


Was sind Kubernetes Workloads?
Kubernetes Workloads sind Anwendungen, Services oder Tasks, die auf einem Kubernetes-Cluster laufen. Sie werden innerhalb von Pods ausgeführt, in der Regel aber über übergeordnete Workload-Ressourcen verwaltet, die Kubernetes vorgeben, wie Pods erstellt, ersetzt, skaliert, aktualisiert und beendet werden sollen. Unterschiedliche Workload-Ressourcen bieten unterschiedliches Lifecycle-Verhalten, sodass Kubernetes zustandslose Services, zustandsbehaftete Anwendungen, Agents auf Node-Ebene, einmalige Batch-Verarbeitung und geplante Tasks unterstützen kann.
Zentrale integrierte Workload-Ressourcen:
| Workload-Typ | Primärer Anwendungsfall | Wichtige Funktionen und Verhalten | Typische Beispiele |
|---|---|---|---|
| Deployment | Zustandslose, dauerhaft laufende Anwendungen | Hält austauschbare Pod-Replikate über ReplicaSets aufrecht und unterstützt Skalierung, Rolling Updates, Rollbacks sowie den automatischen Ersatz fehlgeschlagener Pods. | Webanwendungen, APIs, Microservices |
| StatefulSet | Zustandsbehaftete Anwendungen mit Bedarf an stabiler Identität oder Storage | Gibt Pods stabile Namen und Identitäten, unterstützt geordnetes Erstellen und Beenden und kann jedem Replikat einen eigenen Persistent Volume Claim zuordnen. | PostgreSQL-Cluster, verteilte Datenbanken, Kafka |
| DaemonSet | Services auf Node-Ebene | Stellt sicher, dass auf jedem geeigneten Node oder auf ausgewählten Nodes ein Pod läuft, und fügt Pods automatisch hinzu oder entfernt sie, wenn passende Nodes dem Cluster beitreten oder ihn verlassen. | Log-Collectors, Monitoring-Agents, Netzwerk- und Storage-Agents |
| Job | Endliche oder Batch-Tasks | Erstellt einen oder mehrere Pods und verfolgt sie, bis die erforderliche Anzahl erfolgreicher Abschlüsse erreicht ist; unterstützt sequenzielle und parallele Ausführung. | Datenbankmigrationen, Batch-Verarbeitung, administrative Skripte |
| CronJob | Geplante, wiederkehrende Tasks | Erstellt Jobs nach einem Cron-Zeitplan und kann Parallelität, verpasste Ausführungen und die Aufbewahrung abgeschlossener Jobs steuern. | Backups, Berichterstellung, Aufräumarbeiten, periodische Synchronisation |
| ReplicaSet | Aufrechterhaltung einer festen Anzahl identischer Pod-Replikate | Stellt sicher, dass die angegebene Anzahl passender Pods verfügbar bleibt, und ersetzt fehlgeschlagene oder gelöschte Pods bei Bedarf. Wird in der Regel von einem Deployment erstellt und verwaltet statt direkt. | Replikat-Management als Grundlage von Deployments |
Best Practices für Workloads:
- Präzise Resource Requests und Limits definieren: Legen Sie realistische CPU- und Memory-Requests für das Scheduling fest und setzen Sie Limits mit Bedacht ein, um übermäßigen Verbrauch zu verhindern, ohne unnötiges Throttling oder OOMKilled-Events zu verursachen.
- Workloads kontinuierlich per Right-Sizing anpassen: Vergleichen Sie die historische CPU- und Memory-Nutzung mit den konfigurierten Requests und Limits und passen Sie diese an, wenn sich der Bedarf der Anwendung ändert.
- Den passenden Workload-Controller verwenden: Nutzen Sie Deployments für zustandslose Services, StatefulSets für Workloads mit Bedarf an stabiler Identität oder Storage, DaemonSets für Services auf Node-Ebene, Jobs für endliche Tasks und CronJobs für geplante Aufgaben.
- Readiness-, Liveness- und Startup-Probes konfigurieren: Nutzen Sie Probes, um zu steuern, wann ein Pod Traffic erhält, nicht behebbare Anwendungsfehler zu erkennen und langsam startende Workloads vor vorzeitigen Neustarts zu schützen.
- Pod Disruption Budgets für kritische Anwendungen nutzen: Begrenzen Sie, wie viele Replikate während freiwilliger Unterbrechungen wie Node-Drains und Wartungsarbeiten nicht verfügbar sein dürfen.
- Replikate über Nodes und Availability Zones verteilen: Nutzen Sie Pod-Anti-Affinity oder Topology Spread Constraints, um die Auswirkungen von Node- oder Zonenausfällen zu reduzieren.
- Workload- und Cluster-Autoscaling kombinieren: Stimmen Sie HPA oder anderes Workload-Autoscaling mit dem Node-Autoscaling ab, damit für zusätzliche Replikate genügend Cluster-Kapazität vorhanden ist.
Dieser Artikel ist Teil einer Serie über Kubernetes-Scheduling
In diesem Artikel:
- Kubernetes Workloads vs. Workload-API
- Typen von Kubernetes Workloads
- KI- und Machine-Learning-Workloads in Kubernetes
- Der Lifecycle von Kubernetes Workloads
- Monitoring von Kubernetes Workloads
- Best Practices für das Management von Kubernetes Workloads
Kubernetes Workloads vs. Workload-API
Ein Kubernetes Workload ist die konkrete Ressource, die eine im Cluster laufende Anwendung oder einen Task repräsentiert und verwaltet. Beispiele sind Deployment, StatefulSet, DaemonSet, Job oder CronJob. Diese Objekte beschreiben den gewünschten Zustand des Workloads, etwa das auszuführende Container-Image, die Anzahl der Replikate, die Update-Strategie und die Scheduling-Anforderungen.
Eine Workload-API ist die Kubernetes-API-Schnittstelle, über die diese Workload-Objekte erstellt, gelesen, aktualisiert, gelöscht, skaliert oder anderweitig verwaltet werden. Ein Deployment ist beispielsweise ein Workload-Objekt, während die Deployment-API, die über die Kubernetes-API-Gruppe apps/v1 bereitgestellt wird, die Operationen und das Schema liefert, mit denen Tools wie kubectl, Controller und Anwendungscode Deployment-Ressourcen bearbeiten.
Die Unterscheidung verläuft also zwischen der verwalteten Ressource und der API, mit der sie verwaltet wird. Ein StatefulSet ist ein Workload; die StatefulSet-API ermöglicht es Clients, StatefulSet-Objekte zu erstellen oder zu ändern. Ebenso ist ein Job ein Workload, während die Job-API programmatischen Zugriff auf Job-Ressourcen bietet.
Diese Unterscheidung wird besonders wichtig, wenn Operatoren, Automatisierung, Plattform-Tooling oder individuelle Integrationen entwickelt werden. Solche Systeme interagieren über Workload-APIs mit Kubernetes, statt laufende Container oder Pods direkt zu manipulieren, sodass die Kubernetes Control Plane den angeforderten Workload-Zustand abgleichen kann.
Typen von Kubernetes Workloads
Kubernetes stellt mehrere Workload-Ressourcen für unterschiedliche Anwendungsanforderungen bereit. Jede Ressource verwaltet Pods, folgt dabei aber eigenen Regeln für Scheduling, Skalierung, Updates und den Austausch von Pods. Welche Ressource die richtige ist, hängt davon ab, ob die Anwendung zustandslos, zustandsbehaftet, node-spezifisch oder für eine begrenzte Laufzeit konzipiert ist.
Deployments
Ein Deployment verwaltet zustandslose Anwendungen, die ein oder mehrere austauschbare Pod-Replikate benötigen. Sie definieren das gewünschte Container-Image, die Anzahl der Replikate und die Pod-Konfiguration, und das Deployment arbeitet kontinuierlich daran, diesen Zustand aufrechtzuerhalten.
Deployments unterstützen außerdem kontrollierte Anwendungsupdates. Sie können bei einem Rolling Update alte Pods schrittweise durch neue ersetzen und ermöglichen ein Rollback auf eine frühere Revision, falls ein Update fehlschlägt. Deployments verwalten Pods über ReplicaSets, statt sie direkt zu erstellen.
Beispiel:
apiVersion: apps/v1kind: Deploymentspec: replicas: 3StatefulSets
Ein StatefulSet verwaltet Anwendungen, deren Pods stabile Identitäten, eine vorhersehbare Reihenfolge oder persistenten Storage benötigen. Anders als Deployment-Pods erhalten StatefulSet-Pods persistente Namen wie database-0 und database-1.
StatefulSets können Pods in einer definierten Reihenfolge erstellen und beenden und jedem Pod einen eigenen Persistent Volume Claim zuordnen. Diese Eigenschaften machen sie nützlich für Datenbanken, verteilte Datenspeicher und andere Anwendungen, bei denen einzelne Replikate nicht austauschbar sind.
Beispiel:
apiVersion: apps/v1kind: StatefulSetspec: serviceName: database replicas: 2DaemonSets
Ein DaemonSet stellt sicher, dass auf jedem geeigneten Node oder auf einer ausgewählten Gruppe von Nodes ein Pod läuft. Tritt ein passender Node dem Cluster bei, erstellt Kubernetes den Pod auf diesem Node. Wird der Node entfernt, verschwindet sein DaemonSet-Pod mit ihm.
DaemonSets werden häufig für Services auf Node-Ebene eingesetzt, etwa Log-Collectors, Monitoring-Agents, Storage-Komponenten und Netzwerk-Software. Über Node-Selectors, Affinity-Regeln und Tolerations lässt sich einschränken, welche Nodes die Pods erhalten.
Beispiel:
apiVersion: apps/v1kind: DaemonSetmetadata: name: node-agentJobs
Ein Job führt einen oder mehrere Pods aus, bis ein definierter Task erfolgreich abgeschlossen ist. Anders als ein Deployment, das eine Anwendung dauerhaft am Laufen hält, verfolgt ein Job erfolgreiche Abschlüsse und erstellt keine weiteren Pods mehr, sobald die Abschlussanforderungen erfüllt sind.
Jobs eignen sich für endliche Aufgaben wie Datenbankmigrationen, Datenverarbeitung, Batch-Berechnungen und administrative Operationen. Sie können einen einzelnen Task ausführen oder mehrere Tasks sequenziell oder parallel abarbeiten.
Beispiel:
apiVersion: batch/v1kind: Jobmetadata: name: migrationCronJobs
Ein CronJob erstellt Jobs nach einem wiederkehrenden Zeitplan in Cron-Syntax. Kubernetes wertet den Zeitplan aus und startet einen Job, sobald der konfigurierte Ausführungszeitpunkt erreicht ist.
CronJobs eignen sich für wiederkehrende Aufgaben wie Backups, Berichterstellung, Aufräumarbeiten und periodische Datensynchronisation. Über die Konfiguration lassen sich außerdem parallele Ausführungen, verpasste Zeitpläne und die Aufbewahrung abgeschlossener Jobs steuern.
Beispiel:
apiVersion: batch/v1kind: CronJobspec: schedule: "0 2 * * *"ReplicaSets
Ein ReplicaSet hält eine festgelegte Anzahl identischer Pod-Replikate aufrecht. Fällt ein Pod aus oder wird er gelöscht, erstellt das ReplicaSet einen Ersatz. Existieren zu viele passende Pods, entfernt es die überzähligen.
ReplicaSets werden in der Regel indirekt über Deployments verwaltet. Ein Deployment erstellt neue ReplicaSets, wenn sich sein Pod-Template ändert, und nutzt sie für Rolling Updates und Rollbacks. ReplicaSets direkt zu erstellen ist meist unnötig, wenn ein Deployment das erforderliche Lifecycle-Management bietet.
Beispiel:
apiVersion: apps/v1kind: ReplicaSetspec: replicas: 3KI- und Machine-Learning-Workloads in Kubernetes
Kubernetes kann KI- und Machine-Learning-Workloads wie Modelltraining, verteiltes Training, Batch-Verarbeitung und Inferenz ausführen. Diese Workloads laufen weiterhin in Pods, haben aber oft anspruchsvollere Anforderungen als herkömmliche Anwendungen – insbesondere bei Beschleunigern, Ressourcenverfügbarkeit und der Koordination mehrerer Pods.
Anforderungen an GPUs und Beschleuniger
KI/ML-Workloads sind häufig auf GPUs oder andere spezialisierte Hardware angewiesen. Kubernetes unterstützt Device-Plugins, die Hardware wie AMD- und NVIDIA-GPUs als planbare Ressourcen verfügbar machen.
Damit können Teams:
- GPUs für bestimmte Pods anfordern.
- Workloads nur auf Nodes mit passender Beschleuniger-Hardware einplanen.
- Node-Labels, Selectors und Affinity nutzen, um bestimmte GPU-Typen anzusteuern.
- GPU-Kapazität zusammen mit anderen Kubernetes-Ressourcen wie CPU und Memory verwalten.
Verteilte KI- und ML-Workloads
Große Trainingsjobs können aus mehreren zusammengehörigen Pods bestehen, etwa einem Driver und einer Gruppe von Workern. Diese Pods unabhängig voneinander einzuplanen kann ineffizient sein, weil der Workload keine Fortschritte machen kann, solange nicht genügend Worker gleichzeitig verfügbar sind.
Die Kubernetes Workload-API adressiert diese Art von Anforderung, indem zusammengehörige Pods gruppiert und mit Scheduling-Richtlinien versehen werden können. Gang Scheduling kann beispielsweise nach dem Alles-oder-nichts-Prinzip vorgehen: Die erforderliche Pod-Gruppe wird gemeinsam eingeplant, statt dass nur ein Teil eines verteilten Jobs Ressourcen belegt.
Workload-Platzierung für KI/ML
Auch die Platzierung kann die KI/ML-Performance beeinflussen. Verteiltes Training erfordert oft intensive Kommunikation zwischen den Workern, daher kann Kubernetes workload- und topologiebewusstes Scheduling nutzen, um zu koordinieren, wo zusammengehörige Pods laufen.
Diese Fähigkeiten helfen Unternehmen dabei:
- Verteilte Worker innerhalb geeigneter Topologie-Domänen zu halten.
- Die Kommunikationslatenz zwischen zusammengehörigen Pods zu reduzieren.
- Nur teilweise eingeplante Trainingsjobs zu vermeiden, die keinen sinnvollen Fortschritt machen können.
- Knappe GPU- und Beschleuniger-Ressourcen effizienter zuzuweisen.
Der Lifecycle von Kubernetes Workloads
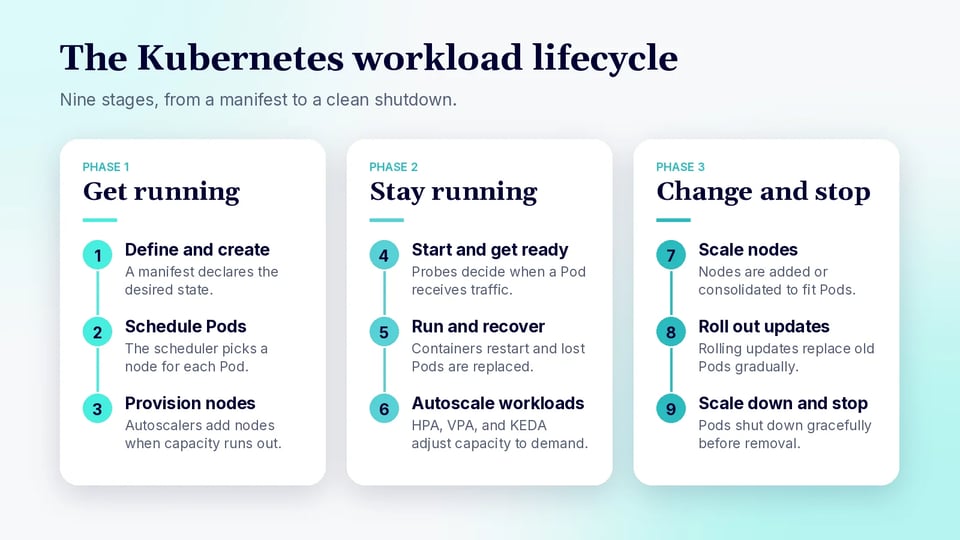
Ein Kubernetes Workload durchläuft mehrere Phasen – von der ursprünglichen Deklaration über Scheduling, Ausführung, Skalierung und Updates bis zur schließlichen Terminierung. Moderne Kubernetes-Umgebungen können einen Großteil dieses Lifecycles automatisieren, einschließlich der Skalierung auf Anwendungsebene und der dynamischen Bereitstellung der zugrunde liegenden Nodes.
1. Workload-Definition und -Erstellung
Der Lifecycle beginnt mit der Definition einer Workload-Ressource wie Deployment, StatefulSet, DaemonSet, Job oder CronJob. Das Manifest legt den gewünschten Zustand der Anwendung fest, einschließlich Container-Images, Replikat-Anzahl, Resource Requests und Limits, Umgebungskonfiguration, Storage-Anforderungen und Scheduling-Beschränkungen.
Wird die Ressource an die Kubernetes-API übergeben, beginnt der zuständige Controller, den tatsächlichen Cluster-Zustand mit dem gewünschten Zustand abzugleichen. Ein Deployment-Controller erstellt und verwaltet beispielsweise ReplicaSets, die wiederum die erforderlichen Pods aufrechterhalten.
2. Pod-Scheduling
Neu erstellte Pods starten in der Regel ohne zugewiesenen Node. Der Kubernetes-Scheduler bewertet die verfügbaren Nodes und wählt eine geeignete Platzierung anhand von Faktoren wie:
- CPU- und Memory-Requests
- Node-Selectors und Node Affinity
- Pod Affinity und Anti-Affinity
- Taints und Tolerations
- Topology Spread Constraints
- Storage- und Hardware-Anforderungen
Kubernetes unterstützt außerdem Scheduling Gates, die einen Pod vom Scheduler fernhalten können, bis externe Bedingungen erfüllt sind. Sobald ein geeigneter Node ausgewählt ist, wird der Pod an diesen Node gebunden.
3. Node-Bereitstellung bei unzureichender Kapazität
Kann der Scheduler einen Pod nicht platzieren, weil keine geeignete Kapazität verfügbar ist, kann Node-Autoscaling zusätzliche Infrastruktur bereitstellen.
Moderne Kubernetes-Versionen unterscheiden dies vom Workload-Autoscaling. Node-Autoscaler reagieren auf nicht einplanbare Pods und stellen Nodes bereit, die deren Ressourcen- und Scheduling-Anforderungen erfüllen. Kubernetes nennt derzeit sowohl Cluster Autoscaler als auch Karpenter als von SIG Autoscaling getragene Implementierungen.
Karpenter verfolgt dabei einen dynamischeren Ansatz. Statt sich ausschließlich auf vordefinierte Node-Gruppen zu stützen, kann es anhand von NodePool-Constraints und den Anforderungen wartender Pods geeignete Node-Kapazität auswählen und bereitstellen. Außerdem übernimmt es umfassendere Node-Lifecycle-Operationen, einschließlich Konsolidierung und Austausch von Nodes.
4. Pod-Start und Readiness
Sobald ein Pod seinen zugewiesenen Node erreicht, bereitet das Kubelet den Pod vor und startet seine Container. Anwendungen benötigen unter Umständen Initialisierungszeit, bevor sie Traffic bedienen können.
Kubernetes stellt für diese Phase mehrere Probes bereit:
- Startup-Probes erkennen, wann eine Anwendung erfolgreich initialisiert wurde.
- Readiness-Probes bestimmen, wann ein Pod Traffic erhalten soll.
- Liveness-Probes erkennen Container, die zwar laufen, aber fehlerhaft sind und neu gestartet werden sollten.
Ein Pod kann also laufen, ohne bereits als bereit für die Verarbeitung von Anfragen zu gelten.
5. Laufzeitbetrieb und Health-Management
Sobald sie bereit sind, führen Pods ihren Anwendungs-Workload aus, während Kubernetes kontinuierlich daran arbeitet, den deklarierten Zustand aufrechtzuerhalten.
Fällt ein Container aus, kann das Kubelet ihn gemäß seiner Restart-Policy neu starten. Verschwindet ein von einem Deployment oder StatefulSet verwalteter Pod vollständig, kann der Workload-Controller einen Ersatz erstellen. Readiness-Checks können fehlerhafte Pods außerdem vorübergehend aus den Service-Endpoints entfernen, ohne sie zwingend neu zu starten.
6. Workload-Autoscaling
Im laufenden Betrieb kann Kubernetes die Workload-Kapazität an die Nachfrage anpassen. Aktuelle Kubernetes-Versionen unterstützen dafür mehrere Ansätze, statt sich auf einen einzigen Skalierungsmechanismus zu verlassen.
- Horizontal Pod Autoscaler (HPA): Ändert die Anzahl der Replikate auf Basis von CPU-, Memory-, benutzerdefinierten oder externen Metriken.
- Vertical Pod Autoscaler (VPA): Passt Resource Requests und Limits an die Anforderungen des Workloads an. VPA wird separat installiert und ist nicht Teil der Kubernetes-Kern-API.
- In-Place Vertical Resizing: Kubernetes kann die einem Container zugewiesenen CPU- und Memory-Ressourcen anpassen, ohne den Pod zwingend zu ersetzen. In-Place Pod Vertical Scaling ist seit Kubernetes 1.35 stabil.
- KEDA: Ergänzt ereignisgesteuertes Autoscaling auf Basis von Quellen wie Queues, Streaming-Systemen, Datenbanken und Monitoring-Plattformen.
KEDA ist besonders nützlich, wenn die Skalierung Anwendungsereignissen statt der CPU- oder Memory-Auslastung folgen soll. Es kann Deployments, StatefulSets und andere skalierbare Ressourcen skalieren, einschließlich der Skalierung von Workloads zwischen null und einem Replikat, bevor HPA für die weitere Skalierung übernimmt. Über ScaledJob kann KEDA außerdem Kubernetes Jobs erstellen und skalieren.
7. Node-Skalierung und Konsolidierung
Mehr Workload-Replikate bedeuten nicht automatisch, dass bestehende Nodes genug Platz haben, um sie auszuführen. Workload-Autoscaling und Node-Autoscaling arbeiten daher oft zusammen.
Beispiel:
- HPA oder KEDA erhöht die Anzahl der Pods als Reaktion auf die Nachfrage.
- Einige neue Pods können nicht eingeplant werden, weil dem Cluster Kapazität fehlt.
- Ein Node-Autoscaler stellt zusätzliche Nodes bereit.
- Der Scheduler platziert die wartenden Pods auf der neu verfügbaren Kapazität.
Der Prozess funktioniert auch umgekehrt. Sinkt die Nachfrage, entfernt das Workload-Autoscaling überflüssige Pods, und das Node-Autoscaling kann ungenutzte Infrastruktur konsolidieren.
Mit Karpenter kann die Konsolidierung leere oder schwach ausgelastete Nodes entfernen oder ersetzen. So passt der Cluster seine Infrastruktur an den Workload an, statt lediglich feste Node-Gruppen aufrechtzuerhalten.
8. Workload-Updates und Rollouts
Workloads ändern sich im Laufe ihres Lebenszyklus häufig, wenn Teams neue Container-Images, Konfigurationen, Ressourceneinstellungen oder Anwendungsversionen bereitstellen.
Bei Deployments führt Kubernetes typischerweise ein Rolling Update durch: Es erstellt schrittweise Pods auf Basis der neuen Spezifikation und beendet gleichzeitig ältere Pods. So bleiben Anwendungen verfügbar, während eine neue Version eingeführt wird. Das Rollout-Verhalten lässt sich über Einstellungen wie maxSurge und maxUnavailable steuern.
Controller gleichen den Workload so lange ab, bis die laufenden Pods dem aktualisierten gewünschten Zustand entsprechen.
9. Herunterskalieren und Terminierung
Pods können durch manuelles Löschen, Workload-Downscaling, Rolling Updates, Node-Störungen oder Node-Konsolidierung beendet werden.
Bei einer regulären Terminierung gibt Kubernetes der Anwendung die Gelegenheit, sich kontrolliert herunterzufahren. Der Pod wird aus dem regulären Service-Traffic entfernt, die Container erhalten ein Terminierungssignal, und Kubernetes wartet die konfigurierte Termination Grace Period ab, bevor verbleibende Prozesse zwangsweise gestoppt werden.
Sinkt die Workload-Nachfrage, können Autoscaler die Replikat-Anzahl reduzieren, und Node-Autoscaler wie Karpenter können anschließend nicht mehr benötigte Kapazität konsolidieren oder entfernen.
Monitoring von Kubernetes Workloads
Das Monitoring von Kubernetes Workloads sollte mehr leisten, als nur anzuzeigen, ob Pods laufen. Ziel ist es, Kapazitätsprobleme, instabile Anwendungen, Scheduling-Engpässe und ineffiziente Ressourcenzuweisung zu identifizieren – und diese Erkenntnisse zu nutzen, um Ressourceneinstellungen, Autoscaling-Richtlinien und Workload-Konfiguration zu optimieren.
CPU- und Memory-Auslastung
CPU- und Memory-Metriken helfen zu beurteilen, ob Workloads genug Ressourcen haben, um zuverlässig zu laufen, ohne mehr Cluster-Kapazität zu reservieren als nötig.
Zu überwachende Metriken
- CPU-Nutzung: Tatsächlich verbrauchte CPU je Container und Pod.
- CPU-Requests: Für das Scheduling reservierte CPU.
- CPU-Limits: Maximale CPU, die ein Container nutzen darf, sofern Limits konfiguriert sind.
- CPU-Throttling: Zeit, in der ein Container daran gehindert wird, zusätzliche CPU zu nutzen, weil er sein CPU-Limit erreicht hat.
- Memory-Nutzung und Working Set: Aktiv vom Workload verbrauchter Arbeitsspeicher.
- Memory-Requests und -Limits: Reservierter Arbeitsspeicher und maximal zulässiger Arbeitsspeicher für den Container.
- Auslastungstrends: Historische Nutzungsmuster, einschließlich Spitzen, dauerhafter Auslastung und schleichendem Memory-Wachstum.
Der Vergleich der tatsächlichen Auslastung mit den Requests ist besonders aufschlussreich, da Requests sowohl das Pod-Scheduling als auch das Verhalten des Horizontal Pod Autoscalers beeinflussen, wenn Metriken zur Ressourcenauslastung verwendet werden.
Tipps zur Optimierung
Nutzen Sie Auslastungsdaten, um Resource Requests per Right-Sizing anzupassen, statt sich nur auf anfängliche Schätzungen zu verlassen. Dauerhaft unterausgelastete Workloads haben möglicherweise unnötig hohe Requests, während Workloads, die regelmäßig an ihre verfügbaren Ressourcen stoßen, mehr Kapazität benötigen könnten.
Mögliche Maßnahmen:
- CPU- und Memory-Requests anpassen, damit sie den beobachteten Bedarf besser widerspiegeln.
- Anhaltendes CPU-Throttling untersuchen, statt einfach die Limits zu erhöhen.
- Memory-Limits erhöhen, wenn der legitime Workload-Bedarf die aktuellen Einstellungen übersteigt.
- Stetiges Memory-Wachstum auf mögliche Memory-Leaks untersuchen.
- HPA, VPA oder andere Autoscaling-Mechanismen einsetzen, wenn sich der Ressourcenbedarf mit der Nachfrage deutlich ändert.
- Langfristige Perzentile und Spitzenzeiten betrachten, statt anhand einer einzelnen Momentaufnahme zu optimieren.
Pod-Neustarts und -Fehler
Restart- und Fehlermetriken decken instabile Workloads auf, die an der aktuellen Pod-Phase nicht unbedingt erkennbar sind. Ein Pod kann Running melden, während einer seiner Container wiederholt abstürzt und neu startet.
Zu überwachende Metriken und Signale
- Anzahl und Rate der Container-Neustarts
- Grund der Container-Terminierung
- Exit-Codes
- Aktueller und vorheriger Container-Zustand
- Fehlgeschlagene Startup-, Readiness- und Liveness-Probes
- CrashLoopBackOff-Events
- Image-Pull- und Konfigurationsfehler
- Anwendungslogs vor und nach einem Neustart
Die Restart-Rate über die Zeit zu überwachen ist in der Regel nützlicher, als auf einen einzelnen Neustart zu reagieren. Plötzliche Anstiege oder anhaltende Restart-Schleifen sind deutlichere Hinweise auf ein zugrunde liegendes Problem.
Tipps für Troubleshooting und Optimierung
Die richtige Reaktion hängt davon ab, warum der Container neu gestartet wurde. Beginnen Sie mit dem Terminierungsgrund, dem vorherigen Container-Zustand, den Kubernetes-Events und den Anwendungslogs.
Typische Maßnahmen:
- Anwendungsabstürze oder unbehandelte Exceptions beheben.
- Probes anpassen, die für Start- oder Antwortzeiten der Anwendung zu aggressiv sind.
- Fehlende Secrets, ConfigMaps, Volumes oder Umgebungsvariablen korrigieren.
- Memory erhöhen, wenn Neustarts durch OOM-Zustände verursacht werden.
- Nicht verfügbare nachgelagerte Services untersuchen, wenn Fehler mit Abhängigkeitsfehlern zusammenfallen.
- Jüngste Deployments überprüfen, wenn die Restart-Rate unmittelbar nach einem Rollout steigt.
Behandeln Sie Neustarts nicht ausschließlich als Kapazitätsproblem. Mehr Ressourcen lösen keine Fehler, die durch Anwendungsbugs, ungültige Konfiguration oder falsch konfigurierte Health-Probes verursacht werden.
Pending und nicht einplanbare Pods
Pending Pods können darauf hindeuten, dass die Workload-Nachfrage die verfügbare Cluster-Kapazität übersteigt oder dass Scheduling-Beschränkungen Kubernetes daran hindern, einen geeigneten Node zu finden.
Zu überwachende Metriken und Signale
- Anzahl der Pending Pods
- Dauer, die Pods im Status Pending verbleiben
- Anzahl nicht einplanbarer Pods
- Scheduler-Events und Ablehnungsgründe
- Angeforderte CPU, Memory, GPUs und weitere Ressourcen
- Verfügbare Kapazität auf geeigneten Nodes
- Node-Affinity- und Selector-Anforderungen
- Taints und Tolerations
- Topology Spread Constraints
- Scheduling- und Attachment-Bedingungen für PersistentVolumes
Besonders aussagekräftig ist das Alter der Pending Pods. Kurze Scheduling-Verzögerungen können normal sein, während Pods, die über längere Zeit nicht einplanbar bleiben, in der Regel ein Eingreifen erfordern.
Tipps zur Behebung von Scheduling-Engpässen
Klären Sie zunächst, ob das Problem an fehlender Kapazität oder an zu restriktiven Scheduling-Regeln liegt.
Mögliche Maßnahmen:
- Resource Requests per Right-Sizing anpassen, wenn Pods deutlich mehr Kapazität anfordern, als sie tatsächlich benötigen.
- Node-Selectors, Affinity-Regeln oder Tolerations korrigieren, die die Platzierung unnötig einschränken.
- Topology-Spread-Anforderungen überprüfen, wenn Kubernetes nicht genügend geeignete Nodes findet.
- Sicherstellen, dass GPU- oder andere spezialisierte Workloads Zugriff auf kompatible Nodes haben.
- Cluster-Kapazität erweitern, wenn der legitime Workload-Bedarf die verfügbaren Ressourcen übersteigt.
- Node-Autoscaling konfigurieren, damit neue Kapazität automatisch bereitgestellt werden kann.
In dynamisch skalierten Umgebungen sollten dauerhaft im Status Pending verbleibende Pods auch eine Überprüfung der Node-Provisioning-Ebene auslösen. Karpenter kann beispielsweise Nodes auf Basis der Anforderungen nicht einplanbarer Pods bereitstellen – die NodePool-Constraints müssen die Erstellung geeigneter Instanzkapazität jedoch zulassen.
OOMKilled-Container
OOMKilled bedeutet, dass ein Container durch das Out-of-Memory-Handling des Betriebssystems beendet wurde. Eine häufige Ursache ist ein Container, der versucht, mehr Memory zu verbrauchen, als sein konfiguriertes Limit erlaubt.
Zu überwachende Metriken und Signale
- Terminierungsgrund des Containers: OOMKilled
- Exit-Code 137
- Memory Working Set
- Memory-Requests und -Limits
- Memory-Spitzenverbrauch
- Memory-Auslastung unmittelbar vor der Terminierung
- Restart-Häufigkeit nach OOM-Events
- Langfristiges Memory-Wachstum
Historische Metriken sind besonders wertvoll, da aktuelle Container-Metriken nach einem Neustart des Containers zurückgesetzt werden.
Tipps zur Vermeidung von OOM-Kills
Klären Sie zunächst, ob die Memory-Nutzung einem legitimen Anwendungsbedarf oder einem anomalen Verhalten entspricht.
Mögliche Optimierungen:
- Memory-Limits erhöhen, wenn normale Workloads legitim mehr Kapazität benötigen.
- Memory-Requests anheben, wenn Pods dauerhaft deutlich mehr Memory verbrauchen als angefordert.
- Memory-Leaks in der Anwendung untersuchen, wenn die Nutzung über die Zeit kontinuierlich wächst.
- Parallelität oder Batch-Größen begrenzen, wenn einzelne Anfragen große Memory-Spitzen verursachen.
- Caches, JVM-Heap-Einstellungen und Memory-Konfiguration auf Anwendungsebene überprüfen.
- Historische Auslastungsdaten nutzen, um realistische Ressourceneinstellungen festzulegen.
- Vertikales Autoscaling in Betracht ziehen, wenn sich der Memory-Bedarf über die Zeit deutlich verändert.
Memory-Limits wiederholt zu erhöhen, ohne die Ursache zu identifizieren, kann Anwendungsprobleme verschleiern und die Infrastrukturkosten in die Höhe treiben. Ressourcenänderungen sollten daher auf dem Workload-Verhalten und der historischen Nutzung basieren – nicht allein auf OOM-Events.
Best Practices für das Management von Kubernetes Workloads
Präzise Resource Requests und Limits definieren
Legen Sie CPU- und Memory-Requests auf Basis realistischer Workload-Anforderungen fest. Der Scheduler nutzt Requests bei der Entscheidung, wo Pods platziert werden – zu hohe Werte können Cluster-Kapazität verschwenden oder Pods im Status Pending zurücklassen. Zu niedrige Requests können zu überlasteten Nodes führen.
Setzen Sie Limits dort ein, wo sie sinnvollen Schutz vor übermäßigem Ressourcenverbrauch bieten. CPU-Limits können Throttling verursachen, während das Überschreiten eines Memory-Limits zu einem OOMKilled-Container führen kann. Testen Sie Limit-Einstellungen unter repräsentativer Last, statt willkürliche Werte zu wählen.
Workloads kontinuierlich per Right-Sizing anpassen
Der Ressourcenbedarf ändert sich, wenn sich Anwendungscode, Traffic und Nutzungsmuster weiterentwickeln. Prüfen Sie den tatsächlichen CPU- und Memory-Verbrauch regelmäßig und vergleichen Sie ihn mit den konfigurierten Requests und Limits.
Nutzen Sie beim Right-Sizing historische Metriken statt kurzer Momentaufnahmen. Berücksichtigen Sie Normalbetrieb, Spitzenlasten, Startanforderungen und erwartetes Wachstum. So reduzieren Sie ungenutzte Kapazität, ohne Anwendungen anfällig für vorhersehbare Lastspitzen zu machen.
Den passenden Workload-Controller verwenden
Wählen Sie den Controller danach aus, wie die Anwendung laufen muss. Nutzen Sie Deployments für zustandslose, dauerhaft laufende Anwendungen und StatefulSets, wenn Replikate stabile Identitäten, geordnete Abläufe oder persistenten Storage benötigen.
DaemonSets eignen sich für Software, die auf ausgewählten Nodes laufen muss, etwa Monitoring- oder Netzwerk-Agents. Nutzen Sie Jobs für endliche Tasks und CronJobs für zeitgesteuerte Ausführung. Mit dem richtigen Controller erhalten Sie das passende Lifecycle-Verhalten ohne eigene Verwaltungslogik.
Readiness-, Liveness- und Startup-Probes konfigurieren
Nutzen Sie Readiness-Probes, um zu bestimmen, wann ein Pod sicher Traffic empfangen kann. Eine fehlgeschlagene Readiness-Probe entfernt den Pod aus den regulären Service-Endpoints, ohne seinen Container neu zu starten – geeignet für temporäre Zustände wie Abhängigkeitsfehler oder Initialisierung.
Nutzen Sie Liveness-Probes, um Anwendungen zu erkennen, die sich ohne Neustart nicht erholen können. Startup-Probes sind hilfreich für Anwendungen mit langen oder unvorhersehbaren Initialisierungszeiten, weil sie verhindern, dass Liveness-Checks die Anwendung vor Abschluss des Starts neu starten.
Konfigurieren Sie Probe-Pfade, Schwellenwerte, Intervalle und Timeouts mit Bedacht. Zu aggressive Probes können selbst Fehler erzeugen, indem sie gesunde, aber vorübergehend langsame Anwendungen neu starten.
Pod Disruption Budgets für kritische Anwendungen nutzen
Ein PodDisruptionBudget begrenzt, wie viele Replikate einer Anwendung bei freiwilligen Unterbrechungen nicht verfügbar sein dürfen. Solche Unterbrechungen können bei Operationen wie Node-Draining, Cluster-Wartung oder bestimmten Autoscaling-Aktivitäten auftreten.
Konfigurieren Sie das Budget über minAvailable oder maxUnavailable entsprechend den Redundanzanforderungen der Anwendung. Ein Budget verhindert nicht jede Art von Ausfall, etwa einen unerwarteten Node-Ausfall, und kann keine Verfügbarkeit sicherstellen, wenn eine Anwendung zu wenige Replikate hat.
Vermeiden Sie Budgets, die Routinewartungen unmöglich machen. Der Workload braucht genügend gesunde Replikate, damit Kubernetes das Budget einhalten und gleichzeitig Pods sicher verdrängen kann.
Replikate über Nodes und Availability Zones verteilen
Mehrere Replikate bieten nur begrenzten Schutz, wenn sie alle auf demselben Node oder in derselben Fehlerdomäne laufen. Nutzen Sie Pod-Anti-Affinity oder Topology Spread Constraints, um Replikate über Nodes, Zonen oder andere Topologiegrenzen zu verteilen.
Die Verteilung reduziert die Auswirkungen von Node- und Availability-Zone-Ausfällen. Sie kann außerdem verhindern, dass die Wartung eines einzelnen Nodes zu viel Anwendungskapazität auf einmal entzieht.
Wägen Sie Resilienzanforderungen und Scheduling-Flexibilität gegeneinander ab. Strikte Platzierungsregeln können Pods im Status Pending zurücklassen, wenn der Cluster nicht genügend geeignete Nodes in der geforderten Topologie hat.
Workload- und Cluster-Autoscaling kombinieren
Workload-Autoscaling und Cluster-Autoscaling lösen unterschiedliche Kapazitätsprobleme. Der HorizontalPodAutoscaler kann Anwendungsreplikate anhand von Metriken erhöhen oder verringern, während das Autoscaling auf Node-Ebene die Cluster-Kapazität anpassen kann, wenn Pods mit den vorhandenen Ressourcen nicht eingeplant werden können.
Diese Mechanismen sollten gemeinsam konfiguriert werden. Ein Deployment zu skalieren bringt wenig, wenn neue Replikate Pending bleiben, weil der Cluster keine Kapazität hat. Umgekehrt erhöht das Hinzufügen von Nodes nicht automatisch die Anzahl der Anwendungsreplikate, wenn die Nachfrage steigt.
Präzise Resource Requests sind für beide Mechanismen wichtig, da sie Scheduling- und Kapazitätsentscheidungen beeinflussen. Legen Sie sinnvolle Skalierungsbereiche fest und überwachen Sie das Skalierungsverhalten, um übermäßige Änderungen, träge Reaktionen auf Nachfrage oder unnötige Infrastrukturnutzung zu vermeiden.
FAQ
Was ist ein Kubernetes Workload? Ein Kubernetes Workload ist eine Anwendung, ein Service oder ein Task, der auf einem Cluster läuft. Workloads werden innerhalb von Pods ausgeführt, in der Regel aber über übergeordnete Ressourcen verwaltet, die Kubernetes vorgeben, wie diese Pods erstellt, ersetzt, skaliert, aktualisiert und beendet werden.
Was sind die wichtigsten Typen von Kubernetes Workloads? Die zentralen integrierten Workload-Ressourcen sind Deployments, StatefulSets, DaemonSets, Jobs, CronJobs und ReplicaSets. Jede deckt einen anderen Bedarf ab, etwa zustandslose Services, zustandsbehaftete Anwendungen, Agents auf Node-Ebene, einmalige Tasks und geplante Tasks.
Was ist der Unterschied zwischen einem Deployment und einem StatefulSet? Ein Deployment verwaltet zustandslose Anwendungen, deren Pod-Replikate austauschbar sind. Ein StatefulSet ist für Anwendungen gedacht, deren Pods stabile Namen, eine vorhersehbare Reihenfolge oder eigenen persistenten Storage benötigen, etwa Datenbanken.
Was ist der Unterschied zwischen einem Job und einem CronJob? Ein Job führt einen oder mehrere Pods aus, bis ein Task erfolgreich abgeschlossen ist, etwa eine Datenbankmigration. Ein CronJob erstellt Jobs nach einem wiederkehrenden Zeitplan in Cron-Syntax – passend für Aufgaben wie Backups und Berichterstellung.
Was ist der Unterschied zwischen einem Kubernetes Workload und der Workload-API? Ein Workload ist die verwaltete Ressource, etwa ein Deployment oder ein Job. Die Workload-API ist die Kubernetes-API-Schnittstelle, über die Tools, Controller und Anwendungen diese Ressourcen erstellen, lesen, aktualisieren, löschen und skalieren.
Warum hängt mein Pod im Status Pending fest? Pending Pods bedeuten meist, dass dem Cluster Kapazität fehlt oder Scheduling-Regeln Kubernetes daran hindern, einen geeigneten Node zu finden. Prüfen Sie die Scheduler-Events und anschließend Resource Requests, Node-Selectors, Affinity-Regeln, Tolerations und Topology Spread Constraints. Node-Autoscaling kann Kapazität ergänzen, wenn der Bedarf legitim ist.
So optimieren Sie Kubernetes Workloads mit PerfectScale
PerfectScale by DoiT ist eine Plattform zur Ressourcenoptimierung über alle Kubernetes-Cluster hinweg. Nach einem einmaligen Helm-Deployment liefert sie umsetzbare Einblicke und autonome Optimierung über Ihren gesamten K8s-Stack – von einzelnen Workloads bis zu den zugrunde liegenden Nodes. Sie arbeitet mit Autoscalern wie HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning und Google Autopilot zusammen. Unterstützt werden Public Clouds wie EKS, GKE und AKS, Private Clouds wie OpenShift sowie On-Premises- und Hybrid-Umgebungen.
Zentrale Funktionen von PerfectScale:
- Autonomes Workload-Right-Sizing: Podfit bietet einen granularen Blick auf Cluster-Gesundheit und -Kosten, identifiziert verschwendete Ressourcen und Resilienzrisiken und liefert datenbasierte Empfehlungen für das Right-Sizing von Workloads. Für die sofortige Optimierung lässt sich zusätzlich eine Automatisierung einrichten.
- Empfehlungen für die Autoscaling-Konfiguration: Erhalten Sie umsetzbare Empfehlungen zur Verbesserung Ihrer HPA- und KEDA-Konfigurationen, damit Workloads effizient mit der Nachfrage skalieren.
- Optimierung von ephemeren und ML-Workloads: Ephemere Workloads wie Airflow- und Spark-Jobs werden autonom per Right-Sizing angepasst, damit auch dynamische Umgebungen optimiert bleiben.
- Revisionsbewusste Automatisierung: PerfectScale bewertet jedes neue Code-Release und passt sich an veränderte Workload-Anforderungen an, sodass seine Optimierungen Ihren Entwicklungsänderungen nie widersprechen.
- Optimierung auf Node-Ebene: Infrafit schafft Transparenz über die Node-Auslastung und hilft, ungenutzte Kapazität zu eliminieren, die richtigen Nodes für Ihre Workloads auszuwählen und die Wirkung von Node-Autoscalern wie Karpenter zu maximieren.
- Priorisierte Echtzeit-Alerts: Begegnen Sie Resilienzrisiken und Kostenspitzen mit wirkungsbasierter Priorisierung – mit Alerts in Slack, Datadog, MS Teams, PagerDuty und weiteren Tools.
- Trend- und Governance-Reporting: Verfolgen Sie Kosten-, Waste- und Risikometriken über die Zeit – über Cluster, Node-Gruppen, Namespaces und Workloads hinweg –, um Prognosen und Ursachenanalysen zu verbessern.