


¿Qué son las tolerations en Kubernetes?
Las tolerations en Kubernetes se aplican a los pods para que puedan "tolerar" los taints de los nodos. Mientras los taints repelen a un conjunto de pods de un nodo, las tolerations coincidentes permiten que el scheduler ubique esos pods en el nodo con taint.
Las tolerations se definen en la especificación del pod y le indican al scheduler de Kubernetes que un pod puede ejecutarse en nodos con taints específicos, lo que en la práctica permite sortear las restricciones que esos taints imponen. Esta capacidad es importante en escenarios avanzados de ubicación y aislamiento de workloads. Las tolerations no garantizan que un pod se programe en un nodo con taint; simplemente lo permiten. La decisión final de scheduling también depende de otros factores, como las solicitudes de recursos y la afinidad de nodos.
Efectos de los taints:
- NoSchedule: Impide que se programen en el nodo pods nuevos sin una toleration coincidente.
- PreferNoSchedule: Una versión flexible en la que el scheduler intenta evitar el nodo, pero no está obligado a hacerlo.
- NoExecute: Desaloja los pods en ejecución de inmediato o después de un tiempo definido si no tienen la toleration.
Operadores de tolerations:
- Equal: La clave, el valor y el efecto deben coincidir explícitamente con el taint.
- Exists: Solo deben coincidir la clave y el efecto; el valor se ignora.
- Gt: El valor del taint debe ser un entero mayor que el valor de la toleration (disponible desde la v1.35).
- Lt: El valor del taint debe ser un entero menor que el valor de la toleration (disponible desde la v1.35).
Ejemplo de configuración YAML:
apiVersion: v1kind: Podmetadata: name: database-podspec: tolerations: - key: "workload" operator: "Equal" value: "database" effect: "NoSchedule"Este artículo forma parte de una serie sobre el scheduling en Kubernetes
En este artículo:
- Cómo funcionan las tolerations en Kubernetes
- Taints vs. tolerations en Kubernetes
- Casos de uso comunes de las tolerations en Kubernetes
- Operadores de tolerations en Kubernetes
- Efectos de los taints en Kubernetes
- Ejemplos de tolerations en Kubernetes
- Buenas prácticas con tolerations en Kubernetes
Cómo funcionan las tolerations en Kubernetes
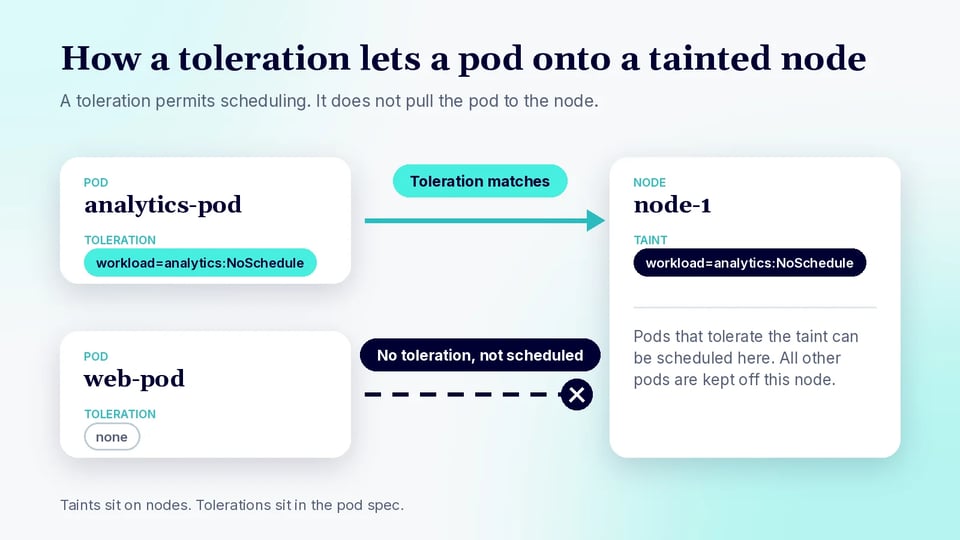
Las tolerations en Kubernetes se especifican en el manifiesto del pod, dentro del campo tolerations. Cada toleration se compone de una clave, un operador, un valor y un efecto. Cuando se crea un pod, el scheduler revisa los taints de los nodos y los compara con las tolerations del pod. Si el taint de un nodo coincide con una toleration del pod, el pod se vuelve elegible para programarse en ese nodo. De lo contrario, el pod no se programará ahí o, si ya está en ejecución, podrá ser desalojado según el efecto del taint.
Este mecanismo permite un control granular del scheduling y asegura que solo los pods con permisos específicos, expresados como tolerations, puedan ejecutarse en nodos con ciertos taints. La interacción entre los taints de los nodos y las tolerations de los pods es la base de las estrategias de aislamiento de nodos, como dedicar nodos a workloads especiales, evitar que workloads sensibles se ejecuten en infraestructura compartida o garantizar que solo pods compatibles corran en hardware especializado.
Taints vs. tolerations en Kubernetes
Los taints y las tolerations son dos caras de la misma moneda en el scheduling de Kubernetes. Los taints se aplican a los nodos y actúan como un mecanismo de repulsión: indican que solo los pods con tolerations coincidentes deberían programarse en esos nodos. Así se evita que los workloads terminen por accidente en nodos que no son adecuados para ellos, como nodos con hardware especializado o reservados para fines específicos.
Las tolerations se aplican a los pods. Especifican qué taints puede tolerar un pod y, con ello, le permiten programarse en nodos que tienen esos taints. Las tolerations no obligan a programar el pod en nodos con taint, pero lo hacen posible al combinarse con otras políticas de scheduling. La combinación de taints y tolerations ofrece un marco flexible para el aislamiento de workloads, la gestión de recursos y el uso eficiente de la infraestructura del clúster.
| Aspecto | Taints | Tolerations |
|---|---|---|
| Se aplican a | Nodos | Pods |
| Propósito | Repeler pods para que no se programen salvo que coincidan con el taint | Permitir que los pods se programen en nodos con taints coincidentes |
| Efecto en el scheduling | Restringe qué pods pueden ejecutarse en un nodo | Permite, pero no exige, programar pods en nodos con taints |
| Caso de uso común | Reservar nodos para workloads, hardware o roles especiales | Permitir que workloads específicos usen esos nodos reservados o especializados |
Casos de uso comunes de las tolerations en Kubernetes
Nodos dedicados
Los nodos dedicados suelen usarse para workloads que requieren aislamiento por razones de seguridad, cumplimiento o rendimiento. Al aplicar a los nodos un taint con una clave y un valor únicos, y agregar tolerations coincidentes solo a los pods que deben ejecutarse ahí, los administradores pueden garantizar que esos nodos queden reservados para workloads específicos. Esto evita que otros pods, potencialmente menos confiables, se programen en hardware dedicado, lo que reduce el riesgo de contención de recursos y aumenta la previsibilidad.
Por ejemplo, un node pool dedicado a aplicaciones financieras puede llevar el taint workload=finance:NoSchedule, de modo que solo los pods con la toleration correspondiente puedan programarse ahí. Este enfoque también es útil en clústeres multi-tenant, donde quieres garantizar que los workloads de cada tenant queden aislados a nivel de nodo. Si aplicas los taints y las tolerations con cuidado, puedes imponer una separación estricta de workloads y límites claros de cumplimiento.
Nodos con GPU
Los nodos con GPU son un recurso valioso y, a menudo, limitado dentro de un clúster de Kubernetes. Para asegurar que solo los workloads que requieren aceleración por GPU se programen en estos nodos, los administradores suelen aplicarles un taint con una clave como hardware=gpu:NoSchedule. Solo los pods con la toleration adecuada serán elegibles para usar los nodos con GPU, lo que evita que workloads de propósito general consuman estos recursos especializados.
Este enfoque minimiza la capacidad de GPU desaprovechada y evita conflictos de scheduling. También permite a los equipos controlar el acceso a hardware costoso y reservarlo para workloads de machine learning, IA o computación científica. El uso correcto de taints y tolerations en nodos con GPU es una buena práctica en clústeres donde el hardware especializado debe protegerse y aprovecharse de forma eficiente.
Contenido relacionado: lee nuestra guía detallada sobre GPU en Kubernetes
Nodos Spot o preemptibles
Los nodos Spot o preemptibles son económicos, pero el proveedor de nube puede reclamarlos en cualquier momento. Estos nodos suelen llevar taints para asegurar que solo se programen en ellos workloads sin estado y tolerantes a fallas. Al aplicarles un taint como instance-type=spot:NoSchedule y configurar tolerations en los pods adecuados, los administradores pueden garantizar que solo los pods capaces de manejar interrupciones se ejecuten en estos nodos.
Esta estrategia permite a las organizaciones optimizar costos sin sacrificar la confiabilidad de los workloads críticos. Los pods sin la toleration no se programarán en nodos Spot, lo que evita terminaciones inesperadas en servicios con estado o de alta disponibilidad. Usar taints y tolerations de esta manera agiliza la asignación de recursos del clúster y protege a las aplicaciones esenciales del riesgo de interrupción.
Contenido relacionado: lee nuestra guía detallada sobre las instancias Spot con Karpenter
Workloads de sistema e infraestructura
Los workloads de sistema e infraestructura, como core DNS, los agentes de monitoreo o los plugins de red, a menudo deben ejecutarse en todos los nodos o en un subconjunto específico. Se pueden aplicar taints a los nodos para repeler los workloads de aplicación generales, mientras que agregar tolerations a los pods críticos del sistema garantiza que estos sí puedan programarse. Por ejemplo, un nodo con el taint node-role.kubernetes.io/infra:NoSchedule solo ejecutará pods con una toleration coincidente, lo que impide que los pods de aplicación comunes consuman los recursos de los nodos de infraestructura.
Este enfoque mantiene una separación clara entre los workloads de sistema y los de usuario, lo que mejora la confiabilidad y la facilidad de gestión. También permite priorizar recursos, ya que los nodos de infraestructura pueden dimensionarse y administrarse por separado de los nodos de aplicación. Usar taints y tolerations para los workloads de sistema es un patrón común en clústeres de producción para garantizar que los servicios críticos siempre cuenten con los recursos que necesitan.
Operadores de tolerations en Kubernetes
Operador Equal
El operador Equal exige que la clave y el valor de la toleration coincidan exactamente con el taint correspondiente. El efecto también debe coincidir cuando se especifica. Este operador es útil cuando un pod debe tolerar un taint específico y no todos los taints que usan la misma clave.
Por ejemplo, una toleration con key: "hardware", operator: "Equal", value: "gpu" y effect: "NoSchedule" coincide con un taint hardware=gpu:NoSchedule. No coincide con hardware=cpu:NoSchedule. Equal es el operador predeterminado cuando se omite el campo operator.
Operador Exists
El operador Exists hace coincidir un taint por su clave, sin exigir que el valor coincida. Al usar Exists, el campo value de la toleration debe omitirse. Si se especifica un effect, el taint también debe tener ese efecto para que la toleration coincida.
Por ejemplo, una toleration con key: "hardware", operator: "Exists" y effect: "NoSchedule" tolera cualquier taint NoSchedule con la clave hardware, sin importar su valor. Si también se omite la clave, Exists puede coincidir con todas las claves de taint, sujeto al efecto especificado, si lo hay. Esto hace que el operador sea útil para tolerations amplias, pero debe usarse con cuidado, porque puede permitir que los pods lleguen a un rango más amplio de nodos con taints.
Operador Gt
El operador Gt (mayor que) coincide con un taint cuando el value del taint es numéricamente mayor que el value de la toleration. La key debe coincidir, y el effect también debe coincidir cuando se especifica. Ambos valores deben ser enteros de 64 bits válidos, sin ceros a la izquierda. Gt se introdujo como funcionalidad alfa en Kubernetes v1.35 y requiere el feature gate TaintTolerationComparisonOperators.
Por ejemplo, una toleration con key: "node-sla", operator: "Gt", value: "950" y effect: "NoSchedule" coincide con un taint node-sla=990:NoSchedule. No coincide con node-sla=900:NoSchedule. Este operador es útil para la ubicación basada en umbrales, por ejemplo, permitir un pod solo en nodos cuyo puntaje de confiabilidad supere un mínimo.
Operador Lt
El operador Lt (menor que) coincide con un taint cuando el value del taint es numéricamente menor que el value de la toleration. Al igual que con Gt, la key debe coincidir, el effect debe coincidir cuando se especifica y ambos valores deben ser enteros válidos. Lt también es alfa en Kubernetes v1.35 y está controlado por el mismo feature gate.
Por ejemplo, una toleration con key: "failure-probability", operator: "Lt", value: "5" y effect: "NoSchedule" tolera un taint failure-probability=2:NoSchedule, pero no failure-probability=8:NoSchedule. Esto hace que el operador sea útil para nodos Spot o preemptibles. Ten en cuenta que los valores de taint definidos durante el registro del nodo no se validan, por lo que un valor de taint no numérico hace que la toleration no coincida.
Efectos de los taints en Kubernetes
Repasemos los efectos de los taints que ofrece Kubernetes y que las tolerations pueden anular.
NoSchedule
El efecto NoSchedule impide que se programen pods nuevos en un nodo, a menos que tengan una toleration coincidente. Los pods que ya están en ejecución en el nodo cuando se agrega el taint no se desalojan. Esto hace que NoSchedule sea útil para reservar nodos para workloads específicos sin afectar los pods existentes.
Por ejemplo, agregar un taint hardware=gpu:NoSchedule evita que los pods sin una toleration coincidente se programen en el nodo con GPU a partir de ese momento. Los pods que ya se ejecutan ahí pueden seguir funcionando.
PreferNoSchedule
El efecto PreferNoSchedule es una restricción flexible de scheduling. Kubernetes intenta no ubicar en el nodo con taint pods que no tengan una toleration coincidente, pero puede programarlos ahí cuando es necesario. A diferencia de NoSchedule, no bloquea el scheduling de forma estricta.
Este efecto es útil cuando los administradores prefieren reservar nodos para ciertos workloads, pero aun así quieren que el scheduler use esos nodos cuando las demás opciones de ubicación son limitadas. Los pods existentes no se desalojan al agregar un taint PreferNoSchedule.
NoExecute
El efecto NoExecute afecta tanto al scheduling como a los pods que ya se ejecutan en un nodo. Los pods nuevos sin una toleration coincidente no pueden programarse ahí, mientras que los pods existentes que no toleran el taint son desalojados.
Una toleration puede incluir tolerationSeconds para que el pod permanezca temporalmente en el nodo después de que aparece un taint NoExecute coincidente. Una vez vencido ese plazo, el pod se desaloja si el taint sigue presente. Si se omite tolerationSeconds, una toleration coincidente permite que el pod permanezca mientras el taint exista.
Ejemplos de tolerations en Kubernetes
Ejemplo 1: toleration básica con NoSchedule
Supongamos que un nodo tiene el taint workload=analytics:NoSchedule. Un pod necesita una toleration coincidente para volverse elegible y poder programarse en ese nodo. El siguiente pod tolera ese taint específico:
apiVersion: v1kind: Podmetadata: name: analytics-podspec: containers: - name: web image: nginx:latest tolerations: - key: "workload" operator: "Equal" value: "analytics" effect: "NoSchedule"El operador Equal exige que tanto la key como el value coincidan con el taint. Esta toleration permite que el pod llegue a nodos con el taint indicado, pero no obliga al scheduler a ubicarlo en uno de esos nodos.
Ejemplo 2: tolerar cualquier valor de un taint
El operador Exists puede usarse cuando un pod debe tolerar una clave de taint sin importar su valor. Por ejemplo, la siguiente configuración tolera cualquier taint NoSchedule cuya clave sea workload:
apiVersion: v1kind: Podmetadata: name: compute-podspec: containers: - name: worker image: busybox:latest tolerations: - key: "workload" operator: "Exists" effect: "NoSchedule"Al usar Exists no se especifica ningún valor. Como resultado, este pod puede tolerar taints como workload=database:NoSchedule y workload=batch:NoSchedule. Otras claves o efectos de taint siguen requiriendo tolerations coincidentes por separado.
Ejemplo 3: NoExecute con tolerationSeconds
Una toleration NoExecute puede incluir tolerationSeconds para controlar cuánto tiempo permanece un pod en un nodo después de que se aplica un taint coincidente. El siguiente pod tolera un taint maintenance-window=active:NoExecute durante 100 segundos:
apiVersion: v1kind: Podmetadata: name: maintenance-workerspec: containers: - name: worker image: busybox:latest tolerations: - key: "maintenance-window" operator: "Equal" value: "active" effect: "NoExecute" tolerationSeconds: 100Si el taint se agrega mientras el pod está en ejecución, el pod puede permanecer en el nodo hasta por 100 segundos. Si el taint sigue existiendo después de ese plazo, Kubernetes desaloja el pod. Si el taint se elimina antes de que venza el plazo, el pod puede seguir ejecutándose.
Buenas prácticas con tolerations en Kubernetes
Usa tolerations solo en los workloads que las necesitan
Agrega tolerations solo cuando un workload tenga una razón clara para ejecutarse en nodos con taints. Las tolerations amplias o innecesarias debilitan el aislamiento que los taints buscan proporcionar y pueden permitir que los workloads lleguen a nodos reservados para otros fines. Esto puede provocar contención de recursos y hacer que la ubicación en nodos sea menos predecible.
Revisa las tolerations a medida que cambian los requisitos de los workloads. Evita las tolerations genéricas con Exists, salvo que el pod realmente necesite tolerar un rango amplio de taints. Prefiere claves, valores y efectos de alcance acotado, de modo que cada workload reciba solo los permisos de scheduling que requiere.
También es útil gestionar las tolerations a nivel del controlador del workload, por ejemplo en un Deployment, StatefulSet o DaemonSet. Así el comportamiento de scheduling se mantiene consistente cuando los pods se recrean o escalan.
Combina las tolerations con la afinidad de nodos
Una toleration hace que un pod sea elegible para ejecutarse en un nodo con taint, pero no lo dirige hacia ese nodo. Si un workload debe ejecutarse específicamente en un node pool determinado, combina las tolerations con la afinidad de nodos o con node selectors.
Por ejemplo, un workload de GPU puede tolerar el taint de los nodos con GPU y, al mismo tiempo, usar afinidad de nodos para exigir nodos etiquetados con el tipo de GPU adecuado. El taint mantiene alejados a los workloads comunes, mientras que la afinidad dirige el workload de GPU hacia nodos compatibles.
Elige entre afinidad de nodos requerida o preferida según qué tan estricta deba ser la ubicación. La afinidad requerida impide el scheduling en nodos que no coinciden, mientras que la preferida le da al scheduler más flexibilidad cuando no hay nodos adecuados disponibles.
Mantén la consistencia de taints y tolerations entre node pools
Usa un esquema de nombres consistente para las claves y los valores de los taints en todos los node pools. Valores inconsistentes como workload=gpu, type=gpu y node=gpu para el mismo propósito hacen que las configuraciones de los pods sean más difíciles de mantener y aumentan el riesgo de errores de scheduling.
Define taints estándar para los roles de nodo más comunes y aplícalos mediante la automatización del clúster o de la infraestructura. Así, los manifiestos de los workloads pueden usar tolerations predecibles en desarrollo, staging y producción, sin diferencias de configuración innecesarias.
La consistencia es especialmente importante cuando los nodos se crean o reemplazan automáticamente mediante sistemas de autoescalado del clúster. Los nodos nuevos deben recibir los taints y las etiquetas esperados durante el aprovisionamiento, para que los workloads se comporten igual sin importar qué instancia de nodo esté en ejecución.
Protege los nodos especializados y costosos
Usa taints para evitar que los pods de propósito general consuman recursos especializados, como GPU, instancias de alta memoria u otro hardware costoso. Solo los workloads diseñados para usar esos recursos deberían recibir las tolerations correspondientes.
Las tolerations por sí solas no garantizan que un pod solicite realmente el recurso especializado. Para los workloads de GPU, por ejemplo, configura las solicitudes o límites de recursos adecuados además de la toleration. La afinidad de nodos puede ofrecer un control adicional de ubicación cuando hay varios tipos de hardware disponibles.
Este enfoque ayuda a evitar que workloads de baja prioridad ocupen la capacidad que necesitan las aplicaciones especializadas. También puede reducir los costos de infraestructura al mantener los nodos costosos disponibles para los workloads que realmente aprovechan su hardware.
Monitorea los resultados del scheduling, no solo la configuración
Una toleration válida no garantiza que un pod se programe con éxito. La disponibilidad de recursos, la afinidad de nodos, las restricciones de topología, la afinidad y antiafinidad de pods y otras reglas del scheduler aún pueden impedir la ubicación.
Monitorea los pods pendientes, los eventos del scheduler, los taints de los nodos y la ubicación real de los pods para verificar que las políticas de scheduling se comporten según lo previsto. Comandos como kubectl describe pod y kubectl describe node pueden ayudar a identificar discrepancias en los taints y otras restricciones de scheduling.
El monitoreo también debe detectar ubicaciones inesperadas, no solo pods que quedan pendientes. Un workload que se ejecuta sin problemas en el node pool equivocado puede indicar tolerations demasiado amplias o reglas de afinidad faltantes. Las revisiones periódicas ayudan a garantizar que las políticas de scheduling sigan funcionando a medida que el clúster y sus workloads cambian.
Preguntas frecuentes
¿Qué es una toleration en Kubernetes? Una toleration es una configuración en la especificación de un pod que permite programarlo en nodos con taints coincidentes. Solo permite el scheduling. No garantiza que el pod termine en un nodo con taint, porque las solicitudes de recursos y la afinidad de nodos siguen aplicándose.
¿Cuál es la diferencia entre un taint y una toleration? Los taints se aplican a los nodos y repelen a los pods que no tienen una toleration coincidente. Las tolerations se aplican a los pods y permiten, pero no exigen, programarlos en nodos con taints coincidentes.
¿Cuál es la diferencia entre los operadores Equal y Exists? Equal exige que la clave, el valor y el efecto de la toleration coincidan con el taint, y es el operador predeterminado cuando no se especifica ninguno. Exists coincide solo por la clave, por lo que el valor debe omitirse, y tolera cualquier valor para esa clave.
¿Qué hacen los efectos NoSchedule, PreferNoSchedule y NoExecute? NoSchedule bloquea los pods nuevos sin una toleration coincidente, pero no toca los pods en ejecución. PreferNoSchedule es una versión flexible en la que el scheduler intenta evitar el nodo. NoExecute además desaloja los pods en ejecución que no toleran el taint.
¿Para qué sirve tolerationSeconds? En una toleration NoExecute, tolerationSeconds define cuánto tiempo puede permanecer un pod en un nodo después de que aparece un taint coincidente. Si pasado ese tiempo el taint sigue ahí, Kubernetes desaloja el pod. Si se omite, el pod permanece mientras el taint esté presente.
¿Una toleration hace que un pod se ejecute en un nodo con taint? No. Una toleration solo hace que el pod sea elegible. Para dirigir un pod a un node pool específico, combina la toleration con afinidad de nodos o un node selector.
Haz más eficiente el scheduling basado en tolerations con PerfectScale
Los taints y las tolerations deciden dónde pueden ejecutarse los pods, pero no dicen nada sobre si esos nodos están bien dimensionados ni si los workloads que llegan a ellos solicitan la cantidad correcta de CPU y memoria. PerfectScale es una plataforma de optimización y gobernanza para Kubernetes que se despliega con un solo comando de Helm y, a partir de ahí, ofrece información accionable y optimización autónoma en todo el stack de K8s, workloads, nodos y autoscalers, para que los node pools reservados, especializados y costosos realmente se usen de forma eficiente.
Capacidades clave de PerfectScale:
- Right-sizing autónomo de workloads: Podfit ofrece una vista granular de la salud y el costo del clúster, detecta recursos desaprovechados y problemas de resiliencia, y optimiza los workloads de forma autónoma con recomendaciones de right-sizing basadas en datos que puedes dejar en automático.
- Visibilidad del uso a nivel de nodo: Infrafit revela la capacidad ociosa de los nodos y propone los tipos de nodo adecuados para tus workloads, de modo que los node pools dedicados, con GPU y otros nodos con taints rindan al máximo nivel sin pagar por capacidad sin usar.
- Optimización de autoscalers: PerfectScale se integra con HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning y Google Autopilot, maximizando la efectividad de los sistemas que aprovisionan y reemplazan tus nodos con taints.
- Alertas en tiempo real con priorización automática: Los riesgos de resiliencia y las anomalías de costos se detectan con una priorización basada en el impacto y se envían directamente a Slack, Datadog, MS Teams o PagerDuty antes de que lleguen a tus usuarios o a tu factura de la nube.
- Tendencias, gobernanza y proyecciones: El reporte de Tendencias ofrece visibilidad detallada de las métricas de costo, pérdida y riesgo a lo largo del tiempo en clústeres, grupos de nodos, namespaces y workloads, lo que facilita el análisis de causa raíz y una planificación presupuestaria precisa.
- Cualquier entorno de Kubernetes: PerfectScale funciona tanto en clústeres on-premise como en la nube, incluyendo OpenShift, EKS, GKE, AKS y configuraciones híbridas, con soporte para contenedores de Windows y workloads efímeros o de ML, como los jobs de Airflow y Spark.