


O que são Tolerations no Kubernetes?
As tolerations do Kubernetes são aplicadas a pods para permitir que eles "tolerem" taints de nós. Enquanto os taints repelem um conjunto de pods de um nó, tolerations correspondentes permitem que o scheduler aloque esses pods no nó com taint.
As tolerations são definidas na especificação do pod e informam ao scheduler do Kubernetes que um pod pode ser executado em nós com taints específicos, contornando, na prática, as restrições impostas por esses taints. Essa capacidade é importante para cenários avançados de alocação e isolamento de workloads. Tolerations não garantem o agendamento em um nó com taint; elas apenas o permitem. A decisão real de agendamento também depende de outros fatores, como solicitações de recursos e afinidade de nós.
Efeitos de taint:
- NoSchedule: Impede que novos pods sem uma toleration correspondente sejam agendados no nó.
- PreferNoSchedule: Uma versão flexível em que o scheduler tenta evitar o nó, mas não é obrigado a isso.
- NoExecute: Despeja pods em execução imediatamente ou após um tempo definido se eles não tiverem a toleration.
Operadores de toleration:
- Equal: A key, o value e o effect devem corresponder explicitamente ao taint.
- Exists: Apenas a key e o effect precisam corresponder; o value é ignorado.
- Gt: O valor do taint deve ser um inteiro maior que o valor da toleration (adicionado na v1.35).
- Lt: O valor do taint deve ser um inteiro menor que o valor da toleration (adicionado na v1.35).
Exemplo de configuração YAML:
apiVersion: v1kind: Podmetadata: name: database-podspec: tolerations: - key: "workload" operator: "Equal" value: "database" effect: "NoSchedule"Este artigo faz parte de uma série sobre agendamento no Kubernetes
Neste artigo:
- Como as Tolerations do Kubernetes Funcionam
- Taints vs. Tolerations no Kubernetes
- Casos de Uso Comuns de Tolerations no Kubernetes
- Operadores de Toleration no Kubernetes
- Efeitos de Taint no Kubernetes
- Exemplos de Tolerations no Kubernetes
- Boas Práticas de Tolerations no Kubernetes
Como as Tolerations do Kubernetes Funcionam
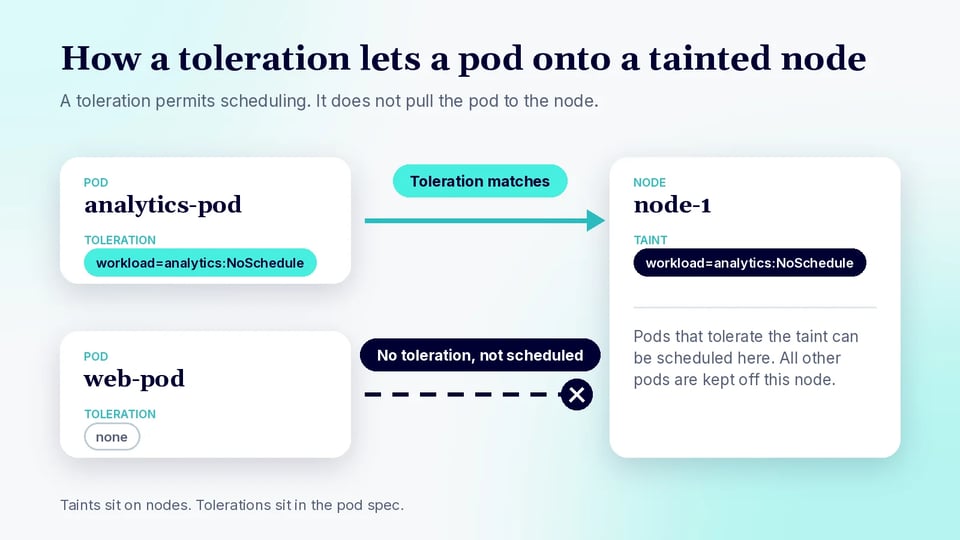
As tolerations do Kubernetes são especificadas como parte do manifesto de um pod, no campo tolerations. Cada toleration consiste em key, operator, value e effect. Quando um pod é criado, o scheduler verifica os taints existentes nos nós e os compara com as tolerations do pod. Se o taint de um nó corresponder a uma toleration do pod, o pod se torna elegível para ser agendado nesse nó. Caso contrário, o pod não será agendado ali ou, se já estiver em execução, poderá ser despejado, dependendo do efeito do taint.
Esse mecanismo permite um controle granular de agendamento, garantindo que apenas pods com permissões específicas, expressas como tolerations, sejam permitidos em nós com determinados taints. A interação entre taints nos nós e tolerations nos pods sustenta estratégias de isolamento de nós, como dedicar nós a workloads especiais, impedir que workloads sensíveis sejam executados em infraestrutura compartilhada ou garantir que apenas pods compatíveis rodem em hardware especializado.
Taints vs. Tolerations no Kubernetes
Taints e tolerations são dois lados da mesma moeda no agendamento do Kubernetes. Os taints são aplicados aos nós e funcionam como um mecanismo de repulsão, indicando que apenas pods com tolerations correspondentes devem ser agendados nesses nós. Isso evita que workloads sejam agendados inadvertidamente em nós inadequados para eles, como nós com hardware especializado ou reservados para fins específicos.
As tolerations são aplicadas aos pods. Elas especificam quais taints um pod pode tolerar, permitindo que ele seja agendado em nós que carregam esses taints. Tolerations não forçam o agendamento em nós com taint, mas o tornam possível quando combinadas com outras políticas de agendamento. A combinação de taints e tolerations oferece uma estrutura flexível para isolamento de workloads, gerenciamento de recursos e uso eficiente da infraestrutura do cluster.
| Aspecto | Taints | Tolerations |
|---|---|---|
| Aplicado a | Nós | Pods |
| Finalidade | Impedir o agendamento de pods, a menos que correspondam ao taint | Permitir que pods sejam agendados em nós com taints correspondentes |
| Efeito no agendamento | Restringe quais pods podem ser executados em um nó | Permite, mas não exige, o agendamento em nós com taint |
| Caso de uso comum | Reservar nós para workloads, hardware ou funções especiais | Permitir que workloads específicos usem esses nós reservados ou especializados |
Casos de Uso Comuns de Tolerations no Kubernetes
Nós Dedicados
Nós dedicados costumam ser usados para workloads que exigem isolamento por motivos de segurança, conformidade ou desempenho. Ao aplicar taints aos nós com uma key e um value exclusivos, e adicionar tolerations correspondentes apenas aos pods que devem ser executados ali, os administradores podem garantir que esses nós fiquem reservados para workloads específicos. Isso impede que outros pods, potencialmente menos confiáveis, sejam agendados em hardware dedicado, reduzindo o risco de disputa por recursos e aumentando a previsibilidade.
Por exemplo, um pool de nós dedicado a aplicações financeiras pode receber o taint workload=finance:NoSchedule, e apenas pods com uma toleration correspondente podem ser agendados ali. Essa abordagem também é útil em clusters multi-tenant, em que você quer garantir que os workloads dos tenants fiquem isolados no nível do nó. Aplicando taints e tolerations com cuidado, é possível impor uma separação rigorosa de workloads e limites de conformidade.
Nós com GPU
Nós com GPU são um recurso valioso e muitas vezes limitado em um cluster Kubernetes. Para garantir que apenas workloads que exigem aceleração por GPU sejam agendados nesses nós, os administradores normalmente aplicam a eles um taint com uma key como hardware=gpu:NoSchedule. Apenas pods com a toleration apropriada serão elegíveis para usar os nós com GPU, garantindo que workloads de uso geral não consumam esses recursos especializados.
Essa abordagem minimiza o desperdício de capacidade de GPU e evita conflitos de agendamento. Também permite que as equipes controlem o acesso a hardware caro, reservando-o para workloads de machine learning, IA ou computação científica. O uso adequado de taints e tolerations com nós de GPU é uma boa prática em clusters onde a especialização de hardware precisa ser protegida e utilizada com eficiência.
Conteúdo relacionado: leia nosso guia detalhado sobre GPU no Kubernetes
Nós Spot ou Preemptíveis
Nós Spot ou preemptíveis são econômicos, mas podem ser recuperados pelo provedor de nuvem a qualquer momento. Esses nós geralmente recebem taints para garantir que apenas workloads tolerantes a falhas e sem estado sejam agendados neles. Ao aplicar um taint como instance-type=spot:NoSchedule a esses nós e configurar tolerations nos pods adequados, os administradores podem garantir que apenas pods capazes de lidar com interrupções rodem nesses nós.
Essa estratégia permite que as organizações otimizem custos mantendo a confiabilidade dos workloads críticos. Pods sem a toleration não serão agendados em nós Spot, evitando encerramentos inesperados de serviços com estado ou de alta disponibilidade. Usar taints e tolerations dessa forma simplifica a alocação de recursos do cluster e protege aplicações essenciais do risco de preempção.
Conteúdo relacionado: leia nosso guia detalhado sobre instâncias Spot com Karpenter
Workloads de Sistema e de Infraestrutura
Workloads de sistema e de infraestrutura, como core DNS, agentes de monitoramento ou plugins de rede, muitas vezes precisam rodar em todos os nós ou em um subconjunto específico. É possível aplicar taints aos nós para repelir workloads de aplicação em geral, enquanto a adição de tolerations aos pods críticos do sistema garante que eles ainda possam ser agendados. Por exemplo, um nó com o taint node-role.kubernetes.io/infra:NoSchedule só executará pods com uma toleration correspondente, impedindo que pods comuns de aplicação consumam recursos dos nós de infraestrutura.
Essa abordagem mantém uma separação clara entre workloads de sistema e de usuário, melhorando a confiabilidade e a capacidade de gestão. Também possibilita a priorização de recursos, já que os nós de infraestrutura podem ser dimensionados e gerenciados separadamente dos nós de aplicação. Usar taints e tolerations para workloads de sistema é um padrão comum em clusters de produção para garantir que serviços críticos sempre tenham os recursos de que precisam.
Operadores de Toleration no Kubernetes
Operador Equal
O operador Equal exige que a key e o value de uma toleration correspondam exatamente ao taint. O effect também deve corresponder quando especificado. Esse operador é útil quando um pod deve tolerar um taint específico, e não todos os taints que usam a mesma key.
Por exemplo, uma toleration com key: "hardware", operator: "Equal", value: "gpu" e effect: "NoSchedule" corresponde a um taint hardware=gpu:NoSchedule. Ela não corresponde a hardware=cpu:NoSchedule. Equal é o operador padrão quando o campo operator é omitido.
Operador Exists
O operador Exists corresponde a um taint com base na sua key, sem exigir um value correspondente. Ao usar Exists, o campo value da toleration deve ser omitido. Se um effect for especificado, o taint também deve ter esse effect para que a toleration corresponda.
Por exemplo, uma toleration com key: "hardware", operator: "Exists" e effect: "NoSchedule" tolera qualquer taint NoSchedule com a key hardware, independentemente do seu value. Se a key também for omitida, Exists pode corresponder a todas as keys de taint, respeitando o effect especificado, se houver. Isso torna o operador útil para tolerations amplas, mas ele deve ser usado com cautela, pois pode permitir pods em uma gama maior de nós com taint.
Operador Gt
O operador Gt (maior que) corresponde a um taint quando o value do taint é numericamente maior que o value da toleration. A key deve corresponder, e o effect também deve corresponder quando especificado. Ambos os valores devem ser inteiros de 64 bits válidos, sem zeros à esquerda. O Gt foi introduzido como recurso alfa no Kubernetes v1.35 e requer o feature gate TaintTolerationComparisonOperators.
Por exemplo, uma toleration com key: "node-sla", operator: "Gt", value: "950" e effect: "NoSchedule" corresponde a um taint node-sla=990:NoSchedule. Ela não corresponde a node-sla=900:NoSchedule. Esse operador é útil para alocação baseada em limiares, como permitir um pod apenas em nós cuja pontuação de confiabilidade ultrapasse um mínimo.
Operador Lt
O operador Lt (menor que) corresponde a um taint quando o value do taint é numericamente menor que o value da toleration. Assim como no Gt, a key deve corresponder, o effect deve corresponder quando especificado e ambos os valores devem ser inteiros válidos. O Lt também é alfa no Kubernetes v1.35 e é controlado pelo mesmo feature gate.
Por exemplo, uma toleration com key: "failure-probability", operator: "Lt", value: "5" e effect: "NoSchedule" tolera um taint failure-probability=2:NoSchedule, mas não failure-probability=8:NoSchedule. Isso torna o operador útil para nós Spot ou preemptíveis. Observe que os valores de taint definidos durante o registro do nó não são validados, então um value de taint não numérico faz com que a toleration não corresponda.
Efeitos de Taint no Kubernetes
Vamos analisar os efeitos de taint oferecidos pelo Kubernetes, que as tolerations podem contornar.
NoSchedule
O efeito NoSchedule impede que novos pods sejam agendados em um nó, a menos que tenham uma toleration correspondente. Pods que já estão em execução no nó quando o taint é adicionado não são despejados. Isso torna o NoSchedule útil para reservar nós para workloads específicos sem interromper pods existentes.
Por exemplo, adicionar um taint hardware=gpu:NoSchedule impede que pods sem uma toleration correspondente sejam agendados no nó com GPU a partir daquele momento. Pods que já estão rodando ali podem continuar em execução.
PreferNoSchedule
O efeito PreferNoSchedule é uma restrição flexível de agendamento. O Kubernetes tenta evitar colocar pods sem uma toleration correspondente no nó com taint, mas ainda pode agendá-los ali quando necessário. Diferente do NoSchedule, ele não bloqueia o agendamento de forma estrita.
Esse efeito é útil quando os administradores preferem reservar nós para certos workloads, mas ainda querem que o scheduler use esses nós quando as outras opções de alocação forem limitadas. Pods existentes não são despejados quando um taint PreferNoSchedule é adicionado.
NoExecute
O efeito NoExecute afeta tanto o agendamento quanto os pods que já estão rodando em um nó. Novos pods sem uma toleration correspondente não podem ser agendados ali, enquanto pods existentes que não toleram o taint são despejados.
Uma toleration pode incluir tolerationSeconds para permitir que um pod permaneça temporariamente no nó depois que um taint NoExecute correspondente surgir. Após esse período expirar, o pod é despejado se o taint persistir. Se tolerationSeconds for omitido, uma toleration correspondente permite que o pod permaneça enquanto o taint estiver presente.
Exemplos de Tolerations no Kubernetes
Exemplo 1: Toleration NoSchedule Básica
Suponha que um nó tenha o taint workload=analytics:NoSchedule. Um pod precisa de uma toleration correspondente para se tornar elegível ao agendamento nesse nó. O pod a seguir tolera esse taint específico:
apiVersion: v1kind: Podmetadata: name: analytics-podspec: containers: - name: web image: nginx:latest tolerations: - key: "workload" operator: "Equal" value: "analytics" effect: "NoSchedule"O operador Equal exige que tanto a key quanto o value correspondam ao taint. Essa toleration permite que o pod seja agendado em nós com o taint especificado, mas não exige que o scheduler coloque o pod em um desses nós.
Exemplo 2: Tolerando Qualquer Value de um Taint
O operador Exists pode ser usado quando um pod deve tolerar uma key de taint independentemente do seu value. Por exemplo, a configuração a seguir tolera qualquer taint NoSchedule cuja key seja workload:
apiVersion: v1kind: Podmetadata: name: compute-podspec: containers: - name: worker image: busybox:latest tolerations: - key: "workload" operator: "Exists" effect: "NoSchedule"Nenhum value é especificado ao usar Exists. Como resultado, esse pod pode tolerar taints como workload=database:NoSchedule e workload=batch:NoSchedule. Outras keys ou effects de taint ainda exigem tolerations correspondentes separadas.
Exemplo 3: NoExecute com tolerationSeconds
Uma toleration NoExecute pode incluir tolerationSeconds para controlar por quanto tempo um pod permanece em um nó após a aplicação de um taint correspondente. O pod a seguir tolera um taint maintenance-window=active:NoExecute por 100 segundos:
apiVersion: v1kind: Podmetadata: name: maintenance-workerspec: containers: - name: worker image: busybox:latest tolerations: - key: "maintenance-window" operator: "Equal" value: "active" effect: "NoExecute" tolerationSeconds: 100Se o taint for adicionado enquanto o pod estiver em execução, o pod pode permanecer no nó por até 100 segundos. Se o taint ainda existir após esse período, o Kubernetes despeja o pod. Se o taint for removido antes de o período expirar, o pod pode continuar em execução.
Boas Práticas de Tolerations no Kubernetes
Use Tolerations Apenas em Workloads que Precisam Delas
Adicione tolerations apenas quando um workload tiver um motivo claro para rodar em nós com taint. Tolerations amplas ou desnecessárias enfraquecem o isolamento que os taints devem proporcionar e podem permitir workloads em nós reservados para outros fins. Isso pode gerar disputa por recursos e tornar a alocação de nós menos previsível.
Revise as tolerations conforme os requisitos dos workloads mudarem. Evite tolerations genéricas com Exists, a menos que o pod realmente precise tolerar uma ampla variedade de taints. Prefira keys, values e effects com escopo restrito, para que cada workload receba apenas as permissões de agendamento de que precisa.
Também é útil gerenciar as tolerations no nível do controlador de workload, como em um Deployment, StatefulSet ou DaemonSet. Isso mantém o comportamento de agendamento consistente quando os pods são recriados ou escalados.
Combine Tolerations com Afinidade de Nós
Uma toleration torna um pod elegível para rodar em um nó com taint, mas não direciona o pod para esse nó. Se um workload deve rodar especificamente em um determinado pool de nós, combine tolerations com afinidade de nós ou node selectors.
Por exemplo, um workload de GPU pode tolerar um taint de nó de GPU e, ao mesmo tempo, usar afinidade de nós para exigir nós rotulados com o tipo de GPU apropriado. O taint mantém workloads comuns afastados, enquanto a afinidade direciona o workload de GPU para nós compatíveis.
Escolha entre afinidade de nós obrigatória (required) ou preferencial (preferred) com base em quão rígida a alocação precisa ser. A afinidade obrigatória impede o agendamento em nós que não correspondem, enquanto a preferencial dá ao scheduler mais flexibilidade quando não há nós adequados disponíveis.
Mantenha Taints e Tolerations Consistentes entre os Pools de Nós
Use um esquema de nomenclatura consistente para keys e values de taints em todos os pools de nós. Valores inconsistentes, como workload=gpu, type=gpu e node=gpu para a mesma finalidade, dificultam a manutenção das configurações dos pods e aumentam o risco de erros de agendamento.
Defina taints padrão para as funções de nó mais comuns e aplique-os por meio de automação de cluster ou de infraestrutura. Os manifestos dos workloads podem então usar tolerations previsíveis em desenvolvimento, staging e produção, sem diferenças de configuração desnecessárias.
A consistência é especialmente importante quando os nós são criados ou substituídos automaticamente por sistemas de autoescalonamento de cluster. Os novos nós devem receber os taints e rótulos esperados durante o provisionamento, para que os workloads se comportem da mesma forma, independentemente de qual instância de nó estiver em execução.
Proteja Nós Especializados e Caros
Use taints para impedir que pods de uso geral consumam recursos especializados, como GPUs, instâncias com muita memória ou outros hardwares caros. Apenas workloads projetados para usar esses recursos devem receber as tolerations correspondentes.
Tolerations sozinhas não garantem que um pod de fato solicite o recurso especializado. Para workloads de GPU, por exemplo, configure as solicitações ou limites de recursos apropriados, além da toleration. A afinidade de nós pode oferecer controle adicional de alocação quando há vários tipos de hardware disponíveis.
Essa abordagem ajuda a evitar que workloads de baixa prioridade ocupem a capacidade necessária para aplicações especializadas. Também pode reduzir custos de infraestrutura, mantendo nós caros disponíveis para workloads que podem se beneficiar do seu hardware.
Monitore os Resultados do Agendamento, Não Apenas a Configuração
Uma toleration válida não garante que um pod será agendado com sucesso. Disponibilidade de recursos, afinidade de nós, restrições de topologia, afinidade e antiafinidade de pods e outras regras do scheduler ainda podem impedir a alocação.
Monitore pods pendentes, eventos do scheduler, taints dos nós e a alocação real dos pods para verificar se as políticas de agendamento se comportam como esperado. Comandos como kubectl describe pod e kubectl describe node podem ajudar a identificar incompatibilidades de taint e outras restrições de agendamento.
O monitoramento também deve detectar alocações inesperadas, e não apenas pods que permanecem pendentes. Um workload rodando com sucesso no pool de nós errado pode indicar tolerations amplas demais ou regras de afinidade ausentes. Verificações periódicas ajudam a garantir que as políticas de agendamento continuem funcionando à medida que o cluster e seus workloads mudam.
FAQ
O que é uma toleration no Kubernetes? Uma toleration é uma configuração na spec de um pod que permite que ele seja agendado em nós com taints correspondentes. Ela apenas permite o agendamento. Não garante que o pod seja alocado em um nó com taint, porque as solicitações de recursos e a afinidade de nós ainda se aplicam.
Qual é a diferença entre um taint e uma toleration? Taints são aplicados aos nós e repelem pods que não têm uma toleration correspondente. Tolerations são aplicadas aos pods e permitem, mas não exigem, o agendamento em nós com taints correspondentes.
Qual é a diferença entre os operadores Equal e Exists? O Equal exige que a key, o value e o effect da toleration correspondam ao taint, e é o padrão quando nenhum operador é definido. O Exists corresponde apenas pela key, então o value deve ser omitido, e ele tolera qualquer value para essa key.
O que fazem os efeitos NoSchedule, PreferNoSchedule e NoExecute? O NoSchedule bloqueia novos pods sem uma toleration correspondente, mas não mexe nos pods em execução. O PreferNoSchedule é uma versão flexível em que o scheduler tenta evitar o nó. O NoExecute também despeja pods em execução que não toleram o taint.
O que faz o tolerationSeconds? Em uma toleration NoExecute, o tolerationSeconds define por quanto tempo um pod pode permanecer em um nó depois que um taint correspondente surge. Quando esse tempo passa e o taint ainda está lá, o Kubernetes despeja o pod. Se for omitido, o pod permanece enquanto o taint estiver presente.
Uma toleration faz um pod rodar em um nó com taint? Não. Uma toleration apenas torna o pod elegível. Para direcionar um pod a um pool de nós específico, combine a toleration com afinidade de nós ou um node selector.
Tornando o Agendamento Baseado em Tolerations Mais Eficiente com o PerfectScale
Taints e tolerations decidem onde os pods podem rodar, mas não dizem nada sobre se esses nós estão dimensionados corretamente ou se os workloads alocados neles estão solicitando a quantidade certa de CPU e memória. O PerfectScale é uma plataforma de otimização e governança de Kubernetes que é implantada com um único comando Helm e, a partir daí, entrega insights acionáveis e otimização autônoma em toda a stack K8s — workloads, nós e autoscalers —, para que pools de nós reservados, especializados e caros sejam de fato usados com eficiência.
Principais recursos do PerfectScale:
- Right-sizing autônomo de workloads: o Podfit oferece uma visão granular da saúde e do custo do cluster, destaca recursos desperdiçados e problemas de resiliência e otimiza workloads de forma autônoma, com recomendações de right-sizing baseadas em dados que você pode automatizar.
- Insights de utilização no nível dos nós: o Infrafit revela capacidade ociosa de nós e recomenda os tipos de nó certos para seus workloads, para que pools de nós dedicados, de GPU e outros com taint entreguem desempenho máximo sem que você pague por capacidade não utilizada.
- Otimização de autoscalers: o PerfectScale se integra a HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot, maximizando a eficácia dos sistemas que provisionam e substituem seus nós com taint.
- Alertas em tempo real com priorização automática: riscos de resiliência e anomalias de custo são destacados com priorização orientada por impacto e entregues diretamente no Slack, Datadog, MS Teams ou PagerDuty, antes de chegarem aos seus usuários ou à sua conta de nuvem.
- Tendências, governança e previsão: o relatório Trends oferece visibilidade aprofundada das métricas de custo, desperdício e risco ao longo do tempo, em clusters, grupos de nós, namespaces e workloads, apoiando a análise de causa raiz e um planejamento de orçamento preciso.
- Qualquer ambiente Kubernetes: o PerfectScale roda em clusters on-premise e na nuvem, incluindo OpenShift, EKS, GKE, AKS e ambientes híbridos, com suporte a contêineres Windows e a workloads efêmeros ou de ML, como jobs do Airflow e do Spark.