


Cosa sono le tolerations di Kubernetes?
Le tolerations di Kubernetes vengono applicate ai pod per consentire loro di "tollerare" i taint dei nodi. Mentre i taint respingono un insieme di pod da un nodo, le tolerations corrispondenti permettono allo scheduler di collocare quei pod sul nodo con taint.
Le tolerations sono definite nella specifica del pod e indicano allo scheduler di Kubernetes che un pod può essere eseguito su nodi con taint specifici, aggirando di fatto le restrizioni imposte da tali taint. Questa capacità è importante per scenari avanzati di posizionamento e isolamento dei workloads. Le tolerations non garantiscono lo scheduling su un nodo con taint: si limitano a consentirlo. La decisione effettiva di scheduling dipende anche da altri fattori, come le resource request e la node affinity.
Effect dei taint:
- NoSchedule: impedisce ai nuovi pod privi di una toleration corrispondente di essere schedulati sul nodo.
- PreferNoSchedule: una versione soft in cui lo scheduler cerca di evitare il nodo, senza esservi obbligato.
- NoExecute: espelle i pod in esecuzione, immediatamente o dopo un tempo prestabilito, se privi della toleration.
Operatori delle tolerations:
- Equal: key, value ed effect devono corrispondere esplicitamente al taint.
- Exists: devono corrispondere solo key ed effect; il valore viene ignorato.
- Gt: il valore del taint deve essere un intero maggiore del valore della toleration (introdotto nella v1.35).
- Lt: il valore del taint deve essere un intero minore del valore della toleration (introdotto nella v1.35).
Esempio di configurazione YAML:
apiVersion: v1kind: Podmetadata: name: database-podspec: tolerations: - key: "workload" operator: "Equal" value: "database" effect: "NoSchedule"Questo articolo fa parte di una serie di approfondimenti sullo scheduling di Kubernetes
In questo articolo:
- Come funzionano le tolerations di Kubernetes
- Taint vs. tolerations in Kubernetes
- Casi d'uso comuni delle tolerations di Kubernetes
- Gli operatori delle tolerations di Kubernetes
- Gli effect dei taint di Kubernetes
- Esempi di tolerations in Kubernetes
- Best practice per le tolerations di Kubernetes
Come funzionano le tolerations di Kubernetes
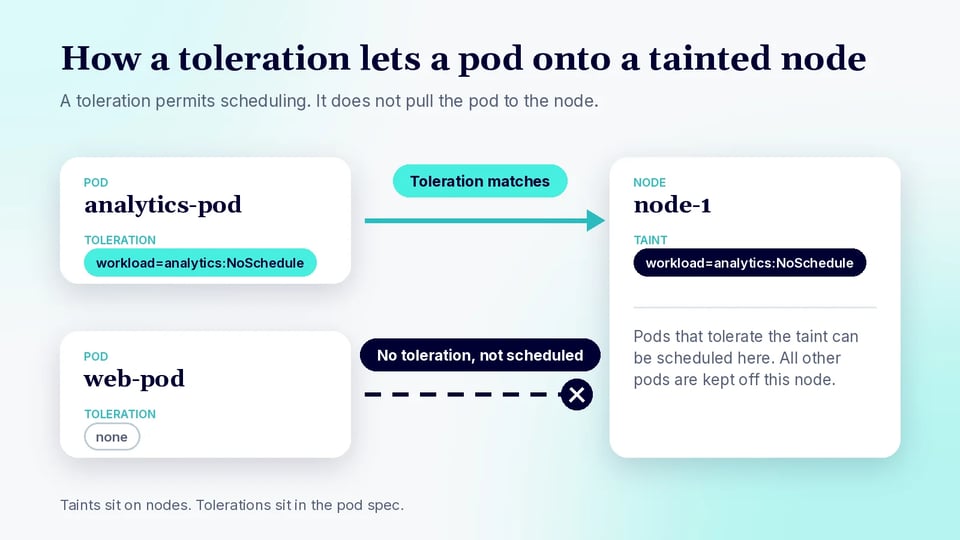
Le tolerations di Kubernetes vengono specificate nel manifest di un pod, nel campo tolerations. Ogni toleration è composta da key, operator, value ed effect. Quando viene creato un pod, lo scheduler verifica gli eventuali taint presenti sui nodi e li confronta con le tolerations del pod. Se il taint di un nodo corrisponde a una toleration del pod, il pod diventa idoneo a essere schedulato su quel nodo. In caso contrario, il pod non verrà schedulato lì oppure, se già in esecuzione, potrà essere espulso a seconda dell'effect del taint.
Questo meccanismo consente un controllo granulare dello scheduling, garantendo che solo i pod con autorizzazioni specifiche, espresse come tolerations, siano ammessi sui nodi con determinati taint. L'interazione tra i taint sui nodi e le tolerations sui pod è alla base delle strategie di isolamento dei nodi, come dedicare nodi a workloads speciali, impedire che workloads sensibili vengano eseguiti su infrastrutture condivise o garantire che solo pod compatibili girino su hardware specializzato.
Taint vs. tolerations in Kubernetes
Taint e tolerations sono le due facce della stessa medaglia nello scheduling di Kubernetes. I taint vengono applicati ai nodi e fungono da meccanismo di respingimento, indicando che su quei nodi dovrebbero essere schedulati solo i pod con tolerations corrispondenti. In questo modo si evita che i workloads vengano schedulati inavvertitamente su nodi non adatti, ad esempio nodi con hardware specializzato o riservati a scopi specifici.
Le tolerations si applicano ai pod. Specificano quali taint un pod può tollerare, permettendogli così di essere schedulato su nodi che presentano tali taint. Le tolerations non forzano lo scheduling sui nodi con taint, ma lo rendono possibile in combinazione con altre policy di scheduling. L'insieme di taint e tolerations offre un framework flessibile per l'isolamento dei workloads, la gestione delle risorse e l'uso efficiente dell'infrastruttura del cluster.
| Aspetto | Taint | Tolerations |
|---|---|---|
| Si applicano a | Nodi | Pod |
| Scopo | Impedire lo scheduling dei pod che non corrispondono al taint | Consentire ai pod di essere schedulati su nodi con taint corrispondenti |
| Effetto sullo scheduling | Limita quali pod possono essere eseguiti su un nodo | Consente, ma non impone, lo scheduling su nodi con taint |
| Caso d'uso comune | Riservare nodi a workloads, hardware o ruoli speciali | Consentire a workloads specifici di usare quei nodi riservati o specializzati |
Casi d'uso comuni delle tolerations di Kubernetes
Nodi dedicati
I nodi dedicati vengono spesso utilizzati per workloads che richiedono isolamento per motivi di sicurezza, compliance o prestazioni. Applicando ai nodi un taint con chiave e valore univoci e aggiungendo le tolerations corrispondenti solo ai pod che devono girarvi, gli amministratori possono garantire che questi nodi restino riservati a workloads specifici. Ciò impedisce che altri pod, potenzialmente meno affidabili, vengano schedulati su hardware dedicato, riducendo il rischio di contesa delle risorse e aumentando la prevedibilità.
Ad esempio, un node pool dedicato alle applicazioni finanziarie può ricevere il taint workload=finance:NoSchedule, e solo i pod con una toleration corrispondente potranno esservi schedulati. Questo approccio è utile anche nei cluster multi-tenant, in cui si vuole garantire che i workloads dei tenant siano isolati a livello di nodo. Applicando con attenzione taint e tolerations è possibile imporre una netta separazione dei workloads e confini di compliance solidi.
Nodi GPU
I nodi GPU sono una risorsa preziosa e spesso limitata all'interno di un cluster Kubernetes. Per garantire che su questi nodi vengano schedulati solo workloads che richiedono accelerazione GPU, gli amministratori di solito applicano ai nodi GPU un taint come hardware=gpu:NoSchedule. Solo i pod con la toleration appropriata saranno idonei a utilizzare i nodi GPU, assicurando che i workloads generici non consumino queste risorse specializzate.
Questo approccio riduce al minimo lo spreco di capacità GPU e previene i conflitti di scheduling. Permette inoltre ai team di controllare l'accesso a hardware costoso, riservandolo a workloads di machine learning, AI o calcolo scientifico. Un uso corretto di taint e tolerations con i nodi GPU è una best practice nei cluster in cui la specializzazione hardware deve essere protetta e sfruttata in modo efficiente.
Contenuti correlati: la nostra guida dettagliata su Kubernetes GPU
Nodi Spot o preemptible
I nodi Spot o preemptible sono convenienti in termini di costi, ma possono essere revocati dal cloud provider in qualsiasi momento. A questi nodi viene spesso applicato un taint per garantire che vi vengano schedulati solo workloads stateless e tolleranti ai guasti. Applicando un taint come instance-type=spot:NoSchedule e configurando le tolerations sui pod adatti, gli amministratori possono assicurarsi che su questi nodi girino solo pod in grado di gestire le interruzioni.
Questa strategia consente alle organizzazioni di ottimizzare i costi mantenendo l'affidabilità dei workloads critici. I pod privi della toleration non verranno schedulati sui nodi Spot, evitando terminazioni impreviste per i servizi stateful o ad alta disponibilità. Usare taint e tolerations in questo modo semplifica l'allocazione delle risorse del cluster e protegge le applicazioni essenziali dal rischio di preemption.
Contenuti correlati: la nostra guida dettagliata alle istanze Spot con Karpenter
Workloads di sistema e di infrastruttura
I workloads di sistema e di infrastruttura, come core DNS, agenti di monitoraggio o plugin di rete, spesso devono essere eseguiti su tutti i nodi o su un sottoinsieme specifico. È possibile applicare taint ai nodi per respingere i workloads applicativi generici, aggiungendo al contempo tolerations ai pod di sistema critici per garantirne comunque lo scheduling. Ad esempio, un nodo con il taint node-role.kubernetes.io/infra:NoSchedule eseguirà solo pod con una toleration corrispondente, impedendo ai normali pod applicativi di consumare le risorse dei nodi di infrastruttura.
Questo approccio mantiene una netta separazione tra workloads di sistema e workloads utente, migliorando affidabilità e gestibilità. Consente inoltre di dare priorità alle risorse, poiché i nodi di infrastruttura possono essere dimensionati e gestiti separatamente dai nodi applicativi. L'uso di taint e tolerations per i workloads di sistema è un pattern comune nei cluster di produzione, per garantire che i servizi critici dispongano sempre delle risorse necessarie.
Gli operatori delle tolerations di Kubernetes
Operatore Equal
L'operatore Equal richiede che key e value della toleration corrispondano esattamente al taint. Anche l'effect deve corrispondere, quando specificato. Questo operatore è utile quando un pod deve tollerare un taint specifico anziché tutti i taint che usano la stessa chiave.
Ad esempio, una toleration con key: "hardware", operator: "Equal", value: "gpu" ed effect: "NoSchedule" corrisponde a un taint hardware=gpu:NoSchedule. Non corrisponde a hardware=cpu:NoSchedule. Equal è l'operatore predefinito quando il campo operator viene omesso.
Operatore Exists
L'operatore Exists fa corrispondere un taint in base alla sua chiave, senza richiedere un valore corrispondente. Quando si usa Exists, il campo value della toleration deve essere omesso. Se viene specificato un effect, anche il taint deve avere quell'effect perché la toleration corrisponda.
Ad esempio, una toleration con key: "hardware", operator: "Exists" ed effect: "NoSchedule" tollera qualsiasi taint NoSchedule con la chiave hardware, indipendentemente dal valore. Se viene omessa anche la chiave, Exists può corrispondere a tutte le chiavi dei taint, nei limiti dell'effect eventualmente specificato. Questo rende l'operatore utile per tolerations ad ampio raggio, ma va usato con cautela, perché può consentire ai pod di finire su una gamma più ampia di nodi con taint.
Operatore Gt
L'operatore Gt (greater than, maggiore di) fa corrispondere un taint quando il value del taint è numericamente maggiore del value della toleration. La key deve corrispondere e anche l'effect deve corrispondere, quando specificato. Entrambi i valori devono essere interi a 64 bit validi, senza zeri iniziali. Gt è stato introdotto come funzionalità alpha in Kubernetes v1.35 e richiede il feature gate TaintTolerationComparisonOperators.
Ad esempio, una toleration con key: "node-sla", operator: "Gt", value: "950" ed effect: "NoSchedule" corrisponde a un taint node-sla=990:NoSchedule. Non corrisponde a node-sla=900:NoSchedule. Questo operatore è utile per il posizionamento basato su soglie, ad esempio per ammettere un pod solo su nodi il cui punteggio di affidabilità supera un valore minimo.
Operatore Lt
L'operatore Lt (less than, minore di) fa corrispondere un taint quando il value del taint è numericamente minore del value della toleration. Come per Gt, la key deve corrispondere, l'effect deve corrispondere quando specificato ed entrambi i valori devono essere interi validi. Anche Lt è in alpha in Kubernetes v1.35 ed è controllato dallo stesso feature gate.
Ad esempio, una toleration con key: "failure-probability", operator: "Lt", value: "5" ed effect: "NoSchedule" tollera un taint failure-probability=2:NoSchedule, ma non failure-probability=8:NoSchedule. Questo rende l'operatore utile per i nodi Spot o preemptible. Da notare che i valori dei taint impostati durante la registrazione del nodo non vengono validati, quindi un valore di taint non numerico fa sì che la toleration non corrisponda.
Gli effect dei taint di Kubernetes
Vediamo gli effect dei taint offerti da Kubernetes, che le tolerations possono scavalcare.
NoSchedule
L'effect NoSchedule impedisce che nuovi pod vengano schedulati su un nodo, a meno che non abbiano una toleration corrispondente. I pod già in esecuzione sul nodo al momento dell'aggiunta del taint non vengono espulsi. Questo rende NoSchedule utile per riservare nodi a workloads specifici senza interrompere i pod esistenti.
Ad esempio, l'aggiunta di un taint hardware=gpu:NoSchedule impedisce ai pod privi di una toleration corrispondente di essere schedulati ex novo sul nodo GPU. I pod già in esecuzione possono continuare a funzionare.
PreferNoSchedule
L'effect PreferNoSchedule è una restrizione di scheduling di tipo soft. Kubernetes cerca di evitare di collocare sul nodo con taint i pod privi di una toleration corrispondente, ma può comunque schedularli lì quando necessario. A differenza di NoSchedule, non blocca rigidamente lo scheduling.
Questo effect è utile quando gli amministratori preferiscono riservare i nodi a determinati workloads, ma vogliono comunque che lo scheduler possa usarli quando le altre opzioni di posizionamento sono limitate. I pod esistenti non vengono espulsi quando viene aggiunto un taint PreferNoSchedule.
NoExecute
L'effect NoExecute incide sia sullo scheduling sia sui pod già in esecuzione su un nodo. I nuovi pod privi di una toleration corrispondente non possono esservi schedulati, mentre i pod esistenti che non tollerano il taint vengono espulsi.
Una toleration può includere tolerationSeconds per permettere a un pod di rimanere temporaneamente sul nodo dopo la comparsa di un taint NoExecute corrispondente. Allo scadere di quel periodo, il pod viene espulso se il taint è ancora presente. Se tolerationSeconds viene omesso, una toleration corrispondente consente al pod di rimanere finché il taint è presente.
Esempi di tolerations in Kubernetes
Esempio 1: toleration NoSchedule di base
Supponiamo che un nodo abbia il taint workload=analytics:NoSchedule. Un pod ha bisogno di una toleration corrispondente per diventare idoneo allo scheduling su quel nodo. Il pod seguente tollera questo taint specifico:
apiVersion: v1kind: Podmetadata: name: analytics-podspec: containers: - name: web image: nginx:latest tolerations: - key: "workload" operator: "Equal" value: "analytics" effect: "NoSchedule"L'operatore Equal richiede che sia la key sia il value corrispondano al taint. Questa toleration consente al pod di accedere ai nodi con il taint specificato, ma non obbliga lo scheduler a collocare il pod su uno di quei nodi.
Esempio 2: tollerare qualsiasi valore di un taint
L'operatore Exists può essere usato quando un pod deve tollerare una chiave di taint indipendentemente dal valore. Ad esempio, la configurazione seguente tollera qualsiasi taint NoSchedule con chiave workload:
apiVersion: v1kind: Podmetadata: name: compute-podspec: containers: - name: worker image: busybox:latest tolerations: - key: "workload" operator: "Exists" effect: "NoSchedule"Quando si usa Exists non viene specificato alcun valore. Di conseguenza, questo pod può tollerare taint come workload=database:NoSchedule e workload=batch:NoSchedule. Altre chiavi o effect di taint richiedono comunque tolerations corrispondenti separate.
Esempio 3: NoExecute con tolerationSeconds
Una toleration NoExecute può includere tolerationSeconds per controllare per quanto tempo un pod rimane su un nodo dopo l'applicazione di un taint corrispondente. Il pod seguente tollera un taint maintenance-window=active:NoExecute per 100 secondi:
apiVersion: v1kind: Podmetadata: name: maintenance-workerspec: containers: - name: worker image: busybox:latest tolerations: - key: "maintenance-window" operator: "Equal" value: "active" effect: "NoExecute" tolerationSeconds: 100Se il taint viene aggiunto mentre il pod è in esecuzione, il pod può rimanere sul nodo fino a 100 secondi. Se dopo quel periodo il taint è ancora presente, Kubernetes espelle il pod. Se il taint viene rimosso prima della scadenza, il pod può continuare a funzionare.
Best practice per le tolerations di Kubernetes
Usare le tolerations solo per i workloads che ne hanno bisogno
Le tolerations vanno aggiunte solo quando un workload ha un motivo chiaro per essere eseguito su nodi con taint. Tolerations troppo ampie o superflue indeboliscono l'isolamento che i taint dovrebbero garantire e possono far finire i workloads su nodi riservati ad altri scopi. Questo può generare contesa delle risorse e rendere meno prevedibile il posizionamento sui nodi.
È opportuno rivedere le tolerations man mano che i requisiti dei workloads cambiano. Meglio evitare tolerations Exists generiche, a meno che il pod non debba davvero tollerare un'ampia gamma di taint. Preferire key, value ed effect con ambito ristretto, in modo che ogni workload riceva solo le autorizzazioni di scheduling di cui ha effettivamente bisogno.
È inoltre utile gestire le tolerations a livello di controller del workload, ad esempio in un Deployment, StatefulSet o DaemonSet. In questo modo il comportamento di scheduling resta coerente quando i pod vengono ricreati o scalati.
Abbinare le tolerations alla node affinity
Una toleration rende un pod idoneo a essere eseguito su un nodo con taint, ma non lo indirizza verso quel nodo. Se un workload deve girare specificamente su un determinato node pool, è consigliabile combinare le tolerations con la node affinity o i node selector.
Ad esempio, un workload GPU può tollerare il taint dei nodi GPU e al tempo stesso usare la node affinity per richiedere nodi etichettati con il tipo di GPU appropriato. Il taint tiene lontani i workloads ordinari, mentre l'affinity indirizza il workload GPU verso i nodi compatibili.
La scelta tra node affinity required e preferred dipende da quanto deve essere rigido il posizionamento. L'affinity required impedisce lo scheduling sui nodi che non corrispondono, mentre quella preferred lascia allo scheduler maggiore flessibilità quando non sono disponibili nodi adatti.
Mantenere taint e tolerations coerenti tra i node pool
Adottare uno schema di denominazione coerente per chiavi e valori dei taint in tutti i node pool. Valori incoerenti come workload=gpu, type=gpu e node=gpu per lo stesso scopo rendono le configurazioni dei pod più difficili da mantenere e aumentano il rischio di errori di scheduling.
Definire taint standard per i ruoli di nodo più comuni e applicarli tramite l'automazione del cluster o dell'infrastruttura. I manifest dei workloads potranno così usare tolerations prevedibili in sviluppo, staging e produzione, senza differenze di configurazione superflue.
La coerenza è particolarmente importante quando i nodi vengono creati o sostituiti automaticamente da sistemi di autoscaling del cluster. I nuovi nodi dovrebbero ricevere i taint e le label previsti durante il provisioning, così che i workloads si comportino allo stesso modo indipendentemente dall'istanza di nodo in esecuzione.
Proteggere i nodi specializzati e costosi
Usare i taint per impedire ai pod generici di consumare risorse specializzate come GPU, istanze ad alta memoria o altro hardware costoso. Solo i workloads progettati per utilizzare tali risorse dovrebbero ricevere le tolerations corrispondenti.
Le tolerations da sole non garantiscono che un pod richieda effettivamente la risorsa specializzata. Per i workloads GPU, ad esempio, oltre alla toleration vanno configurati gli opportuni resource request o limit. La node affinity può offrire un ulteriore controllo sul posizionamento quando sono disponibili più tipi di hardware.
Questo approccio aiuta a evitare che workloads a bassa priorità occupino capacità necessaria alle applicazioni specializzate. Può inoltre ridurre i costi di infrastruttura, mantenendo i nodi costosi disponibili per i workloads in grado di sfruttarne l'hardware.
Monitorare gli esiti dello scheduling, non solo la configurazione
Una toleration valida non garantisce che un pod venga schedulato con successo. Disponibilità delle risorse, node affinity, vincoli di topologia, pod affinity e anti-affinity e altre regole dello scheduler possono comunque impedirne il posizionamento.
Monitorare i pod in stato pending, gli eventi dello scheduler, i taint dei nodi e il posizionamento effettivo dei pod per verificare che le policy di scheduling si comportino come previsto. Comandi come kubectl describe pod e kubectl describe node aiutano a identificare le mancate corrispondenze dei taint e altri vincoli di scheduling.
Il monitoraggio dovrebbe rilevare anche i posizionamenti imprevisti, non solo i pod che restano in pending. Un workload in esecuzione sul node pool sbagliato può indicare tolerations troppo ampie o regole di affinity mancanti. Controlli periodici aiutano a garantire che le policy di scheduling continuino a funzionare man mano che il cluster e i suoi workloads evolvono.
FAQ
Che cos'è una toleration in Kubernetes? Una toleration è un'impostazione nella spec di un pod che consente al pod di essere schedulato su nodi con taint corrispondenti. Si limita a consentire lo scheduling: non garantisce che il pod finisca su un nodo con taint, perché resource request e node affinity restano comunque valide.
Qual è la differenza tra un taint e una toleration? I taint vengono applicati ai nodi e respingono i pod privi di una toleration corrispondente. Le tolerations vengono applicate ai pod e consentono, senza imporlo, lo scheduling su nodi con taint corrispondenti.
Qual è la differenza tra gli operatori Equal ed Exists? Equal richiede che key, value ed effect della toleration corrispondano al taint, ed è l'operatore predefinito quando non ne viene impostato uno. Exists effettua la corrispondenza solo sulla chiave, quindi il valore deve essere omesso, e tollera qualsiasi valore per quella chiave.
Che cosa fanno gli effect NoSchedule, PreferNoSchedule e NoExecute? NoSchedule blocca i nuovi pod privi di una toleration corrispondente, ma non tocca i pod in esecuzione. PreferNoSchedule è una versione soft in cui lo scheduler cerca di evitare il nodo. NoExecute espelle anche i pod in esecuzione che non tollerano il taint.
A cosa serve tolerationSeconds? In una toleration NoExecute, tolerationSeconds stabilisce per quanto tempo un pod può rimanere su un nodo dopo la comparsa di un taint corrispondente. Trascorso quel tempo, se il taint è ancora presente, Kubernetes espelle il pod. Se viene omesso, il pod rimane finché il taint è presente.
Una toleration fa sì che un pod venga eseguito su un nodo con taint? No. Una toleration rende il pod soltanto idoneo. Per indirizzare un pod verso un node pool specifico, occorre abbinare la toleration a una node affinity o a un node selector.
Uno scheduling basato sulle tolerations più efficiente con PerfectScale
Taint e tolerations stabiliscono dove i pod possono essere eseguiti, ma non dicono nulla sul corretto dimensionamento di quei nodi né sul fatto che i workloads che vi approdano richiedano la giusta quantità di CPU e memoria. PerfectScale è una piattaforma di ottimizzazione e governance per Kubernetes che si installa con un singolo comando Helm e fornisce poi insight concreti e ottimizzazione autonoma sull'intero stack K8s, workloads, nodi e autoscaler, affinché i node pool riservati, specializzati e costosi vengano davvero utilizzati in modo efficiente.
Le funzionalità chiave di PerfectScale:
- Right-sizing autonomo dei workloads: Podfit offre una vista granulare dello stato di salute e dei costi del cluster, evidenzia risorse sprecate e problemi di resilienza e ottimizza i workloads in autonomia con raccomandazioni di right-sizing basate sui dati, che è possibile automatizzare.
- Insight sull'utilizzo a livello di nodo: Infrafit fa emergere la capacità inutilizzata dei nodi e consiglia i tipi di nodo giusti per i workloads, così che i node pool dedicati, GPU e con altri taint offrano le massime prestazioni senza pagare capacità inutilizzata.
- Ottimizzazione degli autoscaler: PerfectScale si integra con HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot, massimizzando l'efficacia dei sistemi che effettuano il provisioning e la sostituzione dei nodi con taint.
- Avvisi in tempo reale con prioritizzazione automatica: i rischi di resilienza e le anomalie di costo vengono evidenziati con una prioritizzazione basata sull'impatto e recapitati direttamente su Slack, Datadog, MS Teams o PagerDuty, prima che raggiungano gli utenti o la fattura cloud.
- Trend, governance e previsioni: il report Trends offre una visibilità approfondita nel tempo sulle metriche di costo, spreco e rischio su cluster, gruppi di nodi, namespace e workloads, supportando l'analisi delle cause e una pianificazione accurata dei budget.
- Qualsiasi ambiente Kubernetes: PerfectScale funziona su cluster on-premise e cloud, inclusi OpenShift, EKS, GKE, AKS e configurazioni ibride, con supporto per container Windows e workloads effimeri o di ML come i job Airflow e Spark.