


Que sont les tolerations Kubernetes ?
Les tolerations Kubernetes s'appliquent aux pods pour leur permettre de "tolérer" les taints des nœuds. Tandis que les taints repoussent un ensemble de pods d'un nœud, les tolerations correspondantes permettent au scheduler de placer ces pods sur le nœud porteur du taint.
Les tolerations sont définies dans la spécification du pod et indiquent au scheduler Kubernetes qu'un pod peut s'exécuter sur des nœuds porteurs de taints spécifiques, contournant ainsi les restrictions imposées par ces taints. Cette capacité est essentielle pour les scénarios avancés de placement et d'isolation de workloads. Les tolerations ne garantissent pas la planification sur un nœud porteur d'un taint ; elles la rendent simplement possible. La décision de planification dépend aussi d'autres facteurs comme les requêtes de ressources et l'affinité de nœud.
Effets des taints :
- NoSchedule : empêche la planification sur le nœud des nouveaux pods dépourvus d'une toleration correspondante.
- PreferNoSchedule : version souple où le scheduler tente d'éviter le nœud, sans y être contraint.
- NoExecute : évince immédiatement, ou après un délai défini, les pods en cours d'exécution dépourvus de la toleration.
Opérateurs de tolerations :
- Equal : la clé, la valeur et l'effet doivent correspondre explicitement au taint.
- Exists : seuls la clé et l'effet doivent correspondre ; la valeur est ignorée.
- Gt : la valeur du taint doit être un entier supérieur à la valeur de la toleration (ajouté en v1.35).
- Lt : la valeur du taint doit être un entier inférieur à la valeur de la toleration (ajouté en v1.35).
Exemple de configuration YAML :
apiVersion: v1kind: Podmetadata: name: database-podspec: tolerations: - key: "workload" operator: "Equal" value: "database" effect: "NoSchedule"Cet article fait partie d'une série consacrée à la planification Kubernetes
Dans cet article :
- Fonctionnement des tolerations Kubernetes
- Taints et tolerations Kubernetes : les différences
- Cas d'usage courants des tolerations Kubernetes
- Opérateurs de tolerations Kubernetes
- Effets des taints Kubernetes
- Exemples de tolerations Kubernetes
- Bonnes pratiques pour les tolerations Kubernetes
Fonctionnement des tolerations Kubernetes
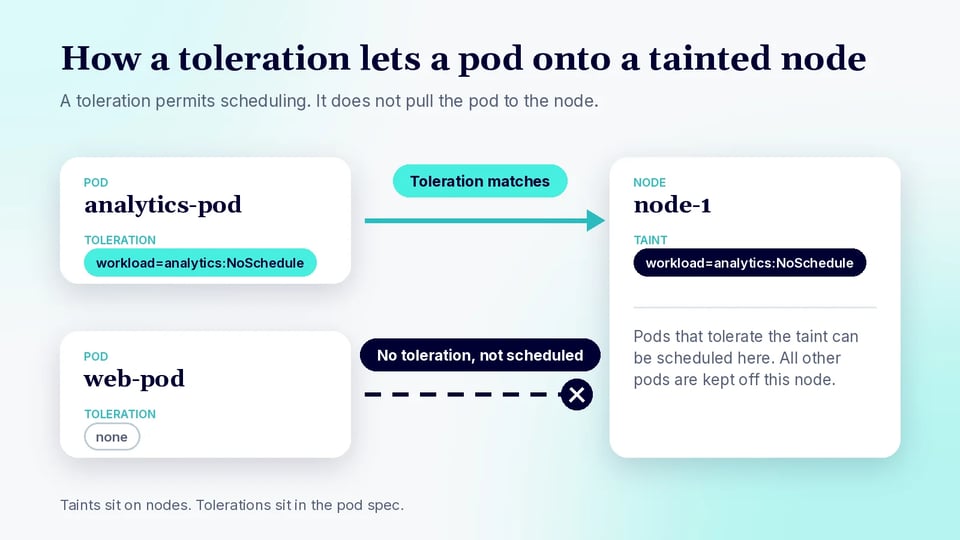
Les tolerations Kubernetes sont déclarées dans le manifeste d'un pod, sous le champ tolerations. Chaque toleration se compose d'une clé, d'un opérateur, d'une valeur et d'un effet. À la création d'un pod, le scheduler vérifie les taints présents sur les nœuds et les compare aux tolerations du pod. Si le taint d'un nœud correspond à une toleration du pod, celui-ci devient éligible à la planification sur ce nœud. Dans le cas contraire, le pod n'y sera pas planifié, ou, s'il y est déjà en cours d'exécution, pourra être évincé selon l'effet du taint.
Ce mécanisme offre un contrôle granulaire de la planification, en garantissant que seuls les pods disposant de permissions spécifiques, exprimées sous forme de tolerations, sont admis sur les nœuds porteurs de certains taints. L'interaction entre taints sur les nœuds et tolerations sur les pods sous-tend les stratégies d'isolation des nœuds : dédier des nœuds à des workloads particuliers, empêcher des workloads sensibles de s'exécuter sur une infrastructure partagée, ou garantir que seuls des pods compatibles s'exécutent sur du matériel spécialisé.
Taints et tolerations Kubernetes : les différences
Taints et tolerations sont les deux faces d'une même médaille dans la planification Kubernetes. Les taints s'appliquent aux nœuds et agissent comme un mécanisme de répulsion, indiquant que seuls les pods dotés de tolerations correspondantes devraient être planifiés sur ces nœuds. Cela évite que des workloads soient planifiés par inadvertance sur des nœuds qui ne leur conviennent pas, comme des nœuds équipés de matériel spécialisé ou réservés à des usages précis.
Les tolerations s'appliquent aux pods. Elles précisent quels taints un pod peut tolérer, ce qui lui permet d'être planifié sur les nœuds porteurs de ces taints. Les tolerations n'imposent pas la planification sur les nœuds porteurs d'un taint, mais la rendent possible lorsqu'elles sont combinées à d'autres règles de planification. L'association des taints et des tolerations offre un cadre flexible pour l'isolation des workloads, la gestion des ressources et l'utilisation efficace de l'infrastructure du cluster.
| Aspect | Taints | Tolerations |
|---|---|---|
| S'appliquent aux | Nœuds | Pods |
| Objectif | Empêcher la planification des pods qui ne correspondent pas au taint | Autoriser la planification des pods sur les nœuds porteurs de taints correspondants |
| Effet sur la planification | Restreint les pods pouvant s'exécuter sur un nœud | Autorise, sans l'imposer, la planification sur des nœuds porteurs d'un taint |
| Cas d'usage courant | Réserver des nœuds à des workloads, du matériel ou des rôles spécifiques | Permettre à des workloads spécifiques d'utiliser ces nœuds réservés ou spécialisés |
Cas d'usage courants des tolerations Kubernetes
Nœuds dédiés
Les nœuds dédiés sont souvent utilisés pour des workloads nécessitant une isolation pour des raisons de sécurité, de conformité ou de performance. En appliquant aux nœuds un taint avec une clé et une valeur uniques, et en n'ajoutant les tolerations correspondantes qu'aux pods censés s'y exécuter, les administrateurs s'assurent que ces nœuds restent réservés à des workloads spécifiques. Cela empêche d'autres pods, potentiellement moins fiables, d'être planifiés sur du matériel dédié, réduisant le risque de contention des ressources et améliorant la prévisibilité.
Par exemple, un pool de nœuds dédié aux applications financières peut porter le taint workload=finance:NoSchedule : seuls les pods dotés de la toleration correspondante pourront y être planifiés. Cette approche est également utile dans les clusters multi-tenants, où l'on souhaite garantir que les workloads des différents tenants sont isolés au niveau des nœuds. En appliquant soigneusement taints et tolerations, vous pouvez imposer une séparation stricte des workloads et des frontières de conformité solides.
Nœuds GPU
Les nœuds GPU constituent une ressource précieuse et souvent limitée au sein d'un cluster Kubernetes. Pour garantir que seuls les workloads nécessitant une accélération GPU y soient planifiés, les administrateurs appliquent généralement aux nœuds GPU un taint tel que hardware=gpu:NoSchedule. Seuls les pods dotés de la toleration appropriée pourront utiliser les nœuds GPU, ce qui évite que des workloads génériques consomment ces ressources spécialisées.
Cette approche limite le gaspillage de capacité GPU et prévient les conflits de planification. Elle permet aussi aux équipes de contrôler l'accès à du matériel coûteux, en le réservant aux workloads de machine learning, d'IA ou de calcul scientifique. L'utilisation adéquate des taints et tolerations avec les nœuds GPU est une bonne pratique dans les clusters où la spécialisation matérielle doit être protégée et exploitée efficacement.
Contenu associé : consultez notre guide détaillé sur Kubernetes GPU
Nœuds Spot ou préemptibles
Les nœuds Spot ou préemptibles sont économiques, mais peuvent être récupérés à tout moment par le fournisseur cloud. Ces nœuds portent souvent un taint afin de garantir que seuls des workloads stateless et tolérants aux pannes y soient planifiés. En appliquant à ces nœuds un taint comme instance-type=spot:NoSchedule et en configurant les tolerations sur les pods adaptés, les administrateurs s'assurent que seuls les pods capables de gérer les interruptions s'y exécutent.
Cette stratégie permet aux organisations d'optimiser leurs coûts tout en préservant la fiabilité des workloads critiques. Les pods dépourvus de la toleration ne seront pas planifiés sur les nœuds Spot, ce qui évite des arrêts inattendus pour les services stateful ou à haute disponibilité. Utilisés de cette manière, taints et tolerations rationalisent l'allocation des ressources du cluster et protègent les applications essentielles du risque de préemption.
Contenu associé : consultez notre guide détaillé sur les instances Spot avec Karpenter
Workloads système et d'infrastructure
Les workloads système et d'infrastructure, comme CoreDNS, les agents de monitoring ou les plugins réseau, doivent souvent s'exécuter sur tous les nœuds ou sur un sous-ensemble précis. On peut appliquer des taints aux nœuds pour repousser les workloads applicatifs génériques, tout en ajoutant des tolerations aux pods système critiques afin qu'ils restent planifiables. Par exemple, un nœud portant le taint node-role.kubernetes.io/infra:NoSchedule n'exécutera que des pods dotés de la toleration correspondante, empêchant les pods applicatifs ordinaires de consommer les ressources des nœuds d'infrastructure.
Cette approche maintient une séparation nette entre workloads système et workloads utilisateurs, améliorant la fiabilité et la facilité de gestion. Elle permet également de prioriser les ressources, puisque les nœuds d'infrastructure peuvent être dimensionnés et gérés indépendamment des nœuds applicatifs. L'usage des taints et tolerations pour les workloads système est une pratique courante dans les clusters de production, garantissant que les services critiques disposent toujours des ressources nécessaires.
Opérateurs de tolerations Kubernetes
Opérateur Equal
L'opérateur Equal exige que la clé et la valeur de la toleration correspondent exactement au taint. L'effet doit également correspondre lorsqu'il est spécifié. Cet opérateur est utile lorsqu'un pod doit tolérer un taint précis plutôt que tous les taints utilisant la même clé.
Par exemple, une toleration avec key: "hardware", operator: "Equal", value: "gpu" et effect: "NoSchedule" correspond à un taint hardware=gpu:NoSchedule. Elle ne correspond pas à hardware=cpu:NoSchedule. Equal est l'opérateur par défaut lorsque le champ operator est omis.
Opérateur Exists
L'opérateur Exists fait correspondre un taint sur la base de sa clé, sans exiger de valeur correspondante. Avec Exists, le champ value de la toleration doit être omis. Si un effect est spécifié, le taint doit également comporter cet effet pour que la toleration corresponde.
Par exemple, une toleration avec key: "hardware", operator: "Exists" et effect: "NoSchedule" tolère n'importe quel taint NoSchedule portant la clé hardware, quelle que soit sa valeur. Si la clé est elle aussi omise, Exists peut correspondre à toutes les clés de taints, sous réserve de l'effet éventuellement spécifié. Cet opérateur est donc utile pour des tolerations larges, mais il doit être utilisé avec précaution, car il peut admettre des pods sur un éventail plus large de nœuds porteurs de taints.
Opérateur Gt
L'opérateur Gt (greater than) correspond à un taint lorsque la value du taint est numériquement supérieure à la value de la toleration. La key doit correspondre, et l'effect doit également correspondre lorsqu'il est spécifié. Les deux valeurs doivent être des entiers 64 bits valides, sans zéros initiaux. Gt a été introduit en version alpha dans Kubernetes v1.35 et nécessite la feature gate TaintTolerationComparisonOperators.
Par exemple, une toleration avec key: "node-sla", operator: "Gt", value: "950" et effect: "NoSchedule" correspond à un taint node-sla=990:NoSchedule. Elle ne correspond pas à node-sla=900:NoSchedule. Cet opérateur est utile pour un placement basé sur des seuils, par exemple pour n'autoriser un pod que sur des nœuds dont le score de fiabilité dépasse un minimum.
Opérateur Lt
L'opérateur Lt (less than) correspond à un taint lorsque la value du taint est numériquement inférieure à la value de la toleration. Comme pour Gt, la key doit correspondre, l'effect doit correspondre lorsqu'il est spécifié, et les deux valeurs doivent être des entiers valides. Lt est également en alpha dans Kubernetes v1.35 et dépend de la même feature gate.
Par exemple, une toleration avec key: "failure-probability", operator: "Lt", value: "5" et effect: "NoSchedule" tolère un taint failure-probability=2:NoSchedule, mais pas failure-probability=8:NoSchedule. Cet opérateur est donc utile pour les nœuds Spot ou préemptibles. Notez que les valeurs de taints définies lors de l'enregistrement d'un nœud ne sont pas validées : une valeur de taint non numérique empêche la correspondance de la toleration.
Effets des taints Kubernetes
Passons en revue les effets de taints proposés par Kubernetes, que les tolerations peuvent neutraliser.
NoSchedule
L'effet NoSchedule empêche la planification de nouveaux pods sur un nœud, sauf s'ils disposent d'une toleration correspondante. Les pods déjà en cours d'exécution sur le nœud au moment de l'ajout du taint ne sont pas évincés. NoSchedule est donc utile pour réserver des nœuds à des workloads spécifiques sans perturber les pods existants.
Par exemple, l'ajout d'un taint hardware=gpu:NoSchedule empêche la planification de nouveaux pods sans toleration correspondante sur le nœud GPU. Les pods qui y tournent déjà peuvent continuer de s'exécuter.
PreferNoSchedule
L'effet PreferNoSchedule est une restriction de planification souple. Kubernetes tente d'éviter de placer sur le nœud porteur du taint les pods sans toleration correspondante, mais peut tout de même les y planifier si nécessaire. Contrairement à NoSchedule, il ne bloque pas strictement la planification.
Cet effet est utile lorsque les administrateurs préfèrent réserver des nœuds à certains workloads, tout en laissant le scheduler les utiliser lorsque les autres options de placement sont limitées. Les pods existants ne sont pas évincés à l'ajout d'un taint PreferNoSchedule.
NoExecute
L'effet NoExecute agit à la fois sur la planification et sur les pods déjà en cours d'exécution sur un nœud. Les nouveaux pods sans toleration correspondante ne peuvent pas y être planifiés, tandis que les pods existants qui ne tolèrent pas le taint sont évincés.
Une toleration peut inclure tolerationSeconds pour permettre à un pod de rester temporairement sur le nœud après l'apparition d'un taint NoExecute correspondant. Une fois ce délai écoulé, le pod est évincé si le taint est toujours présent. Si tolerationSeconds est omis, une toleration correspondante permet au pod de rester tant que le taint est présent.
Exemples de tolerations Kubernetes
Exemple 1 : toleration NoSchedule de base
Supposons qu'un nœud porte le taint workload=analytics:NoSchedule. Un pod a besoin d'une toleration correspondante pour devenir éligible à la planification sur ce nœud. Le pod suivant tolère ce taint spécifique :
apiVersion: v1kind: Podmetadata: name: analytics-podspec: containers: - name: web image: nginx:latest tolerations: - key: "workload" operator: "Equal" value: "analytics" effect: "NoSchedule"L'opérateur Equal exige que la key et la value correspondent toutes deux au taint. Cette toleration autorise le pod sur les nœuds porteurs du taint spécifié, mais n'oblige pas le scheduler à le placer sur l'un de ces nœuds.
Exemple 2 : tolérer n'importe quelle valeur d'un taint
L'opérateur Exists peut être utilisé lorsqu'un pod doit tolérer une clé de taint quelle que soit sa valeur. Par exemple, la configuration suivante tolère tout taint NoSchedule dont la clé est workload :
apiVersion: v1kind: Podmetadata: name: compute-podspec: containers: - name: worker image: busybox:latest tolerations: - key: "workload" operator: "Exists" effect: "NoSchedule"Aucune valeur n'est spécifiée avec Exists. Ce pod peut donc tolérer des taints tels que workload=database:NoSchedule et workload=batch:NoSchedule. Les autres clés ou effets de taints nécessitent toujours des tolerations correspondantes distinctes.
Exemple 3 : NoExecute avec tolerationSeconds
Une toleration NoExecute peut inclure tolerationSeconds pour contrôler la durée pendant laquelle un pod reste sur un nœud après l'application d'un taint correspondant. Le pod suivant tolère un taint maintenance-window=active:NoExecute pendant 100 secondes :
apiVersion: v1kind: Podmetadata: name: maintenance-workerspec: containers: - name: worker image: busybox:latest tolerations: - key: "maintenance-window" operator: "Equal" value: "active" effect: "NoExecute" tolerationSeconds: 100Si le taint est ajouté alors que le pod est en cours d'exécution, celui-ci peut rester sur le nœud jusqu'à 100 secondes. Si le taint existe toujours après ce délai, Kubernetes évince le pod. Si le taint est supprimé avant l'expiration du délai, le pod peut continuer de s'exécuter.
Bonnes pratiques pour les tolerations Kubernetes
N'utiliser les tolerations que pour les workloads qui en ont besoin
N'ajoutez des tolerations que lorsqu'un workload a une raison claire de s'exécuter sur des nœuds porteurs de taints. Des tolerations trop larges ou superflues affaiblissent l'isolation que les taints sont censés garantir et peuvent admettre des workloads sur des nœuds réservés à d'autres usages. Il peut en résulter une contention des ressources et un placement moins prévisible.
Révisez les tolerations à mesure que les besoins des workloads évoluent. Évitez les tolerations Exists génériques, sauf si le pod doit réellement tolérer un large éventail de taints. Privilégiez des clés, valeurs et effets à portée restreinte afin que chaque workload ne reçoive que les permissions de planification dont il a besoin.
Il est également judicieux de gérer les tolerations au niveau du contrôleur de workload, par exemple dans un Deployment, un StatefulSet ou un DaemonSet. Le comportement de planification reste ainsi cohérent lorsque les pods sont recréés ou mis à l'échelle.
Associer tolerations et affinité de nœud
Une toleration rend un pod éligible à l'exécution sur un nœud porteur d'un taint, mais elle ne l'y dirige pas. Si un workload doit s'exécuter spécifiquement sur un pool de nœuds donné, combinez les tolerations avec l'affinité de nœud ou des node selectors.
Par exemple, un workload GPU peut tolérer le taint des nœuds GPU tout en utilisant l'affinité de nœud pour exiger des nœuds labellisés avec le type de GPU approprié. Le taint tient les workloads ordinaires à l'écart, tandis que l'affinité oriente le workload GPU vers les nœuds compatibles.
Choisissez entre affinité requise et affinité préférée selon le degré de rigueur attendu pour le placement. L'affinité requise empêche la planification sur les nœuds non conformes, tandis que l'affinité préférée laisse plus de latitude au scheduler lorsque les nœuds adéquats sont indisponibles.
Maintenir la cohérence des taints et tolerations entre les pools de nœuds
Utilisez un schéma de nommage cohérent pour les clés et valeurs de taints entre vos pools de nœuds. Des valeurs incohérentes comme workload=gpu, type=gpu et node=gpu pour un même usage compliquent la maintenance des configurations de pods et augmentent le risque d'erreurs de planification.
Définissez des taints standard pour les rôles de nœuds courants et appliquez-les via l'automatisation du cluster ou de l'infrastructure. Les manifestes des workloads peuvent alors utiliser des tolerations prévisibles en développement, en staging et en production, sans différences de configuration inutiles.
La cohérence est particulièrement importante lorsque les nœuds sont créés ou remplacés automatiquement par des systèmes d'autoscaling de cluster. Les nouveaux nœuds doivent recevoir les taints et labels attendus dès le provisioning, afin que les workloads se comportent de la même manière quelle que soit l'instance de nœud en service.
Protéger les nœuds spécialisés et coûteux
Utilisez des taints pour empêcher les pods génériques de consommer des ressources spécialisées telles que les GPU, les instances à forte mémoire ou tout autre matériel onéreux. Seuls les workloads conçus pour exploiter ces ressources devraient recevoir les tolerations correspondantes.
Les tolerations seules ne garantissent pas qu'un pod demande effectivement la ressource spécialisée. Pour les workloads GPU, par exemple, configurez les requêtes ou limites de ressources appropriées en plus de la toleration. L'affinité de nœud peut offrir un contrôle de placement supplémentaire lorsque plusieurs types de matériel sont disponibles.
Cette approche évite que des workloads de faible priorité occupent la capacité nécessaire aux applications spécialisées. Elle peut aussi réduire les coûts d'infrastructure en gardant les nœuds coûteux disponibles pour les workloads qui tirent parti de leur matériel.
Surveiller les résultats de planification, pas seulement la configuration
Une toleration valide ne garantit pas qu'un pod sera planifié avec succès. La disponibilité des ressources, l'affinité de nœud, les contraintes de topologie, l'affinité et l'anti-affinité de pods, ainsi que d'autres règles du scheduler peuvent toujours empêcher le placement.
Surveillez les pods en attente, les événements du scheduler, les taints des nœuds et le placement réel des pods pour vérifier que les politiques de planification se comportent comme prévu. Des commandes telles que kubectl describe pod et kubectl describe node aident à identifier les incohérences de taints et autres contraintes de planification.
La surveillance doit aussi détecter les placements inattendus, et pas seulement les pods qui restent en attente. Un workload qui s'exécute correctement sur le mauvais pool de nœuds peut révéler des tolerations trop larges ou des règles d'affinité manquantes. Des vérifications périodiques permettent de s'assurer que les politiques de planification restent efficaces à mesure que le cluster et ses workloads évoluent.
FAQ
Qu'est-ce qu'une toleration Kubernetes ? Une toleration est un paramètre de la spec d'un pod qui lui permet d'être planifié sur des nœuds porteurs de taints correspondants. Elle autorise uniquement la planification. Elle ne garantit pas que le pod sera placé sur un nœud porteur d'un taint, car les requêtes de ressources et l'affinité de nœud s'appliquent toujours.
Quelle est la différence entre un taint et une toleration ? Les taints s'appliquent aux nœuds et repoussent les pods dépourvus d'une toleration correspondante. Les tolerations s'appliquent aux pods et autorisent, sans l'imposer, la planification sur les nœuds porteurs de taints correspondants.
Quelle est la différence entre les opérateurs Equal et Exists ? Equal exige que la clé, la valeur et l'effet de la toleration correspondent au taint ; c'est l'opérateur par défaut lorsqu'aucun opérateur n'est défini. Exists correspond sur la seule clé : la valeur doit être omise, et toute valeur pour cette clé est tolérée.
Que font les effets NoSchedule, PreferNoSchedule et NoExecute ? NoSchedule bloque les nouveaux pods sans toleration correspondante, mais ne touche pas aux pods en cours d'exécution. PreferNoSchedule est une version souple où le scheduler tente d'éviter le nœud. NoExecute évince en plus les pods en cours d'exécution qui ne tolèrent pas le taint.
À quoi sert tolerationSeconds ? Sur une toleration NoExecute, tolerationSeconds définit la durée pendant laquelle un pod peut rester sur un nœud après l'apparition d'un taint correspondant. Une fois ce délai écoulé, si le taint est toujours présent, Kubernetes évince le pod. S'il est omis, le pod reste tant que le taint est présent.
Une toleration oblige-t-elle un pod à s'exécuter sur un nœud porteur d'un taint ? Non. Une toleration rend seulement le pod éligible. Pour diriger un pod vers un pool de nœuds spécifique, associez la toleration à une affinité de nœud ou à un node selector.
Optimiser la planification basée sur les tolerations avec PerfectScale
Les taints et tolerations déterminent où les pods sont autorisés à s'exécuter, mais ne disent rien du dimensionnement de ces nœuds ni de la justesse des demandes de CPU et de mémoire des workloads qui y sont déployés. PerfectScale est une plateforme d'optimisation et de gouvernance Kubernetes qui se déploie via une seule commande Helm, puis fournit des insights actionnables et une optimisation autonome sur l'ensemble de la stack K8s — workloads, nœuds et autoscalers — afin que les pools de nœuds réservés, spécialisés et coûteux soient réellement utilisés efficacement.
Principales capacités de PerfectScale :
- Right-sizing autonome des workloads : Podfit offre une vue granulaire de la santé et des coûts du cluster, met en évidence les ressources gaspillées et les risques de résilience, et optimise les workloads de manière autonome grâce à des recommandations de right-sizing fondées sur les données, que vous pouvez automatiser.
- Visibilité sur l'utilisation au niveau des nœuds : Infrafit révèle la capacité inutilisée des nœuds et recommande les types de nœuds adaptés à vos workloads, afin que les pools dédiés, GPU et autres pools porteurs de taints offrent des performances optimales sans payer pour de la capacité inutilisée.
- Optimisation des autoscalers : PerfectScale s'intègre à HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning et Google Autopilot, maximisant l'efficacité des systèmes qui provisionnent et remplacent vos nœuds porteurs de taints.
- Alertes en temps réel avec priorisation automatique : les risques de résilience et les anomalies de coûts sont remontés avec une priorisation basée sur l'impact et transmis directement dans Slack, Datadog, MS Teams ou PagerDuty, avant d'atteindre vos utilisateurs ou votre facture cloud.
- Tendances, gouvernance et prévisions : le rapport Trends offre une visibilité approfondie sur les métriques de coûts, de gaspillage et de risques dans le temps, à l'échelle des clusters, groupes de nœuds, namespaces et workloads, facilitant l'analyse des causes racines et une planification budgétaire précise.
- Tout environnement Kubernetes : PerfectScale fonctionne sur les clusters on-premise comme cloud, y compris OpenShift, EKS, GKE, AKS et les environnements hybrides, avec prise en charge des conteneurs Windows et des workloads éphémères ou ML tels que les jobs Airflow et Spark.