


KubernetesのTolerationとは
KubernetesのTolerationはPodに設定し、ノードのTaintを「許容」できるようにする仕組みです。Taintは特定のPod群をノードから遠ざけますが、合致するTolerationがあれば、スケジューラーはそのPodをTaintが付与されたノードに配置できます。
TolerationはPodの仕様(spec)で定義され、特定のTaintを持つノード上でPodを実行できることをKubernetesのスケジューラーに伝えます。これにより、Taintによる制限を実質的に回避できます。この機能は、高度なワークロード配置や分離のシナリオで重要です。Tolerationは、Taintが付与されたノードへのスケジューリングを保証するものではなく、あくまで許可するだけです。実際のスケジューリング判断は、リソース要求やノードアフィニティなど他の要因にも左右されます。
Taintの効果:
- NoSchedule:合致するTolerationを持たない新規Podが、そのノードにスケジュールされるのをブロックします。
- PreferNoSchedule:緩やかな制限で、スケジューラーはそのノードを避けようとしますが、強制ではありません。
- NoExecute:Tolerationを持たない実行中のPodを、即時または一定時間の経過後に退避(Evict)させます。
Tolerationの演算子:
- Equal:key、value、effectがTaintと明示的に一致する必要があります。
- Exists:keyとeffectのみ一致すればよく、valueは無視されます。
- Gt:Taintのvalueが、Tolerationのvalueより大きい整数である必要があります(v1.35で追加)。
- Lt:Taintのvalueが、Tolerationのvalueより小さい整数である必要があります(v1.35で追加)。
YAML設定例:
apiVersion: v1kind: Podmetadata: name: database-podspec: tolerations: - key: "workload" operator: "Equal" value: "database" effect: "NoSchedule"本記事は、Kubernetesスケジューリングに関する連載記事の一部です
この記事の内容:
- KubernetesのTolerationの仕組み
- KubernetesのTaintとTolerationの比較
- KubernetesのTolerationの代表的なユースケース
- KubernetesのTolerationの演算子
- KubernetesのTaintの効果
- KubernetesのTolerationの設定例
- KubernetesのTolerationのベストプラクティス
KubernetesのTolerationの仕組み
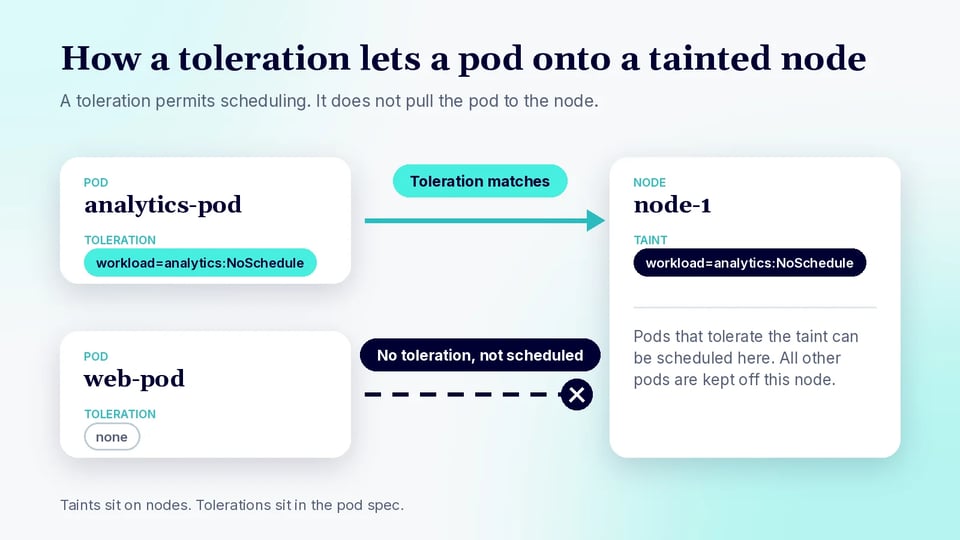
KubernetesのTolerationは、Podマニフェストのtolerationsフィールドに指定します。各Tolerationは、key、operator、value、effectで構成されます。Podが作成されると、スケジューラーはノードに付与されたTaintを確認し、PodのTolerationと照合します。ノードのTaintがPodのTolerationに合致すれば、そのPodはそのノードにスケジュール可能になります。合致しない場合、Podはそのノードにスケジュールされず、すでに実行中の場合はTaintの効果に応じて退避されることがあります。
この仕組みにより、きめ細かなスケジューリング制御が可能になり、Tolerationという形で明示的な許可を持つPodだけが、特定のTaintを持つノード上で実行されるようになります。ノードのTaintとPodのTolerationの相互作用は、特殊なワークロード向けにノードを専用化する、機密性の高いワークロードを共有インフラ上で実行させない、特殊なハードウェア上では互換性のあるPodのみを実行する、といったノード分離戦略の基盤となります。
KubernetesのTaintとTolerationの比較
TaintとTolerationは、Kubernetesのスケジューリングにおける表裏一体の仕組みです。Taintはノードに付与され、Podを遠ざけるメカニズムとして機能し、合致するTolerationを持つPodだけがそのノードにスケジュールされるべきであることを示します。これにより、特殊なハードウェアを搭載したノードや特定用途向けに確保されたノードなど、適さないノードにワークロードが誤ってスケジュールされるのを防げます。
TolerationはPodに設定します。PodがどのTaintを許容できるかを指定することで、該当するTaintを持つノードへのスケジュールが可能になります。TolerationはTaint付きノードへのスケジュールを強制するものではなく、他のスケジューリングポリシーと組み合わせたときにそれを可能にするものです。TaintとTolerationの組み合わせは、ワークロードの分離、リソース管理、クラスターインフラの効率的な活用のための柔軟なフレームワークを提供します。
| 項目 | Taint | Toleration |
|---|---|---|
| 適用対象 | ノード | Pod |
| 目的 | Taintに合致しない限り、Podのスケジュールを拒む | 合致するTaintを持つノードへのPodのスケジュールを許可する |
| スケジューリングへの影響 | ノード上で実行できるPodを制限する | Taint付きノードへのスケジュールを許可するが、強制はしない |
| 主なユースケース | 特別なワークロード、ハードウェア、ロール向けにノードを確保する | 特定のワークロードが、確保された専用・特殊ノードを利用できるようにする |
KubernetesのTolerationの代表的なユースケース
専用ノード
専用ノードは、セキュリティ、コンプライアンス、パフォーマンスなどの理由で分離が必要なワークロードによく使われます。固有のkeyとvalueでノードにTaintを付与し、そこで実行すべきPodにのみ合致するTolerationを追加することで、管理者はこれらのノードを特定のワークロード専用に確保できます。これにより、信頼性の低い可能性のある他のPodが専用ハードウェアにスケジュールされるのを防ぎ、リソース競合のリスクを減らして予測可能性を高められます。
たとえば、金融系アプリケーション専用のノードプールにworkload=finance:NoScheduleというTaintを付与すれば、対応するTolerationを持つPodだけがそこにスケジュールされます。このアプローチは、テナントのワークロードをノードレベルで分離したいマルチテナントクラスターでも有効です。TaintとTolerationを慎重に適用することで、強固なワークロード分離とコンプライアンス境界を実現できます。
GPUノード
GPUノードは、Kubernetesクラスター内で貴重かつ数が限られたリソースです。GPUアクセラレーションを必要とするワークロードだけがこれらのノードにスケジュールされるよう、管理者は通常、hardware=gpu:NoScheduleのようなkeyでGPUノードにTaintを付与します。適切なTolerationを持つPodだけがGPUノードを利用できるため、汎用ワークロードがこれらの特殊リソースを消費することを防げます。
このアプローチにより、GPUキャパシティの無駄を最小限に抑え、スケジューリングの競合を防止できます。また、高価なハードウェアへのアクセスを制御し、機械学習、AI、科学計算などのワークロード向けに確保することも可能になります。GPUノードでTaintとTolerationを適切に使うことは、ハードウェアの特殊性を保護しつつ効率的に活用すべきクラスターにおけるベストプラクティスです。
関連記事:Kubernetes GPUの詳細ガイドはこちら
Spotノード・プリエンプティブルノード
Spotノードやプリエンプティブルノードはコスト効率に優れていますが、クラウドプロバイダーによっていつでも回収される可能性があります。そのため、これらのノードにはTaintを付与し、障害耐性のあるステートレスなワークロードだけがスケジュールされるようにするのが一般的です。instance-type=spot:NoScheduleのようなTaintをこれらのノードに適用し、適したPodにTolerationを設定することで、中断に対応できるPodだけがこれらのノード上で実行されるようにできます。
この戦略により、重要なワークロードの信頼性を維持しながらコストを最適化できます。Tolerationを持たないPodはSpotノードにスケジュールされないため、ステートフルサービスや高可用性サービスの予期しない終了を回避できます。このようにTaintとTolerationを活用することで、クラスターのリソース割り当てが整理され、重要なアプリケーションをプリエンプションのリスクから保護できます。
関連記事:KarpenterのSpotインスタンスの詳細ガイドはこちら
システム・インフラ系ワークロード
コアDNS、監視エージェント、ネットワークプラグインなどのシステム・インフラ系ワークロードは、全ノードまたは特定のノード群で実行する必要があることがよくあります。一般的なアプリケーションワークロードを遠ざけるためにノードにTaintを付与しつつ、重要なシステムPodにTolerationを追加すれば、それらのPodは引き続きスケジュール可能です。たとえば、node-role.kubernetes.io/infra:NoScheduleのTaintを付与したノードでは、合致するTolerationを持つPodだけが実行され、通常のアプリケーションPodがインフラノードのリソースを消費することを防げます。
このアプローチにより、システムレベルのワークロードとユーザーワークロードを明確に分離でき、信頼性と管理性が向上します。また、インフラノードをアプリケーションノードとは別にサイジング・管理できるため、リソースの優先順位付けも可能になります。システムワークロードにTaintとTolerationを使うのは、重要なサービスが常に必要なリソースを確保できるようにするための、本番クラスターにおける一般的なパターンです。
KubernetesのTolerationの演算子
Equal演算子
Equal演算子は、Tolerationのkeyとvalueが、対応するTaintと完全に一致することを要求します。effectが指定されている場合は、effectも一致する必要があります。この演算子は、同じkeyを使うすべてのTaintではなく、特定のTaintだけをPodに許容させたい場合に有効です。
たとえば、key: "hardware"、operator: "Equal"、value: "gpu"、effect: "NoSchedule"のTolerationは、hardware=gpu:NoScheduleのTaintに合致します。hardware=cpu:NoScheduleには合致しません。operatorフィールドを省略した場合のデフォルトはEqualです。
Exists演算子
Exists演算子は、valueの一致を求めず、keyに基づいてTaintと照合します。Existsを使う場合、Tolerationのvalueフィールドは省略しなければなりません。effectが指定されている場合、Tolerationが合致するには、Taintも同じeffectを持っている必要があります。
たとえば、key: "hardware"、operator: "Exists"、effect: "NoSchedule"のTolerationは、値にかかわらず、hardwareキーを持つあらゆるNoScheduleのTaintを許容します。keyも省略した場合、Existsは指定されたeffectの範囲内で、すべてのTaintキーに合致し得ます。このため広範なTolerationに便利ですが、より多くのTaint付きノードへのPod配置を許してしまう可能性があるため、慎重に使用すべきです。
Gt演算子
Gt(greater than)演算子は、TaintのvalueがTolerationのvalueより数値的に大きい場合に合致します。keyは一致する必要があり、effectも指定されている場合は一致しなければなりません。両方の値は、先頭にゼロを含まない有効な64ビット整数である必要があります。GtはKubernetes v1.35でアルファ機能として導入され、TaintTolerationComparisonOperatorsフィーチャーゲートが必要です。
たとえば、key: "node-sla"、operator: "Gt"、value: "950"、effect: "NoSchedule"のTolerationは、node-sla=990:NoScheduleのTaintに合致します。node-sla=900:NoScheduleには合致しません。この演算子は、信頼性スコアが一定の基準を上回るノードにのみPodを許可するなど、しきい値ベースの配置に有効です。
Lt演算子
Lt(less than)演算子は、TaintのvalueがTolerationのvalueより数値的に小さい場合に合致します。Gtと同様に、keyは一致する必要があり、effectも指定されている場合は一致しなければならず、両方の値は有効な整数である必要があります。LtもKubernetes v1.35ではアルファ機能で、同じフィーチャーゲートで制御されます。
たとえば、key: "failure-probability"、operator: "Lt"、value: "5"、effect: "NoSchedule"のTolerationは、failure-probability=2:NoScheduleのTaintを許容しますが、failure-probability=8:NoScheduleは許容しません。このため、Spotノードやプリエンプティブルノードで有効です。なお、ノード登録時に設定されたTaintの値は検証されないため、Taintの値が数値でない場合、Tolerationは合致しなくなります。
KubernetesのTaintの効果
Tolerationで上書きできる、Kubernetesが提供するTaintの効果を見ていきましょう。
NoSchedule
NoScheduleは、合致するTolerationを持たない新規Podがノードにスケジュールされるのを防ぎます。Taintが追加された時点ですでにノード上で実行されているPodは退避されません。そのため、NoScheduleは、既存のPodに影響を与えずに特定のワークロード向けにノードを確保する場合に有効です。
たとえば、hardware=gpu:NoScheduleのTaintを追加すると、合致するTolerationを持たないPodはGPUノードに新たにスケジュールされなくなります。すでに実行中のPodは、そのまま実行を継続できます。
PreferNoSchedule
PreferNoScheduleは、緩やかなスケジューリング制限です。Kubernetesは、合致するTolerationを持たないPodをTaint付きノードに配置しないよう試みますが、必要な場合はそこにスケジュールすることもあります。NoScheduleとは異なり、スケジューリングを厳密にブロックするわけではありません。
この効果は、特定のワークロード向けにノードを確保したいものの、他の配置先が限られる場合にはスケジューラーにそれらのノードを使わせたい、という場面で有効です。PreferNoScheduleのTaintを追加しても、既存のPodは退避されません。
NoExecute
NoExecuteは、スケジューリングだけでなく、ノード上で実行中のPodにも影響します。合致するTolerationを持たない新規Podはそのノードにスケジュールできず、Taintを許容しない既存のPodは退避されます。
TolerationにtolerationSecondsを含めることで、合致するNoExecuteのTaintが付与された後も、Podが一時的にノードに留まることを許可できます。その期間が経過してもTaintが残っている場合、Podは退避されます。tolerationSecondsを省略した場合、合致するTolerationがあれば、Taintが存在する間はPodが留まり続けられます。
KubernetesのTolerationの設定例
例1:基本的なNoScheduleのToleration
あるノードにworkload=analytics:NoScheduleのTaintが付与されているとします。そのノードにスケジュール可能になるには、Podに合致するTolerationが必要です。次のPodは、この特定のTaintを許容します:
apiVersion: v1kind: Podmetadata: name: analytics-podspec: containers: - name: web image: nginx:latest tolerations: - key: "workload" operator: "Equal" value: "analytics" effect: "NoSchedule"Equal演算子では、keyとvalueの両方がTaintと一致する必要があります。このTolerationは、指定されたTaintを持つノードへのPod配置を許可しますが、スケジューラーにそれらのノードへの配置を強制するものではありません。
例2:Taintの値を問わず許容する
値にかかわらずTaintのkeyをPodに許容させたい場合は、Exists演算子を使えます。たとえば、次の設定は、keyがworkloadであるあらゆるNoScheduleのTaintを許容します:
apiVersion: v1kind: Podmetadata: name: compute-podspec: containers: - name: worker image: busybox:latest tolerations: - key: "workload" operator: "Exists" effect: "NoSchedule"Existsを使う場合、valueは指定しません。その結果、このPodはworkload=database:NoScheduleやworkload=batch:NoScheduleといったTaintを許容できます。他のTaintのkeyやeffectについては、引き続き個別に合致するTolerationが必要です。
例3:tolerationSecondsを使ったNoExecute
NoExecuteのTolerationにtolerationSecondsを含めることで、合致するTaintが適用された後にPodがノードに留まる時間を制御できます。次のPodは、maintenance-window=active:NoExecuteのTaintを100秒間許容します:
apiVersion: v1kind: Podmetadata: name: maintenance-workerspec: containers: - name: worker image: busybox:latest tolerations: - key: "maintenance-window" operator: "Equal" value: "active" effect: "NoExecute" tolerationSeconds: 100Podの実行中にTaintが追加された場合、Podは最大100秒間ノードに留まれます。その期間を過ぎてもTaintが残っていれば、KubernetesはPodを退避させます。期間が終わる前にTaintが削除されれば、Podは実行を継続できます。
KubernetesのTolerationのベストプラクティス
必要なワークロードにだけTolerationを設定する
Tolerationは、ワークロードがTaint付きノードで実行される明確な理由がある場合にのみ追加しましょう。広すぎる、あるいは不要なTolerationは、Taintが本来提供する分離を弱め、他の用途に確保されたノードへのワークロード配置を許してしまいます。その結果、リソース競合が発生し、ノード配置の予測可能性が低下する恐れがあります。
ワークロードの要件が変わったら、Tolerationを見直しましょう。Podが本当に幅広いTaintを許容する必要がある場合を除き、汎用的なExistsのTolerationは避けてください。各ワークロードが必要なスケジューリング権限だけを持つように、key、value、effectのスコープは狭く設定することをおすすめします。
また、DeploymentやStatefulSet、DaemonSetなど、ワークロードコントローラーのレベルでTolerationを管理するのも有効です。これにより、Podの再作成やスケール時にもスケジューリング動作の一貫性が保たれます。
Tolerationとノードアフィニティを組み合わせる
Tolerationは、PodをTaint付きノードで実行可能にするだけで、そのノードへPodを誘導するわけではありません。ワークロードを特定のノードプールで確実に実行したい場合は、Tolerationとノードアフィニティまたはノードセレクターを組み合わせましょう。
たとえば、GPUワークロードは、GPUノードのTaintを許容しつつ、ノードアフィニティで適切なGPUタイプのラベルを持つノードを必須にできます。Taintが一般のワークロードを遠ざけ、アフィニティがGPUワークロードを互換性のあるノードへ導きます。
配置の厳密さに応じて、必須(required)のノードアフィニティと優先(preferred)のノードアフィニティを使い分けましょう。必須のアフィニティは条件に合わないノードへのスケジュールを防ぎ、優先のアフィニティは適切なノードがない場合にスケジューラーへより多くの柔軟性を与えます。
ノードプール間でTaintとTolerationの一貫性を保つ
ノードプール間で、Taintのkeyとvalueに一貫した命名規則を使いましょう。同じ目的にworkload=gpu、type=gpu、node=gpuといった一貫性のない値を使うと、Pod設定の保守が難しくなり、スケジューリングエラーのリスクが高まります。
一般的なノードロールに対して標準のTaintを定義し、クラスターまたはインフラの自動化を通じて適用しましょう。これにより、ワークロードマニフェストは開発、ステージング、本番の各環境で、不要な設定差分なしに予測可能なTolerationを使えるようになります。
一貫性は、クラスターオートスケーリングシステムによってノードが自動的に作成・置換される場合に特に重要です。どのノードインスタンスが稼働していてもワークロードが同じように動作するよう、新規ノードにはプロビジョニング時に想定どおりのTaintとラベルを付与すべきです。
特殊で高価なノードを保護する
GPU、大容量メモリインスタンス、その他の高価なハードウェアといった特殊リソースを汎用Podが消費しないように、Taintを活用しましょう。これらのリソースを使うように設計されたワークロードにだけ、対応するTolerationを付与すべきです。
Tolerationだけでは、Podが実際に特殊リソースを要求していることは保証されません。たとえばGPUワークロードの場合は、Tolerationに加えて、適切なリソース要求や制限も設定してください。複数のハードウェアタイプが利用できる場合は、ノードアフィニティでさらに細かく配置を制御できます。
このアプローチにより、優先度の低いワークロードが、特殊なアプリケーションに必要なキャパシティを占有するのを防げます。また、高価なノードを、そのハードウェアを活かせるワークロード向けに確保しておくことで、インフラコストの削減にもつながります。
設定だけでなくスケジューリングの結果を監視する
Tolerationが正しくても、Podが正常にスケジュールされることは保証されません。リソースの空き状況、ノードアフィニティ、トポロジー制約、Podアフィニティ・アンチアフィニティなど、他のスケジューラールールによって配置が妨げられることがあります。
保留中のPod、スケジューラーのイベント、ノードのTaint、実際のPod配置を監視し、スケジューリングポリシーが意図どおりに機能していることを確認しましょう。kubectl describe podやkubectl describe nodeといったコマンドは、Taintの不一致やその他のスケジューリング制約の特定に役立ちます。
監視では、保留のまま残るPodだけでなく、想定外の配置も検知すべきです。ワークロードが誤ったノードプールで問題なく稼働している場合、Tolerationが広すぎるか、アフィニティルールが不足している可能性があります。定期的なチェックにより、クラスターとワークロードの変化に合わせてスケジューリングポリシーが機能し続けることを確認できます。
よくある質問
KubernetesのTolerationとは何ですか? Tolerationは、Podのspecに設定する項目で、合致するTaintを持つノードにPodをスケジュールできるようにします。あくまでスケジュールを許可するだけです。リソース要求やノードアフィニティも引き続き適用されるため、Taint付きノードへの配置を保証するものではありません。
TaintとTolerationの違いは何ですか? Taintはノードに付与され、合致するTolerationを持たないPodを遠ざけます。TolerationはPodに設定され、合致するTaintを持つノードへのスケジュールを許可しますが、強制はしません。
Equal演算子とExists演算子の違いは何ですか? Equalは、Tolerationのkey、value、effectがTaintと一致する必要があり、演算子を指定しない場合のデフォルトです。Existsはkeyのみで照合するため、valueは省略する必要があり、そのkeyの任意の値を許容します。
NoSchedule、PreferNoSchedule、NoExecuteの各効果はどのような動作をしますか? NoScheduleは、合致するTolerationを持たない新規Podをブロックしますが、実行中のPodには影響しません。PreferNoScheduleは強制力のない緩やかな制限で、スケジューラーはそのノードを避けようとします。NoExecuteはさらに、Taintを許容しない実行中のPodも退避させます。
tolerationSecondsは何をするものですか? NoExecuteのTolerationにおいて、tolerationSecondsは、合致するTaintが付与された後にPodがノードに留まれる時間を指定します。その時間が経過してもTaintが残っている場合、KubernetesはPodを退避させます。省略した場合、Taintが存在する間はPodが留まり続けます。
Tolerationを設定すれば、PodはTaint付きノードで実行されますか? いいえ。Tolerationは、Podをスケジュール可能にするだけです。特定のノードプールにPodを配置したい場合は、Tolerationとノードアフィニティまたはノードセレクターを組み合わせてください。
PerfectScaleでTolerationベースのスケジューリングをさらに効率化
TaintとTolerationは、Podが実行を許可される場所を決めますが、それらのノードが適切にサイジングされているか、そこに配置されるワークロードが適切な量のCPUとメモリを要求しているかについては何も教えてくれません。PerfectScaleは、Helmコマンド1つでデプロイできるKubernetesの最適化・ガバナンスプラットフォームです。ワークロード、ノード、オートスケーラーを含むK8sスタック全体にわたって、実用的なインサイトと自律的な最適化を提供し、専用・特殊・高価なノードプールが実際に効率よく活用されるようにします。
PerfectScaleの主な機能:
- ワークロードの自律的なライトサイジング: Podfitは、クラスターの健全性とコストをきめ細かく可視化し、無駄なリソースやレジリエンスの問題を浮き彫りにします。データドリブンなライトサイジングの推奨に基づいてワークロードを自律的に最適化し、推奨内容を自動適用することも可能です。
- ノードレベルの使用率インサイト: Infrafitは、アイドル状態のノードキャパシティを可視化し、ワークロードに最適なノードタイプを推奨します。専用ノード、GPUノード、その他のTaint付きノードプールが、未使用キャパシティへの支払いなしに最大のパフォーマンスを発揮できるようにします。
- オートスケーラーの最適化: PerfectScaleは、HPA、KEDA、Karpenter、Cluster Autoscaler、EKS Auto Mode、Fargate、Node Auto Provisioning、Google Autopilotと統合し、Taint付きノードをプロビジョニング・置換するシステムの効果を最大化します。
- 自動優先順位付けを備えたリアルタイムアラート: レジリエンスリスクやコストの異常を、影響度に基づいて優先順位付けして検出し、ユーザーやクラウド請求に影響が及ぶ前に、Slack、Datadog、MS Teams、PagerDutyへ直接通知します。
- トレンド、ガバナンス、予測: Trendsレポートは、クラスター、ノードグループ、名前空間、ワークロードを横断して、コスト・無駄・リスクの各指標の推移を詳細に可視化し、根本原因分析と正確な予算計画を支援します。
- あらゆるKubernetes環境に対応: PerfectScaleは、OpenShift、EKS、GKE、AKS、ハイブリッド構成を含むオンプレミスとクラウドの両方のクラスターで動作し、WindowsコンテナやAirflow・Sparkジョブなどのエフェメラル/MLワークロードもサポートします。