


Was sind Kubernetes Tolerations?
Kubernetes Tolerations werden auf Pods angewendet, damit diese Node-Taints "tolerieren" können. Während Taints eine Gruppe von Pods von einem Node fernhalten, erlauben passende Tolerations dem Scheduler, diese Pods auf dem mit einem Taint versehenen Node zu platzieren.
Tolerations werden in der Pod-Spezifikation definiert und teilen dem Kubernetes-Scheduler mit, dass ein Pod auf Nodes mit bestimmten Taints laufen darf – die durch diese Taints auferlegten Einschränkungen werden damit effektiv umgangen. Diese Funktion ist wichtig für fortgeschrittene Szenarien der Workload-Platzierung und -Isolation. Tolerations garantieren kein Scheduling auf einem Node mit Taint; sie erlauben es lediglich. Die tatsächliche Scheduling-Entscheidung hängt auch von anderen Faktoren wie Ressourcenanforderungen und Node Affinity ab.
Taint-Effekte:
- NoSchedule: Verhindert, dass neue Pods ohne passende Toleration auf dem Node eingeplant werden.
- PreferNoSchedule: Eine weiche Variante, bei der der Scheduler versucht, den Node zu meiden, aber nicht dazu gezwungen ist.
- NoExecute: Entfernt laufende Pods sofort oder nach einer festgelegten Zeit, wenn ihnen die Toleration fehlt.
Toleration-Operatoren:
- Equal: Key, Value und Effect müssen exakt mit dem Taint übereinstimmen.
- Exists: Nur Key und Effect müssen übereinstimmen; der Value wird ignoriert.
- Gt: Der Taint-Value muss eine Ganzzahl sein, die größer ist als der Toleration-Value (eingeführt in v1.35).
- Lt: Der Taint-Value muss eine Ganzzahl sein, die kleiner ist als der Toleration-Value (eingeführt in v1.35).
Beispiel für eine YAML-Konfiguration:
apiVersion: v1kind: Podmetadata: name: database-podspec: tolerations: - key: "workload" operator: "Equal" value: "database" effect: "NoSchedule"Dieser Artikel ist Teil einer Artikelserie über Kubernetes Scheduling
In diesem Artikel:
- So funktionieren Kubernetes Tolerations
- Kubernetes Taints vs. Tolerations
- Typische Use Cases für Kubernetes Tolerations
- Kubernetes Toleration-Operatoren
- Kubernetes Taint-Effekte
- Beispiele für Kubernetes Tolerations
- Best Practices für Kubernetes Tolerations
So funktionieren Kubernetes Tolerations
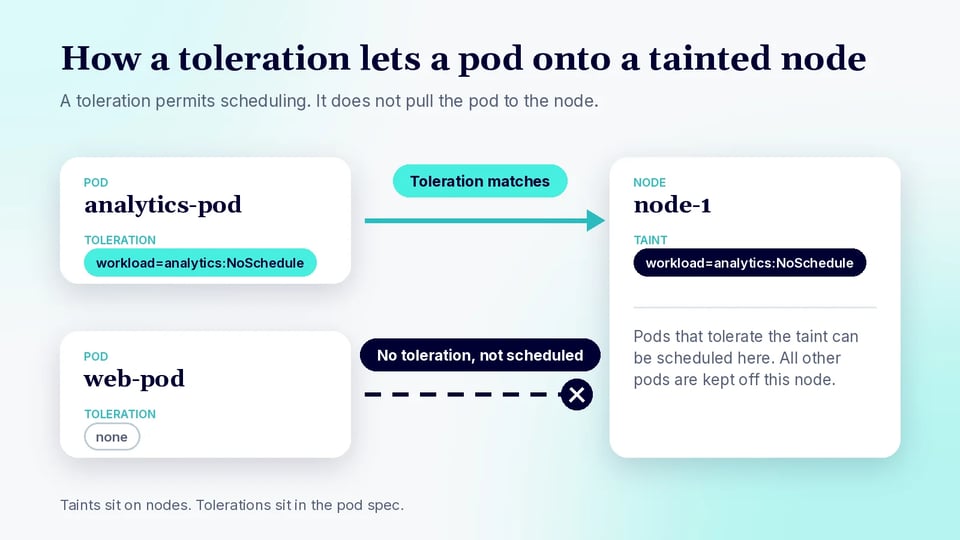
Kubernetes Tolerations werden im Manifest eines Pods unter dem Feld tolerations angegeben. Jede Toleration besteht aus Key, Operator, Value und Effect. Wenn ein Pod erstellt wird, prüft der Scheduler die Taints auf den Nodes und gleicht sie mit den Tolerations des Pods ab. Stimmt der Taint eines Nodes mit einer Toleration des Pods überein, kommt der Pod für das Scheduling auf diesem Node infrage. Andernfalls wird der Pod dort nicht eingeplant – oder, falls er bereits läuft, je nach Taint-Effekt möglicherweise entfernt.
Dieser Mechanismus ermöglicht eine granulare Steuerung des Schedulings und stellt sicher, dass nur Pods mit bestimmten Berechtigungen – ausgedrückt als Tolerations – auf Nodes mit bestimmten Taints zugelassen werden. Das Zusammenspiel von Taints auf Nodes und Tolerations auf Pods bildet die Grundlage für Node-Isolationsstrategien, etwa das Reservieren von Nodes für spezielle Workloads, das Verhindern, dass sensible Workloads auf gemeinsam genutzter Infrastruktur laufen, oder die Sicherstellung, dass nur kompatible Pods auf spezialisierter Hardware ausgeführt werden.
Kubernetes Taints vs. Tolerations
Taints und Tolerations sind zwei Seiten derselben Medaille im Kubernetes-Scheduling. Taints werden auf Nodes angewendet und wirken abweisend: Sie signalisieren, dass nur Pods mit passenden Tolerations auf diesen Nodes eingeplant werden sollen. So wird verhindert, dass Workloads versehentlich auf Nodes landen, die nicht für sie geeignet sind – etwa Nodes mit spezialisierter Hardware oder solche, die für bestimmte Zwecke reserviert sind.
Tolerations werden auf Pods angewendet. Sie geben an, welche Taints ein Pod tolerieren kann, und erlauben so das Scheduling auf Nodes mit diesen Taints. Tolerations erzwingen kein Scheduling auf Nodes mit Taints, sondern machen es in Kombination mit anderen Scheduling-Richtlinien möglich. Die Kombination aus Taints und Tolerations bietet ein flexibles Framework für Workload-Isolation, Ressourcenmanagement und die effiziente Nutzung der Cluster-Infrastruktur.
| Aspekt | Taints | Tolerations |
|---|---|---|
| Angewendet auf | Nodes | Pods |
| Zweck | Halten Pods vom Scheduling fern, sofern diese nicht zum Taint passen | Erlauben Pods das Scheduling auf Nodes mit passenden Taints |
| Auswirkung auf das Scheduling | Schränkt ein, welche Pods auf einem Node laufen dürfen | Erlaubt das Scheduling auf Nodes mit Taints, erzwingt es aber nicht |
| Typischer Use Case | Nodes für spezielle Workloads, Hardware oder Rollen reservieren | Bestimmten Workloads die Nutzung dieser reservierten oder spezialisierten Nodes erlauben |
Typische Use Cases für Kubernetes Tolerations
Dedizierte Nodes
Dedizierte Nodes kommen häufig für Workloads zum Einsatz, die aus Sicherheits-, Compliance- oder Performance-Gründen isoliert werden müssen. Indem Nodes mit einem Taint aus eindeutigem Key und Value versehen werden und nur die Pods, die dort laufen sollen, passende Tolerations erhalten, stellen Administratoren sicher, dass diese Nodes für bestimmte Workloads reserviert bleiben. Das verhindert, dass andere, potenziell weniger vertrauenswürdige Pods auf dedizierter Hardware eingeplant werden, reduziert das Risiko von Ressourcenkonflikten und erhöht die Vorhersagbarkeit.
Ein Node-Pool für Finanzanwendungen kann beispielsweise mit dem Taint workload=finance:NoSchedule versehen werden, sodass nur Pods mit einer entsprechenden Toleration dort eingeplant werden können. Dieser Ansatz ist auch in Multi-Tenant-Clustern nützlich, wenn die Workloads der einzelnen Tenants auf Node-Ebene isoliert werden sollen. Durch den gezielten Einsatz von Taints und Tolerations lassen sich eine strikte Workload-Trennung und klare Compliance-Grenzen durchsetzen.
GPU-Nodes
GPU-Nodes sind eine wertvolle und oft begrenzte Ressource in einem Kubernetes-Cluster. Damit nur Workloads, die GPU-Beschleunigung benötigen, auf diesen Nodes eingeplant werden, versehen Administratoren GPU-Nodes üblicherweise mit einem Taint wie hardware=gpu:NoSchedule. Nur Pods mit der passenden Toleration kommen dann für die GPU-Nodes infrage – so wird verhindert, dass allgemeine Workloads diese spezialisierten Ressourcen belegen.
Dieser Ansatz minimiert ungenutzte GPU-Kapazität und verhindert Scheduling-Konflikte. Außerdem können Teams so den Zugriff auf teure Hardware steuern und sie für Machine-Learning-, KI- oder wissenschaftliche Workloads reservieren. Der richtige Einsatz von Taints und Tolerations bei GPU-Nodes ist Best Practice in Clustern, in denen spezialisierte Hardware geschützt und effizient genutzt werden muss.
Verwandte Inhalte: Lesen Sie unseren ausführlichen Leitfaden zu Kubernetes GPU
Spot- und Preemptible-Nodes
Spot- oder Preemptible-Nodes sind kostengünstig, können aber jederzeit vom Cloud-Anbieter zurückgefordert werden. Diese Nodes werden häufig mit Taints versehen, damit nur fehlertolerante, zustandslose Workloads dort eingeplant werden. Mit einem Taint wie instance-type=spot:NoSchedule auf diesen Nodes und entsprechenden Tolerations auf geeigneten Pods stellen Administratoren sicher, dass dort nur Pods laufen, die mit Unterbrechungen umgehen können.
Diese Strategie ermöglicht es Unternehmen, Kosten zu optimieren und gleichzeitig die Zuverlässigkeit kritischer Workloads zu wahren. Pods ohne die Toleration werden nicht auf Spot-Nodes eingeplant, wodurch unerwartete Terminierungen für zustandsbehaftete oder hochverfügbare Services vermieden werden. So eingesetzt, vereinfachen Taints und Tolerations die Ressourcenzuweisung im Cluster und schützen essenzielle Anwendungen vor dem Preemption-Risiko.
Verwandte Inhalte: Lesen Sie unseren ausführlichen Leitfaden zu Karpenter-Spot-Instances
System- und Infrastruktur-Workloads
System- und Infrastruktur-Workloads wie Core DNS, Monitoring-Agents oder Netzwerk-Plugins müssen oft auf allen Nodes oder auf einer bestimmten Teilmenge laufen. Nodes können mit Taints versehen werden, um allgemeine Anwendungs-Workloads fernzuhalten, während Tolerations auf kritischen System-Pods sicherstellen, dass diese weiterhin eingeplant werden können. Ein Node mit dem Taint node-role.kubernetes.io/infra:NoSchedule führt beispielsweise nur Pods mit passender Toleration aus und verhindert so, dass reguläre Anwendungs-Pods die Ressourcen der Infrastruktur-Nodes verbrauchen.
Dieser Ansatz sorgt für eine saubere Trennung zwischen System- und Nutzer-Workloads und verbessert Zuverlässigkeit und Verwaltbarkeit. Er ermöglicht zudem eine Priorisierung der Ressourcen, da Infrastruktur-Nodes getrennt von Anwendungs-Nodes dimensioniert und verwaltet werden können. Taints und Tolerations für System-Workloads sind ein gängiges Muster in Produktionsclustern, um sicherzustellen, dass kritische Services stets über die benötigten Ressourcen verfügen.
Kubernetes Toleration-Operatoren
Der Equal-Operator
Der Equal-Operator verlangt, dass Key und Value einer Toleration exakt mit dem entsprechenden Taint übereinstimmen. Auch der Effect muss übereinstimmen, sofern er angegeben ist. Dieser Operator ist nützlich, wenn ein Pod genau einen bestimmten Taint tolerieren soll – und nicht jeden Taint mit demselben Key.
Eine Toleration mit key: "hardware", operator: "Equal", value: "gpu" und effect: "NoSchedule" passt beispielsweise zu einem Taint hardware=gpu:NoSchedule. Sie passt nicht zu hardware=cpu:NoSchedule. Equal ist der Standard-Operator, wenn das Feld operator weggelassen wird.
Der Exists-Operator
Der Exists-Operator gleicht einen Taint allein anhand seines Keys ab, ohne dass ein passender Value erforderlich ist. Bei Exists muss das Value-Feld der Toleration weggelassen werden. Ist ein effect angegeben, muss der Taint ebenfalls diesen Effect haben, damit die Toleration passt.
Eine Toleration mit key: "hardware", operator: "Exists" und effect: "NoSchedule" toleriert beispielsweise jeden NoSchedule-Taint mit dem Key hardware, unabhängig von dessen Value. Wird auch der Key weggelassen, kann Exists alle Taint-Keys abdecken – vorbehaltlich eines angegebenen Effects. Das macht den Operator nützlich für breit gefasste Tolerations; er sollte jedoch mit Bedacht eingesetzt werden, da er Pods auf eine größere Bandbreite von Nodes mit Taints zulassen kann.
Der Gt-Operator
Der Gt-Operator (greater than) passt zu einem Taint, wenn dessen value numerisch größer ist als der value der Toleration. Der key muss übereinstimmen, und der effect muss ebenfalls übereinstimmen, sofern er angegeben ist. Beide Werte müssen gültige 64-Bit-Ganzzahlen ohne führende Nullen sein. Gt wurde in Kubernetes v1.35 als Alpha-Feature eingeführt und erfordert das Feature Gate TaintTolerationComparisonOperators.
Eine Toleration mit key: "node-sla", operator: "Gt", value: "950" und effect: "NoSchedule" passt beispielsweise zu einem Taint node-sla=990:NoSchedule. Sie passt nicht zu node-sla=900:NoSchedule. Dieser Operator eignet sich für schwellenwertbasierte Platzierung – etwa um einen Pod nur auf Nodes zuzulassen, deren Zuverlässigkeits-Score ein Minimum überschreitet.
Der Lt-Operator
Der Lt-Operator (less than) passt zu einem Taint, wenn dessen value numerisch kleiner ist als der value der Toleration. Wie bei Gt muss der key übereinstimmen, der effect muss übereinstimmen, sofern angegeben, und beide Werte müssen gültige Ganzzahlen sein. Lt ist in Kubernetes v1.35 ebenfalls Alpha und wird über dasselbe Feature Gate gesteuert.
Eine Toleration mit key: "failure-probability", operator: "Lt", value: "5" und effect: "NoSchedule" toleriert beispielsweise einen Taint failure-probability=2:NoSchedule, nicht aber failure-probability=8:NoSchedule. Das macht den Operator nützlich für Spot- oder Preemptible-Nodes. Beachten Sie, dass Taint-Werte, die bei der Node-Registrierung gesetzt werden, nicht validiert werden – ein nicht-numerischer Taint-Value führt dazu, dass die Toleration nicht passt.
Kubernetes Taint-Effekte
Werfen wir einen Blick auf die Taint-Effekte, die Kubernetes bietet und die sich mit Tolerations außer Kraft setzen lassen.
NoSchedule
Der Effekt NoSchedule verhindert, dass neue Pods ohne passende Toleration auf einem Node eingeplant werden. Pods, die beim Hinzufügen des Taints bereits auf dem Node laufen, werden nicht entfernt. Damit eignet sich NoSchedule, um Nodes für bestimmte Workloads zu reservieren, ohne bestehende Pods zu beeinträchtigen.
Das Hinzufügen eines Taints hardware=gpu:NoSchedule verhindert beispielsweise, dass Pods ohne passende Toleration neu auf dem GPU-Node eingeplant werden. Dort bereits laufende Pods können weiterlaufen.
PreferNoSchedule
Der Effekt PreferNoSchedule ist eine weiche Scheduling-Einschränkung. Kubernetes versucht, Pods ohne passende Toleration nicht auf dem Node mit Taint zu platzieren, kann sie dort bei Bedarf aber trotzdem einplanen. Anders als NoSchedule blockiert er das Scheduling nicht strikt.
Dieser Effekt ist nützlich, wenn Administratoren Nodes bevorzugt für bestimmte Workloads reservieren möchten, der Scheduler diese Nodes aber dennoch nutzen soll, wenn andere Platzierungsoptionen begrenzt sind. Bestehende Pods werden beim Hinzufügen eines PreferNoSchedule-Taints nicht entfernt.
NoExecute
Der Effekt NoExecute wirkt sich sowohl auf das Scheduling als auch auf bereits laufende Pods aus. Neue Pods ohne passende Toleration können dort nicht eingeplant werden, während bestehende Pods, die den Taint nicht tolerieren, entfernt werden.
Eine Toleration kann tolerationSeconds enthalten, damit ein Pod nach dem Auftreten eines passenden NoExecute-Taints vorübergehend auf dem Node bleiben darf. Nach Ablauf dieser Frist wird der Pod entfernt, sofern der Taint weiterhin besteht. Wird tolerationSeconds weggelassen, darf der Pod mit passender Toleration bleiben, solange der Taint vorhanden ist.
Beispiele für Kubernetes Tolerations
Beispiel 1: Einfache NoSchedule-Toleration
Angenommen, ein Node hat den Taint workload=analytics:NoSchedule. Ein Pod benötigt eine passende Toleration, um für das Scheduling auf diesem Node infrage zu kommen. Der folgende Pod toleriert genau diesen Taint:
apiVersion: v1kind: Podmetadata: name: analytics-podspec: containers: - name: web image: nginx:latest tolerations: - key: "workload" operator: "Equal" value: "analytics" effect: "NoSchedule"Der Equal-Operator verlangt, dass sowohl key als auch value mit dem Taint übereinstimmen. Diese Toleration erlaubt dem Pod das Scheduling auf Nodes mit dem angegebenen Taint, verpflichtet den Scheduler aber nicht, den Pod auf einem dieser Nodes zu platzieren.
Beispiel 2: Beliebige Values eines Taints tolerieren
Der Exists-Operator kommt zum Einsatz, wenn ein Pod einen Taint-Key unabhängig von dessen Value tolerieren soll. Die folgende Konfiguration toleriert beispielsweise jeden NoSchedule-Taint mit dem Key workload:
apiVersion: v1kind: Podmetadata: name: compute-podspec: containers: - name: worker image: busybox:latest tolerations: - key: "workload" operator: "Exists" effect: "NoSchedule"Bei Exists wird kein Value angegeben. Dieser Pod kann daher Taints wie workload=database:NoSchedule und workload=batch:NoSchedule tolerieren. Andere Taint-Keys oder Effects erfordern weiterhin eigene passende Tolerations.
Beispiel 3: NoExecute mit tolerationSeconds
Eine NoExecute-Toleration kann tolerationSeconds enthalten, um zu steuern, wie lange ein Pod nach dem Setzen eines passenden Taints auf einem Node verbleibt. Der folgende Pod toleriert einen Taint maintenance-window=active:NoExecute für 100 Sekunden:
apiVersion: v1kind: Podmetadata: name: maintenance-workerspec: containers: - name: worker image: busybox:latest tolerations: - key: "maintenance-window" operator: "Equal" value: "active" effect: "NoExecute" tolerationSeconds: 100Wird der Taint hinzugefügt, während der Pod läuft, darf der Pod bis zu 100 Sekunden auf dem Node bleiben. Besteht der Taint nach Ablauf dieser Frist weiterhin, entfernt Kubernetes den Pod. Wird der Taint vorher entfernt, kann der Pod weiterlaufen.
Best Practices für Kubernetes Tolerations
Tolerations nur für Workloads einsetzen, die sie benötigen
Fügen Sie Tolerations nur hinzu, wenn es für einen Workload einen klaren Grund gibt, auf Nodes mit Taints zu laufen. Breit gefasste oder unnötige Tolerations schwächen die Isolation, die Taints eigentlich bieten sollen, und können Workloads auf Nodes zulassen, die für andere Zwecke reserviert sind. Das kann zu Ressourcenkonflikten führen und die Node-Platzierung weniger vorhersehbar machen.
Überprüfen Sie Tolerations, wenn sich die Anforderungen der Workloads ändern. Vermeiden Sie generische Exists-Tolerations, sofern der Pod nicht tatsächlich eine große Bandbreite an Taints tolerieren muss. Bevorzugen Sie eng gefasste Keys, Values und Effects, damit jeder Workload nur die Scheduling-Berechtigungen erhält, die er benötigt.
Es empfiehlt sich außerdem, Tolerations auf Ebene des Workload-Controllers zu verwalten, etwa in einem Deployment, StatefulSet oder DaemonSet. So bleibt das Scheduling-Verhalten konsistent, wenn Pods neu erstellt oder skaliert werden.
Tolerations mit Node Affinity kombinieren
Eine Toleration macht einen Pod lediglich für Nodes mit Taints zulässig, lenkt ihn aber nicht dorthin. Soll ein Workload gezielt auf einem bestimmten Node-Pool laufen, kombinieren Sie Tolerations mit Node Affinity oder Node-Selektoren.
Ein GPU-Workload kann beispielsweise den Taint der GPU-Nodes tolerieren und gleichzeitig per Node Affinity Nodes mit dem passenden GPU-Typ-Label verlangen. Der Taint hält gewöhnliche Workloads fern, während die Affinity den GPU-Workload zu kompatiblen Nodes lenkt.
Wählen Sie zwischen Required- und Preferred-Node-Affinity, je nachdem, wie strikt die Platzierung sein muss. Required Affinity verhindert das Scheduling auf nicht passenden Nodes, während Preferred Affinity dem Scheduler mehr Flexibilität lässt, wenn keine geeigneten Nodes verfügbar sind.
Taints und Tolerations über Node-Pools hinweg konsistent halten
Verwenden Sie ein einheitliches Namensschema für Taint-Keys und -Values über alle Node-Pools hinweg. Inkonsistente Werte wie workload=gpu, type=gpu und node=gpu für denselben Zweck erschweren die Pflege der Pod-Konfigurationen und erhöhen das Risiko von Scheduling-Fehlern.
Definieren Sie Standard-Taints für gängige Node-Rollen und wenden Sie sie über Cluster- oder Infrastruktur-Automatisierung an. Workload-Manifeste können dann über Development, Staging und Produktion hinweg vorhersehbare Tolerations verwenden – ohne unnötige Konfigurationsunterschiede.
Konsistenz ist besonders wichtig, wenn Nodes automatisch von Cluster-Autoscaling-Systemen erstellt oder ersetzt werden. Neue Nodes sollten bereits beim Provisioning die erwarteten Taints und Labels erhalten, damit sich Workloads unabhängig von der jeweiligen Node-Instanz gleich verhalten.
Spezialisierte und teure Nodes schützen
Nutzen Sie Taints, um zu verhindern, dass allgemeine Pods spezialisierte Ressourcen wie GPUs, Instanzen mit viel Arbeitsspeicher oder andere teure Hardware belegen. Nur Workloads, die für diese Ressourcen ausgelegt sind, sollten die entsprechenden Tolerations erhalten.
Tolerations allein stellen nicht sicher, dass ein Pod die spezialisierte Ressource tatsächlich anfordert. Konfigurieren Sie für GPU-Workloads beispielsweise neben der Toleration auch die passenden Resource Requests oder Limits. Node Affinity bietet zusätzliche Kontrolle über die Platzierung, wenn mehrere Hardware-Typen verfügbar sind.
Dieser Ansatz verhindert, dass Workloads mit niedriger Priorität Kapazitäten belegen, die spezialisierte Anwendungen benötigen. Er kann zudem die Infrastrukturkosten senken, indem teure Nodes für Workloads verfügbar bleiben, die von ihrer Hardware profitieren.
Scheduling-Ergebnisse überwachen – nicht nur die Konfiguration
Eine gültige Toleration garantiert nicht, dass ein Pod erfolgreich eingeplant wird. Ressourcenverfügbarkeit, Node Affinity, Topologie-Beschränkungen, Pod Affinity und Anti-Affinity sowie andere Scheduler-Regeln können die Platzierung weiterhin verhindern.
Überwachen Sie Pods im Status Pending, Scheduler-Events, Node-Taints und die tatsächliche Pod-Platzierung, um zu überprüfen, ob sich die Scheduling-Richtlinien wie beabsichtigt verhalten. Befehle wie kubectl describe pod und kubectl describe node helfen dabei, Taint-Unstimmigkeiten und andere Scheduling-Beschränkungen zu identifizieren.
Das Monitoring sollte auch unerwartete Platzierungen erkennen – nicht nur Pods, die im Status Pending verbleiben. Ein Workload, der erfolgreich auf dem falschen Node-Pool läuft, kann auf zu breit gefasste Tolerations oder fehlende Affinity-Regeln hindeuten. Regelmäßige Prüfungen stellen sicher, dass die Scheduling-Richtlinien auch bei Veränderungen im Cluster und bei den Workloads weiterhin funktionieren.
FAQ
Was ist eine Kubernetes Toleration? Eine Toleration ist eine Einstellung in der Spezifikation eines Pods, die es dem Pod erlaubt, auf Nodes mit passenden Taints eingeplant zu werden. Sie erlaubt das Scheduling lediglich. Sie garantiert nicht, dass der Pod auf einem Node mit Taint landet, da Ressourcenanforderungen und Node Affinity weiterhin gelten.
Was ist der Unterschied zwischen einem Taint und einer Toleration? Taints werden auf Nodes angewendet und halten Pods fern, die keine passende Toleration haben. Tolerations werden auf Pods angewendet und erlauben das Scheduling auf Nodes mit passenden Taints, erzwingen es aber nicht.
Was ist der Unterschied zwischen den Operatoren Equal und Exists? Equal verlangt, dass Key, Value und Effect der Toleration mit dem Taint übereinstimmen, und ist der Standard, wenn kein Operator gesetzt ist. Exists gleicht nur anhand des Keys ab – der Value muss weggelassen werden – und toleriert jeden Value für diesen Key.
Was bewirken die Effekte NoSchedule, PreferNoSchedule und NoExecute? NoSchedule blockiert neue Pods ohne passende Toleration, lässt laufende Pods aber unangetastet. PreferNoSchedule ist eine weiche Variante, bei der der Scheduler versucht, den Node zu meiden. NoExecute entfernt zusätzlich laufende Pods, die den Taint nicht tolerieren.
Was bewirkt tolerationSeconds? Bei einer NoExecute-Toleration legt tolerationSeconds fest, wie lange ein Pod nach dem Auftreten eines passenden Taints auf einem Node bleiben darf. Ist diese Zeit abgelaufen und der Taint besteht weiterhin, entfernt Kubernetes den Pod. Wird der Wert weggelassen, bleibt der Pod, solange der Taint vorhanden ist.
Sorgt eine Toleration dafür, dass ein Pod auf einem Node mit Taint läuft? Nein. Eine Toleration macht den Pod lediglich für solche Nodes zulässig. Um einen Pod gezielt auf einen bestimmten Node-Pool zu lenken, kombinieren Sie die Toleration mit Node Affinity oder einem Node-Selektor.
Toleration-basiertes Scheduling mit PerfectScale effizienter machen
Taints und Tolerations entscheiden, wo Pods laufen dürfen – sie sagen aber nichts darüber aus, ob diese Nodes richtig dimensioniert sind oder ob die dort landenden Workloads die passende Menge an CPU und Arbeitsspeicher anfordern. PerfectScale ist eine Plattform für Kubernetes-Optimierung und -Governance, die sich mit einem einzigen Helm-Befehl bereitstellen lässt und anschließend umsetzbare Erkenntnisse sowie autonome Optimierung über den gesamten K8s-Stack liefert – Workloads, Nodes und Autoscaler –, damit reservierte, spezialisierte und teure Node-Pools tatsächlich effizient genutzt werden.
Die wichtigsten Funktionen von PerfectScale:
- Autonomes Workload-Right-Sizing: Podfit bietet einen granularen Blick auf Zustand und Kosten des Clusters, deckt verschwendete Ressourcen und Resilienzprobleme auf und optimiert Workloads autonom mit datenbasierten Right-Sizing-Empfehlungen, die sich automatisieren lassen.
- Auslastungs-Insights auf Node-Ebene: Infrafit macht ungenutzte Node-Kapazität sichtbar und empfiehlt die richtigen Node-Typen für Ihre Workloads – so liefern dedizierte, GPU- und andere Node-Pools mit Taints Spitzenleistung, ohne dass Sie für ungenutzte Kapazität zahlen.
- Autoscaler-Optimierung: PerfectScale lässt sich mit HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning und Google Autopilot integrieren und maximiert so die Effektivität der Systeme, die Ihre Nodes mit Taints bereitstellen und ersetzen.
- Echtzeit-Alerts mit automatischer Priorisierung: Resilienzrisiken und Kostenanomalien werden nach Auswirkung priorisiert und direkt an Slack, Datadog, MS Teams oder PagerDuty gemeldet – bevor sie Ihre Nutzer oder Ihre Cloud-Rechnung erreichen.
- Trends, Governance und Prognosen: Der Trends-Report bietet detaillierte Einblicke in Kosten-, Waste- und Risikometriken im Zeitverlauf – über Cluster, Node-Gruppen, Namespaces und Workloads hinweg – und unterstützt Root-Cause-Analysen sowie eine präzise Budgetplanung.
- Jede Kubernetes-Umgebung: PerfectScale läuft sowohl auf On-Premise- als auch auf Cloud-Clustern, einschließlich OpenShift, EKS, GKE, AKS und hybriden Setups, und unterstützt Windows-Container sowie kurzlebige oder ML-Workloads wie Airflow- und Spark-Jobs.