


¿Qué es Kubernetes Service Discovery?
Kubernetes Service Discovery es el mecanismo integrado que permite que los microservicios en contenedores se encuentren y se comuniquen entre sí de forma dinámica, sin necesidad de codificar direcciones IP volátiles. Como los Pods de Kubernetes son efímeros (se destruyen, se recrean y reciben nuevas IPs con frecuencia), Kubernetes los abstrae detrás de una entidad de enrutamiento lógica y permanente conocida como Service.
Componentes centrales del service discovery: Kubernetes combina varias capas arquitectónicas del sistema para rastrear los backends y enrutar el tráfico de red de forma ordenada:
- Objetos Service: una capa de abstracción que define un conjunto lógico de Pods y una política para acceder a ellos. Los Services encuentran los Pods objetivo mediante Labels y Selectors definidos por el usuario.
- EndpointSlices: objetos gestionados automáticamente por el control plane que rastrean en tiempo real las direcciones IP y los estados de readiness de todos los Pods individuales a los que apunta un Service.
- CoreDNS: la infraestructura DNS interna del clúster. Actúa como registro central y asigna los nombres legibles de los Services directamente a sus direcciones IP internas de destino.
- Kube-proxy: un agente de red que se ejecuta en cada worker node. Actualiza dinámicamente las reglas de red del sistema (como IPVS o
iptables) para interceptar y balancear las solicitudes de los clientes dirigidas a la IP de un Service.
Tipos de Service para distintas necesidades de enrutamiento:
Según dónde se originen las solicitudes de los clientes y cómo deban descubrir los destinos, los desarrolladores configuran el parámetro spec.type de un Service:
| Tipo de Service | Comportamiento de resolución | Caso de uso típico |
|---|---|---|
| ClusterIP | Asigna una dirección IP virtual estable, solo interna. | Comunicación privada entre microservicios dentro del clúster. |
| NodePort | Abre un puerto estático en la interfaz externa de cada worker node. | Exponer servicios internos a routers de hardware externos. |
| LoadBalancer | Aprovisiona automáticamente un balanceador de carga externo en la nube. | Acceso público directo para tráfico de internet en producción. |
| ExternalName | Devuelve un registro CNAME estándar que apunta a un dominio externo. |
Mapear hooks internos del código a APIs de terceros. |
Este artículo forma parte de una serie sobre Kubernetes scheduling
En este artículo:
- ¿Por qué Kubernetes necesita Service Discovery?
- Componentes centrales del Service Discovery
- Métodos de Service Discovery en Kubernetes
- Ejemplo de Kubernetes Service Discovery
- Tipos de Service de Kubernetes y Service Discovery
- Buenas prácticas de Kubernetes Service Discovery
¿Por qué Kubernetes necesita Service Discovery? {#why-does-kubernetes-need-service-discovery}
Los workloads de Kubernetes son muy dinámicos. Los Pods pueden reiniciarse, escalar, moverse entre nodos o ser reemplazados, lo que significa que sus direcciones IP pueden cambiar con frecuencia. El Service Discovery ofrece a las aplicaciones formas estables de localizar estos workloads sin rastrear las direcciones de cada Pod:
- IPs de Pod dinámicas: los Pods suelen recibir una nueva dirección IP cuando se recrean. El Service Discovery elimina la necesidad de que las aplicaciones mantengan listas de IPs cambiantes.
- Actualización automática de endpoints: los Services de Kubernetes rastrean los Pods coincidentes y actualizan sus endpoints disponibles a medida que se agregan, eliminan o reemplazan Pods.
- Comunicación confiable entre servicios: las aplicaciones pueden conectarse mediante nombres de Service estables en lugar de dirigirse directamente a Pods individuales.
- Soporte para el escalado: cuando un workload escala a múltiples Pods, el Service Discovery pone las nuevas instancias a disposición automáticamente y permite distribuir el tráfico entre ellas.
- Menos sobrecarga de configuración: los desarrolladores no necesitan actualizar manualmente la configuración de la aplicación cada vez que cambia la topología del clúster.
- Microservicios desacoplados: los servicios pueden comunicarse mediante nombres lógicos, lo que permite desplegar, escalar o reiniciar cada componente de forma independiente.
Componentes centrales del Service Discovery
Objetos Service
Un Service de Kubernetes es un objeto de la API que expone una aplicación de red que se ejecuta como uno o más Pods. En el caso más común, un Service usa un label selector para determinar qué Pods pertenecen a su conjunto de backends. Kubernetes luego mantiene EndpointSlices que contienen los endpoints que coinciden con ese selector.
El tipo de Service predeterminado, ClusterIP, recibe una dirección IP virtual interna del clúster. Los clientes pueden conectarse a esa dirección estable del Service aunque los Pods detrás de ella se reemplacen o escalen. Esto desacopla a las aplicaciones cliente de las cambiantes IPs de Pod que componen el workload backend.
Los Services también pueden ser headless si se establece .spec.clusterIP en None. En ese caso, Kubernetes no asigna una IP de clúster al Service, y el DNS puede devolver en su lugar las direcciones de los endpoints individuales del Service.
EndpointSlices
Los EndpointSlices representan subconjuntos de los endpoints de red que respaldan un Service de Kubernetes. Para un Service con selector, el control plane de Kubernetes crea automáticamente EndpointSlices con referencias a los Pods que coinciden con ese selector.
Los EndpointSlices se diseñaron para escalar con mayor eficiencia que la antigua API de Endpoints. En lugar de almacenar todas las direcciones de backend en un único objeto de gran tamaño, Kubernetes puede dividir los endpoints en múltiples objetos EndpointSlice. De forma predeterminada, el control plane crea otro EndpointSlice cuando los existentes alcanzan el objetivo por defecto de 100 endpoints.
Los EndpointSlices pueden contener direcciones de endpoints, puertos, información de readiness, información de nodos y otros metadatos que utilizan los componentes de red del clúster. También son la fuente de información de endpoints backend que usa kube-proxy al enrutar el tráfico interno de los Services.
La API heredada de Endpoints quedó obsoleta en favor de los EndpointSlices, y la documentación actual de Kubernetes recomienda que los clientes usen la API de EndpointSlice en su lugar.
CoreDNS
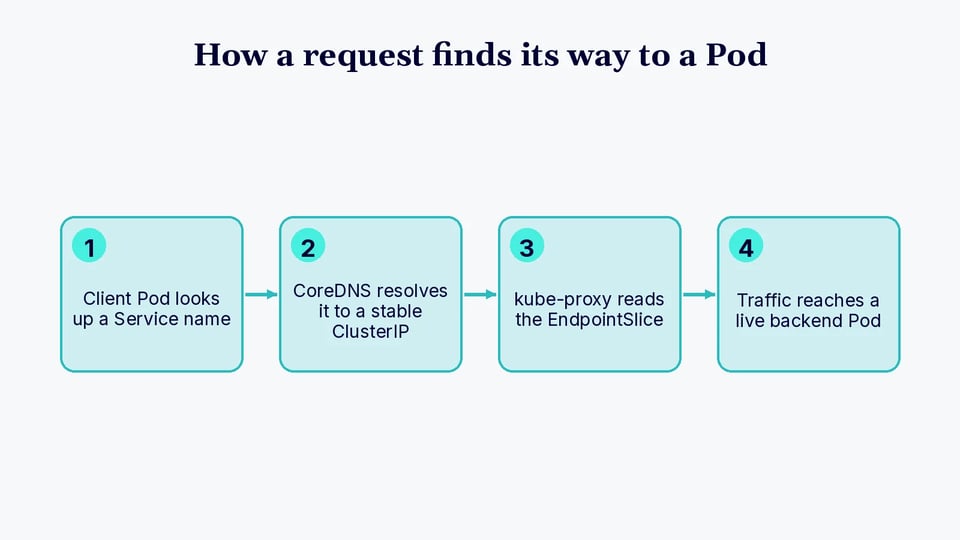
Los clústeres de Kubernetes suelen usar CoreDNS como implementación de DNS del clúster. Un servidor DNS con conocimiento del clúster observa la información de Kubernetes y crea registros DNS que permiten a los Pods buscar Services por nombre. Kubernetes configura los ajustes DNS de los Pods a través del kubelet, de modo que las aplicaciones puedan usar la resolución DNS estándar en lugar de dirigirse a los Services por IP.
Por ejemplo, considera un Service llamado my-service en el namespace my-namespace. Un Pod puede dirigirse a él usando un nombre DNS como:
my-service.my-namespaceUn nombre de Service completamente calificado suele seguir esta estructura:
my-service.my-namespace.svc.cluster.localEl dominio exacto del clúster puede diferir de cluster.local si el administrador del clúster configuró otro dominio. Dentro del mismo namespace, las aplicaciones normalmente pueden usar solo el nombre corto del Service, como my-service. Los Pods de otro namespace suelen necesitar incluir el namespace del Service.
kube-proxy
kube-proxy es la implementación predeterminada de proxy de Services en Kubernetes. En los nodos donde se usa kube-proxy, este observa los objetos Service y EndpointSlice y configura el plano de datos de red del nodo para que el tráfico enviado a la IP virtual y al puerto de un Service pueda redirigirse a uno de sus endpoints.
En Linux, las implementaciones actuales de kube-proxy admiten los modos iptables, nftables e ipvs. En Windows, kube-proxy admite el modo kernelspace. El modo IPVS está obsoleto a partir de Kubernetes v1.35, mientras que nftables está disponible como una implementación de proxy más reciente para Linux.
Es útil distinguir el descubrimiento del reenvío de tráfico: el DNS ayuda a una aplicación a descubrir la identidad estable del Service, mientras que kube-proxy, o una implementación alternativa de proxy de Services, suele encargarse de reenviar el tráfico desde esa IP virtual del Service hacia un endpoint backend adecuado. Algunas implementaciones de red de Kubernetes reemplazan kube-proxy con su propia implementación de proxy de Services.
Métodos de Service Discovery en Kubernetes {#kubernetes-service-discovery-methods}
Service Discovery basado en DNS
El DNS es el método estándar y, en general, el preferido para descubrir Services desde aplicaciones que se ejecutan dentro de un clúster de Kubernetes. Kubernetes asigna nombres DNS a los Services, y un servidor DNS con conocimiento del clúster, como CoreDNS, permite resolver esos nombres desde los Pods.
Por ejemplo, si existe un Service llamado backend en el namespace default, un Pod del mismo namespace normalmente puede conectarse usando:
backendUn Pod de otro namespace puede usar:
backend.defaulto el nombre completamente calificado:
backend.default.svc.cluster.localPara un Service ClusterIP normal, el nombre DNS se resuelve a la IP de clúster del Service. Kubernetes también admite registros DNS para Services headless y registros SRV para puertos de Service con nombre.
Como las aplicaciones realizan búsquedas DNS estándar, no necesitan implementar un protocolo de descubrimiento específico de Kubernetes.
Service Discovery basado en variables de entorno
Kubernetes también puede publicar información sobre los Services activos como variables de entorno dentro de los Pods. Cuando el kubelet inicia un Pod, puede agregar variables basadas en los Services que ya existen. Para un Service llamado my-service, por ejemplo, las variables generadas incluyen formas como:
MY_SERVICE_SERVICE_HOSTMY_SERVICE_SERVICE_PORTLa variable de host contiene la IP de clúster del Service, mientras que la variable de puerto contiene su puerto de Service.
Este mecanismo tiene una limitación de orden importante: el Service debe existir antes de que se cree el Pod cliente para que sus variables de entorno se completen en ese Pod. Crear un Service más tarde no agrega retroactivamente esas variables a un Pod que ya está en ejecución. El descubrimiento basado en DNS no tiene este requisito de orden.
Las variables de entorno de Service también pueden deshabilitarse para un Pod mediante el campo enableServiceLinks cuando no son necesarias.
Ejemplo de Kubernetes Service Discovery {#kubernetes-service-discovery-example}
Crear el Deployment de backend
Crea un Deployment con dos réplicas de nginx:
apiVersion: apps/v1kind: Deploymentmetadata: name: internal-webspec: replicas: 2 selector: matchLabels: app: internal-web template: metadata: labels: app: internal-web spec: containers: - name: web-server image: nginx:stable ports: - containerPort: 80Guarda el manifiesto como nginx-deployment.yaml y aplícalo:
kubectl apply -f nginx-deployment.yamlVerifica que los Pods estén en ejecución:
kubectl get pods -l app=internal-web -o wideEl Deployment mantiene la cantidad de réplicas solicitada. Si uno de estos Pods se elimina y se reemplaza, el reemplazo puede recibir una IP de Pod diferente, lo cual es una de las razones por las que los clientes deberían usar un Service en lugar de depender directamente de estas direcciones.
Crear el Service de Kubernetes
Crea un Service ClusterIP que seleccione los Pods con la etiqueta app: internal-web:
apiVersion: v1kind: Servicemetadata: name: internal-webspec: selector: app: internal-web ports: - protocol: TCP port: 8080 targetPort: 80Guarda este manifiesto como nginx-service.yaml y aplícalo:
kubectl apply -f nginx-service.yamlRevisa el Service:
kubectl get service internal-webDeberías ver una salida similar a:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S)internal-web ClusterIP 10.96.100.10 <none> 8080/TCPLa IP de clúster específica la asigna tu clúster, por lo que puede variar.
También puedes inspeccionar los EndpointSlices creados para el Service:
kubectl get endpointslices -l kubernetes.io/service-name=internal-webLas direcciones de los endpoints deberían corresponder a los Pods seleccionados por el Service. Si esos Pods se reemplazan o el Deployment se escala, Kubernetes actualiza los EndpointSlices del Service en consecuencia.
Descubrir el Service desde otro Pod
Inicia un Pod temporal con BusyBox:
kubectl run service-test --image=busybox --restart=Never --command -- sleep 3600Cuando el Pod esté en ejecución, usa nslookup para consultar el nombre del Service:
kubectl exec service-test -- nslookup internal-webLa respuesta DNS debería resolver internal-web a la ClusterIP del Service.
También puedes consultar el nombre calificado con el namespace:
kubectl exec service-test -- nslookup internal-web.defaulto el nombre de Service completamente calificado cuando el clúster usa el dominio de clúster predeterminado:
kubectl exec service-test -- nslookup internal-web.default.svc.cluster.localEsto demuestra el beneficio clave de Kubernetes Service Discovery: el cliente solo necesita conocer el nombre estable internal-web. No necesita saber qué Pods de nginx existen en cada momento ni qué direcciones IP tienen. El DNS de Kubernetes resuelve la identidad del Service, los EndpointSlices rastrean el conjunto actual de backends y la implementación de proxy de Services del clúster reenvía el tráfico del Service a un endpoint adecuado.
Cuando termines las pruebas, elimina el Pod temporal:
kubectl delete pod service-testTipos de Service de Kubernetes y Service Discovery {#kubernetes-service-types-and-service-discovery}
ClusterIP
Un Service ClusterIP expone una aplicación en una dirección IP virtual estable accesible desde dentro del clúster. Es el tipo de Service predeterminado y se usa comúnmente para la comunicación entre componentes internos de la aplicación.
Los clientes normalmente descubren un Service ClusterIP a través de su nombre DNS en lugar de su dirección IP asignada. El DNS resuelve el nombre del Service a la IP de clúster, mientras que la implementación de proxy de Services del clúster reenvía el tráfico a uno de los endpoints actuales del Service. Esto permite reemplazar o escalar los Pods backend sin que los clientes tengan que actualizar su configuración.
NodePort
Un Service NodePort expone un Service en un puerto de cada nodo del clúster, además de proporcionar la IP de clúster normal del Service. Los clientes que pueden alcanzar un nodo pueden acceder al Service usando la dirección del nodo y el puerto asignado.
NodePort cambia la forma en que se puede alcanzar el Service, pero no reemplaza los mecanismos internos de descubrimiento de Kubernetes. Los Pods dentro del clúster aún pueden descubrir el Service a través de su nombre DNS y su IP de clúster. NodePort suele usarse como base para el acceso externo o cuando los clientes necesitan conectarse directamente mediante las direcciones de los nodos.
LoadBalancer
Un Service LoadBalancer solicita un balanceador de carga externo a un proveedor de nube compatible o a otra implementación de balanceo de carga. El balanceador de carga externo recibe el tráfico desde fuera del clúster y lo dirige hacia el Service de Kubernetes.
Internamente, el Service se puede seguir descubriendo a través del DNS de Kubernetes, igual que los demás Services. La principal diferencia es que los clientes externos pueden usar la dirección o el hostname asignado al balanceador de carga. El aprovisionamiento exacto y la ruta del tráfico dependen de la infraestructura del clúster y de la implementación del balanceador de carga.
ExternalName
Un Service ExternalName asigna el nombre de un Service de Kubernetes a un nombre DNS externo. En lugar de seleccionar Pods o mantener EndpointSlices de backend, devuelve un registro DNS CNAME que apunta al valor configurado en el campo externalName del Service.
Por ejemplo, una aplicación puede acceder a un nombre como database.default.svc.cluster.local, mientras el DNS de Kubernetes redirige la resolución hacia un hostname externo como database.example.com. Esto proporciona un nombre local de Kubernetes para una dependencia externa, aunque las aplicaciones deben tener en cuenta protocolos como TLS y HTTP que pueden depender del hostname usado por el cliente.
Buenas prácticas de Kubernetes Service Discovery {#kubernetes-service-discovery-best-practices}
Estas son algunas prácticas útiles para tener en cuenta al usar el Service discovery de Kubernetes.
1. Usa el DNS de Kubernetes en lugar de IPs de Pod fijas
Usa los nombres DNS de los Services como la forma predeterminada en que las aplicaciones localizan otros workloads. Las direcciones IP de los Pods son temporales y pueden cambiar cuando los Pods se reinician, se reemplazan o se mueven a otro nodo. Codificar estas direcciones de forma fija hace que las aplicaciones dependan de detalles de infraestructura que Kubernetes está diseñado para gestionar dinámicamente.
Configura los clientes con nombres como backend o backend.production en lugar de almacenar direcciones de Pods. Esto mantiene la configuración de la aplicación independiente de la ubicación de los workloads y permite que Kubernetes actualice los endpoints subyacentes sin requerir cambios en los clientes.
Prefiere los nombres calificados con namespace cuando las aplicaciones se comunican entre namespaces. Los nombres DNS completamente calificados también pueden evitar ambigüedades en entornos con Services de nombres similares. Las aplicaciones deberían manejar la caché DNS de forma razonable para que los registros se actualicen cuando sea necesario.
2. Aplica right-sizing a los workloads sin comprometer la disponibilidad del servicio
Ejecuta suficientes réplicas para mantener la disponibilidad del servicio durante fallas de Pods, despliegues, eventos de escalado y mantenimiento de rutina. Para los servicios importantes, depender de un solo Pod crea un punto en el que el Service puede quedarse temporalmente sin endpoints utilizables.
Define resource requests y límites apropiados para que los Pods puedan programarse de forma confiable sin consumir capacidad del clúster innecesariamente. Requests demasiado altos pueden dificultar la programación de los Pods, mientras que requests demasiado bajos pueden contribuir a la contención de recursos y a un rendimiento inestable.
Usa readiness probes para evitar que Kubernetes envíe tráfico del Service a Pods antes de que estén listos para atender solicitudes. Para workloads que requieren una disponibilidad mínima durante interrupciones voluntarias, considera PodDisruptionBudgets y distribuye las réplicas entre nodos o dominios de falla cuando corresponda.
3. Mantén coherentes los selectors de Service y las etiquetas de los Pods
Un Service basado en selector solo enruta tráfico a los Pods cuyas etiquetas coinciden con su selector. Por lo tanto, etiquetas incorrectas o inconsistentes pueden dejar a un Service sin endpoints incluso cuando los Pods de la aplicación están en ejecución.
Usa un esquema de etiquetado predecible y gestiona juntos los selectors de los Services y las etiquetas de los workloads. Evita cambiar las etiquetas usadas por Services activos sin considerar cómo afectará el cambio a la pertenencia de endpoints durante un despliegue.
Comandos como kubectl get pods --show-labels y kubectl get endpointslices -l kubernetes.io/service-name=<service-name> pueden ayudar a confirmar que los Pods esperados están registrados como endpoints. Si un Service existe pero no tiene endpoints, revisar los selectors, las etiquetas y el readiness de los Pods es un buen primer paso de diagnóstico.
4. Monitorea la salud de los EndpointSlices
Monitorea los EndpointSlices para verificar que los Services tengan la cantidad esperada de endpoints backend utilizables. Un conjunto de endpoints vacío o más pequeño de lo esperado puede indicar discrepancias de selector, verificaciones de readiness fallidas, Pods no disponibles o problemas de despliegue.
Incluye la disponibilidad de Services y endpoints en el monitoreo y las alertas del clúster. Los cambios en la cantidad de endpoints pueden ser especialmente útiles para identificar fallas durante despliegues o eventos de autoscaling antes de que se conviertan en problemas de disponibilidad más amplios.
Durante el diagnóstico, inspecciona los EndpointSlices junto con el estado de los Pods, las condiciones de readiness y la configuración del Service. Esto ayuda a distinguir un problema de descubrimiento de una falla de aplicación, de DNS o de red. El monitoreo debería centrarse no solo en si un Service existe, sino también en si tiene endpoints saludables capaces de recibir tráfico.
Contenido relacionado: lee nuestro artículo sobre el monitoreo de Kubernetes para una visión más amplia de las métricas y alertas del clúster.
5. Coordina el Service Discovery con el autoscaling
El autoscaling cambia la cantidad de Pods detrás de un Service, por lo que el descubrimiento y el enrutamiento de tráfico deben responder correctamente a medida que se agregan y eliminan réplicas. Kubernetes actualiza los EndpointSlices a medida que los Pods elegibles entran o salen del conjunto de backends, lo que permite a los clientes seguir usando el mismo nombre de Service durante los eventos de escalado.
Configura las readiness probes con cuidado para que los Pods recién creados reciban tráfico solo cuando puedan atender solicitudes. Durante el scale-down, los ajustes de terminación ordenada pueden dar tiempo a que las solicitudes y conexiones existentes se completen mientras los endpoints se retiran del uso activo.
Las aplicaciones también deberían usar una caché DNS razonable, tiempos de espera de conexión, reintentos y un buen comportamiento del pool de conexiones. Los clientes que mantienen conexiones abiertas indefinidamente pueden seguir comunicándose con un conjunto limitado de backends y no aprovechar las réplicas recién agregadas. Por lo tanto, el comportamiento del cliente debería complementar el autoscaling y la gestión de endpoints de Kubernetes, en lugar de trabajar en su contra.
Mantén saludables los endpoints de tus Services con PerfectScale
La calidad del service discovery depende directamente de los Pods que hay detrás. Cuando los workloads están subaprovisionados, mal configurados o escalados de forma ineficiente, los Services terminan con muy pocos endpoints saludables, y el enrutamiento de tráfico se ve afectado aunque la resolución DNS funcione correctamente. PerfectScale es una plataforma de optimización de Kubernetes que se despliega una sola vez mediante Helm y que luego ofrece información accionable y optimización autónoma en todo tu stack de K8s, para que los workloads se mantengan eficientes en costos y lo suficientemente resilientes como para seguir atendiendo tráfico.
Capacidades clave de PerfectScale:
- Right-sizing autónomo de workloads: Podfit proporciona una vista granular de la salud y los costos del clúster, priorizando las áreas que necesitan atención mientras optimiza los workloads de forma autónoma y pone en evidencia los recursos desaprovechados y los problemas de resiliencia.
- Recomendaciones de escalado basadas en datos: PerfectScale ofrece recomendaciones accionables para mejorar las configuraciones de HPA y KEDA, y se integra con soluciones de autoscaling como HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning y Google Autopilot.
- Optimización a nivel de nodo: Infrafit ofrece visibilidad completa de la utilización de los nodos, lo que te ayuda a identificar y eliminar la capacidad ociosa y a elegir los nodos adecuados para tus workloads con recomendaciones basadas en datos.
- Alertas en tiempo real con priorización automática: la priorización basada en impacto te ayuda a resolver riesgos de resiliencia e identificar picos de costos y anomalías antes de que lleguen a los usuarios, con alertas entregadas en Slack, Datadog, MS Teams o PagerDuty.
- Reportes de tendencias para gobernanza y pronósticos: visibilidad granular de las métricas de costo, pérdida y riesgo a lo largo del tiempo en clústeres, grupos de nodos, namespaces y workloads, con análisis de causa raíz para evitar que los problemas se repitan.
- Amplio soporte de entornos: PerfectScale funciona tanto en entornos on-premise como en la nube, se integra con nubes privadas como OpenShift y nubes públicas como EKS, GKE y AKS, y también admite contenedores basados en Windows.
Descubre cómo la plataforma PerfectScale mantiene tus workloads de Kubernetes con el tamaño adecuado, resilientes y listos para atender tráfico.
Preguntas frecuentes
¿Cuál es la diferencia entre un Service de Kubernetes y un EndpointSlice? Un Service es la puerta de entrada lógica y estable: un nombre y una IP virtual a los que se conectan los clientes. Un EndpointSlice es la lista detrás de esa puerta: el conjunto real de IPs de Pods que actualmente coinciden con el selector del Service, que se mantiene actualizado automáticamente a medida que los Pods aparecen y desaparecen.
¿Kubernetes prefiere el service discovery basado en DNS o en variables de entorno? El DNS es el método estándar y, en general, el preferido. El descubrimiento basado en variables de entorno tiene una limitación de orden: el Service ya debe existir antes de que se cree el Pod cliente, o ese Pod nunca recibe las variables. Las búsquedas DNS no tienen esta restricción.
¿Por qué un Service mostraría cero endpoints aunque sus Pods estén en ejecución?
Casi siempre se trata de una discrepancia entre el selector del Service y las etiquetas de los Pods, aunque las verificaciones de readiness fallidas también pueden causarlo. Revisar kubectl get endpointslices junto con kubectl get pods --show-labels es la forma más rápida de confirmar cuál es la causa.
¿Cuál es la diferencia entre ClusterIP, NodePort y LoadBalancer? ClusterIP es solo interno y es el tipo predeterminado. NodePort agrega un puerto estático en cada nodo para que el Service pueda alcanzarse desde fuera del clúster. LoadBalancer aprovisiona un balanceador de carga externo en la nube delante del Service. Los tres se pueden seguir descubriendo dentro del clúster a través del mismo nombre DNS.
¿El autoscaling rompe el service discovery? No, pero sí requiere que los clientes cooperen con él. Kubernetes actualiza los EndpointSlices automáticamente a medida que las réplicas aumentan o disminuyen, pero los clientes que mantienen conexiones abiertas indefinidamente pueden seguir comunicándose con un conjunto obsoleto y más reducido de backends en lugar de aprovechar las réplicas recién agregadas.