


Kubernetesサービスディスカバリとは?
Kubernetesサービスディスカバリとは、コンテナ化されたマイクロサービスが、変動しやすいIPアドレスをハードコードすることなく、動的に相互を検出して通信できるようにする組み込みの仕組みです。KubernetesのPodはエフェメラル(頻繁に破棄・再作成され、新しいIPが割り当てられる)であるため、KubernetesはServiceと呼ばれる恒久的な論理ルーティング層の背後にPodを抽象化します。
サービスディスカバリの主要コンポーネント: Kubernetesは複数のアーキテクチャレイヤーを組み合わせて、バックエンドを追跡し、ネットワークトラフィックを適切にルーティングします:
- Serviceオブジェクト: Podの論理的な集合と、それらへのアクセスポリシーを定義する抽象化レイヤーです。Serviceは、独自に定義したラベルとセレクターを使って対象のPodを特定します。
- EndpointSlice: コントロールプレーンが自動的に管理するオブジェクトで、Serviceの対象となる各PodのリアルタイムなIPアドレスとReadiness状態を追跡します。
- CoreDNS: クラスター内部のDNS基盤です。中央レジストリとして機能し、可読性の高いService名を対象の内部IPアドレスに直接マッピングします。
- kube-proxy: すべてのワーカーノード上で動作するネットワークエージェントです。システムのネットワークルール(IPVSや
iptablesなど)を動的に更新し、ServiceのIP宛てのクライアントリクエストをインターセプトして負荷分散します。
多様なルーティングニーズに対応するServiceタイプ:
クライアントリクエストの発生元と宛先の検出方法に応じて、開発者はServiceのspec.typeパラメーターを設定します:
| Serviceタイプ | 名前解決の動作 | 主な用途 |
|---|---|---|
| ClusterIP | クラスター内部専用の安定した仮想IPアドレスを割り当てます。 | Pod間のプライベートなマイクロサービス通信。 |
| NodePort | 各ワーカーノードの外部インターフェースに静的ポートを開きます。 | 内部サービスを外部のハードウェアルーターに公開。 |
| LoadBalancer | 外部クラウドロードバランサーを自動的にプロビジョニングします。 | 本番のインターネットトラフィックに対する直接のパブリックアクセス。 |
| ExternalName | 外部ドメインを指す標準のCNAMEレコードを返します。 |
内部コードのフックをサードパーティAPIにマッピング。 |
本記事はKubernetesスケジューリングに関する連載記事の一部です
この記事で扱う内容:
- なぜKubernetesにサービスディスカバリが必要なのか?
- サービスディスカバリの主要コンポーネント
- Kubernetesサービスディスカバリの方式
- Kubernetesサービスディスカバリの実例
- KubernetesのServiceタイプとサービスディスカバリ
- Kubernetesサービスディスカバリのベストプラクティス
なぜKubernetesにサービスディスカバリが必要なのか? {#why-does-kubernetes-need-service-discovery}
Kubernetesのワークロードは非常に動的です。Podは再起動、スケール、ノード間の移動、置き換えが発生するため、IPアドレスが頻繁に変わる可能性があります。サービスディスカバリは、個々のPodのアドレスを追跡することなく、アプリケーションがこれらのワークロードを見つけるための安定した手段を提供します:
- 動的なPodのIPアドレス: Podは再作成されると通常、新しいIPアドレスを受け取ります。サービスディスカバリにより、アプリケーションが変化するIPリストを管理する必要がなくなります。
- エンドポイントの自動更新: KubernetesのServiceは一致するPodを追跡し、Podの追加・削除・置き換えに応じて利用可能なエンドポイントを更新します。
- サービス間の信頼性の高い通信: アプリケーションは個々のPodを直接指定する代わりに、安定したService名を介して接続できます。
- スケーリングへの対応: ワークロードが複数のPodにスケールすると、サービスディスカバリによって新しいインスタンスが自動的に利用可能になり、トラフィックをそれらに分散できます。
- 設定負荷の軽減: クラスターのトポロジーが変わるたびに、開発者がアプリケーション設定を手動で更新する必要はありません。
- マイクロサービスの疎結合化: サービス同士は論理名で通信できるため、各コンポーネントを独立してデプロイ・スケール・再起動できます。
サービスディスカバリの主要コンポーネント
Serviceオブジェクト
KubernetesのServiceは、1つ以上のPodとして動作するネットワークアプリケーションを公開するAPIオブジェクトです。一般的なケースでは、Serviceはラベルセレクターを使って、どのPodがバックエンドセットに属するかを決定します。Kubernetesは、そのセレクターに一致するエンドポイントを含むEndpointSliceを維持します。
デフォルトのServiceタイプであるClusterIPには、クラスター内部の仮想IPアドレスが割り当てられます。背後のPodが置き換えられたりスケールされたりしても、クライアントはその安定したServiceアドレスに接続できます。これにより、クライアントアプリケーションは、バックエンドワークロードを構成する変化し続けるPodのIPアドレスから切り離されます。
.spec.clusterIPをNoneに設定することで、Serviceをヘッドレスにすることもできます。この場合、KubernetesはServiceのクラスターIPを割り当てず、DNSは代わりにServiceの個々のエンドポイントのアドレスを返すことができます。
EndpointSlice
EndpointSliceは、KubernetesのServiceを支えるネットワークエンドポイントのサブセットを表します。セレクターを持つServiceに対しては、Kubernetesのコントロールプレーンが、そのセレクターに一致するPodへの参照を含むEndpointSliceを自動的に作成します。
EndpointSliceは、従来のEndpoints APIよりも効率的にスケールするよう設計されています。すべてのバックエンドアドレスを1つの大きなオブジェクトに格納するのではなく、Kubernetesはエンドポイントを複数のEndpointSliceオブジェクトに分割できます。デフォルトでは、既存のスライスが既定の上限である100エンドポイントに達すると、コントロールプレーンが新しいEndpointSliceを作成します。
EndpointSliceには、エンドポイントのアドレス、ポート、Readiness情報、ノード情報のほか、クラスターのネットワークコンポーネントが使用するその他のメタデータを含めることができます。また、kube-proxyが内部のServiceトラフィックをルーティングする際に使用するバックエンドエンドポイント情報の情報源でもあります。
従来のEndpoints APIはEndpointSliceへの移行に伴い非推奨となっており、現在のKubernetesドキュメントでは、クライアントにEndpointSlice APIの使用を推奨しています。
CoreDNS
Kubernetesクラスターでは、クラスターDNSの実装として一般的にCoreDNSが使用されます。クラスター対応のDNSサーバーはKubernetesの情報を監視し、PodがService名でServiceを検索できるDNSレコードを作成します。Kubernetesはkubeletを通じてPodのDNS設定を構成するため、アプリケーションはServiceをIPで指定する代わりに、標準のDNS名前解決を利用できます。
例えば、ネームスペースmy-namespaceにあるmy-serviceという名前のServiceを考えてみましょう。Podは次のようなDNS名でアクセスできます:
my-service.my-namespace完全修飾Service名は通常、次の構造に従います:
my-service.my-namespace.svc.cluster.localクラスター管理者が別のドメインを設定している場合、実際のクラスタードメインはcluster.localと異なることがあります。同じネームスペース内では、アプリケーションは通常my-serviceのような短いService名だけを使用できます。別のネームスペースにあるPodは、通常Serviceのネームスペースを含める必要があります。
kube-proxy
kube-proxyは、KubernetesにおけるServiceプロキシのデフォルト実装です。kube-proxyが使用されるノードでは、ServiceとEndpointSliceのオブジェクトを監視し、Serviceの仮想IPとポート宛てに送信されたトラフィックがいずれかのエンドポイントにリダイレクトされるよう、ノードのネットワークデータプレーンを設定します。
Linuxでは、現行のkube-proxy実装はiptables、nftables、ipvsの各モードをサポートしています。Windowsでは、kube-proxyはkernelspaceモードをサポートします。IPVSモードはKubernetes v1.35の時点で非推奨であり、nftablesはより新しいLinuxプロキシ実装として利用可能です。
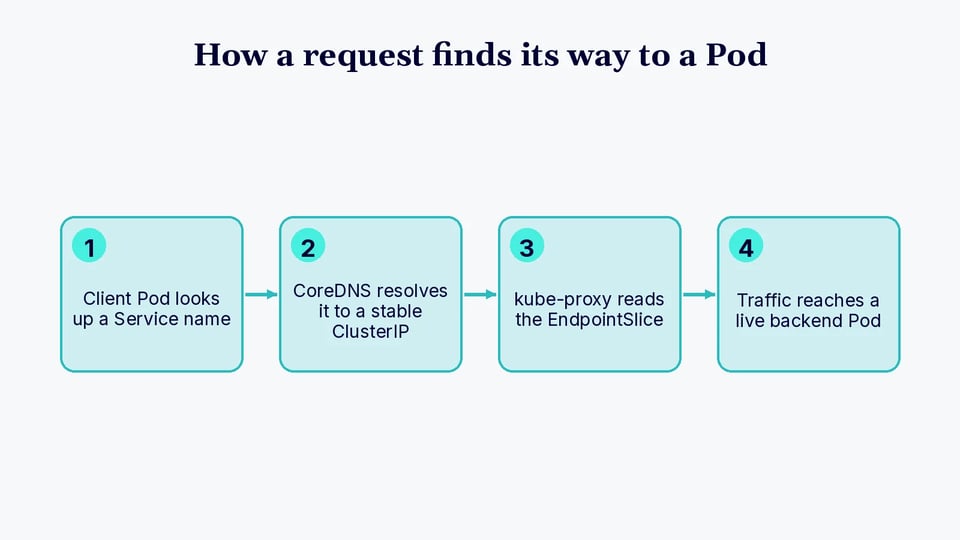
検出(ディスカバリ)とトラフィック転送を区別しておくと理解しやすくなります。DNSはアプリケーションが安定したServiceの識別情報を見つける手助けをし、kube-proxyまたは代替のServiceプロキシ実装は通常、そのServiceの仮想IPから適切なバックエンドエンドポイントへのトラフィック転送を担います。Kubernetesのネットワーク実装の中には、kube-proxyを独自のServiceプロキシ実装に置き換えるものもあります。
Kubernetesサービスディスカバリの方式 {#kubernetes-service-discovery-methods}
DNSベースのサービスディスカバリ
DNSは、Kubernetesクラスター内で動作するアプリケーションからServiceを検出するための標準的で、一般的に推奨される方法です。KubernetesはServiceにDNS名を割り当て、CoreDNSのようなクラスター対応のDNSサーバーが、それらの名前をPodから解決可能にします。
例えば、defaultネームスペースにbackendという名前のServiceが存在する場合、同じネームスペース内のPodは通常、次の名前で接続できます:
backend別のネームスペースにあるPodは次を使用できます:
backend.defaultまたは完全修飾名も使用できます:
backend.default.svc.cluster.local通常のClusterIP Serviceでは、DNS名はServiceのクラスターIPに解決されます。Kubernetesは、ヘッドレスService用のDNSレコードや、名前付きServiceポート用のSRVレコードもサポートしています。
アプリケーションは標準的なDNSルックアップを実行するだけなので、Kubernetes固有のディスカバリプロトコルを実装する必要はありません。
環境変数ベースのサービスディスカバリ
Kubernetesは、アクティブなServiceに関する情報をPod内の環境変数として公開することもできます。kubeletがPodを起動する際、すでに存在するServiceに基づいて変数を追加できます。例えばmy-serviceという名前のServiceの場合、生成される変数には次のような形式が含まれます:
MY_SERVICE_SERVICE_HOSTMY_SERVICE_SERVICE_PORTホスト変数にはServiceのクラスターIPが、ポート変数にはそのServiceポートが格納されます。
この仕組みには順序に関する重要な制約があります。Serviceの環境変数がPodに設定されるためには、クライアントPodが作成される前にServiceが存在していなければなりません。後からServiceを作成しても、すでに動作中のPodに変数が遡って追加されることはありません。DNSベースのディスカバリには、この順序の制約はありません。
Serviceの環境変数が不要な場合は、enableServiceLinksフィールドを使ってPodごとに無効化することもできます。
Kubernetesサービスディスカバリの実例 {#kubernetes-service-discovery-example}
バックエンドDeploymentの作成
nginxのレプリカを2つ持つDeploymentを作成します:
apiVersion: apps/v1kind: Deploymentmetadata: name: internal-webspec: replicas: 2 selector: matchLabels: app: internal-web template: metadata: labels: app: internal-web spec: containers: - name: web-server image: nginx:stable ports: - containerPort: 80マニフェストをnginx-deployment.yamlとして保存し、適用します:
kubectl apply -f nginx-deployment.yamlPodが動作していることを確認します:
kubectl get pods -l app=internal-web -o wideDeploymentは指定されたレプリカ数を維持します。これらのPodのいずれかが削除されて置き換えられた場合、置き換え後のPodには別のPod IPが割り当てられる可能性があります。これが、クライアントがこれらのアドレスに直接依存するのではなくServiceを使うべき理由の一つです。
Kubernetes Serviceの作成
app: internal-webラベルを持つPodを選択するClusterIP Serviceを作成します:
apiVersion: v1kind: Servicemetadata: name: internal-webspec: selector: app: internal-web ports: - protocol: TCP port: 8080 targetPort: 80このマニフェストをnginx-service.yamlとして保存し、適用します:
kubectl apply -f nginx-service.yamlServiceを確認します:
kubectl get service internal-web次のような出力が表示されるはずです:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S)internal-web ClusterIP 10.96.100.10 <none> 8080/TCP具体的なクラスターIPはクラスターによって割り当てられるため、環境により異なります。
Service用に作成されたEndpointSliceを確認することもできます:
kubectl get endpointslices -l kubernetes.io/service-name=internal-webエンドポイントのアドレスは、Serviceが選択したPodに対応しているはずです。これらのPodが置き換えられたり、Deploymentがスケールされたりすると、KubernetesはServiceのEndpointSliceを適宜更新します。
別のPodからServiceを検出する
BusyBoxを含む一時的なPodを起動します:
kubectl run service-test --image=busybox --restart=Never --command -- sleep 3600Podが起動したら、nslookupでService名を問い合わせます:
kubectl exec service-test -- nslookup internal-webDNS応答では、internal-webがServiceのClusterIPに解決されるはずです。
ネームスペース付きの名前を問い合わせることもできます:
kubectl exec service-test -- nslookup internal-web.defaultクラスターがデフォルトのクラスタードメインを使用している場合は、完全修飾Service名も使用できます:
kubectl exec service-test -- nslookup internal-web.default.svc.cluster.localこれこそがKubernetesサービスディスカバリの重要なメリットです。クライアントが知る必要があるのは、安定した名前internal-webだけです。現在どのnginx Podが存在し、どのIPアドレスを持っているかを知る必要はありません。Kubernetes DNSがServiceの識別情報を解決し、EndpointSliceが現在のバックエンドセットを追跡し、クラスターのServiceプロキシ実装がServiceトラフィックを適切なエンドポイントに転送します。
テストが終わったら、一時的なPodを削除します:
kubectl delete pod service-testKubernetesのServiceタイプとサービスディスカバリ {#kubernetes-service-types-and-service-discovery}
ClusterIP
ClusterIP Serviceは、クラスター内から到達可能な安定した仮想IPアドレスでアプリケーションを公開します。デフォルトのServiceタイプであり、内部のアプリケーションコンポーネント間の通信によく使用されます。
クライアントは通常、ClusterIP Serviceを割り当てられたIPアドレスではなくDNS名で検出します。DNSがService名をクラスターIPに解決し、クラスターのServiceプロキシ実装がトラフィックをServiceの現在のエンドポイントのいずれかに転送します。これにより、クライアント側の設定を変更することなく、バックエンドのPodを置き換えたりスケールしたりできます。
NodePort
NodePort Serviceは、通常のServiceクラスターIPに加えて、各クラスターノードのポートでServiceを公開します。ノードに到達できるクライアントは、ノードのアドレスと割り当てられたノードポートを使ってServiceにアクセスできます。
NodePortはServiceへの到達方法を変えますが、Kubernetesの内部ディスカバリ機構を置き換えるものではありません。クラスター内のPodは、引き続きDNS名とクラスターIPを通じてServiceを検出できます。NodePortは、外部アクセスの構成要素として、またはクライアントがノードアドレス経由で直接接続する必要がある場合によく使用されます。
LoadBalancer
LoadBalancer Serviceは、対応するクラウドプロバイダーまたは他のロードバランサー実装に外部ロードバランサーを要求します。外部ロードバランサーはクラスター外からのトラフィックを受け取り、Kubernetes Serviceに向けて転送します。
クラスター内部では、このServiceも他のServiceと同様にKubernetes DNSで検出できます。主な違いは、外部クライアントがロードバランサーに割り当てられたアドレスやホスト名を使用できることです。実際のプロビジョニングやトラフィック経路は、クラスターのインフラとロードバランサー実装によって異なります。
ExternalName
ExternalName Serviceは、KubernetesのService名を外部のDNS名にマッピングします。Podを選択したりバックエンドのEndpointSliceを維持したりする代わりに、ServiceのexternalNameフィールドに設定された値を指すDNSのCNAMEレコードを返します。
例えば、アプリケーションはdatabase.default.svc.cluster.localのような名前にアクセスでき、Kubernetes DNSは名前解決をdatabase.example.comのような外部ホスト名にリダイレクトします。これにより、外部依存先に対してKubernetesローカルの名前を利用できますが、クライアントが使用するホスト名に依存する可能性のあるTLSやHTTPなどのプロトコルについては、アプリケーション側で考慮が必要です。
Kubernetesサービスディスカバリのベストプラクティス {#kubernetes-service-discovery-best-practices}
Kubernetesのサービスディスカバリを使用する際に押さえておきたい実践的なポイントを紹介します。
1. PodのIPをハードコードせずKubernetes DNSを使う
アプリケーションが他のワークロードを見つけるデフォルトの方法として、ServiceのDNS名を使用します。PodのIPアドレスは一時的なもので、Podの再起動、置き換え、別ノードへの移動時に変わる可能性があります。これらのアドレスをハードコードすると、Kubernetesが動的に管理するよう設計されたインフラの詳細にアプリケーションが依存してしまいます。
Podのアドレスを保存する代わりに、backendやbackend.productionのような名前でクライアントを設定します。これにより、アプリケーション設定がワークロードの配置から独立し、クライアント側の変更なしにKubernetesが背後のエンドポイントを更新できます。
アプリケーションがネームスペースをまたいで通信する場合は、ネームスペース付きの名前を優先してください。似た名前のServiceが存在する環境では、完全修飾DNS名を使うことで曖昧さを回避できます。レコードが必要なときに更新されるよう、アプリケーションは適切なDNSキャッシュ動作を採用すべきです。
2. Serviceの可用性を損なわずにワークロードをライトサイジングする
Podの障害、デプロイ、スケーリングイベント、定期メンテナンス中もサービスの可用性を維持できるよう、十分な数のレプリカを実行します。重要なサービスで単一のPodに依存すると、Serviceが一時的に利用可能なエンドポイントを持たなくなるリスクが生じます。
クラスターの容量を無駄に消費することなくPodを確実にスケジュールできるよう、適切なリソースリクエストとリミットを設定します。リクエストが高すぎるとPodのスケジュールが難しくなり、低すぎるとリソース競合や不安定なパフォーマンスにつながる可能性があります。
リクエストを処理できる状態になる前のPodにKubernetesがServiceトラフィックを送らないよう、Readinessプローブを使用します。自発的な中断時にも最低限の可用性が必要なワークロードについては、PodDisruptionBudgetの利用を検討し、必要に応じてレプリカをノードや障害ドメインに分散配置してください。
3. ServiceのセレクターとPodのラベルの一貫性を保つ
セレクターベースのServiceは、ラベルがセレクターに一致するPodにのみトラフィックをルーティングします。そのため、ラベルが誤っていたり一貫していなかったりすると、アプリケーションのPodが動作していてもServiceのエンドポイントが欠落することがあります。
予測可能なラベリング方式を採用し、Serviceのセレクターとワークロードのラベルを一緒に管理します。デプロイ中のエンドポイントのメンバーシップにどのような影響が出るかを考慮せずに、稼働中のServiceが使用するラベルを変更することは避けてください。
kubectl get pods --show-labelsやkubectl get endpointslices -l kubernetes.io/service-name=<service-name>などのコマンドで、想定したPodがエンドポイントとして登録されていることを確認できます。Serviceは存在するのにエンドポイントがない場合、セレクター、ラベル、PodのReadinessを確認することが、トラブルシューティングの最初のステップとして有効です。
4. EndpointSliceの健全性を監視する
Serviceが想定どおりの数の利用可能なバックエンドエンドポイントを持っているかを確認するため、EndpointSliceを監視します。エンドポイントセットが空だったり想定外に少なかったりする場合、セレクターの不一致、Readinessチェックの失敗、Podの利用不可、デプロイの問題などが考えられます。
クラスターの監視とアラートに、Serviceとエンドポイントの可用性を含めます。エンドポイント数の変化は、デプロイやオートスケーリングイベント中の障害を、より広範な可用性の問題に発展する前に特定するうえで特に有効です。
トラブルシューティングの際は、PodのステータスやReadinessの状態、Serviceの設定とあわせてEndpointSliceを確認します。これにより、ディスカバリの問題なのか、アプリケーション、DNS、ネットワークの障害なのかを切り分けられます。監視では、Serviceが存在するかどうかだけでなく、トラフィックを受け取れる健全なエンドポイントがあるかどうかにも注目すべきです。
関連コンテンツ: クラスターのメトリクスとアラートをより広い視点で解説したKubernetes監視に関する記事もぜひご覧ください。
5. サービスディスカバリとオートスケーリングを連携させる
オートスケーリングはServiceの背後にあるPodの数を変化させるため、レプリカの追加・削除に応じてディスカバリとトラフィックルーティングが正しく追従する必要があります。Kubernetesは、対象となるPodがバックエンドセットに出入りするたびにEndpointSliceを更新するため、クライアントはスケーリングイベント中も同じService名を使い続けられます。
新しく作成されたPodがリクエストを処理できるようになってからトラフィックを受け取るよう、Readinessプローブを慎重に設定します。スケールダウン時には、グレースフルターミネーションの設定により、エンドポイントが利用対象から外れる間に、既存のリクエストや接続を完了させる時間を確保できます。
アプリケーション側でも、適切なDNSキャッシュ、接続タイムアウト、リトライ、コネクションプールの動作を採用すべきです。接続を無期限に保持するクライアントは、限られたバックエンドとの通信を続け、新しく追加されたレプリカを活用できないことがあります。したがって、クライアントの挙動はKubernetesのオートスケーリングとエンドポイント管理を妨げるのではなく、補完するものであるべきです。
PerfectScaleでServiceのエンドポイントを健全に保つ
サービスディスカバリの効果は、その背後にあるPodの状態に左右されます。ワークロードのプロビジョニングが不足していたり、設定が誤っていたり、スケーリングが非効率だったりすると、Serviceの健全なエンドポイントが不足し、DNSの名前解決が正常に機能していてもトラフィックルーティングに支障が出ます。PerfectScaleはKubernetes最適化プラットフォームで、Helmで一度デプロイするだけで、K8sスタック全体にわたる実用的なインサイトと自律的な最適化を得られます。これにより、ワークロードはコスト効率と、トラフィックを処理し続けるのに十分なレジリエンスの両方を維持できます。
PerfectScaleの主な機能:
- 自律的なワークロードのライトサイジング: Podfitはクラスターの健全性とコストを詳細に可視化し、注意が必要な領域を優先順位付けしながら、ワークロードを自律的に最適化し、無駄なリソースやレジリエンスの問題を浮き彫りにします。
- データドリブンなスケーリング推奨: PerfectScaleはHPAやKEDAの設定を改善するための実用的な推奨を提供し、HPA、Karpenter、Cluster Autoscaler、EKS Auto Mode、Fargate、Node Auto Provisioning、Google Autopilotなどのオートスケーリングソリューションと統合します。
- ノードレベルの最適化: Infrafitはノード使用率を包括的に可視化し、アイドル状態のノード容量の特定と排除を支援するとともに、データドリブンな推奨によってワークロードに最適なノードの選択をサポートします。
- 自動優先順位付けを備えたリアルタイムアラート: 影響度に基づく優先順位付けにより、レジリエンスリスクの解消や、コストの急増・異常がユーザーに影響する前の特定を支援します。アラートはSlack、Datadog、MS Teams、PagerDutyに配信されます。
- ガバナンスと予測のためのトレンドレポート: クラスター、ノードグループ、ネームスペース、ワークロードを横断して、コスト・無駄・リスクの指標を時系列で詳細に可視化し、根本原因分析によって問題の再発を防ぎます。
- 幅広い環境サポート: PerfectScaleはオンプレミスとクラウドの両方の環境で動作し、OpenShiftなどのプライベートクラウドやEKS、GKE、AKSなどのパブリッククラウドと統合でき、Windowsベースのコンテナもサポートします。
PerfectScaleプラットフォームがKubernetesワークロードを適切なサイズに保ち、レジリエントで、トラフィックを処理できる状態に維持する仕組みについて、詳しくはこちらをご覧ください。
FAQ
KubernetesのServiceとEndpointSliceの違いは何ですか? Serviceは安定した論理的な入り口であり、クライアントが接続する名前と仮想IPです。EndpointSliceはその入り口の裏側にあるリストで、Serviceのセレクターに現在一致しているPodのIPの実際の集合を表し、Podの増減に応じて自動的に最新の状態に保たれます。
KubernetesではDNSベースと環境変数ベース、どちらのサービスディスカバリが推奨されますか? DNSが標準的で、一般的に推奨される方法です。環境変数ベースのディスカバリには順序の制約があり、クライアントPodが作成される前にServiceが存在していなければ、そのPodは変数を受け取れません。DNSルックアップにはこの制約がありません。
Podが動作しているのにServiceのエンドポイントがゼロになるのはなぜですか?
ほとんどの場合、ServiceのセレクターとPodのラベルの不一致が原因ですが、Readinessチェックの失敗が原因となることもあります。kubectl get endpointslicesとkubectl get pods --show-labelsをあわせて確認するのが、どちらが原因かを特定する最も速い方法です。
ClusterIP、NodePort、LoadBalancerの違いは何ですか? ClusterIPはクラスター内部専用で、デフォルトのタイプです。NodePortはすべてのノードに静的ポートを追加し、クラスター外からServiceに到達できるようにします。LoadBalancerはServiceの前段に外部クラウドロードバランサーをプロビジョニングします。いずれの場合も、クラスター内では同じDNS名で検出できます。
オートスケーリングはサービスディスカバリを壊しますか? いいえ。ただし、クライアント側の協調が必要です。Kubernetesはレプリカのスケールアップ・ダウンに応じてEndpointSliceを自動的に更新しますが、接続を無期限に保持するクライアントは、古くなった少数のバックエンド群と通信し続け、新しく追加されたレプリカを活用できない場合があります。