


O que é Kubernetes Service Discovery?
O Kubernetes Service Discovery é o mecanismo nativo que permite que microsserviços em contêineres se encontrem e se comuniquem dinamicamente, sem a necessidade de fixar endereços IP voláteis no código. Como os Pods do Kubernetes são efêmeros (ou seja, são frequentemente destruídos, recriados e recebem novos IPs), o Kubernetes os abstrai por trás de uma entidade de roteamento lógica e permanente conhecida como Service.
Componentes centrais do service discovery: O Kubernetes combina várias camadas arquiteturais do sistema para rastrear backends e rotear o tráfego de rede de forma limpa:
- Objetos Service: uma camada de abstração personalizada que define um conjunto lógico de Pods e uma política de acesso a eles. Os Services encontram os Pods de destino usando Labels e Selectors definidos pelo usuário.
- EndpointSlices: objetos gerenciados automaticamente pelo control plane que rastreiam, em tempo real, os endereços IP e os estados de prontidão de todos os Pods individuais visados por um Service.
- CoreDNS: a infraestrutura interna de DNS do cluster. Atua como registro central, mapeando nomes de Service legíveis por humanos diretamente para seus endereços IP internos de destino.
- Kube-proxy: um agente de rede executado em cada worker node. Ele atualiza dinamicamente as regras de rede do sistema (como IPVS ou
iptables) para interceptar e balancear as requisições de clientes direcionadas ao IP de um Service.
Tipos de Service para diferentes necessidades de roteamento:
Dependendo de onde as requisições dos clientes se originam e de como eles precisam descobrir os destinos, os desenvolvedores configuram o parâmetro spec.type de um Service:
| Tipo de Service | Comportamento de resolução | Caso de uso típico |
|---|---|---|
| ClusterIP | Aloca um endereço IP virtual estável e apenas interno. | Comunicação privada entre microsserviços (entre Pods). |
| NodePort | Abre uma porta estática na interface externa de cada worker node. | Expor serviços internos a roteadores de hardware externos. |
| LoadBalancer | Provisiona automaticamente um load balancer externo na nuvem. | Acesso público direto para tráfego de internet em produção. |
| ExternalName | Retorna um registro CNAME padrão apontando para um domínio externo. |
Mapear integrações internas do código para APIs de terceiros. |
Este artigo faz parte de uma série sobre Kubernetes scheduling
Neste artigo:
- Por que o Kubernetes precisa de Service Discovery?
- Componentes centrais do Service Discovery
- Métodos de Service Discovery no Kubernetes
- Exemplo de Service Discovery no Kubernetes
- Tipos de Service no Kubernetes e Service Discovery
- Boas práticas de Service Discovery no Kubernetes
Por que o Kubernetes precisa de Service Discovery? {#why-does-kubernetes-need-service-discovery}
Os workloads do Kubernetes são altamente dinâmicos. Pods podem reiniciar, escalar, migrar entre nós ou ser substituídos, o que significa que seus endereços IP podem mudar com frequência. O Service Discovery oferece formas estáveis de as aplicações localizarem esses workloads sem rastrear endereços de Pods individuais:
- Endereços IP dinâmicos de Pods: os Pods geralmente recebem um novo endereço IP quando são recriados. O Service Discovery elimina a necessidade de as aplicações manterem listas de IPs em constante mudança.
- Atualizações automáticas de endpoints: os Services do Kubernetes rastreiam os Pods correspondentes e atualizam seus endpoints disponíveis à medida que Pods são adicionados, removidos ou substituídos.
- Comunicação confiável entre serviços: as aplicações podem se conectar por meio de nomes de Service estáveis, em vez de endereçar Pods individuais diretamente.
- Suporte a escalabilidade: quando um workload escala para múltiplos Pods, o Service Discovery disponibiliza as novas instâncias automaticamente e permite distribuir o tráfego entre elas.
- Menos sobrecarga de configuração: os desenvolvedores não precisam atualizar manualmente a configuração da aplicação sempre que a topologia do cluster muda.
- Microsserviços desacoplados: os serviços podem se comunicar usando nomes lógicos, permitindo que cada componente seja implantado, escalado ou reiniciado de forma independente.
Componentes centrais do Service Discovery
Objetos Service
Um Service do Kubernetes é um objeto de API que expõe uma aplicação de rede executada como um ou mais Pods. No caso mais comum, um Service usa um label selector para determinar quais Pods pertencem ao seu conjunto de backend. O Kubernetes então mantém EndpointSlices contendo os endpoints que correspondem a esse selector.
O tipo de Service padrão, ClusterIP, recebe um endereço IP virtual interno ao cluster. Os clientes podem se conectar a esse endereço estável do Service mesmo que os Pods por trás dele sejam substituídos ou escalados. Isso desacopla as aplicações cliente dos endereços IP de Pods em constante mudança que compõem o workload de backend.
Os Services também podem ser headless, definindo .spec.clusterIP como None. Nesse caso, o Kubernetes não aloca um IP de cluster para o Service, e o DNS pode retornar os endereços dos endpoints individuais do Service.
EndpointSlices
Os EndpointSlices representam subconjuntos dos endpoints de rede que dão suporte a um Service do Kubernetes. Para um Service com selector, o control plane do Kubernetes cria automaticamente EndpointSlices contendo referências aos Pods que correspondem a esse selector.
Os EndpointSlices foram projetados para escalar com mais eficiência do que a antiga API Endpoints. Em vez de armazenar todos os endereços de backend em um único objeto grande, o Kubernetes pode dividir os endpoints em vários objetos EndpointSlice. Por padrão, o control plane cria outro EndpointSlice quando os slices existentes atingem o limite padrão de 100 endpoints.
Os EndpointSlices podem conter endereços de endpoint, portas, informações de prontidão, informações de nó e outros metadados usados pelos componentes de rede do cluster. Eles também são a fonte de informações de endpoints de backend usada pelo kube-proxy ao rotear o tráfego interno de Services.
A antiga API Endpoints foi descontinuada em favor dos EndpointSlices, e a documentação atual do Kubernetes recomenda que os clientes usem a API EndpointSlice.
CoreDNS
Os clusters Kubernetes costumam usar o CoreDNS como implementação de DNS do cluster. Um servidor DNS que conhece o cluster observa as informações do Kubernetes e cria registros DNS que permitem aos Pods consultar Services pelo nome. O Kubernetes configura as definições de DNS dos Pods por meio do kubelet, para que as aplicações possam usar a resolução DNS padrão em vez de endereçar Services por IP.
Por exemplo, considere um Service chamado my-service no namespace my-namespace. Um Pod pode endereçá-lo usando um nome DNS como:
my-service.my-namespaceUm nome de Service totalmente qualificado normalmente segue esta estrutura:
my-service.my-namespace.svc.cluster.localO domínio exato do cluster pode ser diferente de cluster.local se o administrador tiver configurado outro domínio. Dentro do mesmo namespace, as aplicações geralmente podem usar apenas o nome curto do Service, como my-service. Pods em outro namespace normalmente precisam incluir o namespace do Service.
kube-proxy
O kube-proxy é a implementação padrão de proxy de Service do Kubernetes. Nos nós em que o kube-proxy é usado, ele observa objetos Service e EndpointSlice e configura o data plane de rede do nó para que o tráfego enviado ao IP virtual e à porta de um Service possa ser redirecionado para um de seus endpoints.
No Linux, as implementações atuais do kube-proxy oferecem suporte aos modos iptables, nftables e ipvs. No Windows, o kube-proxy oferece suporte ao modo kernelspace. O modo IPVS está descontinuado a partir do Kubernetes v1.35, enquanto o nftables está disponível como uma implementação de proxy mais recente para Linux.
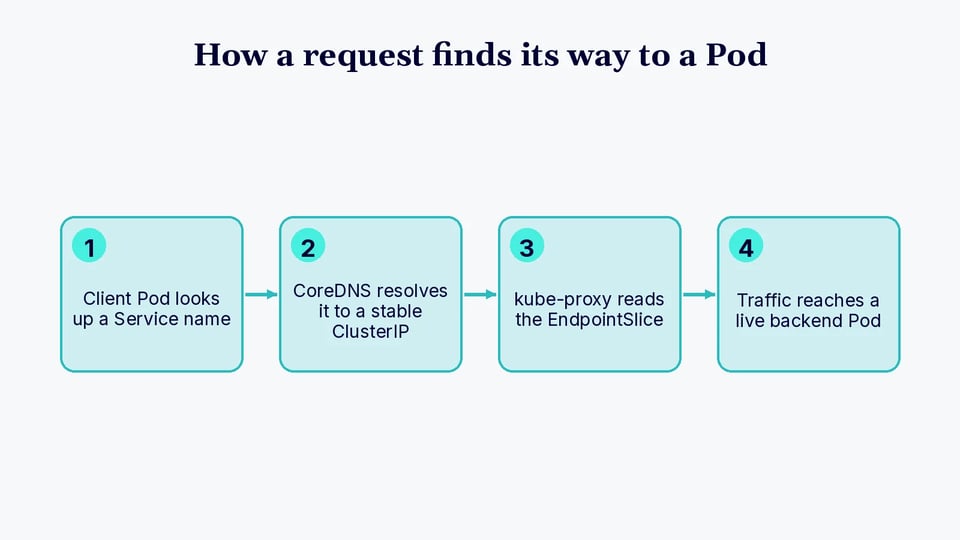
É útil distinguir descoberta de encaminhamento de tráfego: o DNS ajuda a aplicação a descobrir a identidade estável do Service, enquanto o kube-proxy ou uma implementação alternativa de proxy de Service normalmente se encarrega de encaminhar o tráfego do IP virtual do Service para um endpoint de backend adequado. Algumas implementações de rede do Kubernetes substituem o kube-proxy por sua própria implementação de proxy de Service.
Métodos de Service Discovery no Kubernetes {#kubernetes-service-discovery-methods}
Service Discovery baseado em DNS
O DNS é o método padrão e geralmente preferido para descobrir Services a partir de aplicações executadas dentro de um cluster Kubernetes. O Kubernetes atribui nomes DNS aos Services, e um servidor DNS que conhece o cluster, como o CoreDNS, torna esses nomes resolvíveis a partir dos Pods.
Por exemplo, se um Service chamado backend existir no namespace default, um Pod no mesmo namespace normalmente pode se conectar usando:
backendUm Pod em outro namespace pode usar:
backend.defaultou o nome totalmente qualificado:
backend.default.svc.cluster.localPara um Service ClusterIP comum, o nome DNS resolve para o IP de cluster do Service. O Kubernetes também suporta registros DNS para Services headless e registros SRV para portas de Service nomeadas.
Como as aplicações realizam consultas DNS padrão, elas não precisam implementar um protocolo de descoberta específico do Kubernetes.
Service Discovery baseado em variáveis de ambiente
O Kubernetes também pode publicar informações sobre Services ativos como variáveis de ambiente dentro dos Pods. Quando o kubelet inicia um Pod, ele pode adicionar variáveis com base nos Services que já existem. Para um Service chamado my-service, por exemplo, as variáveis geradas incluem formatos como:
MY_SERVICE_SERVICE_HOSTMY_SERVICE_SERVICE_PORTA variável de host contém o IP de cluster do Service, enquanto a variável de porta contém a porta do Service.
Esse mecanismo tem uma limitação importante de ordem: o Service precisa existir antes de o Pod cliente ser criado para que as variáveis de ambiente do Service sejam preenchidas nesse Pod. Criar um Service depois não adiciona retroativamente essas variáveis a um Pod já em execução. A descoberta baseada em DNS não tem esse requisito de ordem.
As variáveis de ambiente de Service também podem ser desabilitadas para um Pod usando o campo enableServiceLinks quando não forem necessárias.
Exemplo de Service Discovery no Kubernetes {#kubernetes-service-discovery-example}
Crie o Deployment de backend
Crie um Deployment com duas réplicas do nginx:
apiVersion: apps/v1kind: Deploymentmetadata: name: internal-webspec: replicas: 2 selector: matchLabels: app: internal-web template: metadata: labels: app: internal-web spec: containers: - name: web-server image: nginx:stable ports: - containerPort: 80Salve o manifesto como nginx-deployment.yaml e aplique-o:
kubectl apply -f nginx-deployment.yamlVerifique se os Pods estão em execução:
kubectl get pods -l app=internal-web -o wideO Deployment mantém o número solicitado de réplicas. Se um desses Pods for removido e substituído, o substituto pode receber um IP de Pod diferente — um dos motivos pelos quais os clientes devem usar um Service em vez de depender diretamente desses endereços.
Crie o Service do Kubernetes
Crie um Service ClusterIP que selecione os Pods com o label app: internal-web:
apiVersion: v1kind: Servicemetadata: name: internal-webspec: selector: app: internal-web ports: - protocol: TCP port: 8080 targetPort: 80Salve este manifesto como nginx-service.yaml e aplique-o:
kubectl apply -f nginx-service.yamlConfira o Service:
kubectl get service internal-webVocê deve ver uma saída semelhante a:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S)internal-web ClusterIP 10.96.100.10 <none> 8080/TCPO IP de cluster específico é atribuído pelo seu cluster e pode variar.
Você também pode inspecionar os EndpointSlices criados para o Service:
kubectl get endpointslices -l kubernetes.io/service-name=internal-webOs endereços dos endpoints devem corresponder aos Pods selecionados pelo Service. Se esses Pods forem substituídos ou o Deployment for escalado, o Kubernetes atualiza os EndpointSlices do Service de acordo.
Descubra o Service a partir de outro Pod
Inicie um Pod temporário com o BusyBox:
kubectl run service-test --image=busybox --restart=Never --command -- sleep 3600Com o Pod em execução, use o nslookup para consultar o nome do Service:
kubectl exec service-test -- nslookup internal-webA resposta do DNS deve resolver internal-web para o ClusterIP do Service.
Você também pode consultar o nome qualificado com o namespace:
kubectl exec service-test -- nslookup internal-web.defaultou o nome totalmente qualificado do Service, quando o cluster usa o domínio de cluster padrão:
kubectl exec service-test -- nslookup internal-web.default.svc.cluster.localIsso demonstra o principal benefício do Kubernetes Service Discovery: o cliente só precisa conhecer o nome estável internal-web. Ele não precisa saber quais Pods nginx existem no momento nem quais endereços IP eles possuem. O DNS do Kubernetes resolve a identidade do Service, os EndpointSlices rastreiam o conjunto atual de backends e a implementação de proxy de Service do cluster encaminha o tráfego do Service para um endpoint adequado.
Depois dos testes, remova o Pod temporário:
kubectl delete pod service-testTipos de Service no Kubernetes e Service Discovery {#kubernetes-service-types-and-service-discovery}
ClusterIP
Um Service ClusterIP expõe uma aplicação em um endereço IP virtual estável, acessível de dentro do cluster. É o tipo de Service padrão e é comumente usado para comunicação entre componentes internos de aplicações.
Os clientes normalmente descobrem um Service ClusterIP pelo seu nome DNS, e não pelo endereço IP atribuído. O DNS resolve o nome do Service para o IP de cluster, enquanto a implementação de proxy de Service do cluster encaminha o tráfego para um dos endpoints atuais do Service. Isso permite substituir ou escalar os Pods de backend sem exigir que os clientes atualizem sua configuração.
NodePort
Um Service NodePort expõe um Service em uma porta de cada nó do cluster, além de fornecer o IP de cluster normal do Service. Clientes com acesso a um nó podem acessar o Service usando o endereço do nó e a porta alocada.
O NodePort muda a forma como o Service pode ser alcançado, mas não substitui os mecanismos internos de descoberta do Kubernetes. Os Pods dentro do cluster ainda podem descobrir o Service pelo seu nome DNS e IP de cluster. O NodePort é frequentemente usado como base para acesso externo ou quando os clientes precisam se conectar diretamente pelos endereços dos nós.
LoadBalancer
Um Service LoadBalancer solicita um load balancer externo a um provedor de nuvem compatível ou a outra implementação de load balancer. O load balancer externo recebe o tráfego de fora do cluster e o direciona para o Service do Kubernetes.
Internamente, o Service continua podendo ser descoberto pelo DNS do Kubernetes, como qualquer outro Service. A principal diferença é que clientes externos podem usar o endereço ou hostname atribuído ao load balancer. O provisionamento exato e o caminho do tráfego dependem da infraestrutura do cluster e da implementação do load balancer.
ExternalName
Um Service ExternalName mapeia o nome de um Service do Kubernetes para um nome DNS externo. Em vez de selecionar Pods ou manter EndpointSlices de backend, ele retorna um registro DNS CNAME apontando para o valor configurado no campo externalName do Service.
Por exemplo, uma aplicação pode acessar um nome como database.default.svc.cluster.local, enquanto o DNS do Kubernetes redireciona a resolução para um hostname externo como database.example.com. Isso fornece um nome local do Kubernetes para uma dependência externa, embora as aplicações precisem considerar protocolos como TLS e HTTP, que podem depender do hostname usado pelo cliente.
Boas práticas de Service Discovery no Kubernetes {#kubernetes-service-discovery-best-practices}
Aqui estão algumas práticas úteis para ter em mente ao usar o service discovery do Kubernetes.
1. Use o DNS do Kubernetes em vez de IPs de Pods fixos no código
Use nomes DNS de Service como forma padrão de as aplicações localizarem outros workloads. Os endereços IP dos Pods são temporários e podem mudar quando os Pods reiniciam, são substituídos ou migram para outro nó. Fixar esses endereços no código torna as aplicações dependentes de detalhes de infraestrutura que o Kubernetes foi projetado para gerenciar dinamicamente.
Configure os clientes com nomes como backend ou backend.production em vez de armazenar endereços de Pods. Isso mantém a configuração da aplicação independente do posicionamento dos workloads e permite que o Kubernetes atualize os endpoints subjacentes sem exigir mudanças nos clientes.
Prefira nomes qualificados com namespace quando as aplicações se comunicam entre namespaces. Nomes DNS totalmente qualificados também podem evitar ambiguidade em ambientes com Services de nomes parecidos. As aplicações devem adotar um comportamento sensato de cache de DNS para que os registros sejam atualizados quando necessário.
2. Faça o right-sizing dos workloads sem comprometer a disponibilidade do Service
Execute réplicas suficientes para manter a disponibilidade do serviço durante falhas de Pods, deployments, eventos de escalonamento e manutenções de rotina. Para serviços importantes, depender de um único Pod cria um ponto em que o Service pode ficar temporariamente sem endpoints utilizáveis.
Defina resource requests e limits adequados para que os Pods possam ser agendados de forma confiável, sem consumir capacidade do cluster desnecessariamente. Requests muito altos podem dificultar o agendamento dos Pods, enquanto requests muito baixos podem contribuir para disputa de recursos e desempenho instável.
Use readiness probes para impedir que o Kubernetes envie tráfego do Service a Pods antes que eles estejam prontos para atender requisições. Para workloads que exigem disponibilidade mínima durante interrupções voluntárias, considere PodDisruptionBudgets e distribua as réplicas entre nós ou domínios de falha, quando apropriado.
3. Mantenha os Selectors dos Services e os Labels dos Pods consistentes
Um Service baseado em selector só roteia tráfego para Pods cujos labels correspondem ao seu selector. Labels incorretos ou inconsistentes podem, portanto, deixar um Service sem endpoints mesmo com os Pods da aplicação em execução.
Use um esquema de rotulagem previsível e gerencie os selectors dos Services e os labels dos workloads em conjunto. Evite alterar labels usados por Services ativos sem considerar como a mudança afetará a composição dos endpoints durante um deployment.
Comandos como kubectl get pods --show-labels e kubectl get endpointslices -l kubernetes.io/service-name=<service-name> ajudam a confirmar se os Pods esperados estão registrados como endpoints. Se um Service existe mas não tem endpoints, verificar selectors, labels e a prontidão dos Pods é um bom primeiro passo de troubleshooting.
4. Monitore a saúde dos EndpointSlices
Monitore os EndpointSlices para verificar se os Services têm o número esperado de endpoints de backend utilizáveis. Um conjunto de endpoints vazio ou inesperadamente pequeno pode indicar divergências de selector, falhas em readiness checks, Pods indisponíveis ou problemas de deployment.
Inclua a disponibilidade de Services e endpoints no monitoramento e nos alertas do cluster. Mudanças na contagem de endpoints podem ser especialmente úteis para identificar falhas durante deployments ou eventos de autoscaling antes que se transformem em problemas de disponibilidade mais amplos.
Durante o troubleshooting, inspecione os EndpointSlices em conjunto com o status dos Pods, as condições de prontidão e a configuração do Service. Isso ajuda a distinguir um problema de descoberta de uma falha de aplicação, DNS ou rede. O monitoramento deve focar não apenas na existência do Service, mas também em se ele tem endpoints saudáveis capazes de receber tráfego.
Conteúdo relacionado: leia nosso artigo sobre monitoramento do Kubernetes para uma visão mais ampla de métricas e alertas do cluster.
5. Coordene o Service Discovery com o autoscaling
O autoscaling muda o número de Pods por trás de um Service, então a descoberta e o roteamento de tráfego precisam responder corretamente à medida que réplicas são adicionadas e removidas. O Kubernetes atualiza os EndpointSlices conforme Pods elegíveis entram ou saem do conjunto de backend, permitindo que os clientes continuem usando o mesmo nome de Service durante os eventos de escalonamento.
Configure readiness probes com cuidado para que Pods recém-criados recebam tráfego somente quando puderem atender requisições. Durante o scale-down, as configurações de graceful termination podem dar tempo para que requisições e conexões existentes sejam concluídas enquanto os endpoints são removidos do uso ativo.
As aplicações também devem adotar comportamentos razoáveis de cache de DNS, timeouts de conexão, retries e pool de conexões. Clientes que mantêm conexões abertas indefinidamente podem continuar se comunicando com um conjunto limitado de backends e deixar de aproveitar as réplicas recém-adicionadas. O comportamento do cliente deve, portanto, complementar o autoscaling e o gerenciamento de endpoints do Kubernetes, e não trabalhar contra eles.
Mantendo os endpoints dos Services saudáveis com PerfectScale
O service discovery só é tão eficiente quanto os Pods por trás dele. Quando os workloads estão subprovisionados, mal configurados ou escalados de forma ineficiente, os Services acabam com poucos endpoints saudáveis, e o roteamento de tráfego sofre mesmo com a resolução DNS funcionando corretamente. O PerfectScale é uma plataforma de otimização de Kubernetes que você implanta via Helm uma única vez e passa a usar para obter insights acionáveis e otimização autônoma em toda a sua stack K8s, mantendo os workloads econômicos e resilientes o suficiente para continuar atendendo o tráfego.
Principais recursos do PerfectScale:
- Right-sizing autônomo de workloads: o Podfit oferece uma visão granular da saúde e dos custos do cluster, priorizando as áreas que precisam de atenção enquanto otimiza workloads de forma autônoma e revela recursos desperdiçados e problemas de resiliência.
- Recomendações de escalonamento baseadas em dados: o PerfectScale entrega recomendações acionáveis para melhorar as configurações de HPA e KEDA, e se integra a soluções de autoscaling como HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot.
- Otimização no nível dos nós: o Infrafit oferece visibilidade abrangente da utilização dos nós, ajudando você a identificar e eliminar capacidade ociosa e a escolher os nós certos para seus workloads com recomendações baseadas em dados.
- Alertas em tempo real com priorização automática: a priorização orientada por impacto ajuda a resolver riscos de resiliência e a identificar picos de custo e anomalias antes que cheguem aos usuários, com alertas enviados para Slack, Datadog, MS Teams ou PagerDuty.
- Relatórios de tendências para governança e previsão: visibilidade granular de métricas de custo, desperdício e risco ao longo do tempo, por clusters, grupos de nós, namespaces e workloads, com análise de causa raiz para evitar problemas recorrentes.
- Amplo suporte a ambientes: o PerfectScale funciona tanto em ambientes on-premise quanto na nuvem, integrando-se a nuvens privadas como OpenShift e públicas como EKS, GKE e AKS, além de oferecer suporte a contêineres baseados em Windows.
Saiba mais sobre como a plataforma PerfectScale mantém seus workloads Kubernetes bem dimensionados, resilientes e prontos para atender o tráfego.
FAQ
Qual é a diferença entre um Service do Kubernetes e um EndpointSlice? Um Service é a porta de entrada lógica e estável: um nome e um IP virtual aos quais os clientes se conectam. Um EndpointSlice é a lista por trás dessa porta: o conjunto real de IPs de Pods que correspondem ao selector do Service naquele momento, mantido atualizado automaticamente conforme os Pods vêm e vão.
O Kubernetes prefere service discovery baseado em DNS ou em variáveis de ambiente? O DNS é o método padrão e geralmente preferido. A descoberta por variáveis de ambiente tem uma limitação de ordem: o Service precisa existir antes de o Pod cliente ser criado, caso contrário o Pod nunca recebe as variáveis. As consultas DNS não têm essa restrição.
Por que um Service pode mostrar zero endpoints mesmo com os Pods em execução?
Quase sempre é uma divergência de labels entre o selector do Service e os labels do Pod, embora falhas em readiness checks também possam causar isso. Verificar kubectl get endpointslices em conjunto com kubectl get pods --show-labels é a forma mais rápida de confirmar qual é a causa.
Qual é a diferença entre ClusterIP, NodePort e LoadBalancer? O ClusterIP é apenas interno e é o padrão. O NodePort adiciona uma porta estática em cada nó para que o Service possa ser acessado de fora do cluster. O LoadBalancer provisiona um load balancer externo na nuvem na frente do Service. Os três continuam podendo ser descobertos dentro do cluster pelo mesmo nome DNS.
O autoscaling quebra o service discovery? Não, mas exige que os clientes cooperem com ele. O Kubernetes atualiza os EndpointSlices automaticamente conforme as réplicas aumentam ou diminuem, mas clientes que mantêm conexões abertas indefinidamente podem continuar falando com um conjunto desatualizado e menor de backends, em vez de aproveitar as réplicas recém-adicionadas.