


Che cos'è la Service Discovery di Kubernetes?
La Service Discovery di Kubernetes è il meccanismo integrato che consente ai microservizi containerizzati di individuarsi e comunicare tra loro in modo dinamico, senza dover inserire nel codice indirizzi IP volatili. Poiché i Pod di Kubernetes sono effimeri (vengono cioè distrutti e ricreati di frequente, ricevendo ogni volta nuovi IP), Kubernetes li astrae dietro un'entità di routing logica e permanente nota come Service.
Componenti principali della service discovery: Kubernetes combina diversi livelli architetturali di sistema per tracciare i backend e instradare il traffico di rete in modo pulito:
- Oggetti Service: un livello di astrazione personalizzato che definisce un insieme logico di Pod e una policy per accedervi. I Service individuano i Pod di destinazione tramite Label e Selector definiti dall'utente.
- EndpointSlices: oggetti gestiti automaticamente dal control plane che tracciano in tempo reale gli indirizzi IP e lo stato di readiness di tutti i singoli Pod a cui un Service punta.
- CoreDNS: l'infrastruttura DNS interna del cluster. Funge da registro centrale, mappando i nomi leggibili dei Service direttamente sui rispettivi indirizzi IP interni di destinazione.
- Kube-proxy: un agente di rete in esecuzione su ogni nodo worker. Aggiorna dinamicamente le regole di rete del sistema (come IPVS o
iptables) per intercettare e bilanciare le richieste dei client dirette all'IP di un Service.
Tipi di Service per esigenze di routing diverse:
A seconda dell'origine delle richieste dei client e di come queste devono individuare le destinazioni, gli sviluppatori configurano il parametro spec.type di un Service:
| Tipo di Service | Comportamento di risoluzione | Caso d'uso tipico |
|---|---|---|
| ClusterIP | Alloca un indirizzo IP virtuale stabile, accessibile solo all'interno del cluster. | Comunicazione privata tra Pod per microservizi interni. |
| NodePort | Apre una porta statica sull'interfaccia esterna di ogni nodo worker. | Esposizione di servizi interni a router hardware esterni. |
| LoadBalancer | Effettua automaticamente il provisioning di un load balancer cloud esterno. | Accesso pubblico diretto per il traffico internet di produzione. |
| ExternalName | Restituisce un record CNAME standard che punta a un dominio esterno. |
Mappatura di hook interni nel codice verso API di terze parti. |
Questo articolo fa parte di una serie dedicata allo scheduling di Kubernetes
In questo articolo:
- Perché Kubernetes ha bisogno della Service Discovery?
- I componenti principali della Service Discovery
- I metodi di Service Discovery in Kubernetes
- Un esempio di Service Discovery in Kubernetes
- Tipi di Service in Kubernetes e Service Discovery
- Best practice per la Service Discovery in Kubernetes
Perché Kubernetes ha bisogno della Service Discovery? {#why-does-kubernetes-need-service-discovery}
I workloads di Kubernetes sono estremamente dinamici. I Pod possono riavviarsi, scalare, spostarsi tra i nodi o essere sostituiti, il che significa che i loro indirizzi IP possono cambiare di frequente. La Service Discovery offre alle applicazioni modalità stabili per individuare questi workloads senza dover tracciare gli indirizzi dei singoli Pod:
- Indirizzi IP dei Pod dinamici: i Pod ricevono in genere un nuovo indirizzo IP quando vengono ricreati. La Service Discovery elimina la necessità per le applicazioni di mantenere elenchi di IP in continuo cambiamento.
- Aggiornamento automatico degli endpoint: i Service di Kubernetes tengono traccia dei Pod corrispondenti e aggiornano gli endpoint disponibili man mano che i Pod vengono aggiunti, rimossi o sostituiti.
- Comunicazione affidabile tra servizi: le applicazioni possono connettersi tramite nomi di Service stabili anziché indirizzare direttamente i singoli Pod.
- Supporto alla scalabilità: quando un workload scala su più Pod, la Service Discovery rende automaticamente disponibili le nuove istanze e consente di distribuire il traffico tra di esse.
- Minore overhead di configurazione: gli sviluppatori non devono aggiornare manualmente la configurazione delle applicazioni ogni volta che cambia la topologia del cluster.
- Microservizi disaccoppiati: i servizi possono comunicare tramite nomi logici, consentendo di distribuire, scalare o riavviare ogni componente in modo indipendente.
I componenti principali della Service Discovery
Oggetti Service
Un Service di Kubernetes è un oggetto API che espone un'applicazione di rete in esecuzione su uno o più Pod. Nel caso più comune, un Service utilizza un selettore di label per determinare quali Pod appartengono al proprio insieme di backend. Kubernetes mantiene quindi degli EndpointSlices contenenti gli endpoint che corrispondono a quel selettore.
Il tipo di Service predefinito, ClusterIP, riceve un indirizzo IP virtuale interno al cluster. I client possono connettersi a quell'indirizzo stabile del Service anche se i Pod retrostanti vengono sostituiti o scalati. Questo disaccoppia le applicazioni client dagli indirizzi IP mutevoli dei Pod che compongono il workload di backend.
I Service possono anche essere headless impostando .spec.clusterIP su None. In questo caso, Kubernetes non alloca un cluster IP per il Service e il DNS può invece restituire gli indirizzi dei singoli endpoint del Service.
EndpointSlices
Gli EndpointSlices rappresentano sottoinsiemi degli endpoint di rete che fanno da backend a un Service di Kubernetes. Per un Service con selettore, il control plane di Kubernetes crea automaticamente degli EndpointSlices contenenti i riferimenti ai Pod che corrispondono a quel selettore.
Gli EndpointSlices sono stati progettati per scalare in modo più efficiente rispetto alla precedente API Endpoints. Invece di archiviare ogni indirizzo di backend in un unico grande oggetto, Kubernetes può suddividere gli endpoint su più oggetti EndpointSlice. Per impostazione predefinita, il control plane crea un nuovo EndpointSlice quando gli slice esistenti hanno raggiunto il target predefinito di 100 endpoint.
Gli EndpointSlices possono contenere indirizzi degli endpoint, porte, informazioni di readiness, informazioni sui nodi e altri metadati utilizzati dai componenti di rete del cluster. Sono inoltre la fonte delle informazioni sugli endpoint di backend usata da kube-proxy per instradare il traffico interno dei Service.
La precedente API Endpoints è stata deprecata a favore degli EndpointSlices e la documentazione attuale di Kubernetes raccomanda ai client di utilizzare l'API EndpointSlice.
CoreDNS
I cluster Kubernetes utilizzano comunemente CoreDNS come implementazione DNS del cluster. Un server DNS cluster-aware monitora le informazioni di Kubernetes e crea record DNS che consentono ai Pod di risolvere i Service per nome. Kubernetes configura le impostazioni DNS dei Pod tramite il kubelet, in modo che le applicazioni possano usare la normale risoluzione DNS invece di indirizzare i Service tramite IP.
Si consideri ad esempio un Service chiamato my-service nel namespace my-namespace. Un Pod può indirizzarlo usando un nome DNS come:
my-service.my-namespaceUn nome di Service completamente qualificato segue normalmente questa struttura:
my-service.my-namespace.svc.cluster.localIl dominio esatto del cluster può differire da cluster.local se l'amministratore del cluster ha configurato un dominio diverso. All'interno dello stesso namespace, le applicazioni possono in genere usare il solo nome breve del Service, come my-service. I Pod in un altro namespace devono normalmente includere il namespace del Service.
kube-proxy
kube-proxy è l'implementazione predefinita del proxying dei Service in Kubernetes. Sui nodi in cui kube-proxy è in uso, osserva gli oggetti Service ed EndpointSlice e configura il data plane di rete del nodo in modo che il traffico inviato all'IP virtuale e alla porta di un Service possa essere reindirizzato verso uno dei suoi endpoint.
Su Linux, le implementazioni attuali di kube-proxy supportano le modalità iptables, nftables e ipvs. Su Windows, kube-proxy supporta la modalità kernelspace. La modalità IPVS è deprecata a partire da Kubernetes v1.35, mentre nftables è disponibile come implementazione proxy Linux più recente.
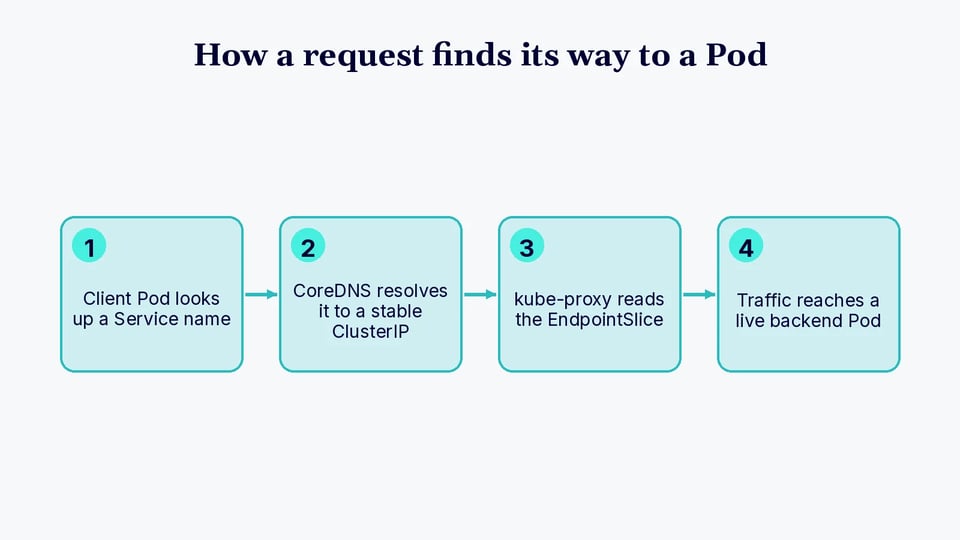
È utile distinguere la discovery dall'inoltro del traffico: il DNS aiuta un'applicazione a individuare l'identità stabile del Service, mentre kube-proxy, o un'implementazione alternativa del proxy dei Service, si occupa tipicamente di inoltrare il traffico dall'IP virtuale del Service verso un endpoint di backend appropriato. Alcune implementazioni di rete per Kubernetes sostituiscono kube-proxy con una propria implementazione del proxy dei Service.
I metodi di Service Discovery in Kubernetes {#kubernetes-service-discovery-methods}
Service Discovery basata su DNS
Il DNS è il metodo standard, e in genere preferito, con cui le applicazioni in esecuzione all'interno di un cluster Kubernetes individuano i Service. Kubernetes assegna nomi DNS ai Service e un server DNS cluster-aware, come CoreDNS, rende quei nomi risolvibili dai Pod.
Ad esempio, se nel namespace default esiste un Service chiamato backend, un Pod nello stesso namespace può normalmente connettersi usando:
backendUn Pod in un altro namespace può usare:
backend.defaultoppure il nome completamente qualificato:
backend.default.svc.cluster.localPer un normale Service di tipo ClusterIP, il nome DNS si risolve nel cluster IP del Service. Kubernetes supporta anche record DNS per i Service headless e record SRV per le porte denominate dei Service.
Poiché le applicazioni eseguono normali lookup DNS, non devono implementare un protocollo di discovery specifico di Kubernetes.
Service Discovery basata su variabili d'ambiente
Kubernetes può anche pubblicare informazioni sui Service attivi come variabili d'ambiente all'interno dei Pod. Quando il kubelet avvia un Pod, può aggiungere variabili basate sui Service già esistenti. Per un Service chiamato my-service, ad esempio, le variabili generate includono forme come:
MY_SERVICE_SERVICE_HOSTMY_SERVICE_SERVICE_PORTLa variabile host contiene il cluster IP del Service, mentre la variabile port contiene la relativa porta del Service.
Questo meccanismo presenta un'importante limitazione legata all'ordine di creazione: il Service deve esistere prima della creazione del Pod client affinché le sue variabili d'ambiente vengano popolate in quel Pod. Creare un Service in un secondo momento non aggiunge retroattivamente quelle variabili a un Pod già in esecuzione. La discovery basata su DNS non è soggetta a questo vincolo.
Le variabili d'ambiente dei Service possono anche essere disabilitate per un Pod tramite il campo enableServiceLinks, quando non sono necessarie.
Un esempio di Service Discovery in Kubernetes {#kubernetes-service-discovery-example}
Creare il Deployment di backend
Creare un Deployment con due repliche nginx:
apiVersion: apps/v1kind: Deploymentmetadata: name: internal-webspec: replicas: 2 selector: matchLabels: app: internal-web template: metadata: labels: app: internal-web spec: containers: - name: web-server image: nginx:stable ports: - containerPort: 80Salvare il manifest come nginx-deployment.yaml, quindi applicarlo:
kubectl apply -f nginx-deployment.yamlVerificare che i Pod siano in esecuzione:
kubectl get pods -l app=internal-web -o wideIl Deployment mantiene il numero di repliche richiesto. Se uno di questi Pod viene rimosso e sostituito, il sostituto può ricevere un IP di Pod diverso: ecco uno dei motivi per cui i client dovrebbero usare un Service invece di affidarsi direttamente a questi indirizzi.
Creare il Service Kubernetes
Creare un Service di tipo ClusterIP che seleziona i Pod con la label app: internal-web:
apiVersion: v1kind: Servicemetadata: name: internal-webspec: selector: app: internal-web ports: - protocol: TCP port: 8080 targetPort: 80Salvare questo manifest come nginx-service.yaml e applicarlo:
kubectl apply -f nginx-service.yamlControllare il Service:
kubectl get service internal-webSi dovrebbe ottenere un output simile a:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S)internal-web ClusterIP 10.96.100.10 <none> 8080/TCPIl cluster IP specifico viene assegnato dal cluster e può variare.
È anche possibile esaminare gli EndpointSlices creati per il Service:
kubectl get endpointslices -l kubernetes.io/service-name=internal-webGli indirizzi degli endpoint dovrebbero corrispondere ai Pod selezionati dal Service. Se quei Pod vengono sostituiti o il Deployment viene scalato, Kubernetes aggiorna di conseguenza gli EndpointSlices del Service.
Individuare il Service da un altro Pod
Avviare un Pod temporaneo contenente BusyBox:
kubectl run service-test --image=busybox --restart=Never --command -- sleep 3600Una volta che il Pod è in esecuzione, usare nslookup per interrogare il nome del Service:
kubectl exec service-test -- nslookup internal-webLa risposta DNS dovrebbe risolvere internal-web nel ClusterIP del Service.
È anche possibile interrogare il nome qualificato con il namespace:
kubectl exec service-test -- nslookup internal-web.defaultoppure il nome di Service completamente qualificato, se il cluster usa il dominio di cluster predefinito:
kubectl exec service-test -- nslookup internal-web.default.svc.cluster.localQuesto dimostra il vantaggio chiave della Service Discovery di Kubernetes: il client deve conoscere soltanto il nome stabile internal-web. Non ha bisogno di sapere quali Pod nginx esistano in quel momento né quali indirizzi IP abbiano. Il DNS di Kubernetes risolve l'identità del Service, gli EndpointSlices tracciano l'insieme di backend corrente e l'implementazione del proxy dei Service del cluster inoltra il traffico del Service verso un endpoint appropriato.
Al termine dei test, rimuovere il Pod temporaneo:
kubectl delete pod service-testTipi di Service in Kubernetes e Service Discovery {#kubernetes-service-types-and-service-discovery}
ClusterIP
Un Service ClusterIP espone un'applicazione su un indirizzo IP virtuale stabile raggiungibile dall'interno del cluster. È il tipo di Service predefinito ed è comunemente usato per la comunicazione tra componenti interni delle applicazioni.
I client individuano normalmente un Service ClusterIP tramite il suo nome DNS anziché tramite l'indirizzo IP assegnato. Il DNS risolve il nome del Service nel cluster IP, mentre l'implementazione del proxy dei Service del cluster inoltra il traffico verso uno degli endpoint correnti del Service. Questo consente di sostituire o scalare i Pod di backend senza richiedere ai client di aggiornare la propria configurazione.
NodePort
Un Service NodePort espone un Service su una porta di ogni nodo del cluster, oltre a fornire il normale cluster IP del Service. I client in grado di raggiungere un nodo possono accedere al Service usando l'indirizzo del nodo e la porta allocata.
NodePort cambia il modo in cui il Service può essere raggiunto, ma non sostituisce i meccanismi di discovery interni di Kubernetes. I Pod all'interno del cluster possono comunque individuare il Service tramite il suo nome DNS e il cluster IP. NodePort viene spesso usato come elemento di base per l'accesso esterno o quando i client devono connettersi direttamente tramite gli indirizzi dei nodi.
LoadBalancer
Un Service LoadBalancer richiede un load balancer esterno a un cloud provider supportato o a un'altra implementazione di load balancer. Il load balancer esterno riceve il traffico proveniente dall'esterno del cluster e lo dirige verso il Service Kubernetes.
Internamente, il Service rimane individuabile tramite il DNS di Kubernetes come gli altri Service. La differenza principale è che i client esterni possono usare l'indirizzo o l'hostname assegnato al load balancer. Il provisioning esatto e il percorso del traffico dipendono dall'infrastruttura del cluster e dall'implementazione del load balancer.
ExternalName
Un Service ExternalName mappa il nome di un Service Kubernetes su un nome DNS esterno. Invece di selezionare Pod o mantenere EndpointSlices di backend, restituisce un record DNS CNAME che punta al valore configurato nel campo externalName del Service.
Ad esempio, un'applicazione può accedere a un nome come database.default.svc.cluster.local, mentre il DNS di Kubernetes reindirizza la risoluzione verso un hostname esterno come database.example.com. Questo fornisce un nome locale a Kubernetes per una dipendenza esterna, anche se le applicazioni devono tenere conto di protocolli come TLS e HTTP che possono dipendere dall'hostname usato dal client.
Best practice per la Service Discovery in Kubernetes {#kubernetes-service-discovery-best-practices}
Ecco alcune pratiche utili da tenere a mente quando si utilizza la Service Discovery di Kubernetes.
1. Usare il DNS di Kubernetes invece di IP dei Pod hardcoded
Utilizzare i nomi DNS dei Service come modalità predefinita con cui le applicazioni individuano gli altri workloads. Gli indirizzi IP dei Pod sono temporanei e possono cambiare quando i Pod si riavviano, vengono sostituiti o si spostano su un altro nodo. Scrivere questi indirizzi direttamente nel codice rende le applicazioni dipendenti da dettagli infrastrutturali che Kubernetes è progettato per gestire in modo dinamico.
Configurare i client con nomi come backend o backend.production invece di memorizzare gli indirizzi dei Pod. In questo modo la configurazione delle applicazioni rimane indipendente dal posizionamento dei workloads e Kubernetes può aggiornare gli endpoint sottostanti senza richiedere modifiche lato client.
Preferire nomi qualificati con il namespace quando le applicazioni comunicano tra namespace diversi. I nomi DNS completamente qualificati possono inoltre evitare ambiguità in ambienti con Service dai nomi simili. Le applicazioni dovrebbero adottare un comportamento di caching DNS ragionevole, in modo che i record vengano aggiornati quando necessario.
2. Applicare il right-sizing ai workloads senza compromettere la disponibilità dei Service
Eseguire un numero sufficiente di repliche per mantenere la disponibilità del servizio durante guasti dei Pod, deployment, eventi di scaling e manutenzione ordinaria. Per i servizi importanti, affidarsi a un singolo Pod crea un punto in cui il Service può temporaneamente rimanere senza endpoint utilizzabili.
Impostare richieste di risorse appropriate e limiti adeguati, in modo che i Pod possano essere schedulati in modo affidabile senza consumare inutilmente capacità del cluster. Richieste troppo elevate possono rendere difficile lo scheduling dei Pod, mentre richieste troppo basse possono contribuire a contese sulle risorse e a prestazioni instabili.
Utilizzare le readiness probe per evitare che Kubernetes invii traffico del Service ai Pod prima che siano pronti a gestire le richieste. Per i workloads che richiedono una disponibilità minima durante le interruzioni volontarie, valutare i PodDisruptionBudget e distribuire le repliche tra nodi o domini di guasto, dove opportuno.
3. Mantenere coerenti i selettori dei Service e le label dei Pod
Un Service basato su selettore instrada il traffico solo verso i Pod le cui label corrispondono al suo selettore. Label errate o incoerenti possono quindi lasciare un Service senza endpoint anche quando i Pod dell'applicazione sono in esecuzione.
Adottare uno schema di labeling prevedibile e gestire insieme i selettori dei Service e le label dei workloads. Evitare di modificare le label usate da Service attivi senza considerare come la modifica influirà sull'appartenenza agli endpoint durante un deployment.
Comandi come kubectl get pods --show-labels e kubectl get endpointslices -l kubernetes.io/service-name=<service-name> possono aiutare a confermare che i Pod attesi siano registrati come endpoint. Se un Service esiste ma non ha endpoint, controllare selettori, label e readiness dei Pod è un utile primo passo di troubleshooting.
4. Monitorare lo stato degli EndpointSlices
Monitorare gli EndpointSlices per verificare che i Service abbiano il numero previsto di endpoint di backend utilizzabili. Un insieme di endpoint vuoto o inaspettatamente ridotto può indicare selettori non corrispondenti, readiness check falliti, Pod non disponibili o problemi di deployment.
Includere la disponibilità di Service ed endpoint nel monitoraggio e negli alert del cluster. Le variazioni nel numero di endpoint possono essere particolarmente utili per individuare guasti durante deployment o eventi di autoscaling, prima che si trasformino in problemi di disponibilità più ampi.
Durante il troubleshooting, esaminare gli EndpointSlices insieme allo stato dei Pod, alle condizioni di readiness e alla configurazione dei Service. Questo aiuta a distinguere un problema di discovery da un guasto applicativo, DNS o di rete. Il monitoraggio dovrebbe concentrarsi non solo sull'esistenza di un Service, ma anche sulla presenza di endpoint integri in grado di ricevere traffico.
Contenuti correlati: legga il nostro articolo sul monitoraggio di Kubernetes per una visione più ampia di metriche e alerting del cluster.
5. Coordinare la Service Discovery con l'autoscaling
L'autoscaling modifica il numero di Pod dietro un Service, quindi la discovery e il routing del traffico devono reagire correttamente quando le repliche vengono aggiunte e rimosse. Kubernetes aggiorna gli EndpointSlices man mano che i Pod idonei entrano o escono dall'insieme di backend, consentendo ai client di continuare a usare lo stesso nome di Service durante gli eventi di scaling.
Configurare con attenzione le readiness probe in modo che i Pod appena creati ricevano traffico solo quando sono in grado di servire le richieste. Durante lo scale-down, le impostazioni di terminazione graduale possono dare alle richieste e alle connessioni esistenti il tempo di completarsi mentre gli endpoint vengono rimossi dall'uso attivo.
Le applicazioni dovrebbero inoltre adottare un caching DNS ragionevole, timeout di connessione, retry e un comportamento adeguato dei connection pool. I client che mantengono connessioni aperte indefinitamente possono continuare a comunicare con un insieme limitato di backend, senza sfruttare le repliche appena aggiunte. Il comportamento dei client dovrebbe quindi essere complementare all'autoscaling e alla gestione degli endpoint di Kubernetes, anziché contrastarli.
Mantenere in salute gli endpoint dei Service con PerfectScale
La service discovery funziona bene solo se funzionano bene i Pod che vi stanno dietro. Quando i workloads sono sottodimensionati, mal configurati o scalati in modo inefficiente, i Service si ritrovano con troppo pochi endpoint integri e il routing del traffico ne risente, anche se la risoluzione DNS funziona correttamente. PerfectScale è una piattaforma di ottimizzazione per Kubernetes che si installa una sola volta tramite Helm e che fornisce poi insight concreti e ottimizzazione autonoma sull'intero stack K8s, in modo che i workloads restino efficienti in termini di costi e abbastanza resilienti da continuare a servire traffico.
Funzionalità chiave di PerfectScale:
- Right-sizing autonomo dei workloads: Podfit offre una visione granulare dello stato di salute e dei costi del cluster, dando priorità alle aree che richiedono attenzione, ottimizzando autonomamente i workloads e facendo emergere risorse sprecate e problemi di resilienza.
- Raccomandazioni di scaling basate sui dati: PerfectScale fornisce raccomandazioni concrete per migliorare le configurazioni di HPA e KEDA e si integra con soluzioni di autoscaling tra cui HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot.
- Ottimizzazione a livello di nodo: Infrafit offre una visibilità completa sull'utilizzo dei nodi, aiutando a identificare ed eliminare la capacità inattiva dei nodi e a selezionare i nodi giusti per i propri workloads grazie a raccomandazioni basate sui dati.
- Alert in tempo reale con prioritizzazione automatica: la prioritizzazione basata sull'impatto aiuta a risolvere i rischi di resilienza e a identificare picchi di costo e anomalie prima che raggiungano gli utenti, con alert recapitati in Slack, Datadog, MS Teams o PagerDuty.
- Report sui trend per governance e previsioni: visibilità granulare nel tempo su metriche di costo, spreco e rischio tra cluster, gruppi di nodi, namespace e workloads, con analisi delle cause alla radice per prevenire il ripetersi dei problemi.
- Ampio supporto degli ambienti: PerfectScale funziona sia in ambienti on-premise sia in ambienti cloud, integrandosi con cloud privati come OpenShift e cloud pubblici come EKS, GKE e AKS, e supporta anche i container basati su Windows.
Scopra come la piattaforma PerfectScale mantiene i workloads Kubernetes correttamente dimensionati, resilienti e pronti a servire traffico.
FAQ
Qual è la differenza tra un Service Kubernetes e un EndpointSlice? Un Service è la porta d'ingresso logica e stabile: un nome e un IP virtuale a cui i client si connettono. Un EndpointSlice è l'elenco dietro quella porta: l'insieme effettivo degli IP dei Pod che corrispondono in quel momento al selettore del Service, mantenuto aggiornato automaticamente man mano che i Pod vanno e vengono.
Kubernetes privilegia la service discovery basata su DNS o quella basata su variabili d'ambiente? Il DNS è il metodo standard e in genere preferito. La discovery basata su variabili d'ambiente ha una limitazione legata all'ordine di creazione: il Service deve già esistere prima della creazione del Pod client, altrimenti quel Pod non riceve mai le variabili. I lookup DNS non hanno questa restrizione.
Perché un Service può mostrare zero endpoint anche se i suoi Pod sono in esecuzione?
Si tratta quasi sempre di una mancata corrispondenza tra il selettore del Service e le label dei Pod, sebbene anche i readiness check falliti possano esserne la causa. Controllare kubectl get endpointslices insieme a kubectl get pods --show-labels è il modo più rapido per confermare quale delle due sia la causa.
Qual è la differenza tra ClusterIP, NodePort e LoadBalancer? ClusterIP è solo interno ed è il tipo predefinito. NodePort aggiunge una porta statica su ogni nodo, così il Service può essere raggiunto dall'esterno del cluster. LoadBalancer effettua il provisioning di un load balancer cloud esterno davanti al Service. Tutti e tre restano individuabili all'interno del cluster tramite lo stesso nome DNS.
L'autoscaling compromette la service discovery? No, ma richiede la collaborazione dei client. Kubernetes aggiorna automaticamente gli EndpointSlices quando le repliche aumentano o diminuiscono, ma i client che mantengono le connessioni aperte indefinitamente possono continuare a dialogare con un insieme di backend obsoleto e più ridotto, senza intercettare le repliche appena aggiunte.