


Qu'est-ce que le Service Discovery Kubernetes ?
Le Service Discovery Kubernetes est le mécanisme intégré qui permet aux microservices conteneurisés de se trouver et de communiquer entre eux de façon dynamique, sans coder en dur des adresses IP volatiles. Les Pods Kubernetes étant éphémères (ils sont fréquemment détruits, recréés et se voient attribuer de nouvelles IP), Kubernetes les abstrait derrière une entité de routage logique et permanente appelée Service.
Les composants clés du service discovery : Kubernetes combine plusieurs couches architecturales pour suivre les backends et router proprement le trafic réseau :
- Objets Service : Une couche d'abstraction qui définit un ensemble logique de Pods et une politique d'accès. Les Services identifient les Pods cibles à l'aide de labels et sélecteurs personnalisés.
- EndpointSlices : Des objets gérés automatiquement par le control plane, qui suivent en temps réel les adresses IP et l'état de disponibilité de chaque Pod ciblé par un Service.
- CoreDNS : L'infrastructure DNS interne du cluster. Elle joue le rôle de registre central en associant directement les noms de Service lisibles à leurs adresses IP internes cibles.
- Kube-proxy : Un agent réseau exécuté sur chaque nœud worker. Il met à jour dynamiquement les règles réseau du système (comme IPVS ou
iptables) pour intercepter et répartir les requêtes clientes adressées à l'IP d'un Service.
Des types de Service pour des besoins de routage variés :
Selon l'origine des requêtes clientes et la manière dont elles doivent découvrir leurs destinations, les développeurs configurent le paramètre spec.type d'un Service :
| Type de Service | Comportement de résolution | Cas d'usage typique |
|---|---|---|
| ClusterIP | Alloue une adresse IP virtuelle stable, accessible uniquement en interne. | Communication privée entre microservices (inter-Pods). |
| NodePort | Ouvre un port statique sur l'interface externe de chaque nœud worker. | Exposition de services internes à des routeurs matériels externes. |
| LoadBalancer | Provisionne automatiquement un load balancer cloud externe. | Accès public direct pour le trafic internet en production. |
| ExternalName | Renvoie un enregistrement CNAME standard pointant vers un domaine externe. |
Mappage de hooks internes vers des API tierces. |
Cet article fait partie d'une série consacrée au scheduling Kubernetes
Dans cet article :
- Pourquoi Kubernetes a-t-il besoin du Service Discovery ?
- Les composants clés du Service Discovery
- Les méthodes de Service Discovery dans Kubernetes
- Exemple de Service Discovery Kubernetes
- Types de Service Kubernetes et Service Discovery
- Bonnes pratiques du Service Discovery Kubernetes
Pourquoi Kubernetes a-t-il besoin du Service Discovery ? {#why-does-kubernetes-need-service-discovery}
Les workloads Kubernetes sont hautement dynamiques. Les Pods peuvent redémarrer, être scalés, migrer entre les nœuds ou être remplacés, ce qui signifie que leurs adresses IP peuvent changer fréquemment. Le Service Discovery fournit aux applications des moyens stables de localiser ces workloads sans suivre les adresses de chaque Pod :
- Adresses IP de Pods dynamiques : Les Pods reçoivent généralement une nouvelle adresse IP lorsqu'ils sont recréés. Le Service Discovery évite aux applications de devoir maintenir des listes d'IP changeantes.
- Mise à jour automatique des endpoints : Les Services Kubernetes suivent les Pods correspondants et mettent à jour leurs endpoints disponibles à mesure que des Pods sont ajoutés, retirés ou remplacés.
- Communication fiable entre services : Les applications peuvent se connecter via des noms de Service stables au lieu d'adresser directement des Pods individuels.
- Prise en charge du scaling : Lorsqu'un workload passe à plusieurs Pods, le Service Discovery rend automatiquement les nouvelles instances disponibles et permet de répartir le trafic entre elles.
- Moins de configuration à maintenir : Les développeurs n'ont pas besoin de mettre à jour manuellement la configuration applicative à chaque changement de topologie du cluster.
- Microservices découplés : Les services peuvent communiquer à l'aide de noms logiques, ce qui permet de déployer, scaler ou redémarrer chaque composant indépendamment.
Les composants clés du Service Discovery
Objets Service
Un Service Kubernetes est un objet API qui expose une application réseau s'exécutant sous forme d'un ou plusieurs Pods. Dans le cas le plus courant, un Service utilise un sélecteur de labels pour déterminer quels Pods composent son ensemble de backends. Kubernetes maintient ensuite des EndpointSlices contenant les endpoints correspondant à ce sélecteur.
Le type de Service par défaut, ClusterIP, reçoit une adresse IP virtuelle interne au cluster. Les clients peuvent se connecter à cette adresse de Service stable même si les Pods situés derrière sont remplacés ou scalés. Les applications clientes sont ainsi découplées des adresses IP changeantes des Pods qui constituent le workload backend.
Un Service peut aussi être headless en définissant .spec.clusterIP à None. Dans ce cas, Kubernetes n'alloue pas d'IP de cluster au Service, et le DNS peut renvoyer à la place les adresses des endpoints individuels du Service.
EndpointSlices
Les EndpointSlices représentent des sous-ensembles des endpoints réseau qui soutiennent un Service Kubernetes. Pour un Service doté d'un sélecteur, le control plane Kubernetes crée automatiquement des EndpointSlices contenant des références vers les Pods correspondant à ce sélecteur.
Les EndpointSlices ont été conçus pour offrir une meilleure scalabilité que l'ancienne API Endpoints. Plutôt que de stocker toutes les adresses backend dans un seul objet volumineux, Kubernetes peut répartir les endpoints sur plusieurs objets EndpointSlice. Par défaut, le control plane crée un nouvel EndpointSlice lorsque les slices existants ont atteint la cible par défaut de 100 endpoints.
Les EndpointSlices peuvent contenir des adresses d'endpoints, des ports, des informations de readiness, des informations de nœud et d'autres métadonnées utilisées par les composants réseau du cluster. Ils constituent également la source d'information sur les endpoints backend utilisée par kube-proxy pour router le trafic interne des Services.
L'ancienne API Endpoints est dépréciée au profit des EndpointSlices, et la documentation Kubernetes actuelle recommande aux clients d'utiliser l'API EndpointSlice.
CoreDNS
Les clusters Kubernetes utilisent couramment CoreDNS comme implémentation DNS de cluster. Un serveur DNS intégré au cluster observe les informations Kubernetes et crée des enregistrements DNS permettant aux Pods de rechercher les Services par leur nom. Kubernetes configure les paramètres DNS des Pods via le kubelet, afin que les applications puissent utiliser la résolution DNS standard plutôt que d'adresser les Services par IP.
Prenons par exemple un Service nommé my-service dans le namespace my-namespace. Un Pod peut s'y adresser via un nom DNS tel que :
my-service.my-namespaceUn nom de Service pleinement qualifié suit normalement cette structure :
my-service.my-namespace.svc.cluster.localLe domaine exact du cluster peut différer de cluster.local si l'administrateur du cluster a configuré un autre domaine. Au sein du même namespace, les applications peuvent généralement utiliser le nom court du Service, comme my-service. Les Pods d'un autre namespace doivent normalement inclure le namespace du Service.
kube-proxy
kube-proxy est l'implémentation par défaut du proxying de Service dans Kubernetes. Sur les nœuds où kube-proxy est utilisé, il observe les objets Service et EndpointSlice et configure le data plane réseau du nœud afin que le trafic envoyé vers l'IP virtuelle et le port d'un Service puisse être redirigé vers l'un de ses endpoints.
Sous Linux, les implémentations actuelles de kube-proxy prennent en charge les modes iptables, nftables et ipvs. Sous Windows, kube-proxy prend en charge le mode kernelspace. Le mode IPVS est déprécié depuis Kubernetes v1.35, tandis que nftables est disponible comme implémentation de proxy Linux plus récente.
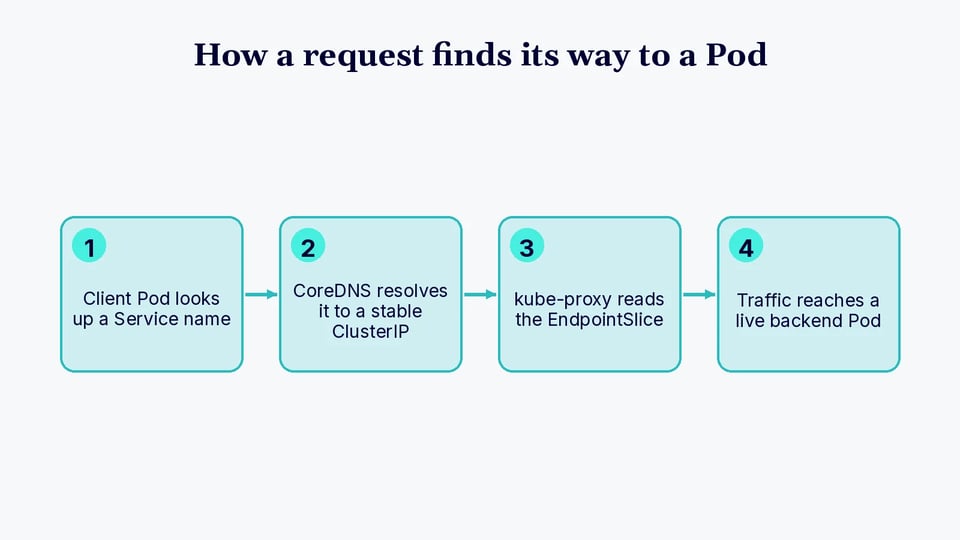
Il est utile de distinguer la découverte du transfert de trafic : le DNS aide une application à découvrir l'identité stable du Service, tandis que kube-proxy, ou une implémentation alternative de proxy de Service, se charge généralement de transférer le trafic depuis cette IP virtuelle de Service vers un endpoint backend approprié. Certaines implémentations réseau de Kubernetes remplacent kube-proxy par leur propre implémentation de proxy de Service.
Les méthodes de Service Discovery dans Kubernetes {#kubernetes-service-discovery-methods}
Découverte de services basée sur le DNS
Le DNS est la méthode standard et généralement privilégiée pour découvrir les Services depuis les applications s'exécutant dans un cluster Kubernetes. Kubernetes attribue des noms DNS aux Services, et un serveur DNS intégré au cluster, comme CoreDNS, rend ces noms résolvables depuis les Pods.
Par exemple, si un Service nommé backend existe dans le namespace default, un Pod du même namespace peut normalement s'y connecter avec :
backendUn Pod d'un autre namespace peut utiliser :
backend.defaultou le nom pleinement qualifié :
backend.default.svc.cluster.localPour un Service ClusterIP classique, le nom DNS est résolu vers l'IP de cluster du Service. Kubernetes prend également en charge les enregistrements DNS pour les Services headless et les enregistrements SRV pour les ports de Service nommés.
Comme les applications effectuent des requêtes DNS standard, elles n'ont pas besoin d'implémenter un protocole de découverte spécifique à Kubernetes.
Découverte de services via variables d'environnement
Kubernetes peut également publier des informations sur les Services actifs sous forme de variables d'environnement dans les Pods. Lorsque le kubelet démarre un Pod, il peut ajouter des variables basées sur les Services déjà existants. Pour un Service nommé my-service, par exemple, les variables générées incluent des formes telles que :
MY_SERVICE_SERVICE_HOSTMY_SERVICE_SERVICE_PORTLa variable host contient l'IP de cluster du Service, tandis que la variable port contient son port de Service.
Ce mécanisme comporte une contrainte importante liée à l'ordre de création : le Service doit exister avant la création du Pod client pour que ses variables d'environnement de Service soient renseignées dans ce Pod. Créer un Service plus tard n'ajoute pas rétroactivement ces variables à un Pod déjà en cours d'exécution. La découverte basée sur le DNS n'a pas cette contrainte.
Les variables d'environnement de Service peuvent également être désactivées pour un Pod via le champ enableServiceLinks lorsqu'elles sont inutiles.
Exemple de Service Discovery Kubernetes {#kubernetes-service-discovery-example}
Créer le Deployment backend
Créez un Deployment avec deux réplicas nginx :
apiVersion: apps/v1kind: Deploymentmetadata: name: internal-webspec: replicas: 2 selector: matchLabels: app: internal-web template: metadata: labels: app: internal-web spec: containers: - name: web-server image: nginx:stable ports: - containerPort: 80Enregistrez le manifeste sous nginx-deployment.yaml, puis appliquez-le :
kubectl apply -f nginx-deployment.yamlVérifiez que les Pods sont en cours d'exécution :
kubectl get pods -l app=internal-web -o wideLe Deployment maintient le nombre de réplicas demandé. Si l'un de ces Pods est supprimé et remplacé, son remplaçant peut recevoir une adresse IP différente, ce qui est l'une des raisons pour lesquelles les clients devraient utiliser un Service plutôt que de dépendre directement de ces adresses.
Créer le Service Kubernetes
Créez un Service ClusterIP qui sélectionne les Pods portant le label app: internal-web :
apiVersion: v1kind: Servicemetadata: name: internal-webspec: selector: app: internal-web ports: - protocol: TCP port: 8080 targetPort: 80Enregistrez ce manifeste sous nginx-service.yaml et appliquez-le :
kubectl apply -f nginx-service.yamlVérifiez le Service :
kubectl get service internal-webVous devriez obtenir une sortie similaire à :
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S)internal-web ClusterIP 10.96.100.10 <none> 8080/TCPL'IP de cluster exacte est attribuée par votre cluster et varie d'un cas à l'autre.
Vous pouvez également inspecter les EndpointSlices créés pour le Service :
kubectl get endpointslices -l kubernetes.io/service-name=internal-webLes adresses des endpoints doivent correspondre aux Pods sélectionnés par le Service. Si ces Pods sont remplacés ou si le Deployment est scalé, Kubernetes met à jour en conséquence les EndpointSlices du Service.
Découvrir le Service depuis un autre Pod
Démarrez un Pod temporaire contenant BusyBox :
kubectl run service-test --image=busybox --restart=Never --command -- sleep 3600Une fois le Pod en cours d'exécution, utilisez nslookup pour interroger le nom du Service :
kubectl exec service-test -- nslookup internal-webLa réponse DNS doit résoudre internal-web vers le ClusterIP du Service.
Vous pouvez aussi interroger le nom qualifié par le namespace :
kubectl exec service-test -- nslookup internal-web.defaultou le nom de Service pleinement qualifié lorsque le cluster utilise le domaine de cluster par défaut :
kubectl exec service-test -- nslookup internal-web.default.svc.cluster.localCela illustre le principal avantage du Service Discovery Kubernetes : le client n'a besoin de connaître que le nom stable internal-web. Il n'a pas besoin de savoir quels Pods nginx existent actuellement ni quelles sont leurs adresses IP. Le DNS Kubernetes résout l'identité du Service, les EndpointSlices suivent l'ensemble de backends actuel, et l'implémentation de proxy de Service du cluster transfère le trafic du Service vers un endpoint approprié.
Après le test, supprimez le Pod temporaire :
kubectl delete pod service-testTypes de Service Kubernetes et Service Discovery {#kubernetes-service-types-and-service-discovery}
ClusterIP
Un Service ClusterIP expose une application sur une adresse IP virtuelle stable, accessible depuis l'intérieur du cluster. C'est le type de Service par défaut, couramment utilisé pour la communication entre composants applicatifs internes.
Les clients découvrent normalement un Service ClusterIP via son nom DNS plutôt que via son adresse IP attribuée. Le DNS résout le nom du Service en IP de cluster, tandis que l'implémentation de proxy de Service du cluster transfère le trafic vers l'un des endpoints actuels du Service. Les Pods backend peuvent ainsi être remplacés ou scalés sans que les clients aient à modifier leur configuration.
NodePort
Un Service NodePort expose un Service sur un port de chaque nœud du cluster, en plus de fournir l'IP de cluster habituelle du Service. Les clients capables d'atteindre un nœud peuvent accéder au Service via une adresse de nœud et le port de nœud alloué.
NodePort change la façon dont le Service peut être atteint, mais ne remplace pas les mécanismes de découverte internes de Kubernetes. Les Pods à l'intérieur du cluster peuvent toujours découvrir le Service via son nom DNS et son IP de cluster. NodePort est souvent utilisé comme brique de base pour l'accès externe, ou lorsque les clients doivent se connecter directement via les adresses des nœuds.
LoadBalancer
Un Service LoadBalancer demande un load balancer externe auprès d'un fournisseur cloud pris en charge ou d'une autre implémentation de load balancer. Le load balancer externe reçoit le trafic provenant de l'extérieur du cluster et le dirige vers le Service Kubernetes.
En interne, le Service reste accessible via le DNS Kubernetes, comme les autres Services. La principale différence est que les clients externes peuvent utiliser l'adresse ou le nom d'hôte attribué au load balancer. Le provisionnement exact et le chemin du trafic dépendent de l'infrastructure du cluster et de l'implémentation du load balancer.
ExternalName
Un Service ExternalName associe un nom de Service Kubernetes à un nom DNS externe. Au lieu de sélectionner des Pods ou de maintenir des EndpointSlices backend, il renvoie un enregistrement DNS CNAME pointant vers la valeur configurée dans le champ externalName du Service.
Par exemple, une application peut accéder à un nom tel que database.default.svc.cluster.local, tandis que le DNS Kubernetes redirige la résolution vers un nom d'hôte externe tel que database.example.com. Cela fournit un nom local au cluster pour une dépendance externe, même si les applications doivent tenir compte des protocoles comme TLS et HTTP, qui peuvent dépendre du nom d'hôte utilisé par le client.
Bonnes pratiques du Service Discovery Kubernetes {#kubernetes-service-discovery-best-practices}
Voici quelques pratiques utiles à garder à l'esprit lors de l'utilisation du service discovery Kubernetes.
1. Utiliser le DNS Kubernetes plutôt que des IP de Pods codées en dur
Utilisez les noms DNS des Services comme méthode par défaut pour que les applications localisent les autres workloads. Les adresses IP des Pods sont temporaires et peuvent changer lorsque les Pods redémarrent, sont remplacés ou migrent vers un autre nœud. Coder ces adresses en dur rend les applications dépendantes de détails d'infrastructure que Kubernetes est conçu pour gérer dynamiquement.
Configurez les clients avec des noms comme backend ou backend.production au lieu de stocker des adresses de Pods. La configuration applicative reste ainsi indépendante du placement des workloads, et Kubernetes peut mettre à jour les endpoints sous-jacents sans modification côté client.
Privilégiez les noms qualifiés par le namespace lorsque les applications communiquent entre namespaces. Les noms DNS pleinement qualifiés permettent aussi d'éviter toute ambiguïté dans les environnements comportant des Services aux noms similaires. Les applications devraient adopter un comportement de cache DNS raisonnable afin que les enregistrements soient rafraîchis quand nécessaire.
2. Appliquer le right-sizing des workloads sans compromettre la disponibilité des Services
Exécutez suffisamment de réplicas pour maintenir la disponibilité du service pendant les défaillances de Pods, les déploiements, les événements de scaling et la maintenance courante. Pour les services importants, dépendre d'un seul Pod crée un point où le Service peut temporairement ne plus avoir d'endpoints utilisables.
Définissez des requests de ressources appropriées et des limites afin que les Pods puissent être planifiés de manière fiable sans consommer inutilement la capacité du cluster. Des requests trop élevées peuvent rendre les Pods difficiles à planifier, tandis que des requests trop faibles peuvent contribuer à la contention des ressources et à des performances instables.
Utilisez des readiness probes pour empêcher Kubernetes d'envoyer du trafic de Service vers des Pods avant qu'ils ne soient prêts à traiter les requêtes. Pour les workloads exigeant une disponibilité minimale pendant les interruptions volontaires, envisagez des PodDisruptionBudgets et répartissez les réplicas entre les nœuds ou les domaines de défaillance lorsque c'est pertinent.
3. Maintenir la cohérence entre sélecteurs de Service et labels de Pods
Un Service basé sur un sélecteur ne route le trafic que vers les Pods dont les labels correspondent à son sélecteur. Des labels incorrects ou incohérents peuvent donc laisser un Service sans endpoints, même lorsque les Pods applicatifs sont en cours d'exécution.
Adoptez un schéma de labels prévisible et gérez ensemble les sélecteurs de Service et les labels des workloads. Évitez de modifier les labels utilisés par des Services actifs sans évaluer l'impact du changement sur la composition des endpoints pendant un déploiement.
Des commandes comme kubectl get pods --show-labels et kubectl get endpointslices -l kubernetes.io/service-name=<service-name> permettent de confirmer que les Pods attendus sont bien enregistrés comme endpoints. Si un Service existe mais n'a pas d'endpoints, vérifier les sélecteurs, les labels et la readiness des Pods constitue une première étape de dépannage utile.
4. Surveiller la santé des EndpointSlices
Surveillez les EndpointSlices pour vérifier que les Services disposent du nombre attendu d'endpoints backend utilisables. Un ensemble d'endpoints vide ou anormalement réduit peut indiquer un décalage de sélecteurs, des échecs de readiness, des Pods indisponibles ou des problèmes de déploiement.
Intégrez la disponibilité des Services et des endpoints dans la supervision et les alertes du cluster. Les variations du nombre d'endpoints sont particulièrement utiles pour repérer les défaillances pendant les déploiements ou les événements d'autoscaling, avant qu'elles ne se transforment en problèmes de disponibilité plus larges.
Lors du dépannage, inspectez les EndpointSlices en parallèle du statut des Pods, des conditions de readiness et de la configuration des Services. Cela aide à distinguer un problème de découverte d'une défaillance applicative, DNS ou réseau. La supervision ne doit pas seulement vérifier qu'un Service existe, mais aussi qu'il dispose d'endpoints sains capables de recevoir du trafic.
Contenu associé : lisez notre article sur la supervision Kubernetes pour une vision plus large des métriques et des alertes du cluster.
5. Coordonner le service discovery avec l'autoscaling
L'autoscaling modifie le nombre de Pods derrière un Service ; la découverte et le routage du trafic doivent donc réagir correctement à l'ajout et au retrait de réplicas. Kubernetes met à jour les EndpointSlices à mesure que les Pods éligibles entrent ou sortent de l'ensemble de backends, ce qui permet aux clients de continuer à utiliser le même nom de Service tout au long des événements de scaling.
Configurez soigneusement les readiness probes afin que les Pods nouvellement créés ne reçoivent du trafic qu'une fois capables de servir les requêtes. Lors d'un scale-down, les paramètres de terminaison progressive peuvent laisser aux requêtes et connexions existantes le temps de se terminer pendant que les endpoints sont retirés du service actif.
Les applications devraient également adopter un cache DNS raisonnable, des timeouts de connexion, des retries et une gestion appropriée des pools de connexions. Les clients qui gardent leurs connexions ouvertes indéfiniment peuvent continuer à communiquer avec un ensemble limité de backends et ne pas tirer parti des réplicas nouvellement ajoutés. Le comportement des clients doit donc compléter l'autoscaling et la gestion des endpoints de Kubernetes, et non aller à leur encontre.
Des endpoints de Service toujours sains avec PerfectScale
Le service discovery n'est efficace que si les Pods qui se trouvent derrière le sont aussi. Lorsque les workloads sont sous-provisionnés, mal configurés ou scalés de manière inefficace, les Services se retrouvent avec trop peu d'endpoints sains, et le routage du trafic en pâtit même si la résolution DNS fonctionne correctement. PerfectScale est une plateforme d'optimisation Kubernetes que vous déployez une seule fois via Helm pour obtenir des insights actionnables et une optimisation autonome sur l'ensemble de votre stack K8s, afin que vos workloads restent à la fois rentables et suffisamment résilients pour continuer à servir le trafic.
Fonctionnalités clés de PerfectScale :
- Right-sizing autonome des workloads : Podfit offre une vue granulaire de la santé et des coûts du cluster, en priorisant les zones qui nécessitent une attention particulière, tout en optimisant les workloads de façon autonome et en mettant en évidence les ressources gaspillées et les problèmes de résilience.
- Recommandations de scaling basées sur les données : PerfectScale fournit des recommandations actionnables pour améliorer vos configurations HPA et KEDA, et s'intègre aux solutions d'autoscaling telles que HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning et Google Autopilot.
- Optimisation au niveau des nœuds : Infrafit offre une visibilité complète sur l'utilisation des nœuds, pour identifier et éliminer la capacité inutilisée et choisir les bons nœuds pour vos workloads grâce à des recommandations basées sur les données.
- Alertes en temps réel avec priorisation automatique : La priorisation par impact vous aide à résoudre les risques de résilience et à repérer les pics de coûts et les anomalies avant qu'ils n'atteignent vos utilisateurs, avec des alertes envoyées dans Slack, Datadog, MS Teams ou PagerDuty.
- Rapports de tendances pour la gouvernance et la prévision : Visibilité granulaire sur les coûts, le gaspillage et les métriques de risque dans le temps, à l'échelle des clusters, groupes de nœuds, namespaces et workloads, avec une analyse des causes racines pour éviter la répétition des incidents.
- Large compatibilité d'environnements : PerfectScale fonctionne aussi bien on-premise que dans le cloud, s'intègre aux clouds privés comme OpenShift et aux clouds publics comme EKS, GKE et AKS, et prend également en charge les conteneurs Windows.
Découvrez comment la plateforme PerfectScale maintient vos workloads Kubernetes correctement dimensionnés, résilients et prêts à servir le trafic.
FAQ
Quelle est la différence entre un Service Kubernetes et un EndpointSlice ? Un Service est la porte d'entrée stable et logique : un nom et une IP virtuelle auxquels les clients se connectent. Un EndpointSlice est la liste derrière cette porte : l'ensemble réel des IP de Pods correspondant actuellement au sélecteur du Service, tenu à jour automatiquement au gré des allées et venues des Pods.
Kubernetes privilégie-t-il la découverte de services via DNS ou via variables d'environnement ? Le DNS est la méthode standard et généralement privilégiée. La découverte via variables d'environnement comporte une contrainte d'ordre de création : le Service doit déjà exister avant la création d'un Pod client, sinon ce Pod ne reçoit jamais les variables. Les requêtes DNS n'ont pas cette restriction.
Pourquoi un Service peut-il afficher zéro endpoint alors que ses Pods sont en cours d'exécution ?
Il s'agit presque toujours d'un décalage entre le sélecteur du Service et les labels des Pods, même si des échecs de readiness peuvent aussi en être la cause. Vérifier kubectl get endpointslices en parallèle de kubectl get pods --show-labels est le moyen le plus rapide d'identifier la cause.
Quelle est la différence entre ClusterIP, NodePort et LoadBalancer ? ClusterIP est uniquement interne et constitue le type par défaut. NodePort ajoute un port statique sur chaque nœud afin que le Service soit accessible depuis l'extérieur du cluster. LoadBalancer provisionne un load balancer cloud externe devant le Service. Les trois restent accessibles à l'intérieur du cluster via le même nom DNS.
L'autoscaling casse-t-il le service discovery ? Non, mais il exige la coopération des clients. Kubernetes met automatiquement à jour les EndpointSlices à mesure que les réplicas augmentent ou diminuent, mais les clients qui gardent leurs connexions ouvertes indéfiniment peuvent continuer à dialoguer avec un ensemble de backends obsolète et réduit, au lieu de profiter des réplicas nouvellement ajoutés.