


Was ist Kubernetes Service Discovery?
Kubernetes Service Discovery ist der integrierte Mechanismus, der es containerisierten Microservices ermöglicht, einander dynamisch zu finden und miteinander zu kommunizieren – ohne volatile IP-Adressen fest zu codieren. Da Kubernetes-Pods kurzlebig sind (sie werden häufig gelöscht, neu erstellt und erhalten dabei neue IPs), abstrahiert Kubernetes sie hinter einer dauerhaften, logischen Routing-Instanz – dem sogenannten Service.
Kernkomponenten der Service Discovery: Kubernetes kombiniert mehrere Architekturschichten, um Backends nachzuverfolgen und Netzwerk-Traffic sauber zu routen:
- Service-Objekte: Eine Abstraktionsschicht, die eine logische Gruppe von Pods sowie eine Richtlinie für den Zugriff darauf definiert. Services finden die Ziel-Pods über selbst definierte Labels und Selektoren.
- EndpointSlices: Von der Control Plane automatisch verwaltete Objekte, die die aktuellen IP-Adressen und Readiness-Zustände aller einzelnen Pods nachverfolgen, auf die ein Service abzielt.
- CoreDNS: Die interne DNS-Infrastruktur des Clusters. Sie fungiert als zentrales Register und ordnet menschenlesbare Service-Namen direkt den internen Ziel-IP-Adressen zu.
- Kube-proxy: Ein Netzwerk-Agent, der auf jedem Worker-Node läuft. Er aktualisiert dynamisch die Netzwerkregeln des Systems (etwa IPVS oder
iptables), um Client-Anfragen an die IP eines Services abzufangen und per Load Balancing zu verteilen.
Service-Typen für unterschiedliche Routing-Anforderungen:
Je nachdem, woher Client-Anfragen stammen und wie sie ihre Ziele finden müssen, konfigurieren Entwickler den Parameter spec.type eines Services:
| Service-Typ | Auflösungsverhalten | Typischer Anwendungsfall |
|---|---|---|
| ClusterIP | Weist eine stabile, nur intern erreichbare virtuelle IP-Adresse zu. | Private Microservice-Kommunikation zwischen Pods. |
| NodePort | Öffnet einen statischen Port auf der externen Schnittstelle jedes Worker-Nodes. | Bereitstellung interner Services für externe Hardware-Router. |
| LoadBalancer | Stellt automatisch einen externen Cloud-Load-Balancer bereit. | Direkter öffentlicher Zugriff für Produktions-Internet-Traffic. |
| ExternalName | Gibt einen standardmäßigen CNAME-Eintrag zurück, der auf eine externe Domain verweist. |
Zuordnung interner Code-Hooks zu Drittanbieter-APIs. |
Dieser Artikel ist Teil einer Serie über Kubernetes-Scheduling
In diesem Artikel:
- Warum braucht Kubernetes Service Discovery?
- Kernkomponenten der Service Discovery
- Methoden der Kubernetes Service Discovery
- Kubernetes Service Discovery: Ein Beispiel
- Kubernetes-Service-Typen und Service Discovery
- Best Practices für Kubernetes Service Discovery
Warum braucht Kubernetes Service Discovery? {#why-does-kubernetes-need-service-discovery}
Kubernetes-Workloads sind hochdynamisch. Pods können neu starten, skalieren, zwischen Nodes wandern oder ersetzt werden – ihre IP-Adressen ändern sich daher häufig. Service Discovery bietet Anwendungen stabile Wege, diese Workloads zu finden, ohne einzelne Pod-Adressen nachverfolgen zu müssen:
- Dynamische Pod-IP-Adressen: Pods erhalten bei der Neuerstellung in der Regel eine neue IP-Adresse. Dank Service Discovery müssen Anwendungen keine wechselnden IP-Listen pflegen.
- Automatische Endpunkt-Updates: Kubernetes-Services verfolgen passende Pods und aktualisieren ihre verfügbaren Endpunkte, wenn Pods hinzugefügt, entfernt oder ersetzt werden.
- Zuverlässige Kommunikation zwischen Services: Anwendungen können sich über stabile Service-Namen verbinden, statt einzelne Pods direkt anzusprechen.
- Unterstützung für Skalierung: Skaliert ein Workload auf mehrere Pods, macht Service Discovery die neuen Instanzen automatisch verfügbar und ermöglicht die Verteilung des Traffics auf sie.
- Weniger Konfigurationsaufwand: Entwickler müssen die Anwendungskonfiguration nicht manuell anpassen, wenn sich die Cluster-Topologie ändert.
- Entkoppelte Microservices: Services kommunizieren über logische Namen, sodass jede Komponente unabhängig bereitgestellt, skaliert oder neu gestartet werden kann.
Kernkomponenten der Service Discovery
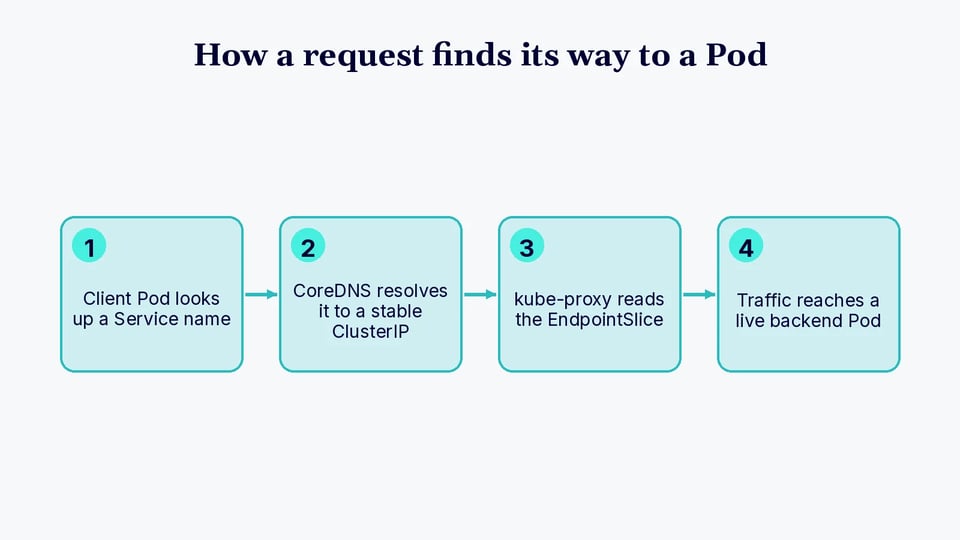
Service-Objekte
Ein Kubernetes-Service ist ein API-Objekt, das eine Netzwerkanwendung bereitstellt, die als ein oder mehrere Pods läuft. Im Normalfall bestimmt ein Service über einen Label-Selector, welche Pods zu seinem Backend gehören. Kubernetes pflegt daraufhin EndpointSlices mit den Endpunkten, die diesem Selector entsprechen.
Der Standard-Service-Typ ClusterIP erhält eine clusterinterne virtuelle IP-Adresse. Clients können sich mit dieser stabilen Service-Adresse verbinden, auch wenn die dahinterliegenden Pods ersetzt oder skaliert werden. Das entkoppelt Client-Anwendungen von den wechselnden Pod-IP-Adressen des Backend-Workloads.
Services können auch headless sein, indem .spec.clusterIP auf None gesetzt wird. In diesem Fall weist Kubernetes keine Service-Cluster-IP zu, und DNS kann stattdessen die Adressen der einzelnen Endpunkte des Services zurückgeben.
EndpointSlices
EndpointSlices repräsentieren Teilmengen der Netzwerk-Endpunkte hinter einem Kubernetes-Service. Für einen Service mit Selector erstellt die Kubernetes Control Plane automatisch EndpointSlices mit Verweisen auf die Pods, die diesem Selector entsprechen.
EndpointSlices wurden entwickelt, um effizienter zu skalieren als die ältere Endpoints-API. Statt alle Backend-Adressen in einem großen Objekt zu speichern, kann Kubernetes Endpunkte auf mehrere EndpointSlice-Objekte verteilen. Standardmäßig erstellt die Control Plane ein weiteres EndpointSlice, sobald bestehende Slices den Standardzielwert von 100 Endpunkten erreicht haben.
EndpointSlices können Endpunktadressen, Ports, Readiness-Informationen, Node-Informationen und weitere Metadaten enthalten, die von den Netzwerkkomponenten des Clusters genutzt werden. Sie sind außerdem die Quelle der Backend-Endpunktinformationen, die kube-proxy beim Routing von internem Service-Traffic verwendet.
Die ältere Endpoints-API ist zugunsten von EndpointSlices als veraltet markiert; die aktuelle Kubernetes-Dokumentation empfiehlt Clients, stattdessen die EndpointSlice-API zu verwenden.
CoreDNS
Kubernetes-Cluster setzen üblicherweise CoreDNS als Cluster-DNS-Implementierung ein. Ein clusterfähiger DNS-Server beobachtet Kubernetes-Informationen und erstellt DNS-Einträge, über die Pods Services per Name auflösen können. Kubernetes konfiguriert die DNS-Einstellungen der Pods über das kubelet, sodass Anwendungen die Standard-DNS-Auflösung nutzen können, statt Services per IP anzusprechen.
Betrachten wir zum Beispiel einen Service namens my-service im Namespace my-namespace. Ein Pod kann ihn über einen DNS-Namen wie diesen ansprechen:
my-service.my-namespaceEin vollqualifizierter Service-Name folgt normalerweise dieser Struktur:
my-service.my-namespace.svc.cluster.localDie genaue Cluster-Domain kann von cluster.local abweichen, wenn der Cluster-Administrator eine andere Domain konfiguriert hat. Innerhalb desselben Namespace reicht Anwendungen in der Regel der kurze Service-Name wie my-service. Pods in einem anderen Namespace müssen normalerweise den Namespace des Services mit angeben.
kube-proxy
kube-proxy ist die Standardimplementierung des Service-Proxyings in Kubernetes. Auf Nodes, auf denen kube-proxy eingesetzt wird, beobachtet es Service- und EndpointSlice-Objekte und konfiguriert die Netzwerk-Datenebene des Nodes so, dass Traffic an die virtuelle IP und den Port eines Services an einen seiner Endpunkte umgeleitet werden kann.
Unter Linux unterstützen aktuelle kube-proxy-Implementierungen die Modi iptables, nftables und ipvs. Unter Windows unterstützt kube-proxy den kernelspace-Modus. Der IPVS-Modus ist seit Kubernetes v1.35 veraltet, während nftables als neuere Linux-Proxy-Implementierung verfügbar ist.
Es lohnt sich, Discovery von Traffic-Weiterleitung zu unterscheiden: DNS hilft einer Anwendung, die stabile Service-Identität zu finden, während kube-proxy oder eine alternative Service-Proxy-Implementierung typischerweise den Traffic von dieser virtuellen Service-IP an einen passenden Backend-Endpunkt weiterleitet. Manche Kubernetes-Netzwerkimplementierungen ersetzen kube-proxy durch eine eigene Service-Proxy-Implementierung.
Methoden der Kubernetes Service Discovery {#kubernetes-service-discovery-methods}
DNS-basierte Service Discovery
DNS ist die Standardmethode und in der Regel der bevorzugte Weg, um Services aus Anwendungen innerhalb eines Kubernetes-Clusters heraus zu finden. Kubernetes weist Services DNS-Namen zu, und ein clusterfähiger DNS-Server wie CoreDNS macht diese Namen für Pods auflösbar.
Existiert beispielsweise ein Service namens backend im Default-Namespace, kann sich ein Pod im selben Namespace normalerweise verbinden über:
backendEin Pod in einem anderen Namespace kann Folgendes verwenden:
backend.defaultoder den vollqualifizierten Namen:
backend.default.svc.cluster.localBei einem normalen ClusterIP-Service wird der DNS-Name auf die Cluster-IP des Services aufgelöst. Kubernetes unterstützt außerdem DNS-Einträge für headless Services sowie SRV-Einträge für benannte Service-Ports.
Da Anwendungen Standard-DNS-Lookups durchführen, müssen sie kein Kubernetes-spezifisches Discovery-Protokoll implementieren.
Service Discovery über Umgebungsvariablen
Kubernetes kann Informationen über aktive Services auch als Umgebungsvariablen in Pods bereitstellen. Wenn das kubelet einen Pod startet, kann es Variablen für bereits existierende Services hinzufügen. Für einen Service namens my-service umfassen die generierten Variablen zum Beispiel Formen wie:
MY_SERVICE_SERVICE_HOSTMY_SERVICE_SERVICE_PORTDie Host-Variable enthält die Cluster-IP des Services, die Port-Variable den Service-Port.
Dieser Mechanismus hat eine wichtige Einschränkung bei der Reihenfolge: Der Service muss existieren, bevor der Client-Pod erstellt wird, damit seine Service-Umgebungsvariablen in diesem Pod gesetzt werden. Ein später erstellter Service fügt diese Variablen nicht rückwirkend zu einem bereits laufenden Pod hinzu. Bei DNS-basierter Discovery spielt die Reihenfolge keine Rolle.
Werden sie nicht benötigt, lassen sich Service-Umgebungsvariablen für einen Pod außerdem über das Feld enableServiceLinks deaktivieren.
Kubernetes Service Discovery: Ein Beispiel {#kubernetes-service-discovery-example}
Das Backend-Deployment erstellen
Erstellen Sie ein Deployment mit zwei nginx-Replikaten:
apiVersion: apps/v1kind: Deploymentmetadata: name: internal-webspec: replicas: 2 selector: matchLabels: app: internal-web template: metadata: labels: app: internal-web spec: containers: - name: web-server image: nginx:stable ports: - containerPort: 80Speichern Sie das Manifest als nginx-deployment.yaml und wenden Sie es an:
kubectl apply -f nginx-deployment.yamlPrüfen Sie, ob die Pods laufen:
kubectl get pods -l app=internal-web -o wideDas Deployment hält die gewünschte Anzahl an Replikaten aufrecht. Wird einer dieser Pods entfernt und ersetzt, kann der Ersatz-Pod eine andere Pod-IP erhalten – ein Grund, warum Clients einen Service nutzen sollten, statt sich direkt auf diese Adressen zu verlassen.
Den Kubernetes-Service erstellen
Erstellen Sie einen ClusterIP-Service, der Pods mit dem Label app: internal-web auswählt:
apiVersion: v1kind: Servicemetadata: name: internal-webspec: selector: app: internal-web ports: - protocol: TCP port: 8080 targetPort: 80Speichern Sie dieses Manifest als nginx-service.yaml und wenden Sie es an:
kubectl apply -f nginx-service.yamlPrüfen Sie den Service:
kubectl get service internal-webDie Ausgabe sollte in etwa so aussehen:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S)internal-web ClusterIP 10.96.100.10 <none> 8080/TCPDie konkrete Cluster-IP wird von Ihrem Cluster vergeben und kann abweichen.
Sie können auch die für den Service erstellten EndpointSlices inspizieren:
kubectl get endpointslices -l kubernetes.io/service-name=internal-webDie Endpunktadressen sollten den vom Service ausgewählten Pods entsprechen. Werden diese Pods ersetzt oder wird das Deployment skaliert, aktualisiert Kubernetes die EndpointSlices des Services entsprechend.
Den Service aus einem anderen Pod heraus finden
Starten Sie einen temporären Pod mit BusyBox:
kubectl run service-test --image=busybox --restart=Never --command -- sleep 3600Sobald der Pod läuft, fragen Sie den Service-Namen mit nslookup ab:
kubectl exec service-test -- nslookup internal-webDie DNS-Antwort sollte internal-web auf die ClusterIP des Services auflösen.
Sie können auch den Namespace-qualifizierten Namen abfragen:
kubectl exec service-test -- nslookup internal-web.defaultoder den vollqualifizierten Service-Namen, wenn der Cluster die Standard-Cluster-Domain verwendet:
kubectl exec service-test -- nslookup internal-web.default.svc.cluster.localDas zeigt den zentralen Vorteil der Kubernetes Service Discovery: Der Client muss nur den stabilen Namen internal-web kennen. Er muss weder wissen, welche nginx-Pods aktuell existieren, noch welche IP-Adressen sie haben. Kubernetes-DNS löst die Service-Identität auf, EndpointSlices verfolgen den aktuellen Backend-Bestand, und die Service-Proxy-Implementierung des Clusters leitet den Service-Traffic an einen passenden Endpunkt weiter.
Entfernen Sie nach dem Test den temporären Pod:
kubectl delete pod service-testKubernetes-Service-Typen und Service Discovery {#kubernetes-service-types-and-service-discovery}
ClusterIP
Ein ClusterIP-Service stellt eine Anwendung über eine stabile virtuelle IP-Adresse bereit, die innerhalb des Clusters erreichbar ist. Er ist der Standard-Service-Typ und wird häufig für die Kommunikation zwischen internen Anwendungskomponenten verwendet.
Clients finden einen ClusterIP-Service normalerweise über seinen DNS-Namen statt über die zugewiesene IP-Adresse. DNS löst den Service-Namen auf die Cluster-IP auf, während die Service-Proxy-Implementierung des Clusters den Traffic an einen der aktuellen Endpunkte des Services weiterleitet. So lassen sich Backend-Pods ersetzen oder skalieren, ohne dass Clients ihre Konfiguration anpassen müssen.
NodePort
Ein NodePort-Service stellt einen Service zusätzlich zur normalen Service-Cluster-IP über einen Port auf jedem Cluster-Node bereit. Clients, die einen Node erreichen können, greifen über eine Node-Adresse und den zugewiesenen Node-Port auf den Service zu.
NodePort ändert, wie der Service erreichbar ist, ersetzt aber nicht die internen Discovery-Mechanismen von Kubernetes. Pods innerhalb des Clusters können den Service weiterhin über seinen DNS-Namen und die Cluster-IP finden. NodePort dient oft als Baustein für externen Zugriff oder für Fälle, in denen Clients sich direkt über Node-Adressen verbinden müssen.
LoadBalancer
Ein LoadBalancer-Service fordert einen externen Load Balancer von einem unterstützten Cloud-Anbieter oder einer anderen Load-Balancer-Implementierung an. Der externe Load Balancer empfängt Traffic von außerhalb des Clusters und leitet ihn an den Kubernetes-Service weiter.
Intern bleibt der Service wie andere Services über Kubernetes-DNS auffindbar. Der Hauptunterschied: Externe Clients können die dem Load Balancer zugewiesene Adresse oder den Hostnamen verwenden. Die genaue Bereitstellung und der Traffic-Pfad hängen von der Infrastruktur des Clusters und der Load-Balancer-Implementierung ab.
ExternalName
Ein ExternalName-Service ordnet einem Kubernetes-Service-Namen einen externen DNS-Namen zu. Statt Pods auszuwählen oder Backend-EndpointSlices zu pflegen, gibt er einen DNS-CNAME-Eintrag zurück, der auf den im Feld externalName des Services konfigurierten Wert verweist.
Eine Anwendung kann zum Beispiel einen Namen wie database.default.svc.cluster.local ansprechen, während Kubernetes-DNS die Auflösung auf einen externen Hostnamen wie database.example.com umleitet. So erhält eine externe Abhängigkeit einen Kubernetes-lokalen Namen – Anwendungen müssen allerdings Protokolle wie TLS und HTTP berücksichtigen, die vom clientseitig verwendeten Hostnamen abhängen können.
Best Practices für Kubernetes Service Discovery {#kubernetes-service-discovery-best-practices}
Im Folgenden einige nützliche Praktiken für den Einsatz der Kubernetes Service Discovery.
1. Kubernetes-DNS statt fest codierter Pod-IPs verwenden
Nutzen Sie Service-DNS-Namen als Standardweg, über den Anwendungen andere Workloads finden. Pod-IP-Adressen sind temporär und können sich ändern, wenn Pods neu starten, ersetzt werden oder auf einen anderen Node wandern. Wer diese Adressen fest codiert, macht Anwendungen von Infrastrukturdetails abhängig, die Kubernetes gerade dynamisch verwalten soll.
Konfigurieren Sie Clients mit Namen wie backend oder backend.production, statt Pod-Adressen zu speichern. So bleibt die Anwendungskonfiguration unabhängig von der Workload-Platzierung, und Kubernetes kann die zugrunde liegenden Endpunkte aktualisieren, ohne dass Clients angepasst werden müssen.
Bevorzugen Sie Namespace-qualifizierte Namen, wenn Anwendungen über Namespaces hinweg kommunizieren. Vollqualifizierte DNS-Namen vermeiden zudem Mehrdeutigkeiten in Umgebungen mit ähnlich benannten Services. Anwendungen sollten ein sinnvolles DNS-Caching-Verhalten nutzen, damit Einträge bei Bedarf aktualisiert werden.
2. Right-Sizing von Workloads ohne Abstriche bei der Service-Verfügbarkeit
Betreiben Sie ausreichend Replikate, um die Service-Verfügbarkeit bei Pod-Ausfällen, Deployments, Skalierungsereignissen und Routinewartung aufrechtzuerhalten. Bei wichtigen Services schafft ein einzelner Pod einen Punkt, an dem der Service vorübergehend keine nutzbaren Endpunkte haben kann.
Setzen Sie passende Resource Requests und Limits, damit Pods zuverlässig eingeplant werden können, ohne unnötig Cluster-Kapazität zu belegen. Zu hohe Requests erschweren das Scheduling der Pods, während zu niedrige Requests zu Ressourcenkonflikten und instabiler Performance beitragen können.
Nutzen Sie Readiness Probes, damit Kubernetes keinen Service-Traffic an Pods sendet, bevor diese Anfragen verarbeiten können. Für Workloads, die während freiwilliger Unterbrechungen eine Mindestverfügbarkeit benötigen, bieten sich PodDisruptionBudgets an; verteilen Sie Replikate zudem bei Bedarf über Nodes oder Failure Domains.
3. Service-Selektoren und Pod-Labels konsistent halten
Ein selectorbasierter Service leitet Traffic nur an Pods weiter, deren Labels zu seinem Selector passen. Falsche oder inkonsistente Labels können daher dazu führen, dass einem Service Endpunkte fehlen, obwohl die Anwendungs-Pods laufen.
Verwenden Sie ein vorhersehbares Labeling-Schema und verwalten Sie Service-Selektoren und Workload-Labels gemeinsam. Ändern Sie Labels aktiver Services nicht, ohne zu bedenken, wie sich die Änderung während eines Deployments auf die Endpunkt-Zugehörigkeit auswirkt.
Befehle wie kubectl get pods --show-labels und kubectl get endpointslices -l kubernetes.io/service-name=<service-name> helfen zu bestätigen, dass die erwarteten Pods als Endpunkte registriert sind. Existiert ein Service ohne Endpunkte, ist die Prüfung von Selektoren, Labels und Pod-Readiness ein sinnvoller erster Troubleshooting-Schritt.
4. Den Zustand der EndpointSlices überwachen
Überwachen Sie EndpointSlices, um sicherzustellen, dass Services die erwartete Anzahl nutzbarer Backend-Endpunkte haben. Ein leerer oder unerwartet kleiner Endpunktbestand kann auf Selector-Abweichungen, fehlgeschlagene Readiness-Checks, nicht verfügbare Pods oder Deployment-Probleme hindeuten.
Beziehen Sie Service- und Endpunktverfügbarkeit in Cluster-Monitoring und Alerting ein. Änderungen der Endpunktanzahl sind besonders nützlich, um Ausfälle während Deployments oder Autoscaling-Ereignissen zu erkennen, bevor daraus größere Verfügbarkeitsprobleme werden.
Beim Troubleshooting sollten Sie EndpointSlices inspizieren – zusammen mit Pod-Status, Readiness-Bedingungen und Service-Konfiguration. Das hilft, ein Discovery-Problem von einem Anwendungs-, DNS- oder Netzwerkfehler zu unterscheiden. Das Monitoring sollte nicht nur prüfen, ob ein Service existiert, sondern auch, ob er gesunde Endpunkte hat, die Traffic entgegennehmen können.
Verwandter Inhalt: Lesen Sie unseren Artikel über Kubernetes-Monitoring für einen umfassenderen Blick auf Cluster-Metriken und Alerting.
5. Service Discovery mit dem Autoscaling abstimmen
Autoscaling verändert die Anzahl der Pods hinter einem Service – Discovery und Traffic-Routing müssen also korrekt reagieren, wenn Replikate hinzukommen oder entfernt werden. Kubernetes aktualisiert EndpointSlices, sobald berechtigte Pods in den Backend-Bestand eintreten oder ihn verlassen, sodass Clients während Skalierungsereignissen denselben Service-Namen weiterverwenden können.
Konfigurieren Sie Readiness Probes sorgfältig, damit neu erstellte Pods erst dann Traffic erhalten, wenn sie Anfragen bedienen können. Beim Herunterskalieren geben Graceful-Termination-Einstellungen laufenden Anfragen und Verbindungen Zeit zum Abschluss, während Endpunkte aus der aktiven Nutzung genommen werden.
Anwendungen sollten zudem auf sinnvolles DNS-Caching, Verbindungs-Timeouts, Retries und ein durchdachtes Connection-Pool-Verhalten setzen. Clients, die Verbindungen unbegrenzt offen halten, kommunizieren unter Umständen weiter mit einer begrenzten Backend-Menge und profitieren nicht von neu hinzugefügten Replikaten. Das Client-Verhalten sollte das Autoscaling und Endpunkt-Management von Kubernetes daher ergänzen – und nicht dagegen arbeiten.
Gesunde Service-Endpunkte mit PerfectScale
Service Discovery ist nur so gut wie die Pods dahinter. Sind Workloads unterdimensioniert, falsch konfiguriert oder ineffizient skaliert, haben Services zu wenige gesunde Endpunkte – und das Traffic-Routing leidet, obwohl die DNS-Auflösung korrekt funktioniert. PerfectScale ist eine Kubernetes-Optimierungsplattform, die Sie einmalig per Helm deployen und anschließend für umsetzbare Erkenntnisse und autonome Optimierung über Ihren gesamten K8s-Stack nutzen – damit Ihre Workloads kosteneffizient und zugleich resilient genug bleiben, um Traffic zuverlässig zu bedienen.
Zentrale Funktionen von PerfectScale:
- Autonomes Right-Sizing von Workloads: Podfit bietet eine granulare Sicht auf Cluster-Zustand und -Kosten, priorisiert die Bereiche mit Handlungsbedarf, optimiert Workloads autonom und macht verschwendete Ressourcen sowie Resilienzprobleme sichtbar.
- Datenbasierte Skalierungsempfehlungen: PerfectScale liefert umsetzbare Empfehlungen zur Verbesserung von HPA- und KEDA-Konfigurationen und integriert sich mit Autoscaling-Lösungen wie HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning und Google Autopilot.
- Optimierung auf Node-Ebene: Infrafit bietet umfassende Transparenz über die Node-Auslastung und hilft Ihnen, ungenutzte Node-Kapazität zu identifizieren und zu eliminieren sowie mit datenbasierten Empfehlungen die richtigen Nodes für Ihre Workloads auszuwählen.
- Echtzeit-Alerts mit automatischer Priorisierung: Eine wirkungsbasierte Priorisierung hilft Ihnen, Resilienzrisiken zu beheben sowie Kostenspitzen und Anomalien zu erkennen, bevor sie Ihre Nutzer erreichen – mit Alerts direkt in Slack, Datadog, MS Teams oder PagerDuty.
- Trend-Reporting für Governance und Forecasting: Granulare Einblicke in Kosten-, Verschwendungs- und Risikometriken im Zeitverlauf über Cluster, Node-Gruppen, Namespaces und Workloads hinweg – inklusive Root-Cause-Analyse zur Vermeidung wiederkehrender Probleme.
- Breite Umgebungsunterstützung: PerfectScale läuft sowohl on-premise als auch in Cloud-Umgebungen, integriert sich mit Private Clouds wie OpenShift und Public Clouds wie EKS, GKE und AKS und unterstützt auch Windows-basierte Container.
Erfahren Sie mehr darüber, wie die PerfectScale-Plattform Ihre Kubernetes-Workloads richtig dimensioniert, resilient und jederzeit bereit für Traffic hält.
FAQ
Was ist der Unterschied zwischen einem Kubernetes-Service und einem EndpointSlice? Ein Service ist der stabile, logische Eingangspunkt: ein Name und eine virtuelle IP, mit denen sich Clients verbinden. Ein EndpointSlice ist die Liste dahinter: die tatsächliche Menge der Pod-IPs, die aktuell zum Selector des Services passen – automatisch aktuell gehalten, während Pods kommen und gehen.
Bevorzugt Kubernetes DNS-basierte Service Discovery oder Umgebungsvariablen? DNS ist die Standardmethode und in der Regel der bevorzugte Weg. Discovery über Umgebungsvariablen hat eine Einschränkung bei der Reihenfolge: Der Service muss bereits existieren, bevor ein Client-Pod erstellt wird – andernfalls erhält dieser Pod die Variablen nie. DNS-Lookups kennen diese Einschränkung nicht.
Warum zeigt ein Service null Endpunkte, obwohl seine Pods laufen?
Das ist fast immer eine Label-Abweichung zwischen dem Selector des Services und den Labels der Pods; auch fehlgeschlagene Readiness-Checks können die Ursache sein. Der schnellste Weg zur Bestätigung ist der Abgleich von kubectl get endpointslices mit kubectl get pods --show-labels.
Was ist der Unterschied zwischen ClusterIP, NodePort und LoadBalancer? ClusterIP ist nur intern erreichbar und der Standard. NodePort fügt auf jedem Node einen statischen Port hinzu, sodass der Service von außerhalb des Clusters erreichbar ist. LoadBalancer stellt einen externen Cloud-Load-Balancer vor dem Service bereit. Alle drei bleiben innerhalb des Clusters über denselben DNS-Namen auffindbar.
Beeinträchtigt Autoscaling die Service Discovery? Nein, aber die Clients müssen dabei mitspielen. Kubernetes aktualisiert EndpointSlices automatisch, wenn Replikate hoch- oder herunterskaliert werden. Clients, die Verbindungen unbegrenzt offen halten, kommunizieren jedoch möglicherweise weiter mit einem veralteten, kleineren Backend-Bestand, statt neu hinzugefügte Replikate zu nutzen.