


¿Qué es NodeSelector en Kubernetes?
En Kubernetes, nodeSelector es la forma recomendada más simple de restringir un Pod para que se programe únicamente en nodos con etiquetas específicas. Funciona como un filtro estricto para el kube-scheduler: si un nodo no coincide con todas y cada una de las etiquetas definidas en el nodeSelector, el Pod no se ubicará allí.
Cómo funciona:
- Etiqueta los nodos de destino: Asigna etiquetas clave-valor a los nodos según propiedades como el tipo de almacenamiento, el hardware, la arquitectura o el rol del workload.
- Define la restricción del pod: Agrega un nodeSelector en el spec del pod con las etiquetas requeridas para la programación.
- Coincide con todas las etiquetas especificadas: El scheduler solo considera los nodos que coinciden con cada par clave-valor definido en el nodeSelector.
- Evalúa los demás requisitos de programación: Los nodos que coinciden deben cumplir además con los requisitos de recursos, los taints, las reglas de afinidad y otras restricciones de programación.
- Los pods sin coincidencia quedan pendientes: Si ningún nodo elegible coincide, el pod permanece en estado Pending hasta que cambien las condiciones del clúster o las restricciones de programación.
nodeSelector vs. node affinity: Si bien nodeSelector es excelente para despliegues simples, los requisitos de programación más complejos suelen exigir Node Affinity.
| Característica | nodeSelector | Node Affinity |
|---|---|---|
| Complejidad | Simple y ligero | Configuración más compleja |
| Lógica de coincidencia | Solo coincidencias exactas clave-valor | Admite operadores expresivos (In, NotIn, Exists, Gt, Lt) |
| Flexibilidad de reglas | Solo reglas estrictas (debe coincidir o el Pod queda en Pending) | Reglas estrictas y flexibles (puede "preferir" un nodo y recurrir a otro si no está disponible) |
| Selección a nivel de Pod | No (solo etiquetas de nodo) | Sí (puede programar en relación con otros Pods en ejecución mediante Pod Affinity) |
Este artículo forma parte de una serie sobre la programación en Kubernetes
En este artículo:
- ¿Qué es NodeSelector en Kubernetes?
- Cómo funciona NodeSelector en Kubernetes
- Sintaxis de NodeSelector en Kubernetes
- Ejemplos de NodeSelector en Kubernetes
- NodeSelector vs. Node Affinity vs. nodeName en Kubernetes
- Buenas prácticas de NodeSelector en Kubernetes
Cómo funciona NodeSelector en Kubernetes
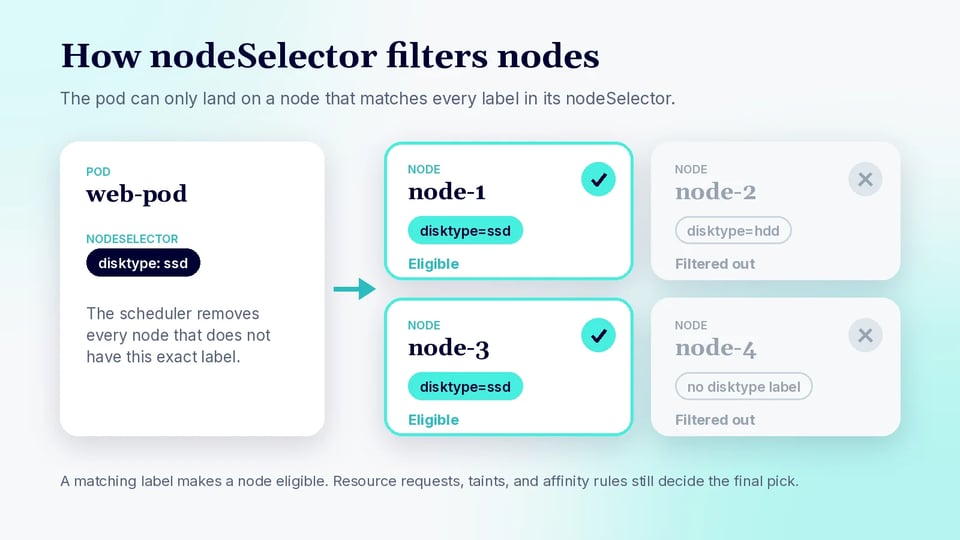
En Kubernetes, nodeSelector funciona comparando las etiquetas definidas en la especificación de un pod con las etiquetas asignadas a los nodos. El scheduler solo considera los nodos que cumplen con cada par clave-valor del nodeSelector del pod. Este mecanismo proporciona un control básico sobre la ubicación de los workloads sin requerir reglas de programación más avanzadas.
1. Etiquetas de nodo
Las etiquetas de nodo son pares clave-valor adjuntos a los nodos de Kubernetes. Describen propiedades del nodo que los workloads pueden usar para la programación, como el tipo de hardware, la configuración de almacenamiento o el rol del workload. Kubernetes también asigna algunas etiquetas estándar de forma automática, incluidas etiquetas de arquitectura, sistema operativo y topología.
Puedes agregar etiquetas personalizadas con kubectl label nodes. Por ejemplo, kubectl label nodes node-1 disktype=ssd asigna la etiqueta disktype=ssd a node-1. Luego, los pods pueden hacer referencia a esta etiqueta mediante nodeSelector.
2. Restricciones de programación del pod
Un pod define nodeSelector dentro de su campo spec. Cada entrada especifica una etiqueta de nodo que debe estar presente con el valor indicado. Por ejemplo, nodeSelector: {disktype: ssd} restringe el pod a los nodos etiquetados con disktype=ssd.
Cuando se especifican varias entradas, el nodo debe coincidir con todas. nodeSelector admite coincidencias exactas clave-valor, no operadores como In, NotIn ni comparaciones numéricas. Para condiciones más complejas, Kubernetes ofrece node affinity.
3. Cómo el scheduler de Kubernetes evalúa nodeSelector
Al programar un pod, el scheduler de Kubernetes primero identifica los nodos elegibles para ejecutarlo. Durante este proceso de filtrado, compara el nodeSelector del pod con las etiquetas de cada nodo candidato. Los nodos que no coinciden con todas las etiquetas solicitadas quedan descartados.
Luego, el scheduler evalúa los nodos restantes con sus demás criterios de programación y selecciona un nodo adecuado. Un nodeSelector coincidente hace que un nodo sea elegible, pero no garantiza su selección, ya que los requisitos de recursos, los taints, las reglas de afinidad y otras restricciones también pueden afectar la ubicación.
4. Qué sucede cuando no hay un nodo que coincida
Si ningún nodo cumple con el nodeSelector del pod y sus demás requisitos de programación, el scheduler no puede asignar el pod a un nodo. El pod permanece en estado Pending en lugar de ubicarse en un nodo que viole la restricción.
Kubernetes sigue intentando programar el pod a medida que cambian las condiciones del clúster. La programación puede completarse más tarde si un nodo coincidente queda disponible, sus etiquetas cambian o se modifican las restricciones del pod. Los eventos del scheduler, visibles con comandos como kubectl describe pod, pueden ayudar a identificar la restricción que impide la ubicación.
Sintaxis de NodeSelector en Kubernetes
El campo nodeSelector se define dentro de spec en una plantilla de pod. Contiene uno o más pares clave-valor de etiquetas de nodo. Un nodo debe coincidir con todos los pares para que el pod sea elegible para programarse en ese nodo.
apiVersion: v1kind: Podmetadata: name: web-podspec: nodeSelector: workload: web containers: - name: nginx image: nginx:latestEn este ejemplo, Kubernetes solo puede programar web-pod en nodos etiquetados con workload=web. Puedes aplicar la etiqueta con:
kubectl label nodes node-1 workload=webSe pueden especificar varias restricciones agregando más entradas:
spec: nodeSelector: workload: web environment: productionAquí, un nodo elegible debe tener tanto workload=web como environment=production. nodeSelector realiza coincidencias exactas de etiquetas; para expresiones como múltiples valores aceptables o reglas de exclusión, usa node affinity.
Ejemplos de NodeSelector en Kubernetes
Programar pods en nodos de alta memoria
Puedes etiquetar los nodos según su tipo de memoria y usar esa etiqueta para ubicar aplicaciones con alto consumo de memoria en nodos adecuados. Por ejemplo, etiqueta un nodo apropiado con node-type=high-memory:
kubectl label nodes worker-2 node-type=high-memoryLuego configura el pod para requerir esa etiqueta:
apiVersion: v1kind: Podmetadata: name: memory-appspec: nodeSelector: node-type: high-memory containers: - name: web-server image: nginx:latestEl scheduler solo considera los nodos con la etiqueta node-type=high-memory al ubicar este pod.
Programar pods en una zona de disponibilidad específica
Kubernetes suele exponer la topología de los nodos mediante la etiqueta topology.kubernetes.io/zone. Puedes usarla para restringir un pod a una zona de disponibilidad determinada:
apiVersion: v1kind: Podmetadata: name: zone-podspec: nodeSelector: topology.kubernetes.io/zone: eu-west-1b containers: - name: app image: nginx:latestEl pod solo puede ejecutarse en nodos cuya etiqueta de zona sea eu-west-1b. Los nombres reales de las zonas dependen del clúster y del proveedor de infraestructura.
Programar workloads según el tipo de nodo
Las etiquetas personalizadas pueden separar los nodos según el workload al que están destinados. Por ejemplo, puedes designar un grupo de nodos para aplicaciones backend:
kubectl label nodes worker-3 role=backendHaz referencia a la misma etiqueta en la especificación del pod:
apiVersion: v1kind: Podmetadata: name: backend-podspec: nodeSelector: role: backend containers: - name: app image: nginxEste enfoque es útil cuando un clúster contiene pools de nodos con diferente hardware, capacidad o propósitos operativos.
Programar workloads de GPU en nodos con GPU
Los workloads de GPU suelen necesitar tanto restricciones de ubicación en nodos como solicitudes de recursos de GPU. Si los nodos con GPU tienen una etiqueta adecuada, nodeSelector puede restringir la programación a esos nodos:
apiVersion: v1kind: Podmetadata: name: gpu-workloadspec: nodeSelector: accelerator: nvidia-gpu containers: - name: inference-app image: example/gpu-app:14.32 resources: limits: nvidia.com/gpu: 1El nodeSelector controla la elegibilidad del nodo, mientras que nvidia.com/gpu: 1 solicita un recurso de GPU al device plugin. El nombre de la etiqueta depende de cada clúster, así que usa una etiqueta que realmente esté configurada en tus nodos con GPU.
NodeSelector vs. Node Affinity vs. nodeName en Kubernetes
Kubernetes ofrece varios mecanismos para controlar qué nodo ejecuta un pod. nodeSelector, node affinity y nodeName pueden influir en la ubicación, pero operan de forma distinta y se adaptan a diferentes requisitos de programación:
- nodeSelector es la opción más simple. Requiere que un nodo tenga exactamente los pares clave-valor de etiquetas especificados por el pod. Funciona bien cuando los workloads tienen requisitos de ubicación sencillos, como ejecutarse solo en nodos SSD o con GPU.
- Node affinity también usa etiquetas de nodo, pero admite reglas más expresivas. Puede coincidir con múltiples valores, usar operadores como In, NotIn, Exists y DoesNotExist, y definir reglas de ubicación tanto obligatorias como preferidas. Úsala cuando la lógica de programación no pueda representarse con coincidencias exactas de etiquetas.
- nodeName funciona de manera diferente porque omite la selección normal de nodos del scheduler. Configurar
spec.nodeNameasigna el pod directamente al nodo indicado. Esto suele ser útil para casos especializados donde el nodo de destino exacto ya se conoce, más que para la programación rutinaria de workloads.
| Característica | nodeSelector | Node Affinity | nodeName |
|---|---|---|---|
| Método de ubicación | Coincide con etiquetas de nodo | Evalúa expresiones basadas en etiquetas | Apunta a un nodo específico |
| Flexibilidad de programación | Baja | Alta | Muy baja |
| Coincidencia exacta de etiquetas | Sí | Sí | No |
| Coincidencia de múltiples valores | No | Sí | No |
| Reglas obligatorias | Sí | Sí | Asignación directa |
| Reglas preferidas | No | Sí | No |
| Usa la selección normal de nodos del scheduler | Sí | Sí | No |
| Ideal para | Ubicación simple basada en etiquetas | Reglas de ubicación complejas o preferidas | Asignar un pod a un nodo conocido |
Buenas prácticas de NodeSelector en Kubernetes
Estas son algunas prácticas útiles a considerar al trabajar con nodeSelector en Kubernetes.
1. Usa convenciones de etiquetado de nodos consistentes
Define un esquema de nombres estándar para las etiquetas que usa nodeSelector. Por ejemplo, etiquetas como workload=compute, storage=ssd y accelerator=gpu describen claramente por qué un workload podría seleccionar un nodo. Para etiquetas específicas de tu organización, usa un prefijo de estilo DNS como example.com/node-pool=gpu.
Mantén las claves y los valores de las etiquetas consistentes entre clústeres y entornos siempre que sea posible. Evita que valores como gpu, GPU y gpu-node representen la misma propiedad. Pequeñas inconsistencias pueden dejar pods en estado Pending, ya que nodeSelector requiere coincidencias exactas.
Las etiquetas también deben describir propiedades relevantes para la programación, no información operativa temporal. Documenta las etiquetas de programación importantes para que los equipos de aplicaciones sepan qué etiquetas están disponibles y qué garantías ofrece cada una.
2. Usa etiquetas estables en lugar de nombres de nodos
Prefiere etiquetas que describan un grupo de nodos o una capacidad, en lugar de vincular los workloads a nodos individuales. Los nodos suelen ser recursos temporales y pueden desaparecer durante el autoescalado, las actualizaciones, el mantenimiento o fallas de infraestructura.
Por ejemplo, node-pool=compute permite que un pod se ejecute en cualquier nodo adecuado de un pool de cómputo. Apuntar directamente a un nodo como worker-03 crea una dependencia de esa máquina y dificulta el reemplazo de nodos.
Siempre que sea posible, configura las etiquetas de nodo como parte del aprovisionamiento del pool de nodos o de la infraestructura. Así, los nodos de reemplazo reciben automáticamente las mismas etiquetas, lo que permite que las reglas de nodeSelector existentes sigan funcionando sin cambios en los manifiestos de los workloads.
3. Combina nodeSelector con requests y limits de recursos
nodeSelector determina si un nodo tiene las etiquetas requeridas, pero no indica si ese nodo tiene suficiente CPU o memoria. Configura requests de recursos junto con las reglas de ubicación para que el scheduler pueda tener en cuenta los recursos que necesita cada pod.
Por ejemplo, un pod podría seleccionar nodos de alta memoria y solicitar 8Gi de memoria. El scheduler solo considera los nodos coincidentes y luego verifica si esos nodos tienen suficiente capacidad asignable para la solicitud. Sin requests adecuados, los workloads pueden competir por recursos incluso cuando se ubican en el tipo de nodo previsto.
Los límites de recursos ofrecen controles adicionales en tiempo de ejecución sobre el consumo de recursos. Usa requests y limits según el comportamiento del workload, en lugar de asumir que seleccionar un nodo más grande o especializado elimina la necesidad de gestionar los recursos.
4. Usa taints y tolerations para nodos dedicados
nodeSelector controla dónde puede ejecutarse un pod en particular, pero no impide que otros pods usen los mismos nodos. Esta distinción es importante cuando los nodos están reservados para workloads que requieren hardware costoso o especializado.
Aplica un taint a los nodos dedicados y agrega una toleration correspondiente a los workloads autorizados a usarlos. Luego usa nodeSelector para asegurar que esos workloads seleccionen activamente el grupo de nodos previsto. Por ejemplo, los nodos con GPU pueden tener un taint para que las aplicaciones comunes no se programen allí, mientras que los workloads de GPU toleran el taint y seleccionan la etiqueta de GPU.
Por lo tanto, los taints, las tolerations y nodeSelector resuelven problemas complementarios. El selector restringe la ubicación del workload, mientras que el taint ayuda a proteger la capacidad de los nodos dedicados frente a workloads que deberían ejecutarse en otro lugar.
5. Usa etiquetas protegidas para aislar nodos por motivos de seguridad
No trates las etiquetas de nodo comunes como una barrera de seguridad sólida. Según la configuración y los permisos del clúster, un nodo comprometido o mal controlado podría llegar a influir en las etiquetas que determinan dónde se ejecutan los workloads sensibles.
Cuando el aislamiento es crítico para la seguridad, Kubernetes puede usar el plugin de admisión NodeRestriction junto con el autorizador Node. NodeRestriction impide que los kubelets establezcan o modifiquen etiquetas con el prefijo reservado node-restriction.kubernetes.io/ y nombres calificados cuyo prefijo termina en .node-restriction.kubernetes.io.
Un administrador puede entonces aplicar una etiqueta como example.com.node-restriction.kubernetes.io/pci-dss=true y hacer referencia a ella desde las reglas de programación. Como el kubelet no puede asignarse esa etiqueta protegida a sí mismo, esto ofrece una base más sólida para aislar workloads que solo deben ejecutarse en nodos designados por el administrador.
Preguntas frecuentes
¿Qué es nodeSelector en Kubernetes? nodeSelector es la forma recomendada más simple de restringir un Pod a nodos con etiquetas específicas. Es un filtro estricto para el kube-scheduler. Si un nodo no coincide con todas las etiquetas del nodeSelector, el Pod no se ubica allí.
¿Cómo se usa nodeSelector? Primero etiqueta el nodo de destino con kubectl label nodes, por ejemplo kubectl label nodes node-1 disktype=ssd. Luego agrega un nodeSelector en el spec del Pod con la misma clave y valor, como disktype: ssd. El scheduler solo considerará los nodos que coincidan.
¿Qué pasa si ningún nodo coincide con el nodeSelector? El Pod permanece en estado Pending en lugar de ubicarse en un nodo que incumpla la restricción. Kubernetes sigue intentando a medida que cambian las condiciones, por lo que la programación puede completarse más tarde si aparece un nodo que coincida, cambian las etiquetas del nodo o se editan las restricciones del Pod. Ejecutar kubectl describe pod muestra los eventos del scheduler que explican el motivo.
¿Cuál es la diferencia entre nodeSelector y node affinity? nodeSelector solo admite coincidencias exactas clave-valor y reglas estrictas. Node affinity admite operadores como In, NotIn, Exists, DoesNotExist, Gt y Lt, y puede expresar ubicaciones tanto obligatorias como preferidas. Usa node affinity cuando las coincidencias exactas de etiquetas no sean suficientes.
¿Cuál es la diferencia entre nodeSelector y nodeName? nodeSelector sigue pasando por el scheduler, que filtra los nodos por etiqueta y luego elige uno. Configurar nodeName omite la selección normal de nodos del scheduler y asigna el Pod directamente al nodo indicado, lo cual es útil sobre todo en casos especializados donde el nodo de destino ya se conoce.
¿nodeSelector impide que otros pods usen los mismos nodos? No. nodeSelector controla dónde puede ejecutarse un Pod en particular, pero no reserva el nodo. Para mantener los workloads comunes fuera de los nodos dedicados, aplica un taint a esos nodos y agrega una toleration correspondiente a los workloads que sí pueden usarlos.
Optimiza la ubicación y el uso de los nodos de Kubernetes con PerfectScale
PerfectScale es una plataforma de optimización de Kubernetes que se despliega con un solo comando de Helm y ofrece información accionable y optimización autónoma en todo tu stack de K8s. Mientras nodeSelector controla dónde pueden ejecutarse los workloads, PerfectScale te ayuda a asegurar que esos workloads estén correctamente dimensionados y que los nodos donde se ubican sean los adecuados, para que puedas reducir la capacidad desaprovechada sin afectar el rendimiento ni la confiabilidad.
Capacidades clave de PerfectScale:
- Right-sizing autónomo de workloads: Podfit ofrece una vista granular de la salud y los costos del clúster, identifica rápidamente recursos desaprovechados y problemas de resiliencia, y propone recomendaciones basadas en datos o automatización para ajustar el tamaño de los workloads de inmediato.
- Visibilidad del uso de los nodos: Infrafit ofrece visibilidad completa del uso de los nodos, ayudándote a identificar y eliminar la capacidad ociosa de los nodos mientras mantienes el rendimiento y la confiabilidad del clúster al máximo nivel.
- Selección de nodos basada en datos: Recibe recomendaciones que te ayudan a elegir los nodos adecuados para tus workloads, para tomar mejores decisiones sobre los grupos de nodos a los que apuntan tus etiquetas de programación.
- Optimización del autoescalador de nodos: Maximiza la efectividad de autoescaladores de nodos como Karpenter, con integraciones para HPA, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning, Google Autopilot y más.
- Alertas priorizadas en tiempo real: Atiende primero los riesgos de resiliencia y los picos de costos de mayor impacto con alertas priorizadas automáticamente en Slack, Datadog, MS Teams, PagerDuty y otras herramientas.
- Gobernanza y pronósticos: El reporte de Trends ofrece visibilidad de las métricas de costo, pérdida y riesgo a lo largo del tiempo en clústeres, grupos de nodos, namespaces y workloads, facilitando una planificación presupuestaria precisa y el análisis de causa raíz.
- Compatibilidad con cualquier entorno: Optimiza clústeres en nubes públicas como EKS, GKE y AKS, nubes privadas como OpenShift, entornos on-premises e híbridos.
¿Todo listo para optimizar tus nodos y workloads de Kubernetes? Conoce más sobre la plataforma PerfectScale.