


Was ist Kubernetes NodeSelector?
In Kubernetes ist nodeSelector die einfachste empfohlene Methode, um einen Pod so einzuschränken, dass er nur auf Nodes mit bestimmten Labels eingeplant wird. Er wirkt als harter Filter für den kube-scheduler: Stimmt ein Node nicht mit jedem einzelnen im nodeSelector definierten Label überein, wird der Pod dort nicht platziert.
So funktioniert es:
- Ziel-Nodes labeln: Weisen Sie Nodes Key-Value-Labels zu – basierend auf Eigenschaften wie Speichertyp, Hardware, Architektur oder Workload-Rolle.
- Pod-Constraint definieren: Fügen Sie unter der spec des Pods einen nodeSelector mit den für das Scheduling erforderlichen Labels hinzu.
- Alle angegebenen Labels abgleichen: Der Scheduler berücksichtigt nur Nodes, die mit jedem im nodeSelector definierten Key-Value-Paar übereinstimmen.
- Weitere Scheduling-Anforderungen prüfen: Passende Nodes müssen weiterhin Ressourcenanforderungen, Taints, Affinity-Regeln und andere Scheduling-Constraints erfüllen.
- Nicht platzierbare Pods bleiben Pending: Findet sich kein passender Node, bleibt der Pod im Status Pending, bis sich die Clusterbedingungen oder die Scheduling-Constraints ändern.
nodeSelector vs. Node Affinity: Während sich nodeSelector hervorragend für einfache Deployments eignet, erfordern komplexere Scheduling-Anforderungen in der Regel Node Affinity.
| Merkmal | nodeSelector | Node Affinity |
|---|---|---|
| Komplexität | Einfach und leichtgewichtig | Komplexere Konfiguration |
| Matching-Logik | Nur exakte Key-Value-Übereinstimmungen | Unterstützt ausdrucksstarke Operatoren (In, NotIn, Exists, Gt, Lt) |
| Regel-Flexibilität | Nur harte Regeln (muss übereinstimmen, sonst bleibt der Pod Pending) | Harte und weiche Regeln (kann einen Node "bevorzugen", weicht aber auf andere aus, wenn er nicht verfügbar ist) |
| Pod-Level-Targeting | Nein (nur Node-Labels) | Ja (kann über Pod Affinity relativ zu anderen laufenden Pods einplanen) |
Dieser Artikel ist Teil einer Serie über Kubernetes-Scheduling
In diesem Artikel:
- Was ist Kubernetes NodeSelector?
- So funktioniert Kubernetes NodeSelector
- Kubernetes NodeSelector: Syntax
- Kubernetes NodeSelector: Beispiele
- Kubernetes NodeSelector vs. Node Affinity vs. nodeName
- Best Practices für Kubernetes NodeSelector
So funktioniert Kubernetes NodeSelector
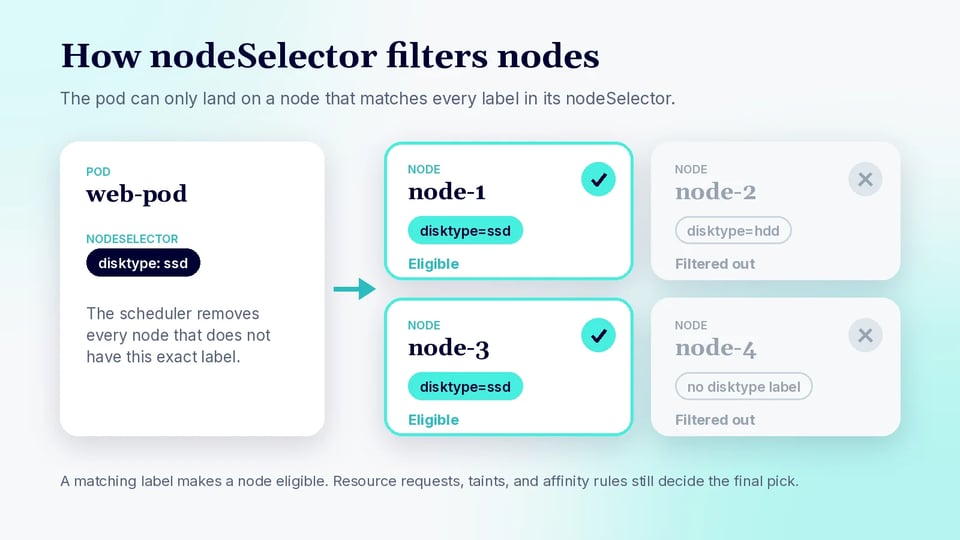
Kubernetes nodeSelector gleicht die in einer Pod-Spezifikation definierten Labels mit den Labels der Nodes ab. Der Scheduler berücksichtigt nur Nodes, die jedes Key-Value-Paar im nodeSelector des Pods erfüllen. Dieser Mechanismus bietet grundlegende Kontrolle über die Platzierung von Workloads, ohne dass komplexere Scheduling-Regeln nötig sind.
1. Node-Labels
Node-Labels sind Key-Value-Paare, die an Kubernetes-Nodes angehängt werden. Sie beschreiben Node-Eigenschaften, die Workloads für das Scheduling nutzen können, etwa Hardwaretyp, Speicherkonfiguration oder Workload-Rolle. Kubernetes vergibt zudem einige Standard-Labels automatisch, darunter Labels für Architektur, Betriebssystem und Topologie.
Eigene Labels fügen Sie mit kubectl label nodes hinzu. Beispielsweise weist kubectl label nodes node-1 disktype=ssd node-1 das Label disktype=ssd zu. Pods können dieses Label anschließend über nodeSelector referenzieren.
2. Scheduling-Constraints des Pods
Ein Pod definiert nodeSelector unter seinem spec-Feld. Jeder Eintrag gibt ein Node-Label an, das mit dem angegebenen Wert vorhanden sein muss. nodeSelector: {disktype: ssd} beschränkt den Pod beispielsweise auf Nodes mit dem Label disktype=ssd.
Sind mehrere Einträge angegeben, muss ein Node alle erfüllen. nodeSelector unterstützt ausschließlich exakte Key-Value-Übereinstimmungen, keine Operatoren wie In, NotIn oder numerische Vergleiche. Für komplexere Bedingungen bietet Kubernetes Node Affinity.
3. Wie der Kubernetes-Scheduler nodeSelector auswertet
Beim Einplanen eines Pods ermittelt der Kubernetes-Scheduler zunächst die Nodes, die für dessen Ausführung infrage kommen. Während dieses Filterprozesses prüft er den nodeSelector des Pods gegen die Labels jedes Kandidaten-Nodes. Nodes, die nicht mit jedem angeforderten Label übereinstimmen, werden aussortiert.
Anschließend bewertet der Scheduler die verbleibenden Nodes anhand seiner übrigen Scheduling-Kriterien und wählt einen geeigneten Node aus. Ein passender nodeSelector macht einen Node zwar wählbar, garantiert aber keine Auswahl, da auch Ressourcenanforderungen, Taints, Affinity-Regeln und andere Constraints die Platzierung beeinflussen können.
4. Was passiert, wenn kein passender Node verfügbar ist
Erfüllt kein Node den nodeSelector des Pods und dessen übrige Scheduling-Anforderungen, kann der Scheduler den Pod keinem Node zuweisen. Der Pod bleibt im Status Pending, statt auf einem Node platziert zu werden, der den Constraint verletzt.
Kubernetes versucht weiterhin, den Pod einzuplanen, sobald sich die Clusterbedingungen ändern. Das Scheduling kann später gelingen, wenn ein passender Node verfügbar wird, sich dessen Labels ändern oder die Constraints des Pods angepasst werden. Scheduler-Events, sichtbar etwa über kubectl describe pod, helfen dabei, den Constraint zu identifizieren, der die Platzierung verhindert.
Kubernetes NodeSelector: Syntax
Das nodeSelector-Feld wird in einem Pod-Template unter spec definiert. Es enthält ein oder mehrere Key-Value-Paare von Node-Labels. Ein Node muss mit jedem Paar übereinstimmen, damit der Pod dort eingeplant werden kann.
apiVersion: v1kind: Podmetadata: name: web-podspec: nodeSelector: workload: web containers: - name: nginx image: nginx:latestIn diesem Beispiel kann Kubernetes web-pod nur auf Nodes mit dem Label workload=web einplanen. Das Label setzen Sie mit:
kubectl label nodes node-1 workload=webMehrere Constraints lassen sich durch zusätzliche Einträge angeben:
spec: nodeSelector: workload: web environment: productionHier muss ein infrage kommender Node sowohl workload=web als auch environment=production besitzen. nodeSelector führt exaktes Label-Matching durch; für Ausdrücke wie mehrere zulässige Werte oder Ausschlussregeln verwenden Sie stattdessen Node Affinity.
Kubernetes NodeSelector: Beispiele
Pods auf Nodes mit viel Arbeitsspeicher einplanen
Sie können Nodes nach ihrem Speichertyp labeln und dieses Label nutzen, um speicherintensive Anwendungen auf geeigneten Nodes zu platzieren. Labeln Sie beispielsweise einen passenden Node mit node-type=high-memory:
kubectl label nodes worker-2 node-type=high-memoryKonfigurieren Sie anschließend den Pod so, dass er dieses Label verlangt:
apiVersion: v1kind: Podmetadata: name: memory-appspec: nodeSelector: node-type: high-memory containers: - name: web-server image: nginx:latestDer Scheduler berücksichtigt bei der Platzierung dieses Pods nur Nodes mit dem Label node-type=high-memory.
Pods in einer bestimmten Availability Zone einplanen
Kubernetes stellt die Node-Topologie üblicherweise über das Label topology.kubernetes.io/zone bereit. Damit können Sie einen Pod auf eine bestimmte Availability Zone beschränken:
apiVersion: v1kind: Podmetadata: name: zone-podspec: nodeSelector: topology.kubernetes.io/zone: eu-west-1b containers: - name: app image: nginx:latestDer Pod kann nur auf Nodes laufen, deren Zone-Label eu-west-1b ist. Die tatsächlichen Zonennamen hängen vom Cluster und vom Infrastrukturanbieter ab.
Workloads nach Node-Typ einplanen
Mit eigenen Labels lassen sich Nodes nach ihrem Verwendungszweck trennen. Beispielsweise können Sie eine Gruppe von Nodes für Backend-Anwendungen vorsehen:
kubectl label nodes worker-3 role=backendReferenzieren Sie dasselbe Label in der Pod-Spezifikation:
apiVersion: v1kind: Podmetadata: name: backend-podspec: nodeSelector: role: backend containers: - name: app image: nginxDieser Ansatz ist nützlich, wenn ein Cluster Node-Pools mit unterschiedlicher Hardware, Kapazität oder unterschiedlichem Einsatzzweck enthält.
GPU-Workloads auf GPU-Nodes einplanen
GPU-Workloads benötigen in der Regel sowohl Platzierungs-Constraints als auch GPU-Ressourcenanforderungen. Tragen GPU-Nodes ein passendes Label, kann nodeSelector das Scheduling auf diese Nodes beschränken:
apiVersion: v1kind: Podmetadata: name: gpu-workloadspec: nodeSelector: accelerator: nvidia-gpu containers: - name: inference-app image: example/gpu-app:14.32 resources: limits: nvidia.com/gpu: 1Der nodeSelector steuert, welche Nodes infrage kommen, während nvidia.com/gpu: 1 eine GPU-Ressource vom Device-Plugin anfordert. Der Label-Name ist clusterspezifisch – verwenden Sie daher ein Label, das auf Ihren GPU-Nodes tatsächlich konfiguriert ist.
Kubernetes NodeSelector vs. Node Affinity vs. nodeName
Kubernetes bietet mehrere Mechanismen, um zu steuern, auf welchem Node ein Pod läuft. nodeSelector, Node Affinity und nodeName können die Platzierung beeinflussen, funktionieren aber unterschiedlich und eignen sich für unterschiedliche Scheduling-Anforderungen:
- nodeSelector ist die einfachste Option. Sie verlangt, dass ein Node exakt die vom Pod angegebenen Label-Key-Value-Paare besitzt. Das funktioniert gut, wenn Workloads einfache Platzierungsanforderungen haben, etwa nur auf SSD- oder GPU-Nodes zu laufen.
- Node Affinity nutzt ebenfalls Node-Labels, unterstützt aber ausdrucksstärkere Regeln. Sie kann mehrere Werte abgleichen, Operatoren wie In, NotIn, Exists und DoesNotExist verwenden sowie verpflichtende und bevorzugte Platzierungsregeln definieren. Verwenden Sie sie, wenn sich die Scheduling-Logik nicht mit exakten Label-Übereinstimmungen abbilden lässt.
- nodeName funktioniert anders, da es die normale Node-Auswahl des Schedulers umgeht. Das Setzen von
spec.nodeNameweist den Pod direkt dem benannten Node zu. Das ist vor allem für Spezialfälle nützlich, in denen der Ziel-Node bereits bekannt ist, nicht für das routinemäßige Workload-Scheduling.
| Merkmal | nodeSelector | Node Affinity | nodeName |
|---|---|---|---|
| Platzierungsmethode | Gleicht Node-Labels ab | Wertet Label-basierte Ausdrücke aus | Zielt auf einen bestimmten Node |
| Scheduling-Flexibilität | Gering | Hoch | Sehr gering |
| Exaktes Label-Matching | Ja | Ja | Nein |
| Abgleich mehrerer Werte | Nein | Ja | Nein |
| Verpflichtende Regeln | Ja | Ja | Direkte Zuweisung |
| Bevorzugte Regeln | Nein | Ja | Nein |
| Nutzt normale Node-Auswahl des Schedulers | Ja | Ja | Nein |
| Am besten geeignet für | Einfache Label-basierte Platzierung | Komplexe oder bevorzugte Platzierungsregeln | Zuweisung eines Pods zu einem bekannten Node |
Best Practices für Kubernetes NodeSelector
Hier einige bewährte Vorgehensweisen für die Arbeit mit nodeSelector in Kubernetes.
1. Einheitliche Konventionen für Node-Labels verwenden
Definieren Sie ein einheitliches Benennungsschema für Labels, die von nodeSelector genutzt werden. Labels wie workload=compute, storage=ssd und accelerator=gpu beschreiben beispielsweise klar, warum ein Workload einen Node auswählen könnte. Für organisationsspezifische Labels verwenden Sie ein DNS-artiges Präfix wie example.com/node-pool=gpu.
Halten Sie Label-Keys und -Werte nach Möglichkeit über Cluster und Umgebungen hinweg konsistent. Vermeiden Sie, dass Werte wie gpu, GPU und gpu-node dieselbe Eigenschaft beschreiben. Schon kleine Inkonsistenzen können Pods im Status Pending festhalten, da nodeSelector exakte Übereinstimmungen verlangt.
Labels sollten zudem Eigenschaften beschreiben, die für das Scheduling relevant sind, und keine temporären Betriebsinformationen. Dokumentieren Sie wichtige Scheduling-Labels, damit Anwendungsteams wissen, welche Labels verfügbar sind und welche Garantien jedes Label bietet.
2. Stabile Labels statt Node-Namen verwenden
Bevorzugen Sie Labels, die eine Node-Gruppe oder eine Fähigkeit beschreiben, statt Workloads an einzelne Nodes zu binden. Nodes sind oft temporäre Ressourcen und können durch Autoscaling, Upgrades, Wartung oder Infrastrukturausfälle verschwinden.
node-pool=compute erlaubt es einem Pod beispielsweise, auf jedem geeigneten Node eines Compute-Pools zu laufen. Das direkte Ansteuern eines Nodes wie worker-03 schafft eine Abhängigkeit von dieser Maschine und erschwert den Node-Austausch.
Konfigurieren Sie Node-Labels nach Möglichkeit als Teil des Node-Pool- oder Infrastruktur-Provisionings. Ersatz-Nodes erhalten dann automatisch dieselben Labels, sodass bestehende nodeSelector-Regeln ohne Änderungen an den Workload-Manifesten weiter funktionieren.
3. nodeSelector mit Resource Requests und Limits kombinieren
nodeSelector prüft, ob ein Node die erforderlichen Labels besitzt, sagt aber nichts darüber aus, ob dieser Node genügend CPU oder Arbeitsspeicher hat. Konfigurieren Sie Resource Requests zusätzlich zu den Platzierungsregeln, damit der Scheduler die von jedem Pod benötigten Ressourcen berücksichtigen kann.
Ein Pod könnte beispielsweise High-Memory-Nodes auswählen und gleichzeitig 8Gi Arbeitsspeicher anfordern. Der Scheduler berücksichtigt nur passende Nodes und prüft anschließend, ob diese genügend zuweisbare Kapazität für die Anforderung haben. Ohne passende Requests können Workloads um Ressourcen konkurrieren, selbst wenn sie auf dem vorgesehenen Node-Typ platziert sind.
Resource Limits bieten zusätzliche Laufzeitkontrollen für den Ressourcenverbrauch. Setzen Sie Requests und Limits entsprechend dem Verhalten des Workloads, statt anzunehmen, dass die Auswahl eines größeren oder spezialisierten Nodes das Ressourcenmanagement überflüssig macht.
4. Taints und Tolerations für dedizierte Nodes nutzen
nodeSelector steuert, wo ein bestimmter Pod laufen darf, hindert andere Pods aber nicht daran, dieselben Nodes zu nutzen. Dieser Unterschied ist wichtig, wenn Nodes für Workloads reserviert sind, die teure oder spezialisierte Hardware benötigen.
Versehen Sie dedizierte Nodes mit einem Taint und fügen Sie den Workloads, die sie nutzen dürfen, eine entsprechende Toleration hinzu. Nutzen Sie dann nodeSelector, damit diese Workloads die vorgesehene Node-Gruppe aktiv auswählen. GPU-Nodes können beispielsweise mit einem Taint versehen werden, damit gewöhnliche Anwendungen dort nicht eingeplant werden, während GPU-Workloads den Taint tolerieren und das GPU-Label auswählen.
Taints, Tolerations und nodeSelector lösen somit komplementäre Probleme. Der Selector beschränkt die Platzierung des Workloads, während der Taint die Kapazität dedizierter Nodes vor Workloads schützt, die woanders laufen sollten.
5. Geschützte Labels für sicherheitskritische Node-Isolation verwenden
Betrachten Sie gewöhnliche Node-Labels nicht als starke Sicherheitsgrenze. Je nach Clusterkonfiguration und Berechtigungen könnte ein kompromittierter oder unzureichend kontrollierter Node Labels beeinflussen, die darüber entscheiden, wo sensible Workloads laufen.
Für sicherheitskritische Isolation kann Kubernetes das NodeRestriction-Admission-Plugin zusammen mit dem Node-Authorizer verwenden. NodeRestriction verhindert, dass Kubelets Labels mit dem reservierten Präfix node-restriction.kubernetes.io/ sowie qualifizierte Namen, deren Präfix auf .node-restriction.kubernetes.io endet, setzen oder ändern.
Ein Administrator kann daher ein Label wie example.com.node-restriction.kubernetes.io/pci-dss=true setzen und in Scheduling-Regeln referenzieren. Da das Kubelet sich dieses geschützte Label nicht selbst zuweisen kann, bildet es eine stärkere Grundlage für die Isolation von Workloads, die nur auf vom Administrator bestimmten Nodes laufen dürfen.
FAQ
Was ist nodeSelector in Kubernetes? nodeSelector ist die einfachste empfohlene Methode, um einen Pod auf Nodes mit bestimmten Labels zu beschränken. Er ist ein harter Filter für den kube-scheduler. Stimmt ein Node nicht mit jedem Label im nodeSelector überein, wird der Pod dort nicht platziert.
Wie verwende ich nodeSelector? Labeln Sie zunächst den Ziel-Node mit kubectl label nodes, zum Beispiel kubectl label nodes node-1 disktype=ssd. Fügen Sie dann unter der spec des Pods einen nodeSelector mit demselben Key und Wert hinzu, etwa disktype: ssd. Der Scheduler berücksichtigt nur übereinstimmende Nodes.
Was passiert, wenn kein Node mit dem nodeSelector übereinstimmt? Der Pod bleibt im Status Pending, statt auf einem Node platziert zu werden, der den Constraint verletzt. Kubernetes versucht es weiter, sobald sich die Bedingungen ändern – das Scheduling kann also später gelingen, wenn ein passender Node erscheint, sich Node-Labels ändern oder die Constraints des Pods angepasst werden. kubectl describe pod zeigt die Scheduler-Events, die den Grund erklären.
Was ist der Unterschied zwischen nodeSelector und Node Affinity? nodeSelector unterstützt nur exakte Key-Value-Übereinstimmungen und harte Regeln. Node Affinity unterstützt Operatoren wie In, NotIn, Exists, DoesNotExist, Gt und Lt und kann sowohl verpflichtende als auch bevorzugte Platzierung ausdrücken. Verwenden Sie Node Affinity, wenn exakte Label-Übereinstimmungen nicht ausreichen.
Was ist der Unterschied zwischen nodeSelector und nodeName? nodeSelector durchläuft weiterhin den Scheduler, der Nodes nach Labels filtert und dann einen auswählt. Das Setzen von nodeName umgeht die normale Node-Auswahl des Schedulers und weist den Pod direkt dem benannten Node zu – das ist vor allem für Spezialfälle nützlich, in denen der Ziel-Node bereits bekannt ist.
Verhindert nodeSelector, dass andere Pods dieselben Nodes nutzen? Nein. nodeSelector steuert, wo ein bestimmter Pod laufen darf, reserviert den Node aber nicht. Um gewöhnliche Workloads von dedizierten Nodes fernzuhalten, versehen Sie diese Nodes mit einem Taint und fügen den zugelassenen Workloads eine passende Toleration hinzu.
Node-Platzierung und -Auslastung in Kubernetes mit PerfectScale optimieren
PerfectScale ist eine Kubernetes-Optimierungsplattform, die sich mit einem einzigen Helm-Befehl bereitstellen lässt und umsetzbare Erkenntnisse sowie autonome Optimierung über Ihren gesamten K8s-Stack liefert. Während nodeSelector steuert, wo Workloads laufen dürfen, sorgt PerfectScale dafür, dass diese Workloads richtig dimensioniert sind und auf den passenden Nodes landen – so reduzieren Sie ungenutzte Kapazität, ohne Performance oder Zuverlässigkeit zu beeinträchtigen.
Zentrale Funktionen von PerfectScale:
- Autonomes Right-Sizing von Workloads: Podfit bietet eine granulare Sicht auf Clusterzustand und -kosten, identifiziert schnell verschwendete Ressourcen und Resilienzprobleme und liefert datenbasierte Empfehlungen oder Automatisierung, um Workloads sofort richtig zu dimensionieren.
- Transparenz über die Node-Auslastung: Infrafit bietet umfassende Einblicke in die Node-Auslastung und hilft Ihnen, ungenutzte Node-Kapazität zu erkennen und zu eliminieren – bei gleichbleibend hoher Clusterperformance und Zuverlässigkeit.
- Datenbasierte Node-Auswahl: Erhalten Sie Empfehlungen für die richtigen Nodes für Ihre Workloads und treffen Sie fundiertere Entscheidungen über die Node-Gruppen, auf die Ihre Scheduling-Labels abzielen.
- Optimierung von Node-Autoscalern: Maximieren Sie die Wirksamkeit von Node-Autoscalern wie Karpenter – mit Integrationen für HPA, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning, Google Autopilot und mehr.
- Priorisierte Echtzeit-Alerts: Gehen Sie die folgenschwersten Resilienzrisiken und Kostenspitzen zuerst an – mit automatisch priorisierten Alerts in Slack, Datadog, MS Teams, PagerDuty und anderen Tools.
- Governance und Prognosen: Der Trends-Report macht Kosten-, Waste- und Risikometriken im Zeitverlauf über Cluster, Node-Gruppen, Namespaces und Workloads hinweg sichtbar und unterstützt präzise Budgetplanung sowie Root-Cause-Analysen.
- Unterstützung für jede Umgebung: Optimieren Sie Cluster in Public Clouds wie EKS, GKE und AKS, in Private Clouds wie OpenShift, On-Premises und in hybriden Setups.
Bereit, Ihre Kubernetes-Nodes und -Workloads zu optimieren? Erfahren Sie mehr über die PerfectScale-Plattform.