


Qu'est-ce que NodeSelector dans Kubernetes ?
Dans Kubernetes, nodeSelector est la méthode recommandée la plus simple pour contraindre un Pod à être planifié uniquement sur des nœuds portant des labels spécifiques. Il agit comme un filtre strict pour le kube-scheduler : si un nœud ne correspond pas à chacun des labels définis dans le nodeSelector, le Pod n'y sera pas placé.
Fonctionnement :
- Appliquez des labels aux nœuds cibles : attribuez des labels clé-valeur aux nœuds selon leurs propriétés, comme le type de stockage, le matériel, l'architecture ou le rôle du workload.
- Définissez la contrainte du pod : ajoutez un nodeSelector dans la spec du pod avec les labels requis pour la planification.
- Faites correspondre tous les labels spécifiés : le scheduler ne prend en compte que les nœuds correspondant à chaque paire clé-valeur définie dans le nodeSelector.
- Évaluez les autres exigences de planification : les nœuds correspondants doivent aussi satisfaire les besoins en ressources, les taints, les règles d'affinité et les autres contraintes de planification.
- Laissez en attente les pods sans correspondance : si aucun nœud éligible ne correspond, le pod reste à l'état Pending jusqu'à ce que les conditions du cluster ou les contraintes de planification évoluent.
nodeSelector et node affinity : Si nodeSelector est parfait pour les déploiements simples, les besoins de planification plus complexes nécessitent généralement Node Affinity.
| Fonctionnalité | nodeSelector | Node Affinity |
|---|---|---|
| Complexité | Simple et léger | Configuration plus complexe |
| Logique de correspondance | Correspondances exactes clé-valeur uniquement | Prend en charge des opérateurs expressifs (In, NotIn, Exists, Gt, Lt) |
| Flexibilité des règles | Règles strictes uniquement (correspondance obligatoire, sinon le Pod reste Pending) | Règles strictes et souples (peut privilégier un nœud et se rabattre sur un autre si indisponible) |
| Ciblage au niveau du Pod | Non (labels de nœuds uniquement) | Oui (placement possible par rapport à d'autres Pods en cours d'exécution via Pod Affinity) |
Cet article fait partie d'une série consacrée à la planification Kubernetes
Dans cet article :
- Qu'est-ce que NodeSelector dans Kubernetes ?
- Fonctionnement de NodeSelector dans Kubernetes
- Syntaxe de NodeSelector dans Kubernetes
- Exemples d'utilisation de NodeSelector
- NodeSelector, Node Affinity et nodeName : quelles différences ?
- Bonnes pratiques pour NodeSelector dans Kubernetes
Fonctionnement de NodeSelector dans Kubernetes
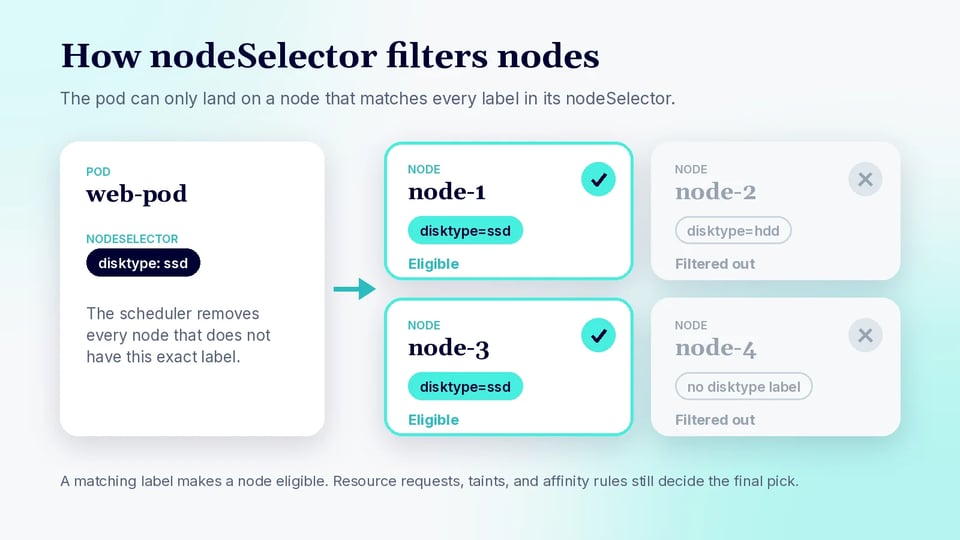
Dans Kubernetes, nodeSelector fonctionne en faisant correspondre les labels définis dans la spécification d'un pod avec ceux attribués aux nœuds. Le scheduler ne prend en compte que les nœuds satisfaisant chaque paire clé-valeur du nodeSelector du pod. Ce mécanisme offre un contrôle de base sur le placement des workloads, sans nécessiter de règles de planification plus avancées.
1. Les labels de nœuds
Les labels de nœuds sont des paires clé-valeur attachées aux nœuds Kubernetes. Ils décrivent des propriétés que les workloads peuvent exploiter pour la planification, comme le type de matériel, la configuration du stockage ou le rôle du workload. Kubernetes attribue aussi automatiquement certains labels standard, notamment pour l'architecture, le système d'exploitation et la topologie.
Vous pouvez ajouter des labels personnalisés avec kubectl label nodes. Par exemple, kubectl label nodes node-1 disktype=ssd attribue le label disktype=ssd à node-1. Les pods peuvent ensuite référencer ce label via nodeSelector.
2. Les contraintes de planification des pods
Un pod définit nodeSelector dans son champ spec. Chaque entrée spécifie un label de nœud qui doit être présent avec la valeur indiquée. Par exemple, nodeSelector: {disktype: ssd} restreint le pod aux nœuds portant le label disktype=ssd.
Lorsque plusieurs entrées sont spécifiées, un nœud doit correspondre à toutes. nodeSelector effectue une correspondance exacte clé-valeur, sans opérateurs tels que In ou NotIn ni comparaisons numériques. Pour des conditions plus complexes, Kubernetes propose la node affinity.
3. Comment le scheduler Kubernetes évalue nodeSelector
Lors de la planification d'un pod, le scheduler Kubernetes identifie d'abord les nœuds éligibles pour l'exécuter. Durant ce filtrage, il compare le nodeSelector du pod aux labels de chaque nœud candidat. Les nœuds qui ne correspondent pas à chacun des labels demandés sont écartés.
Le scheduler évalue ensuite les nœuds restants selon ses autres critères de planification et sélectionne un nœud adapté. Un nodeSelector correspondant rend un nœud éligible, mais ne garantit pas sa sélection, car les besoins en ressources, les taints, les règles d'affinité et d'autres contraintes peuvent aussi influencer le placement.
4. Que se passe-t-il si aucun nœud correspondant n'est disponible
Si aucun nœud ne satisfait le nodeSelector du pod ainsi que ses autres exigences de planification, le scheduler ne peut pas affecter le pod à un nœud. Le pod reste à l'état Pending plutôt que d'être placé sur un nœud qui enfreindrait la contrainte.
Kubernetes continue de tenter de planifier le pod à mesure que les conditions du cluster évoluent. La planification peut aboutir plus tard si un nœud correspondant devient disponible, si ses labels changent ou si les contraintes du pod sont modifiées. Les événements du scheduler, visibles avec des commandes comme kubectl describe pod, aident à identifier la contrainte qui bloque le placement.
Syntaxe de NodeSelector dans Kubernetes
Le champ nodeSelector se définit sous spec dans un template de pod. Il contient une ou plusieurs paires clé-valeur de labels de nœuds. Un nœud doit correspondre à chaque paire pour que le pod soit éligible à la planification sur ce nœud.
apiVersion: v1kind: Podmetadata: name: web-podspec: nodeSelector: workload: web containers: - name: nginx image: nginx:latestDans cet exemple, Kubernetes ne peut planifier web-pod que sur les nœuds portant le label workload=web. Vous pouvez appliquer le label avec :
kubectl label nodes node-1 workload=webPlusieurs contraintes peuvent être spécifiées en ajoutant d'autres entrées :
spec: nodeSelector: workload: web environment: productionIci, un nœud éligible doit porter à la fois workload=web et environment=production. nodeSelector effectue une correspondance exacte de labels ; pour des expressions telles que plusieurs valeurs acceptables ou des règles d'exclusion, utilisez plutôt node affinity.
Exemples d'utilisation de NodeSelector
Planifier des pods sur des nœuds à forte capacité mémoire
Vous pouvez labelliser les nœuds selon leur type de mémoire et utiliser ce label pour placer les applications gourmandes en mémoire sur des nœuds adaptés. Par exemple, appliquez le label node-type=high-memory à un nœud approprié :
kubectl label nodes worker-2 node-type=high-memoryConfigurez ensuite le pod pour exiger ce label :
apiVersion: v1kind: Podmetadata: name: memory-appspec: nodeSelector: node-type: high-memory containers: - name: web-server image: nginx:latestLe scheduler ne prend en compte que les nœuds portant le label node-type=high-memory pour placer ce pod.
Planifier des pods dans une zone de disponibilité spécifique
Kubernetes expose généralement la topologie des nœuds via le label topology.kubernetes.io/zone. Vous pouvez l'utiliser pour contraindre un pod à une zone de disponibilité donnée :
apiVersion: v1kind: Podmetadata: name: zone-podspec: nodeSelector: topology.kubernetes.io/zone: eu-west-1b containers: - name: app image: nginx:latestLe pod ne peut s'exécuter que sur les nœuds dont le label de zone est eu-west-1b. Les noms de zones réels dépendent du cluster et du fournisseur d'infrastructure.
Planifier les workloads par type de nœud
Des labels personnalisés peuvent séparer les nœuds selon le workload auquel ils sont destinés. Par exemple, vous pouvez désigner un groupe de nœuds pour les applications backend :
kubectl label nodes worker-3 role=backendRéférencez le même label dans la spécification du pod :
apiVersion: v1kind: Podmetadata: name: backend-podspec: nodeSelector: role: backend containers: - name: app image: nginxCette approche est utile lorsqu'un cluster contient des pools de nœuds aux caractéristiques matérielles, aux capacités ou aux finalités opérationnelles différentes.
Planifier des workloads GPU sur des nœuds GPU
Les workloads GPU nécessitent généralement à la fois des contraintes de placement et des requêtes de ressources GPU. Si les nœuds GPU portent un label adapté, nodeSelector peut restreindre la planification à ces nœuds :
apiVersion: v1kind: Podmetadata: name: gpu-workloadspec: nodeSelector: accelerator: nvidia-gpu containers: - name: inference-app image: example/gpu-app:14.32 resources: limits: nvidia.com/gpu: 1Le nodeSelector contrôle l'éligibilité des nœuds, tandis que nvidia.com/gpu: 1 demande une ressource GPU au device plugin. Le nom du label est propre à chaque cluster : utilisez un label réellement configuré sur vos nœuds GPU.
NodeSelector, Node Affinity et nodeName : quelles différences ?
Kubernetes propose plusieurs mécanismes pour contrôler le nœud qui exécute un pod. nodeSelector, node affinity et nodeName influencent tous le placement, mais ils fonctionnent différemment et répondent à des besoins de planification distincts :
- nodeSelector est l'option la plus simple. Il exige qu'un nœud porte exactement les paires clé-valeur de labels spécifiées par le pod. Il convient bien aux workloads dont les exigences de placement sont simples, comme s'exécuter uniquement sur des nœuds SSD ou GPU.
- Node affinity s'appuie aussi sur les labels de nœuds, mais prend en charge des règles plus expressives. Elle peut correspondre à plusieurs valeurs, utiliser des opérateurs tels que In, NotIn, Exists et DoesNotExist, et définir des règles de placement aussi bien requises que préférées. Utilisez-la lorsque la logique de planification ne peut pas être exprimée avec des correspondances exactes de labels.
- nodeName fonctionne différemment, car il contourne la sélection normale des nœuds par le scheduler. Définir
spec.nodeNameaffecte directement le pod au nœud indiqué. C'est surtout utile dans des cas particuliers où le nœud cible exact est déjà connu, plutôt que pour la planification courante des workloads.
| Fonctionnalité | nodeSelector | Node Affinity | nodeName |
|---|---|---|---|
| Méthode de placement | Correspondance des labels de nœuds | Évaluation d'expressions basées sur les labels | Ciblage d'un nœud spécifié |
| Flexibilité de planification | Faible | Élevée | Très faible |
| Correspondance exacte de labels | Oui | Oui | Non |
| Correspondance de valeurs multiples | Non | Oui | Non |
| Règles requises | Oui | Oui | Affectation directe |
| Règles préférées | Non | Oui | Non |
| Sélection normale des nœuds par le scheduler | Oui | Oui | Non |
| Idéal pour | Placement simple basé sur les labels | Règles de placement complexes ou préférées | Affectation d'un pod à un nœud connu |
Bonnes pratiques pour NodeSelector dans Kubernetes
Voici quelques pratiques utiles à garder en tête lorsque vous travaillez avec nodeSelector dans Kubernetes.
1. Adoptez des conventions de labellisation cohérentes
Définissez un schéma de nommage standard pour les labels utilisés par nodeSelector. Par exemple, des labels comme workload=compute, storage=ssd et accelerator=gpu décrivent clairement pourquoi un workload pourrait sélectionner un nœud. Pour les labels propres à votre organisation, utilisez un préfixe de type DNS, comme example.com/node-pool=gpu.
Gardez des clés et valeurs de labels cohérentes entre les clusters et les environnements dans la mesure du possible. Évitez que des valeurs comme gpu, GPU et gpu-node représentent la même propriété. De petites incohérences peuvent laisser des pods à l'état Pending, car nodeSelector exige des correspondances exactes.
Les labels doivent également décrire des propriétés pertinentes pour la planification plutôt que des informations opérationnelles temporaires. Documentez les labels de planification importants afin que les équipes applicatives sachent quels labels sont disponibles et quelles garanties chacun offre.
2. Privilégiez des labels stables plutôt que des noms de nœuds
Préférez des labels qui décrivent un groupe de nœuds ou une capacité plutôt que de lier les workloads à des nœuds individuels. Les nœuds sont souvent des ressources temporaires qui peuvent disparaître lors de l'autoscaling, des mises à niveau, de la maintenance ou de pannes d'infrastructure.
Par exemple, node-pool=compute permet à un pod de s'exécuter sur n'importe quel nœud adapté d'un pool de calcul. Cibler directement un nœud comme worker-03 crée une dépendance envers cette machine et complique son remplacement.
Dans la mesure du possible, configurez les labels de nœuds lors du provisionnement des pools de nœuds ou de l'infrastructure. Les nœuds de remplacement reçoivent alors automatiquement les mêmes labels, ce qui permet aux règles nodeSelector existantes de continuer à fonctionner sans modifier les manifestes des workloads.
3. Combinez nodeSelector avec des requests et limits de ressources
nodeSelector détermine si un nœud porte les labels requis, mais n'indique pas s'il dispose de suffisamment de CPU ou de mémoire. Configurez des requests de ressources en complément des règles de placement afin que le scheduler puisse tenir compte des ressources dont chaque pod a besoin.
Par exemple, un pod peut sélectionner des nœuds à forte capacité mémoire tout en demandant 8 Gi de mémoire. Le scheduler ne considère que les nœuds correspondants, puis vérifie s'ils disposent d'une capacité allouable suffisante pour la requête. Sans requests appropriées, les workloads peuvent se disputer les ressources, même lorsqu'ils sont placés sur le type de nœud prévu.
Les limits de ressources offrent des contrôles supplémentaires de la consommation à l'exécution. Utilisez requests et limits en fonction du comportement du workload, plutôt que de supposer que sélectionner un nœud plus grand ou spécialisé dispense de gérer les ressources.
4. Utilisez taints et tolerations pour les nœuds dédiés
nodeSelector contrôle où un pod donné peut s'exécuter, mais n'empêche pas d'autres pods d'utiliser les mêmes nœuds. Cette distinction compte lorsque des nœuds sont réservés à des workloads nécessitant du matériel coûteux ou spécialisé.
Appliquez un taint aux nœuds dédiés et ajoutez la toleration correspondante aux workloads autorisés à les utiliser. Utilisez ensuite nodeSelector pour garantir que ces workloads sélectionnent activement le groupe de nœuds visé. Par exemple, les nœuds GPU peuvent être marqués d'un taint afin que les applications ordinaires n'y soient pas planifiées, tandis que les workloads GPU tolèrent le taint et sélectionnent le label GPU.
Taints, tolerations et nodeSelector résolvent donc des problèmes complémentaires. Le sélecteur restreint le placement du workload, tandis que le taint protège la capacité des nœuds dédiés contre les workloads qui devraient s'exécuter ailleurs.
5. Utilisez des labels protégés pour l'isolation des nœuds sensibles
Ne considérez pas les labels de nœuds ordinaires comme une barrière de sécurité robuste. Selon la configuration du cluster et les permissions, un nœud compromis ou mal contrôlé pourrait influencer les labels qui déterminent où s'exécutent les workloads sensibles.
Pour une isolation à des fins de sécurité, Kubernetes peut utiliser le plugin d'admission NodeRestriction conjointement avec le Node authorizer. NodeRestriction empêche les kubelets de définir ou de modifier les labels portant le préfixe réservé node-restriction.kubernetes.io/ ainsi que les noms qualifiés dont le préfixe se termine par .node-restriction.kubernetes.io.
Un administrateur peut donc appliquer un label tel que example.com.node-restriction.kubernetes.io/pci-dss=true et le référencer dans les règles de planification. Comme le kubelet ne peut pas s'attribuer lui-même ce label protégé, cela constitue une base plus solide pour isoler les workloads qui ne doivent s'exécuter que sur des nœuds désignés par un administrateur.
FAQ
Qu'est-ce que nodeSelector dans Kubernetes ? nodeSelector est la méthode recommandée la plus simple pour contraindre un Pod à des nœuds portant des labels spécifiques. Il s'agit d'un filtre strict pour le kube-scheduler. Si un nœud ne correspond pas à chacun des labels du nodeSelector, le Pod n'y est pas placé.
Comment utiliser nodeSelector ? Commencez par appliquer un label au nœud cible avec kubectl label nodes, par exemple kubectl label nodes node-1 disktype=ssd. Ajoutez ensuite un nodeSelector dans la spec du Pod avec la même clé et la même valeur, par exemple disktype: ssd. Le scheduler ne prendra en compte que les nœuds correspondants.
Que se passe-t-il si aucun nœud ne correspond au nodeSelector ? Le Pod reste à l'état Pending plutôt que d'être placé sur un nœud qui enfreint la contrainte. Kubernetes continue d'essayer à mesure que les conditions évoluent : la planification peut aboutir plus tard si un nœud correspondant apparaît, si les labels changent ou si les contraintes du Pod sont modifiées. La commande kubectl describe pod affiche les événements du scheduler qui en expliquent la raison.
Quelle est la différence entre nodeSelector et node affinity ? nodeSelector ne prend en charge que des correspondances exactes clé-valeur et des règles strictes. Node affinity prend en charge des opérateurs tels que In, NotIn, Exists, DoesNotExist, Gt et Lt, et permet d'exprimer un placement requis ou préféré. Utilisez node affinity lorsque les correspondances exactes de labels ne suffisent pas.
Quelle est la différence entre nodeSelector et nodeName ? nodeSelector passe toujours par le scheduler, qui filtre les nœuds par label avant d'en choisir un. Définir nodeName contourne la sélection normale du scheduler et affecte directement le Pod au nœud indiqué, ce qui est surtout utile dans des cas particuliers où le nœud cible est déjà connu.
nodeSelector empêche-t-il d'autres pods d'utiliser les mêmes nœuds ? Non. nodeSelector contrôle où un Pod donné peut s'exécuter, mais il ne réserve pas le nœud. Pour tenir les workloads ordinaires à l'écart des nœuds dédiés, appliquez un taint à ces nœuds et ajoutez la toleration correspondante aux workloads autorisés à les utiliser.
Optimisez le placement et l'utilisation des nœuds Kubernetes avec PerfectScale
PerfectScale est une plateforme d'optimisation Kubernetes qui se déploie avec une seule commande Helm et fournit des insights exploitables ainsi qu'une optimisation autonome sur l'ensemble de votre stack K8s. Tandis que nodeSelector contrôle où les workloads peuvent s'exécuter, PerfectScale vous aide à garantir que ces workloads sont correctement dimensionnés et que les nœuds qui les accueillent sont les plus adaptés, afin de réduire la capacité gaspillée sans impacter la performance ni la fiabilité.
Fonctionnalités clés de PerfectScale :
- Right-sizing autonome des workloads : Podfit offre une vue granulaire de la santé et des coûts du cluster, identifie rapidement les ressources gaspillées et les problèmes de résilience, et fournit des recommandations basées sur les données ou une automatisation pour redimensionner les workloads immédiatement.
- Visibilité sur l'utilisation des nœuds : Infrafit offre une visibilité complète sur l'utilisation des nœuds, pour identifier et éliminer la capacité inutilisée tout en maintenant des performances et une fiabilité maximales du cluster.
- Sélection des nœuds pilotée par les données : obtenez des recommandations qui vous aident à choisir les bons nœuds pour vos workloads, pour de meilleures décisions concernant les groupes de nœuds ciblés par vos labels de planification.
- Optimisation des autoscalers de nœuds : maximisez l'efficacité des autoscalers de nœuds tels que Karpenter, avec des intégrations pour HPA, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning, Google Autopilot et plus encore.
- Alertes temps réel priorisées : traitez en priorité les risques de résilience et les pics de coûts les plus critiques grâce à des alertes priorisées automatiquement et envoyées vers Slack, Datadog, MS Teams, PagerDuty et d'autres outils.
- Gouvernance et prévisions : le rapport Trends offre une visibilité dans le temps sur les métriques de coûts, de gaspillage et de risque, par cluster, groupe de nœuds, namespace et workload, pour une planification budgétaire précise et une analyse des causes racines.
- Compatible avec tous les environnements : optimisez vos clusters sur les clouds publics comme EKS, GKE et AKS, les clouds privés comme OpenShift, ainsi que les environnements on-premises et hybrides.
Prêt à optimiser vos nœuds et workloads Kubernetes ? Découvrez la plateforme PerfectScale.