


O que é o NodeSelector do Kubernetes?
No Kubernetes, o nodeSelector é a forma mais simples e recomendada de restringir um Pod para que seja agendado apenas em Nodes com labels específicos. Ele atua como um filtro rígido para o kube-scheduler: se um node não corresponder a cada um dos labels definidos no nodeSelector, o Pod não será alocado nele.
Como funciona:
- Aplique labels aos nodes de destino: atribua labels de chave-valor aos nodes com base em propriedades como tipo de armazenamento, hardware, arquitetura ou função do workload.
- Defina a restrição do pod: adicione um nodeSelector no spec do pod com os labels necessários para o agendamento.
- Corresponda a todos os labels especificados: o scheduler considera apenas os nodes que correspondem a cada par chave-valor definido no nodeSelector.
- Avalie os outros requisitos de agendamento: os nodes correspondentes ainda precisam atender aos requisitos de recursos, taints, regras de afinidade e outras restrições de agendamento.
- Mantenha pods sem correspondência em Pending: se nenhum node elegível corresponder, o pod permanece em Pending até que as condições do cluster ou as restrições de agendamento mudem.
nodeSelector vs. node affinity: Embora o nodeSelector seja excelente para implantações simples, requisitos de agendamento mais complexos geralmente exigem a Node Affinity.
| Recurso | nodeSelector | Node Affinity |
|---|---|---|
| Complexidade | Simples e leve | Configuração mais complexa |
| Lógica de correspondência | Apenas correspondências exatas de chave-valor | Suporta operadores expressivos (In, NotIn, Exists, Gt, Lt) |
| Flexibilidade de regras | Apenas regras rígidas (precisa corresponder ou o Pod fica em Pending) | Regras rígidas e flexíveis (pode "preferir" um node, mas recorrer a outro se indisponível) |
| Direcionamento no nível de Pod | Não (apenas labels de Node) | Sim (pode agendar em relação a outros Pods em execução via Pod Affinity) |
Este artigo faz parte de uma série sobre agendamento no Kubernetes
Neste artigo:
- O que é o NodeSelector do Kubernetes?
- Como o NodeSelector do Kubernetes funciona
- Sintaxe do NodeSelector do Kubernetes
- Exemplos de NodeSelector do Kubernetes
- NodeSelector vs. Node Affinity vs. nodeName no Kubernetes
- Boas práticas de NodeSelector no Kubernetes
Como o NodeSelector do Kubernetes funciona
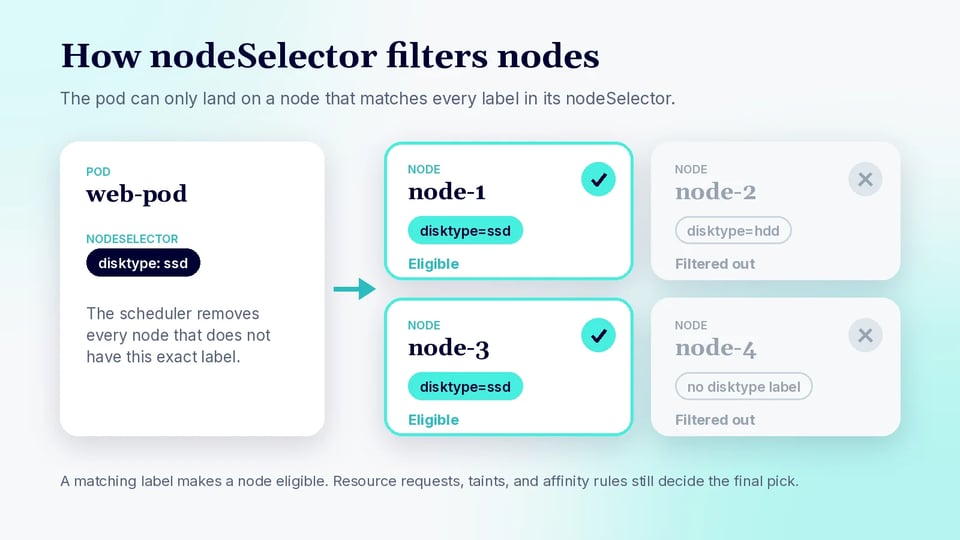
O nodeSelector do Kubernetes funciona comparando os labels definidos na especificação do pod com os labels atribuídos aos nodes. O scheduler considera apenas os nodes que satisfazem cada par chave-valor do nodeSelector do pod. Esse mecanismo oferece controle básico sobre o posicionamento de workloads sem exigir regras de agendamento mais avançadas.
1. Labels de node
Labels de node são pares chave-valor anexados aos nodes do Kubernetes. Eles descrevem propriedades do node que os workloads podem usar para agendamento, como tipo de hardware, configuração de armazenamento ou função do workload. O Kubernetes também atribui alguns labels padrão automaticamente, incluindo labels de arquitetura, sistema operacional e topologia.
Você pode adicionar labels personalizados com kubectl label nodes. Por exemplo, kubectl label nodes node-1 disktype=ssd atribui o label disktype=ssd ao node-1. Os pods podem então referenciar esse label por meio do nodeSelector.
2. Restrições de agendamento de pods
O pod define o nodeSelector dentro do campo spec. Cada entrada especifica um label de node que precisa estar presente com o valor indicado. Por exemplo, nodeSelector: {disktype: ssd} restringe o pod a nodes com o label disktype=ssd.
Quando várias entradas são especificadas, o node precisa corresponder a todas elas. O nodeSelector suporta apenas correspondência exata de chave-valor, sem operadores como In, NotIn ou comparações numéricas. Para condições mais complexas, o Kubernetes oferece a node affinity.
3. Como o scheduler do Kubernetes avalia o nodeSelector
Ao agendar um pod, o scheduler do Kubernetes primeiro identifica os nodes elegíveis para executá-lo. Durante esse processo de filtragem, ele compara o nodeSelector do pod com os labels de cada node candidato. Nodes que não correspondem a todos os labels solicitados são descartados.
Em seguida, o scheduler avalia os nodes restantes usando seus outros critérios de agendamento e seleciona um node adequado. Um nodeSelector correspondente torna o node elegível, mas não garante a seleção, porque requisitos de recursos, taints, regras de afinidade e outras restrições também podem afetar o posicionamento.
4. O que acontece quando nenhum node correspondente está disponível
Se nenhum node satisfizer o nodeSelector do pod e seus outros requisitos de agendamento, o scheduler não consegue atribuir o pod a um node. O pod permanece no estado Pending em vez de ser colocado em um node que viole a restrição.
O Kubernetes continua tentando agendar o pod à medida que as condições do cluster mudam. O agendamento pode ser bem-sucedido mais tarde se um node correspondente ficar disponível, se seus labels mudarem ou se as restrições do pod forem modificadas. Os eventos do scheduler, visíveis com comandos como kubectl describe pod, podem ajudar a identificar a restrição que impede o posicionamento.
Sintaxe do NodeSelector do Kubernetes
O campo nodeSelector é definido dentro de spec em um template de pod. Ele contém um ou mais pares chave-valor de labels de node. O node precisa corresponder a todos os pares para que o pod seja elegível para agendamento nesse node.
apiVersion: v1kind: Podmetadata: name: web-podspec: nodeSelector: workload: web containers: - name: nginx image: nginx:latestNeste exemplo, o Kubernetes só pode agendar o web-pod em nodes com o label workload=web. Você pode aplicar o label com:
kubectl label nodes node-1 workload=webVárias restrições podem ser especificadas adicionando mais entradas:
spec: nodeSelector: workload: web environment: productionAqui, um node elegível precisa ter tanto workload=web quanto environment=production. O nodeSelector faz correspondência exata de labels; para expressões como múltiplos valores aceitáveis ou regras de exclusão, use a node affinity.
Exemplos de NodeSelector do Kubernetes
Agendar pods em nodes de alta memória
Você pode rotular nodes de acordo com o tipo de memória e usar esse label para posicionar aplicações com uso intensivo de memória em nodes adequados. Por exemplo, aplique o label node-type=high-memory a um node apropriado:
kubectl label nodes worker-2 node-type=high-memoryEm seguida, configure o pod para exigir esse label:
apiVersion: v1kind: Podmetadata: name: memory-appspec: nodeSelector: node-type: high-memory containers: - name: web-server image: nginx:latestO scheduler considera apenas nodes com o label node-type=high-memory ao posicionar esse pod.
Agendar pods em uma zona de disponibilidade específica
O Kubernetes normalmente expõe a topologia dos nodes por meio do label topology.kubernetes.io/zone. Você pode usá-lo para restringir um pod a uma zona de disponibilidade específica:
apiVersion: v1kind: Podmetadata: name: zone-podspec: nodeSelector: topology.kubernetes.io/zone: eu-west-1b containers: - name: app image: nginx:latestO pod só pode ser executado em nodes cujo label de zona seja eu-west-1b. Os nomes reais das zonas dependem do cluster e do provedor de infraestrutura.
Agendar workloads por tipo de node
Labels personalizados podem separar nodes de acordo com o workload a que se destinam. Por exemplo, você pode designar um grupo de nodes para aplicações de backend:
kubectl label nodes worker-3 role=backendReferencie o mesmo label na especificação do pod:
apiVersion: v1kind: Podmetadata: name: backend-podspec: nodeSelector: role: backend containers: - name: app image: nginxEssa abordagem é útil quando um cluster contém pools de nodes com hardware, capacidade ou finalidades operacionais diferentes.
Agendar workloads de GPU em nodes com GPU
Workloads de GPU geralmente precisam tanto de restrições de posicionamento de node quanto de solicitações de recursos de GPU. Se os nodes com GPU tiverem um label adequado, o nodeSelector pode restringir o agendamento a esses nodes:
apiVersion: v1kind: Podmetadata: name: gpu-workloadspec: nodeSelector: accelerator: nvidia-gpu containers: - name: inference-app image: example/gpu-app:14.32 resources: limits: nvidia.com/gpu: 1O nodeSelector controla a elegibilidade do node, enquanto nvidia.com/gpu: 1 solicita um recurso de GPU ao device plugin. O nome do label é específico de cada cluster, então use um label que esteja realmente configurado nos seus nodes com GPU.
NodeSelector vs. Node Affinity vs. nodeName no Kubernetes
O Kubernetes oferece vários mecanismos para controlar qual node executa um pod. nodeSelector, node affinity e nodeName podem influenciar o posicionamento, mas funcionam de maneiras diferentes e atendem a requisitos de agendamento distintos:
- nodeSelector é a opção mais simples. Ele exige que o node tenha exatamente os pares chave-valor de labels especificados pelo pod. Funciona bem quando os workloads têm requisitos de posicionamento simples, como executar apenas em nodes com SSD ou GPU.
- Node affinity também usa labels de node, mas suporta regras mais expressivas. Pode corresponder a múltiplos valores, usar operadores como In, NotIn, Exists e DoesNotExist, além de definir regras de posicionamento obrigatórias e preferenciais. Use-a quando a lógica de agendamento não puder ser representada com correspondências exatas de labels.
- nodeName funciona de forma diferente porque ignora a seleção normal de nodes do scheduler. Definir
spec.nodeNameatribui o pod diretamente ao node indicado. Isso costuma ser útil em casos especializados em que o node de destino já é conhecido, e não para o agendamento rotineiro de workloads.
| Recurso | nodeSelector | Node Affinity | nodeName |
|---|---|---|---|
| Método de posicionamento | Corresponde a labels de node | Avalia expressões baseadas em labels | Direciona para um node específico |
| Flexibilidade de agendamento | Baixa | Alta | Muito baixa |
| Correspondência exata de labels | Sim | Sim | Não |
| Correspondência de múltiplos valores | Não | Sim | Não |
| Regras obrigatórias | Sim | Sim | Atribuição direta |
| Regras preferenciais | Não | Sim | Não |
| Usa a seleção normal de nodes do scheduler | Sim | Sim | Não |
| Mais indicado para | Posicionamento simples baseado em labels | Regras de posicionamento complexas ou preferenciais | Atribuir um pod a um node conhecido |
Boas práticas de NodeSelector no Kubernetes
Confira algumas práticas úteis ao trabalhar com o nodeSelector no Kubernetes.
1. Use convenções consistentes de labels de node
Defina um esquema padrão de nomenclatura para os labels usados pelo nodeSelector. Por exemplo, labels como workload=compute, storage=ssd e accelerator=gpu descrevem claramente por que um workload selecionaria um node. Para labels específicos da organização, use um prefixo no estilo DNS, como example.com/node-pool=gpu.
Mantenha as chaves e os valores dos labels consistentes entre clusters e ambientes sempre que possível. Evite que valores como gpu, GPU e gpu-node representem a mesma propriedade. Pequenas inconsistências podem deixar pods no estado Pending, porque o nodeSelector exige correspondências exatas.
Os labels também devem descrever propriedades relevantes para o agendamento, e não informações operacionais temporárias. Documente os labels de agendamento importantes para que as equipes de aplicação saibam quais labels estão disponíveis e quais garantias cada um oferece.
2. Use labels estáveis em vez de nomes de node
Prefira labels que descrevam um grupo de nodes ou uma capacidade, em vez de vincular workloads a nodes individuais. Nodes costumam ser recursos temporários e podem desaparecer durante autoscaling, upgrades, manutenções ou falhas de infraestrutura.
Por exemplo, node-pool=compute permite que um pod seja executado em qualquer node adequado de um pool de computação. Direcionar diretamente um node como worker-03 cria uma dependência daquela máquina e dificulta a substituição de nodes.
Sempre que possível, configure os labels de node como parte do provisionamento do pool de nodes ou da infraestrutura. Assim, os nodes substitutos recebem os mesmos labels automaticamente, permitindo que as regras de nodeSelector existentes continuem funcionando sem alterações nos manifestos dos workloads.
3. Combine nodeSelector com requests e limits de recursos
O nodeSelector determina se um node possui os labels necessários, mas não indica se esse node tem CPU ou memória suficientes. Configure requests de recursos junto com as regras de posicionamento para que o scheduler possa considerar os recursos de que cada pod precisa.
Por exemplo, um pod pode selecionar nodes de alta memória e, ao mesmo tempo, solicitar 8Gi de memória. O scheduler considera apenas os nodes correspondentes e então verifica se eles têm capacidade alocável suficiente para a solicitação. Sem requests adequados, os workloads podem competir por recursos mesmo quando posicionados no tipo de node pretendido.
Limits de recursos fornecem controles adicionais de consumo de recursos em tempo de execução. Use requests e limits de acordo com o comportamento do workload, em vez de presumir que selecionar um node maior ou especializado elimina a necessidade de gerenciamento de recursos.
4. Use taints e tolerations para nodes dedicados
O nodeSelector controla onde um pod específico pode ser executado, mas não impede que outros pods usem os mesmos nodes. Essa distinção é importante quando os nodes são reservados para workloads que exigem hardware caro ou especializado.
Aplique um taint aos nodes dedicados e adicione a toleration correspondente aos workloads autorizados a usá-los. Depois, use o nodeSelector para garantir que esses workloads selecionem ativamente o grupo de nodes pretendido. Por exemplo, nodes com GPU podem receber um taint para que aplicações comuns não sejam agendadas neles, enquanto os workloads de GPU toleram o taint e selecionam o label de GPU.
Taints, tolerations e nodeSelector, portanto, resolvem problemas complementares. O seletor restringe o posicionamento do workload, enquanto o taint ajuda a proteger a capacidade dos nodes dedicados contra workloads que deveriam ser executados em outro lugar.
5. Use labels protegidos para isolamento de nodes com foco em segurança
Não trate labels comuns de node como uma barreira de segurança robusta. Dependendo da configuração e das permissões do cluster, um node comprometido ou controlado de forma inadequada poderia influenciar os labels usados para determinar onde workloads sensíveis são executados.
Para isolamento com foco em segurança, o Kubernetes pode usar o admission plugin NodeRestriction em conjunto com o Node authorizer. O NodeRestriction impede que kubelets definam ou alterem labels com o prefixo reservado node-restriction.kubernetes.io/ e nomes qualificados cujo prefixo termina em .node-restriction.kubernetes.io.
Um administrador pode, portanto, aplicar um label como example.com.node-restriction.kubernetes.io/pci-dss=true e referenciá-lo nas regras de agendamento. Como o kubelet não consegue atribuir esse label protegido a si mesmo, ele oferece uma base mais sólida para isolar workloads que devem ser executados apenas em nodes designados pelo administrador.
FAQ
O que é o nodeSelector no Kubernetes? O nodeSelector é a forma mais simples e recomendada de restringir um Pod a nodes com labels específicos. É um filtro rígido para o kube-scheduler. Se um node não corresponder a cada label do nodeSelector, o Pod não é alocado nele.
Como usar o nodeSelector? Primeiro, aplique o label ao node de destino com kubectl label nodes, por exemplo kubectl label nodes node-1 disktype=ssd. Em seguida, adicione um nodeSelector no spec do Pod com a mesma chave e valor, como disktype: ssd. O scheduler considerará apenas os nodes correspondentes.
O que acontece se nenhum node corresponder ao nodeSelector? O Pod permanece no estado Pending em vez de ser colocado em um node que viole a restrição. O Kubernetes continua tentando conforme as condições mudam, então o agendamento pode ser bem-sucedido mais tarde se um node correspondente surgir, se os labels dos nodes mudarem ou se as restrições do Pod forem editadas. Executar kubectl describe pod mostra os eventos do scheduler que explicam o motivo.
Qual é a diferença entre nodeSelector e node affinity? O nodeSelector suporta apenas correspondências exatas de chave-valor e regras rígidas. A node affinity suporta operadores como In, NotIn, Exists, DoesNotExist, Gt e Lt, e pode expressar tanto posicionamento obrigatório quanto preferencial. Use a node affinity quando correspondências exatas de labels não forem suficientes.
Qual é a diferença entre nodeSelector e nodeName? O nodeSelector ainda passa pelo scheduler, que filtra os nodes por label e então escolhe um. Definir nodeName ignora a seleção normal de nodes do scheduler e atribui o Pod diretamente ao node indicado, o que é útil principalmente em casos especializados em que o node de destino já é conhecido.
O nodeSelector impede que outros pods usem os mesmos nodes? Não. O nodeSelector controla onde um Pod específico pode ser executado, mas não reserva o node. Para manter workloads comuns fora de nodes dedicados, aplique um taint a esses nodes e adicione a toleration correspondente aos workloads autorizados a usá-los.
Otimize o posicionamento e a utilização de nodes do Kubernetes com a PerfectScale
A PerfectScale é uma plataforma de otimização de Kubernetes implantada com um único comando Helm, que entrega insights acionáveis e otimização autônoma em todo o seu stack K8s. Enquanto o nodeSelector controla onde os workloads podem ser executados, a PerfectScale ajuda a garantir que esses workloads estejam dimensionados corretamente e que os nodes onde eles são alocados sejam os mais adequados, para que você reduza a capacidade desperdiçada sem comprometer a performance ou a confiabilidade.
Principais recursos da PerfectScale:
- Right-sizing autônomo de workloads: o Podfit oferece uma visão granular da saúde e dos custos do cluster, identifica rapidamente recursos desperdiçados e problemas de resiliência e entrega recomendações baseadas em dados ou automação para fazer o right-sizing dos workloads imediatamente.
- Visibilidade da utilização de nodes: o Infrafit oferece visibilidade abrangente da utilização dos nodes, ajudando você a identificar e eliminar capacidade ociosa enquanto mantém a performance e a confiabilidade máximas do cluster.
- Seleção de nodes orientada por dados: receba recomendações que ajudam a selecionar os nodes certos para seus workloads, apoiando decisões melhores sobre os grupos de nodes que seus labels de agendamento direcionam.
- Otimização de autoscalers de nodes: maximize a eficácia de autoscalers de nodes como o Karpenter, com integrações para HPA, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning, Google Autopilot e muito mais.
- Alertas priorizados em tempo real: trate primeiro os riscos de resiliência e os picos de custo mais impactantes, com alertas priorizados automaticamente e enviados para Slack, Datadog, MS Teams, PagerDuty e outras ferramentas.
- Governança e previsão: o relatório Trends oferece visibilidade das métricas de custo, desperdício e risco ao longo do tempo em clusters, grupos de nodes, namespaces e workloads, apoiando um planejamento orçamentário preciso e a análise de causa raiz.
- Suporte a qualquer ambiente: otimize clusters em nuvens públicas como EKS, GKE e AKS, nuvens privadas como OpenShift, ambientes on-premises e configurações híbridas.
Pronto para otimizar seus nodes e workloads no Kubernetes? Saiba mais sobre a plataforma PerfectScale.