


Che cos'è NodeSelector in Kubernetes?
In Kubernetes, nodeSelector è il modo più semplice e consigliato per vincolare un Pod a essere schedulato solo su nodi con label specifiche. Agisce come un filtro rigido per il kube-scheduler: se un nodo non corrisponde a ogni singola label definita nel nodeSelector, il Pod non verrà posizionato su quel nodo.
Come funziona:
- Etichettatura dei nodi di destinazione: assegnare ai nodi label chiave-valore in base a proprietà come tipo di storage, hardware, architettura o ruolo del workload.
- Definizione del vincolo del pod: aggiungere un nodeSelector nella spec del pod con le label richieste per lo scheduling.
- Corrispondenza con tutte le label specificate: lo scheduler considera solo i nodi che corrispondono a ogni coppia chiave-valore definita nel nodeSelector.
- Valutazione degli altri requisiti di scheduling: i nodi corrispondenti devono comunque soddisfare requisiti di risorse, taint, regole di affinity e altri vincoli di scheduling.
- Pod senza corrispondenza in stato Pending: se nessun nodo idoneo corrisponde, il pod resta in stato Pending finché le condizioni del cluster o i vincoli di scheduling non cambiano.
nodeSelector vs. node affinity: Se nodeSelector è ottimo per i deployment semplici, i requisiti di scheduling più complessi richiedono in genere la Node Affinity.
| Caratteristica | nodeSelector | Node Affinity |
|---|---|---|
| Complessità | Semplice e leggero | Configurazione più complessa |
| Logica di matching | Solo corrispondenze esatte chiave-valore | Supporta operatori espressivi (In, NotIn, Exists, Gt, Lt) |
| Flessibilità delle regole | Solo regole rigide (deve esserci corrispondenza, altrimenti il Pod resta in Pending) | Regole rigide e soft (può "preferire" un nodo con fallback se non disponibile) |
| Targeting a livello di Pod | No (solo label dei nodi) | Sì (può schedulare rispetto ad altri Pod in esecuzione tramite Pod Affinity) |
Questo articolo fa parte di una serie dedicata allo scheduling in Kubernetes
In questo articolo:
- Che cos'è NodeSelector in Kubernetes?
- Come funziona NodeSelector in Kubernetes
- Sintassi di NodeSelector in Kubernetes
- Esempi di NodeSelector in Kubernetes
- NodeSelector vs. Node Affinity vs. nodeName in Kubernetes
- Best practice per NodeSelector in Kubernetes
Come funziona NodeSelector in Kubernetes
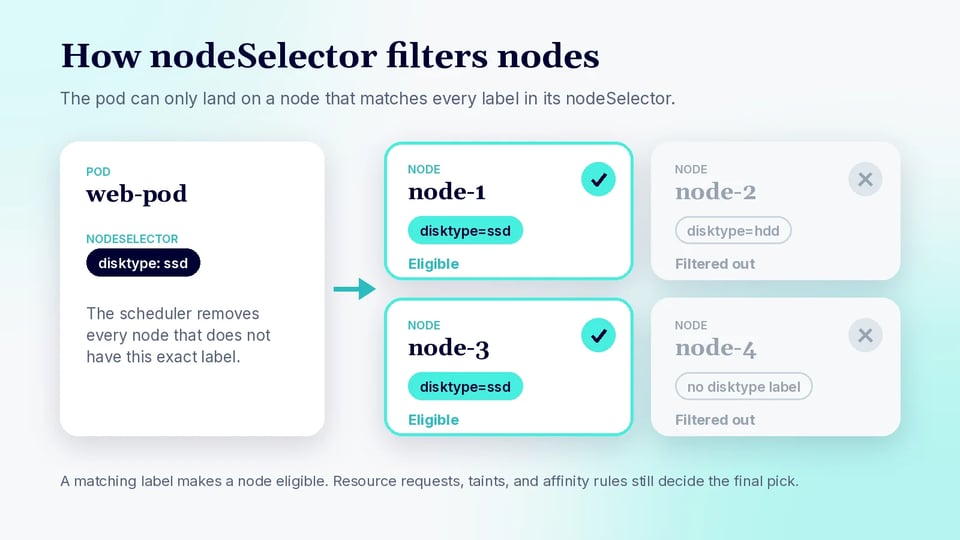
Il nodeSelector di Kubernetes funziona confrontando le label definite nella specifica di un pod con le label assegnate ai nodi. Lo scheduler considera solo i nodi che soddisfano ogni coppia chiave-valore presente nel nodeSelector del pod. Questo meccanismo offre un controllo di base sul posizionamento dei workloads senza richiedere regole di scheduling più avanzate.
1. Label dei nodi
Le label dei nodi sono coppie chiave-valore associate ai nodi Kubernetes. Descrivono proprietà del nodo che i workloads possono usare per lo scheduling, come tipo di hardware, configurazione dello storage o ruolo del workload. Kubernetes assegna automaticamente anche alcune label standard, tra cui quelle per architettura, sistema operativo e topologia.
È possibile aggiungere label personalizzate con kubectl label nodes. Ad esempio, kubectl label nodes node-1 disktype=ssd assegna la label disktype=ssd a node-1. I pod possono quindi fare riferimento a questa label tramite nodeSelector.
2. Vincoli di scheduling del pod
Un pod definisce nodeSelector nel campo spec. Ogni voce specifica una label del nodo che deve essere presente con il valore indicato. Ad esempio, nodeSelector: {disktype: ssd} limita il pod ai nodi etichettati disktype=ssd.
Quando vengono specificate più voci, un nodo deve corrisponderle tutte. nodeSelector supporta solo il matching esatto chiave-valore, senza operatori come In, NotIn o confronti numerici. Per condizioni più complesse, Kubernetes mette a disposizione la node affinity.
3. Come lo scheduler di Kubernetes valuta nodeSelector
Quando deve schedulare un pod, lo scheduler di Kubernetes identifica innanzitutto i nodi idonei a eseguirlo. Durante questa fase di filtraggio, confronta il nodeSelector del pod con le label di ciascun nodo candidato. I nodi che non corrispondono a tutte le label richieste vengono esclusi dalla valutazione.
Lo scheduler valuta quindi i nodi rimanenti in base agli altri criteri di scheduling e seleziona un nodo adatto. Un nodeSelector corrispondente rende un nodo idoneo, ma non ne garantisce la selezione, perché anche requisiti di risorse, taint, regole di affinity e altri vincoli possono influire sul posizionamento.
4. Cosa succede quando nessun nodo corrisponde
Se nessun nodo soddisfa il nodeSelector del pod e gli altri requisiti di scheduling, lo scheduler non può assegnare il pod a un nodo. Il pod resta nello stato Pending invece di essere posizionato su un nodo che viola il vincolo.
Kubernetes continua a tentare di schedulare il pod al variare delle condizioni del cluster. Lo scheduling può riuscire in un secondo momento se diventa disponibile un nodo corrispondente, se le sue label cambiano o se i vincoli del pod vengono modificati. Gli eventi dello scheduler, visibili con comandi come kubectl describe pod, aiutano a individuare il vincolo che impedisce il posizionamento.
Sintassi di NodeSelector in Kubernetes
Il campo nodeSelector si definisce sotto spec in un template di pod. Contiene una o più coppie chiave-valore di label dei nodi. Un nodo deve corrispondere a ogni coppia perché il pod sia idoneo allo scheduling su quel nodo.
apiVersion: v1kind: Podmetadata: name: web-podspec: nodeSelector: workload: web containers: - name: nginx image: nginx:latestIn questo esempio, Kubernetes può schedulare web-pod solo su nodi etichettati workload=web. È possibile applicare la label con:
kubectl label nodes node-1 workload=webÈ possibile specificare più vincoli aggiungendo altre voci:
spec: nodeSelector: workload: web environment: productionIn questo caso, un nodo idoneo deve avere sia workload=web sia environment=production. nodeSelector esegue un matching esatto delle label; per espressioni come più valori accettabili o regole di esclusione, usare invece la node affinity.
Esempi di NodeSelector in Kubernetes
Schedulare pod su nodi ad alta memoria
È possibile etichettare i nodi in base al tipo di memoria e usare quella label per posizionare le applicazioni a uso intensivo di memoria su nodi adeguati. Ad esempio, etichettare un nodo appropriato con node-type=high-memory:
kubectl label nodes worker-2 node-type=high-memoryQuindi configurare il pod in modo che richieda quella label:
apiVersion: v1kind: Podmetadata: name: memory-appspec: nodeSelector: node-type: high-memory containers: - name: web-server image: nginx:latestNel posizionare questo pod, lo scheduler considera solo i nodi con la label node-type=high-memory.
Schedulare pod in una zona di disponibilità specifica
Kubernetes espone comunemente la topologia dei nodi tramite la label topology.kubernetes.io/zone. È possibile usarla per vincolare un pod a una determinata zona di disponibilità:
apiVersion: v1kind: Podmetadata: name: zone-podspec: nodeSelector: topology.kubernetes.io/zone: eu-west-1b containers: - name: app image: nginx:latestIl pod può essere eseguito solo su nodi la cui label di zona è eu-west-1b. I nomi effettivi delle zone dipendono dal cluster e dal provider dell'infrastruttura.
Schedulare i workloads per tipo di nodo
Le label personalizzate possono separare i nodi in base al workload previsto. Ad esempio, è possibile designare un gruppo di nodi per le applicazioni backend:
kubectl label nodes worker-3 role=backendFare riferimento alla stessa label nella specifica del pod:
apiVersion: v1kind: Podmetadata: name: backend-podspec: nodeSelector: role: backend containers: - name: app image: nginxQuesto approccio è utile quando un cluster contiene node pool con hardware, capacità o finalità operative diverse.
Schedulare workloads GPU su nodi GPU
I workloads GPU necessitano in genere sia di vincoli di posizionamento sui nodi sia di richieste di risorse GPU. Se i nodi GPU hanno una label adeguata, nodeSelector può limitare lo scheduling a quei nodi:
apiVersion: v1kind: Podmetadata: name: gpu-workloadspec: nodeSelector: accelerator: nvidia-gpu containers: - name: inference-app image: example/gpu-app:14.32 resources: limits: nvidia.com/gpu: 1Il nodeSelector controlla l'idoneità dei nodi, mentre nvidia.com/gpu: 1 richiede una risorsa GPU al device plugin. Il nome della label è specifico del cluster, quindi usare una label effettivamente configurata sui propri nodi GPU.
NodeSelector vs. Node Affinity vs. nodeName in Kubernetes
Kubernetes offre diversi meccanismi per controllare su quale nodo viene eseguito un pod. nodeSelector, node affinity e nodeName possono tutti influire sul posizionamento, ma funzionano in modo diverso e si adattano a requisiti di scheduling differenti:
- nodeSelector è l'opzione più semplice. Richiede che un nodo abbia esattamente le coppie chiave-valore di label specificate dal pod. Funziona bene quando i workloads hanno requisiti di posizionamento semplici, come l'esecuzione solo su nodi SSD o GPU.
- Node affinity usa anch'essa le label dei nodi, ma supporta regole più espressive. Può effettuare matching su più valori, usare operatori come In, NotIn, Exists e DoesNotExist e definire regole di posizionamento sia obbligatorie sia preferenziali. Da usare quando la logica di scheduling non può essere rappresentata con corrispondenze esatte delle label.
- nodeName funziona in modo diverso perché bypassa la normale selezione dei nodi da parte dello scheduler. Impostare
spec.nodeNameassegna il pod direttamente al nodo indicato. È utile in genere per casi specifici in cui il nodo di destinazione esatto è già noto, non per lo scheduling ordinario dei workloads.
| Caratteristica | nodeSelector | Node Affinity | nodeName |
|---|---|---|---|
| Metodo di posizionamento | Confronta le label dei nodi | Valuta espressioni basate sulle label | Punta a un nodo specifico |
| Flessibilità di scheduling | Bassa | Alta | Molto bassa |
| Matching esatto delle label | Sì | Sì | No |
| Matching su più valori | No | Sì | No |
| Regole obbligatorie | Sì | Sì | Assegnazione diretta |
| Regole preferenziali | No | Sì | No |
| Usa la normale selezione dei nodi dello scheduler | Sì | Sì | No |
| Ideale per | Posizionamento semplice basato sulle label | Regole di posizionamento complesse o preferenziali | Assegnare un pod a un nodo noto |
Best practice per NodeSelector in Kubernetes
Ecco alcune pratiche utili da considerare quando si lavora con nodeSelector in Kubernetes.
1. Adottare convenzioni coerenti per le label dei nodi
Definire uno schema di denominazione standard per le label usate da nodeSelector. Ad esempio, label come workload=compute, storage=ssd e accelerator=gpu descrivono chiaramente perché un workload potrebbe selezionare un nodo. Per le label specifiche dell'organizzazione, usare un prefisso in stile DNS come example.com/node-pool=gpu.
Mantenere coerenti chiavi e valori delle label tra cluster e ambienti, dove possibile. Evitare che valori come gpu, GPU e gpu-node rappresentino la stessa proprietà. Piccole incoerenze possono lasciare i pod in stato Pending, perché nodeSelector richiede corrispondenze esatte.
Le label dovrebbero inoltre descrivere proprietà rilevanti per lo scheduling, non informazioni operative temporanee. Documentare le label di scheduling importanti, così che i team applicativi sappiano quali label sono disponibili e quali garanzie offre ciascuna.
2. Usare label stabili invece dei nomi dei nodi
Preferire label che descrivono un gruppo di nodi o una capacità, invece di legare i workloads a singoli nodi. I nodi sono spesso risorse temporanee e possono scomparire durante autoscaling, aggiornamenti, manutenzione o guasti dell'infrastruttura.
Ad esempio, node-pool=compute consente a un pod di essere eseguito su qualsiasi nodo adatto di un pool di compute. Puntare direttamente a un nodo come worker-03 crea una dipendenza da quella macchina e rende più difficile la sostituzione dei nodi.
Dove possibile, configurare le label dei nodi come parte del provisioning dei node pool o dell'infrastruttura. I nodi sostitutivi riceveranno così automaticamente le stesse label, consentendo alle regole nodeSelector esistenti di continuare a funzionare senza modifiche ai manifest dei workloads.
3. Combinare nodeSelector con request e limit delle risorse
nodeSelector determina se un nodo ha le label richieste, ma non indica se quel nodo dispone di CPU o memoria sufficienti. Configurare le request delle risorse insieme alle regole di posizionamento, così che lo scheduler possa tenere conto delle risorse necessarie a ciascun pod.
Ad esempio, un pod potrebbe selezionare nodi ad alta memoria richiedendo al contempo 8Gi di memoria. Lo scheduler considera solo i nodi corrispondenti e verifica poi se dispongono di capacità allocabile sufficiente per la request. Senza request adeguate, i workloads possono competere per le risorse anche quando vengono posizionati sul tipo di nodo previsto.
I limit delle risorse offrono controlli di runtime aggiuntivi sul consumo di risorse. Usare request e limit in base al comportamento del workload, senza presumere che la selezione di un nodo più grande o specializzato elimini la necessità di gestire le risorse.
4. Usare taint e toleration per i nodi dedicati
nodeSelector controlla dove può essere eseguito un determinato pod, ma non impedisce ad altri pod di usare gli stessi nodi. Questa distinzione è importante quando i nodi sono riservati a workloads che richiedono hardware costoso o specializzato.
Applicare un taint ai nodi dedicati e aggiungere una toleration corrispondente ai workloads autorizzati a usarli. Quindi usare nodeSelector per garantire che quei workloads selezionino attivamente il gruppo di nodi previsto. Ad esempio, è possibile applicare un taint ai nodi GPU in modo che le applicazioni ordinarie non vi vengano schedulate, mentre i workloads GPU tollerano il taint e selezionano la label GPU.
Taint, toleration e nodeSelector risolvono quindi problemi complementari. Il selector limita il posizionamento del workload, mentre il taint aiuta a proteggere la capacità dei nodi dedicati dai workloads che dovrebbero essere eseguiti altrove.
5. Usare label protette per l'isolamento dei nodi ai fini della sicurezza
Non considerare le normali label dei nodi un solido perimetro di sicurezza. A seconda della configurazione del cluster e dei permessi, un nodo compromesso o controllato in modo improprio potrebbe influenzare le label usate per determinare dove vengono eseguiti i workloads sensibili.
Per un isolamento rilevante ai fini della sicurezza, Kubernetes può usare l'admission plugin NodeRestriction insieme al Node authorizer. NodeRestriction impedisce ai kubelet di impostare o modificare label con il prefisso riservato node-restriction.kubernetes.io/ e nomi qualificati il cui prefisso termina con .node-restriction.kubernetes.io.
Un amministratore può quindi applicare una label come example.com.node-restriction.kubernetes.io/pci-dss=true e farvi riferimento nelle regole di scheduling. Poiché il kubelet non può assegnarsi quella label protetta, questa costituisce una base più solida per isolare i workloads che devono essere eseguiti solo su nodi designati dall'amministratore.
FAQ
Che cos'è nodeSelector in Kubernetes? nodeSelector è il modo più semplice e consigliato per vincolare un Pod a nodi con label specifiche. È un filtro rigido per il kube-scheduler: se un nodo non corrisponde a tutte le label definite nel nodeSelector, il Pod non viene posizionato su quel nodo.
Come si usa nodeSelector? Prima si assegna la label al nodo di destinazione con kubectl label nodes, ad esempio kubectl label nodes node-1 disktype=ssd. Poi si aggiunge un nodeSelector nella spec del Pod con la stessa chiave e lo stesso valore, ad esempio disktype: ssd. Lo scheduler considererà solo i nodi corrispondenti.
Cosa succede se nessun nodo corrisponde al nodeSelector? Il Pod resta nello stato Pending invece di essere posizionato su un nodo che viola il vincolo. Kubernetes continua a provare al variare delle condizioni, quindi lo scheduling può riuscire in seguito se compare un nodo corrispondente, se le label dei nodi cambiano o se i vincoli del Pod vengono modificati. Il comando kubectl describe pod mostra gli eventi dello scheduler che ne spiegano il motivo.
Qual è la differenza tra nodeSelector e node affinity? nodeSelector supporta solo corrispondenze esatte chiave-valore e regole rigide. La node affinity supporta operatori come In, NotIn, Exists, DoesNotExist, Gt e Lt e può esprimere sia regole di posizionamento obbligatorie sia preferenziali. Usare la node affinity quando le corrispondenze esatte delle label non sono sufficienti.
Qual è la differenza tra nodeSelector e nodeName? nodeSelector passa comunque attraverso lo scheduler, che filtra i nodi in base alle label e poi ne sceglie uno. Impostare nodeName bypassa la normale selezione dei nodi dello scheduler e assegna il Pod direttamente al nodo indicato, il che è utile soprattutto in casi specifici in cui il nodo di destinazione è già noto.
nodeSelector impedisce ad altri pod di usare gli stessi nodi? No. nodeSelector controlla dove può essere eseguito un determinato Pod, ma non riserva il nodo. Per tenere i workloads ordinari lontani dai nodi dedicati, applicare un taint a quei nodi e aggiungere una toleration corrispondente ai workloads autorizzati a utilizzarli.
Ottimizzare il posizionamento e l'utilizzo dei nodi Kubernetes con PerfectScale
PerfectScale è una piattaforma di ottimizzazione per Kubernetes che si installa con un singolo comando Helm e offre insight concreti e ottimizzazione autonoma su tutto lo stack K8s. Mentre nodeSelector controlla dove possono essere eseguiti i workloads, PerfectScale aiuta a garantire che quei workloads siano dimensionati correttamente e che i nodi su cui vengono eseguiti siano quelli giusti, così da ridurre la capacità sprecata senza compromettere prestazioni o affidabilità.
Funzionalità principali di PerfectScale:
- Right-sizing autonomo dei workloads: Podfit offre una vista granulare su salute e costi del cluster, individua rapidamente risorse sprecate e problemi di resilienza e fornisce raccomandazioni basate sui dati o automazione per il right-sizing immediato dei workloads.
- Visibilità sull'utilizzo dei nodi: Infrafit offre visibilità completa sull'utilizzo dei nodi, aiutando a individuare ed eliminare la capacità inattiva mantenendo prestazioni e affidabilità del cluster ai massimi livelli.
- Selezione dei nodi basata sui dati: raccomandazioni che aiutano a scegliere i nodi giusti per i propri workloads, a supporto di decisioni migliori sui gruppi di nodi a cui puntano le label di scheduling.
- Ottimizzazione degli autoscaler dei nodi: massimizza l'efficacia di autoscaler come Karpenter, con integrazioni per HPA, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning, Google Autopilot e altro ancora.
- Avvisi in tempo reale con priorità: gli avvisi con priorità automatica, inviati a Slack, Datadog, MS Teams, PagerDuty e altri strumenti, consentono di affrontare per primi i rischi di resilienza e i picchi di costo più rilevanti.
- Governance e previsioni: il report Trends offre visibilità nel tempo sulle metriche di costo, spreco e rischio tra cluster, gruppi di nodi, namespace e workloads, a supporto di una pianificazione accurata del budget e dell'analisi delle cause alla radice.
- Supporto per qualsiasi ambiente: ottimizzazione dei cluster su cloud pubblici come EKS, GKE e AKS, cloud privati come OpenShift, ambienti on-premises e ibridi.
Vuole ottimizzare i Suoi nodi e workloads Kubernetes? Scopra di più sulla piattaforma PerfectScale.