


Kubernetes NodeSelectorとは?
Kubernetesにおいて、nodeSelectorは、特定のラベルを持つNodeにのみPodをスケジュールするよう制約する、最もシンプルな推奨方法です。kube-schedulerに対するハードフィルターとして機能し、nodeSelectorで定義されたすべてのラベルに一致しないノードには、Podは配置されません。
仕組み:
- 対象ノードにラベルを付与: ストレージの種類、ハードウェア、アーキテクチャ、ワークロードの役割などの属性に基づいて、キーと値のラベルをノードに割り当てます。
- Podの制約を定義: Podのspec配下に、スケジューリングに必要なラベルを指定したnodeSelectorを追加します。
- 指定したすべてのラベルに一致: スケジューラーは、nodeSelectorで定義されたすべてのキーと値のペアに一致するノードのみを対象とします。
- その他のスケジューリング要件を評価: 一致したノードであっても、リソース要件、taint、アフィニティルールなどのスケジューリング制約を満たす必要があります。
- 一致しないPodはPendingのまま: 条件を満たすノードが存在しない場合、クラスターの状態やスケジューリング制約が変わるまで、PodはPending状態のままになります。
nodeSelectorとnode affinityの違い: nodeSelectorはシンプルなデプロイメントに最適ですが、より複雑なスケジューリング要件には通常Node Affinityが必要になります。
| 項目 | nodeSelector | Node Affinity |
|---|---|---|
| 複雑さ | シンプルで軽量 | より複雑な設定 |
| マッチングロジック | キーと値の完全一致のみ | 表現力のある演算子(In、NotIn、Exists、Gt、Lt)に対応 |
| ルールの柔軟性 | ハードルールのみ(一致しない場合、PodはPendingのまま) | ハードルールとソフトルール(ノードを「優先」しつつ、利用できない場合は他にフォールバック可能) |
| Podレベルのターゲティング | 不可(ノードラベルのみ) | 可能(Pod Affinityにより他の実行中Podとの相対的な配置が可能) |
本記事は、Kubernetesスケジューリングに関する連載記事の一部です。
本記事の内容:
- Kubernetes NodeSelectorとは?
- Kubernetes NodeSelectorの仕組み
- Kubernetes NodeSelectorの構文
- Kubernetes NodeSelectorの使用例
- Kubernetes NodeSelector、Node Affinity、nodeNameの比較
- Kubernetes NodeSelectorのベストプラクティス
Kubernetes NodeSelectorの仕組み
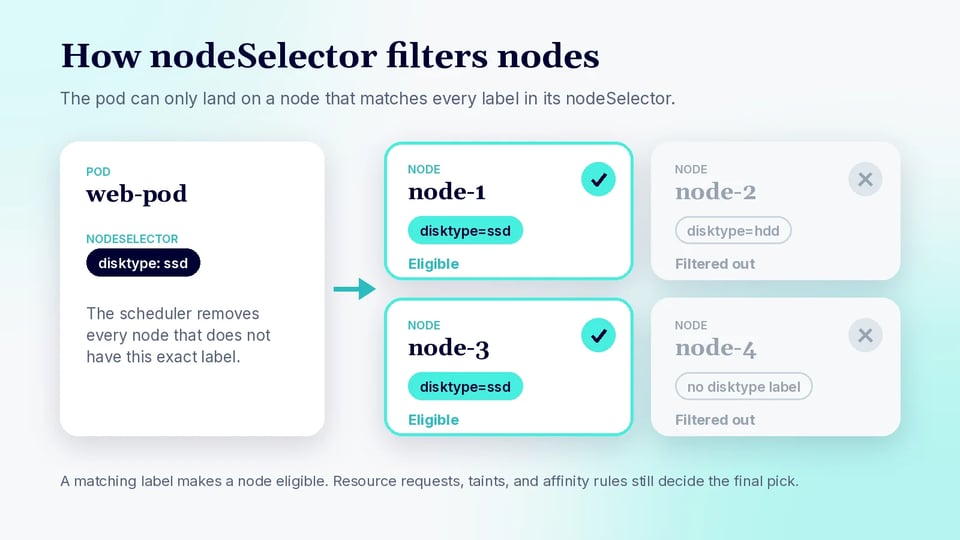
KubernetesのnodeSelectorは、Pod仕様で定義されたラベルと、ノードに割り当てられたラベルを照合することで機能します。スケジューラーは、PodのnodeSelectorに含まれるすべてのキーと値のペアを満たすノードのみを対象とします。この仕組みにより、高度なスケジューリングルールを使わずに、ワークロード配置の基本的な制御が可能になります。
1. ノードラベル
ノードラベルは、Kubernetesのノードに付与されるキーと値のペアです。ハードウェアの種類、ストレージ構成、ワークロードの役割など、スケジューリングに利用できるノードの属性を表します。また、Kubernetesはアーキテクチャ、オペレーティングシステム、トポロジーなどの標準ラベルを自動的に付与します。
カスタムラベルはkubectl label nodesで追加できます。たとえば、kubectl label nodes node-1 disktype=ssdはnode-1にdisktype=ssdというラベルを割り当てます。PodはnodeSelectorを通じてこのラベルを参照できます。
2. Podのスケジューリング制約
PodはnodeSelectorをspecフィールドの配下に定義します。各エントリには、指定した値を持つことが必須となるノードラベルを記述します。たとえば、nodeSelector: {disktype: ssd}は、disktype=ssdのラベルを持つノードにPodを制限します。
複数のエントリを指定した場合、ノードはそのすべてに一致する必要があります。nodeSelectorはIn、NotIn、数値比較などの演算子ではなく、キーと値の完全一致のみをサポートします。より複雑な条件には、Kubernetesのnode affinityが利用できます。
3. KubernetesスケジューラーによるnodeSelectorの評価方法
Podをスケジュールする際、Kubernetesスケジューラーはまず、そのPodを実行できるノードを特定します。このフィルタリングの過程で、PodのnodeSelectorを各候補ノードのラベルと照合します。要求されたすべてのラベルに一致しないノードは、候補から除外されます。
その後、スケジューラーは残ったノードをその他のスケジューリング基準で評価し、適切なノードを選択します。nodeSelectorに一致してもノードが候補になるだけで、選択が保証されるわけではありません。リソース要件、taint、アフィニティルールなどの制約も配置に影響するためです。
4. 一致するノードがない場合の動作
PodのnodeSelectorとその他のスケジューリング要件を満たすノードが存在しない場合、スケジューラーはPodをノードに割り当てられません。制約に違反するノードに配置されることはなく、PodはPending状態のままになります。
Kubernetesは、クラスターの状態変化に応じてPodのスケジューリングを試み続けます。一致するノードが利用可能になる、ラベルが変更される、あるいはPodの制約が修正されると、後からスケジューリングが成功することがあります。kubectl describe podなどのコマンドで確認できるスケジューラーイベントは、配置を妨げている制約の特定に役立ちます。
Kubernetes NodeSelectorの構文
nodeSelectorフィールドは、Podテンプレートのspec配下に定義します。1つ以上のノードラベルのキーと値のペアを含みます。Podがそのノードにスケジュール可能になるには、ノードがすべてのペアに一致している必要があります。
apiVersion: v1kind: Podmetadata: name: web-podspec: nodeSelector: workload: web containers: - name: nginx image: nginx:latestこの例では、Kubernetesはworkload=webというラベルを持つノードにのみweb-podをスケジュールできます。ラベルは次のコマンドで付与できます。
kubectl label nodes node-1 workload=webエントリを追加することで、複数の制約を指定できます。
spec: nodeSelector: workload: web environment: productionこの場合、対象となるノードはworkload=webとenvironment=productionの両方を持っている必要があります。nodeSelectorはラベルの完全一致のみを行います。複数の許容値や除外ルールなどの条件式が必要な場合は、代わりにnode affinityを使用してください。
Kubernetes NodeSelectorの使用例
高メモリノードへのPodのスケジューリング
メモリの種類に応じてノードにラベルを付け、そのラベルを使ってメモリ集約型アプリケーションを適切なノードに配置できます。たとえば、該当するノードにnode-type=high-memoryというラベルを付与します。
kubectl label nodes worker-2 node-type=high-memory次に、そのラベルを必須とするようPodを設定します。
apiVersion: v1kind: Podmetadata: name: memory-appspec: nodeSelector: node-type: high-memory containers: - name: web-server image: nginx:latestスケジューラーは、このPodの配置時にnode-type=high-memoryラベルを持つノードのみを対象とします。
特定のアベイラビリティゾーンへのPodのスケジューリング
Kubernetesは一般に、topology.kubernetes.io/zoneラベルを通じてノードのトポロジーを公開します。これを使って、Podを特定のアベイラビリティゾーンに制約できます。
apiVersion: v1kind: Podmetadata: name: zone-podspec: nodeSelector: topology.kubernetes.io/zone: eu-west-1b containers: - name: app image: nginx:latestこのPodは、ゾーンラベルがeu-west-1bのノードでのみ実行できます。実際のゾーン名は、クラスターやインフラプロバイダーによって異なります。
ノードタイプ別のワークロードのスケジューリング
カスタムラベルを使えば、想定するワークロードに応じてノードを分けられます。たとえば、バックエンドアプリケーション用のノードグループを指定できます。
kubectl label nodes worker-3 role=backendPod仕様で同じラベルを参照します。
apiVersion: v1kind: Podmetadata: name: backend-podspec: nodeSelector: role: backend containers: - name: app image: nginxこの方法は、ハードウェア、キャパシティ、運用目的の異なるノードプールを含むクラスターで有用です。
GPUノードへのGPUワークロードのスケジューリング
GPUワークロードには通常、ノード配置の制約とGPUリソース要求の両方が必要です。GPUノードに適切なラベルが付与されていれば、nodeSelectorでスケジューリングをそれらのノードに限定できます。
apiVersion: v1kind: Podmetadata: name: gpu-workloadspec: nodeSelector: accelerator: nvidia-gpu containers: - name: inference-app image: example/gpu-app:14.32 resources: limits: nvidia.com/gpu: 1nodeSelectorはノードの適格性を制御し、nvidia.com/gpu: 1はデバイスプラグインにGPUリソースを要求します。ラベル名はクラスターごとに異なるため、実際にGPUノードに設定されているラベルを使用してください。
Kubernetes NodeSelector、Node Affinity、nodeNameの比較
Kubernetesには、Podを実行するノードを制御するための複数の仕組みがあります。nodeSelector、node affinity、nodeNameはいずれも配置に影響しますが、動作は異なり、適するスケジューリング要件もそれぞれ異なります。
- nodeSelectorは最もシンプルな選択肢です。Podが指定したキーと値のラベルにノードが完全一致することを要求します。SSDノードやGPUノードでのみ実行するなど、配置要件が単純なワークロードに適しています。
- Node affinityもノードラベルを使いますが、より表現力の高いルールをサポートします。複数の値へのマッチ、In、NotIn、Exists、DoesNotExistなどの演算子の使用、必須ルールと優先ルールの両方の定義が可能です。ラベルの完全一致だけではスケジューリングロジックを表現できない場合に使用します。
- nodeNameは、通常のスケジューラーによるノード選択をバイパスするため、動作が異なります。
spec.nodeNameを設定すると、Podは指定したノードに直接割り当てられます。これは一般に、日常的なワークロードのスケジューリングではなく、対象ノードが既に分かっている特殊なケースで有用です。
| 項目 | nodeSelector | Node Affinity | nodeName |
|---|---|---|---|
| 配置方法 | ノードラベルに一致 | ラベルベースの式を評価 | 指定したノードを対象 |
| スケジューリングの柔軟性 | 低い | 高い | 非常に低い |
| ラベルの完全一致 | 可 | 可 | 不可 |
| 複数値のマッチング | 不可 | 可 | 不可 |
| 必須ルール | 可 | 可 | 直接割り当て |
| 優先ルール | 不可 | 可 | 不可 |
| 通常のスケジューラーによるノード選択 | 使用する | 使用する | 使用しない |
| 最適な用途 | シンプルなラベルベースの配置 | 複雑な配置ルールや優先配置ルール | 既知のノードへのPodの割り当て |
Kubernetes NodeSelectorのベストプラクティス
KubernetesでnodeSelectorを扱う際に役立つプラクティスをいくつか紹介します。
1. 一貫したノードラベルの命名規則を使用する
nodeSelectorで使用するラベルの標準的な命名体系を定義しましょう。たとえば、workload=compute、storage=ssd、accelerator=gpuのようなラベルは、ワークロードがそのノードを選択する理由を明確に表します。組織固有のラベルには、example.com/node-pool=gpuのようなDNS形式のプレフィックスを使用します。
可能な限り、クラスターや環境をまたいでラベルのキーと値の一貫性を維持しましょう。gpu、GPU、gpu-nodeのような値が同じ属性を表す状態は避けてください。nodeSelectorは完全一致を要求するため、わずかな不整合でもPodがPending状態のままになる可能性があります。
また、ラベルは一時的な運用情報ではなく、スケジューリングにとって重要な属性を表すべきです。重要なスケジューリングラベルは文書化し、アプリケーションチームがどのラベルを利用でき、それぞれが何を保証するのかを把握できるようにしましょう。
2. ノード名ではなく安定したラベルを使用する
ワークロードを個々のノードに紐付けるのではなく、ノードグループや機能を表すラベルを優先しましょう。ノードは一時的なリソースであることが多く、オートスケーリング、アップグレード、メンテナンス、インフラ障害によって消失する可能性があります。
たとえば、node-pool=computeであれば、Podはコンピュートプール内の適切な任意のノードで実行できます。worker-03のような特定のノードを直接対象にすると、そのマシンへの依存が生まれ、ノードの置き換えが難しくなります。
可能であれば、ノードプールやインフラのプロビジョニングの一環としてノードラベルを設定しましょう。そうすれば置き換え後のノードにも同じラベルが自動的に付与され、ワークロードのマニフェストを変更することなく、既存のnodeSelectorルールが機能し続けます。
3. nodeSelectorをリソース要求・制限と組み合わせる
nodeSelectorはノードが必要なラベルを持つかどうかを判定しますが、そのノードに十分なCPUやメモリがあるかどうかは示しません。スケジューラーが各Podに必要なリソースを考慮できるよう、配置ルールと併せてリソース要求を設定しましょう。
たとえば、あるPodが高メモリノードを選択しつつ、8Giのメモリを要求するとします。スケジューラーは一致するノードのみを対象とし、その上でそれらのノードに要求分の割り当て可能な容量があるかを確認します。適切な要求がなければ、意図したノードタイプに配置されていてもワークロード間でリソースの奪い合いが発生する可能性があります。
リソース制限は、リソース消費に対する実行時の追加的な制御を提供します。大きなノードや特殊なノードを選択すればリソース管理が不要になると考えるのではなく、ワークロードの挙動に応じて要求と制限を使用してください。
4. 専用ノードにはtaintとtolerationを使用する
nodeSelectorは特定のPodがどこで実行できるかを制御しますが、他のPodが同じノードを使用することは防ぎません。この違いは、高価なハードウェアや特殊なハードウェアを必要とするワークロード向けにノードを予約する場合に重要です。
専用ノードにtaintを適用し、それらの使用を許可されたワークロードに対応するtolerationを追加しましょう。その上で、nodeSelectorを使用して、それらのワークロードが意図したノードグループを確実に選択するようにします。たとえば、GPUノードにtaintを設定すれば一般のアプリケーションはそこにスケジュールされず、GPUワークロードはtaintを許容してGPUラベルを選択します。
つまり、taint、toleration、nodeSelectorは互いに補完し合う課題を解決するものです。セレクターはワークロードの配置を制限し、taintは本来別の場所で実行すべきワークロードから専用ノードのキャパシティを保護するのに役立ちます。
5. セキュリティ上重要なノード分離には保護されたラベルを使用する
通常のノードラベルを強固なセキュリティ境界として扱わないでください。クラスターの構成や権限によっては、侵害されたノードや適切に管理されていないノードが、機密性の高いワークロードの配置先を決定するラベルに影響を与える可能性があります。
セキュリティ上重要な分離には、KubernetesのNodeRestrictionアドミッションプラグインをNodeオーソライザーと組み合わせて使用できます。NodeRestrictionは、予約済みのnode-restriction.kubernetes.io/プレフィックスを持つラベルや、プレフィックスが.node-restriction.kubernetes.ioで終わる修飾名のラベルを、kubeletが設定・変更することを防ぎます。
したがって、管理者はexample.com.node-restriction.kubernetes.io/pci-dss=trueのようなラベルを適用し、スケジューリングルールから参照できます。kubeletはこの保護されたラベルを自分自身に割り当てられないため、管理者が指定したノードでのみ実行すべきワークロードを分離するための、より強固な基盤となります。
FAQ
KubernetesのnodeSelectorとは何ですか? nodeSelectorは、特定のラベルを持つノードにPodを制約するための最もシンプルな推奨方法です。kube-schedulerに対するハードフィルターであり、ノードがnodeSelectorのすべてのラベルに一致しない場合、Podはそこに配置されません。
nodeSelectorはどのように使いますか? まず、kubectl label nodesで対象ノードにラベルを付与します(例:kubectl label nodes node-1 disktype=ssd)。次に、Podのspec配下に同じキーと値を持つnodeSelector(disktype: ssdなど)を追加します。スケジューラーは一致するノードのみを対象とします。
nodeSelectorに一致するノードがない場合はどうなりますか? 制約に違反するノードに配置されることはなく、PodはPending状態のままになります。Kubernetesは状態の変化に応じて試行を続けるため、一致するノードが現れる、ノードラベルが変わる、またはPodの制約が編集されると、後からスケジューリングが成功することがあります。kubectl describe podを実行すると、理由を説明するスケジューラーイベントを確認できます。
nodeSelectorとnode affinityの違いは何ですか? nodeSelectorはキーと値の完全一致とハードルールのみをサポートします。Node affinityはIn、NotIn、Exists、DoesNotExist、Gt、Ltなどの演算子をサポートし、必須と優先の両方の配置を表現できます。ラベルの完全一致だけでは不十分な場合は、node affinityを使用してください。
nodeSelectorとnodeNameの違いは何ですか? nodeSelectorはスケジューラーを経由し、ラベルでノードをフィルタリングしてから1つを選択します。nodeNameを設定すると、通常のスケジューラーによるノード選択をバイパスし、指定したノードにPodを直接割り当てます。これは主に、対象ノードが既に分かっている特殊なケースで有用です。
nodeSelectorは他のPodが同じノードを使用するのを防ぎますか? いいえ。nodeSelectorは特定のPodの実行場所を制御しますが、ノードを予約するわけではありません。一般のワークロードを専用ノードから遠ざけるには、それらのノードにtaintを適用し、使用を許可するワークロードに対応するtolerationを追加してください。
PerfectScaleでKubernetesのノード配置と使用率を最適化
PerfectScaleは、1つのHelmコマンドでデプロイできるKubernetes最適化プラットフォームで、K8sスタック全体にわたって実用的なインサイトと自律的な最適化を提供します。nodeSelectorはワークロードの実行場所を制御しますが、PerfectScaleはそれらのワークロードが適切なサイズであること、そして配置先のノードが最適であることを確実にし、パフォーマンスや信頼性に影響を与えることなく無駄なキャパシティを削減できるよう支援します。
PerfectScaleの主な機能:
- 自律的なワークロードのライトサイジング: Podfitはクラスターの健全性とコストを詳細に可視化し、無駄なリソースやレジリエンスの問題を迅速に特定して、データに基づく推奨または自動化により、ワークロードを即座にライトサイジングします。
- ノード使用率の可視化: Infrafitはノード使用率を包括的に可視化し、クラスターのパフォーマンスと信頼性を最大限に維持しながら、アイドル状態のノードキャパシティの特定と排除を支援します。
- データに基づくノード選択: ワークロードに適したノードを選択するための推奨を得られ、スケジューリングラベルが対象とするノードグループについて、より良い意思決定を支援します。
- ノードオートスケーラーの最適化: Karpenterなどのノードオートスケーラーの効果を最大化します。HPA、Cluster Autoscaler、EKS Auto Mode、Fargate、Node Auto Provisioning、Google Autopilotなどとの連携に対応しています。
- 優先度付きリアルタイムアラート: Slack、Datadog、MS Teams、PagerDutyなどのツールに配信される自動優先度付けアラートにより、最も影響の大きいレジリエンスリスクやコスト急増から順に対処できます。
- ガバナンスと予測: Trendsレポートは、クラスター、ノードグループ、ネームスペース、ワークロードにわたるコスト、無駄、リスクの指標を時系列で可視化し、正確な予算計画と根本原因分析を支援します。
- あらゆる環境に対応: EKS、GKE、AKSなどのパブリッククラウド、OpenShiftなどのプライベートクラウド、オンプレミス、ハイブリッド環境のクラスターを最適化できます。
Kubernetesのノードとワークロードを最適化しませんか?PerfectScaleプラットフォームの詳細はこちら。