


¿Qué es un DaemonSet de Kubernetes?
Un DaemonSet es un controlador de workloads esencial de Kubernetes que garantiza que una copia de un Pod específico se ejecute en todos los nodos (o en los seleccionados) de un clúster. Cuando se agrega un nodo nuevo al clúster, el DaemonSet lanza automáticamente un Pod en él; cuando se elimina un nodo, el Pod asociado se elimina mediante garbage collection.
A diferencia de los Deployments, que se enfocan en mantener un número específico de réplicas totales en todo el clúster, los DaemonSets se enfocan en la cobertura a nivel de nodo, vinculando la programación de los pods a la topología de nodos del clúster. Así se garantiza que ciertos workloads, como agentes de monitoreo o recolectores de logs, se distribuyan de manera uniforme y consistente en toda la infraestructura, con una cobertura y funcionalidad homogéneas. Los DaemonSets son indispensables para los workloads que necesitan ejecutarse en todos los nodos, o en nodos específicos, para mantener la consistencia operativa.
Aquí tienes un ejemplo de manifiesto YAML de un DaemonSet:
El siguiente ejemplo define un DaemonSet que ejecuta un agente de logging de fluentd en el clúster:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluentd-logging namespace: kube-systemspec: selector: matchLabels: name: fluentd-logging template: metadata: labels: name: fluentd-logging spec: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists containers: - name: fluentd image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1Casos de uso comunes de los DaemonSets:
- Recolección de logs: Ejecuta agentes como Fluentd, Filebeat o Logstash en cada nodo para recolectar y reenviar los logs de los contenedores y del sistema.
- Monitoreo de nodos: Despliega herramientas como Prometheus Node Exporter o Datadog Agent en cada nodo para recopilar métricas de salud, recursos y workloads.
- Agentes de seguridad y observabilidad: Garantiza que los agentes de detección de intrusiones, tracing u observabilidad se ejecuten en todos los nodos para una cobertura consistente del clúster.
- Device plugins de Kubernetes: Ejecuta device plugins en nodos con hardware especializado, como GPUs o FPGAs, para que Kubernetes pueda exponer esos recursos a los workloads.
Este artículo forma parte de una serie sobre objetos de Kubernetes.
En este artículo:
- ¿Cómo funciona un DaemonSet?
- Casos de uso del DaemonSet de Kubernetes
- DaemonSet vs. Deployment en Kubernetes
- Tutorial de DaemonSet en Kubernetes
- Buenas prácticas para DaemonSets en Kubernetes
¿Cómo funciona un DaemonSet?
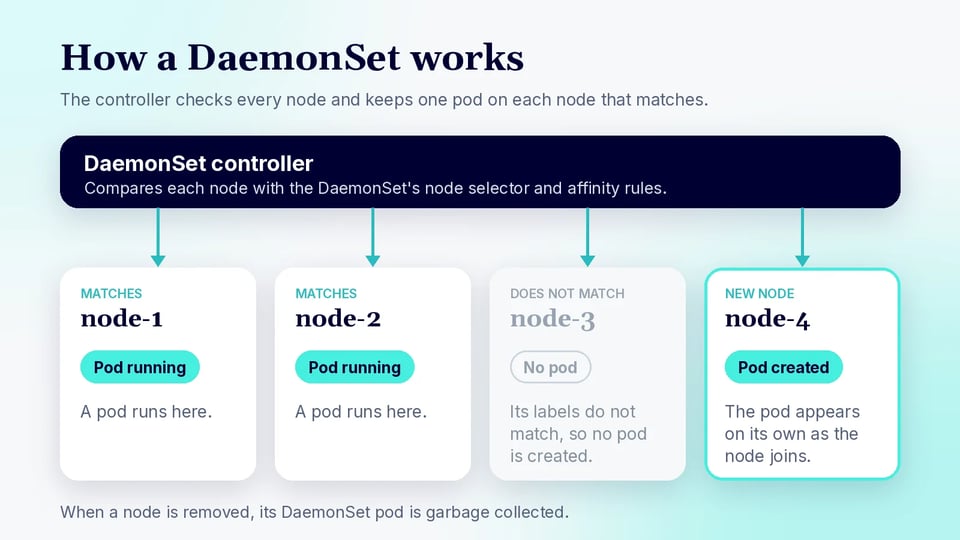
Cuando se crea un DaemonSet, el plano de control de Kubernetes evalúa cada nodo frente a los criterios de programación del DaemonSet. Si un nodo coincide, el controlador del DaemonSet crea el pod especificado en ese nodo. Si más adelante el nodo se elimina del clúster, su pod de DaemonSet se elimina mediante garbage collection.
Si las etiquetas del nodo cambian y este deja de coincidir con el node selector o las reglas de afinidad del DaemonSet, el controlador elimina el pod. El controlador agrega automáticamente una toleration para el taint node.kubernetes.io/unschedulable, por lo que los pods de DaemonSet siguen ejecutándose en nodos acordonados e incluso pueden programarse en ellos. Este mecanismo garantiza que los pods de DaemonSet sigan de cerca el estado del clúster y se adapten a los cambios de los nodos sin intervención del usuario.
Los DaemonSets admiten funciones avanzadas de programación, como node affinity, tolerations y selectores, lo que permite a los administradores dirigirse a subconjuntos específicos de nodos. Por ejemplo, un DaemonSet puede restringirse para ejecutarse únicamente en nodos etiquetados con una clave determinada o en aquellos con hardware específico. A medida que el clúster cambia (se agregan, reetiquetan o eliminan nodos), el controlador del DaemonSet reconcilia continuamente el estado real con el estado deseado, asegurando que los pods siempre se desplieguen donde se necesitan.
Casos de uso del DaemonSet de Kubernetes
Recolección de logs
La recolección de logs es un caso de uso común para los DaemonSets. Las soluciones de logging centralizado suelen requerir un agente presente en cada nodo para recolectar y reenviar los logs de los contenedores y los componentes del sistema. Al desplegar un recolector de logs, como Fluentd o Filebeat, en forma de DaemonSet, los administradores se aseguran de cubrir todos los nodos sin desplegar agentes manualmente ni preocuparse de que los nodos nuevos se queden sin el componente de logging. Este enfoque simplifica la gestión de logs y garantiza la consistencia en todo el clúster.
El uso de DaemonSets para la recolección de logs también simplifica el escalado de los clústeres. Cuando se incorporan nodos nuevos, el controlador del DaemonSet despliega automáticamente el agente de logging, lo que elimina pasos manuales y reduce el riesgo de perder logs de la infraestructura recién agregada. Este despliegue automatizado a nivel de nodo convierte a los DaemonSets en el método preferido para la agregación de logs a escala de clúster en entornos de Kubernetes, lo que facilita el cumplimiento normativo y la resolución de problemas.
Contenido relacionado: Lee nuestra guía sobre logs de Kubernetes
Monitoreo de nodos
El monitoreo de nodos es otro escenario donde los DaemonSets destacan. Herramientas de monitoreo como Prometheus Node Exporter o Datadog Agent suelen desplegarse como DaemonSets para recopilar métricas sobre la salud de los nodos, el uso de recursos y los workloads en ejecución. Al aprovechar los DaemonSets, estos agentes se distribuyen automáticamente en todos los nodos, lo que brinda una visibilidad completa del estado operativo del clúster.
El despliegue automático mediante DaemonSets garantiza que el monitoreo se mantenga consistente a medida que el clúster cambia. Cuando se agregan o eliminan nodos, el controlador del DaemonSet ajusta el despliegue del agente de monitoreo en consecuencia. Esta gestión dinámica simplifica la operación del clúster y asegura que los administradores siempre dispongan de métricas actualizadas de cada nodo, algo fundamental para una planificación de capacidad y una respuesta a incidentes eficaces.
Contenido relacionado: Lee nuestra guía sobre monitoreo de Kubernetes
Agentes de seguridad y observabilidad
Los agentes de seguridad y observabilidad, como los sistemas de detección de intrusiones o los recolectores de tracing distribuido, suelen necesitar ejecutarse en cada nodo para brindar una cobertura completa del clúster. Los DaemonSets facilitan el despliegue uniforme de estos agentes y garantizan que todo el tráfico y la actividad se monitoreen en busca de amenazas o cuellos de botella de rendimiento. Este despliegue uniforme es clave para mantener un entorno de Kubernetes seguro y observable.
Usar DaemonSets para los agentes de seguridad también respalda los requisitos de cumplimiento, al garantizar que ningún nodo quede sin monitorear. A medida que el clúster evoluciona, el DaemonSet se adapta automáticamente y mantiene la cobertura de seguridad sin intervención manual. Este enfoque asegura que las medidas de seguridad y observabilidad sigan el ritmo de la naturaleza dinámica de los clústeres de Kubernetes, reduciendo brechas operativas y riesgos.
Device plugins de Kubernetes
Los device plugins de Kubernetes permiten exponer hardware especializado, como GPUs o FPGAs, a los pods. Estos plugins suelen desplegarse como DaemonSets para asegurar que cada nodo con el hardware adecuado ejecute el pod del device plugin correspondiente. Esta configuración permite a Kubernetes programar workloads que requieren recursos de hardware específicos, lo que permite casos de uso como machine learning o aceleración por hardware.
Desplegar los device plugins como DaemonSets garantiza que los recursos de hardware se gestionen de forma consistente en todos los nodos aplicables. Cuando se agregan nodos nuevos con hardware especializado, el controlador del DaemonSet despliega automáticamente el device plugin correspondiente y pone el recurso a disposición del programador. Este enfoque automatizado simplifica la operación del clúster y maximiza el aprovechamiento del hardware especializado.
DaemonSet vs. Deployment en Kubernetes
Aunque tanto los DaemonSets como los Deployments gestionan pods en Kubernetes, sus propósitos y comportamientos difieren de manera significativa. Los Deployments están diseñados para mantener un número especificado de réplicas de pods, distribuyéndolas entre los nodos disponibles para lograr alta disponibilidad y balanceo de carga. Esto hace que los Deployments sean adecuados para aplicaciones sin estado, donde el objetivo principal es garantizar cierto nivel de redundancia y escalabilidad, sin importar cuántos nodos tenga el clúster.
Los DaemonSets garantizan que exactamente un pod (o un número especificado) se ejecute en cada nodo o en un subconjunto de nodos. Esto es ideal para workloads que deben estar presentes en todos los nodos, como agentes de monitoreo, recolectores de logs o device plugins. Los DaemonSets se adaptan automáticamente cuando se agregan o eliminan nodos, mientras que los Deployments requieren un escalado manual para acompañar los cambios de nodos. Entender esta distinción es clave para elegir el controlador correcto para cada workload en Kubernetes.
| Aspecto | Deployment | DaemonSet |
|---|---|---|
| Propósito principal | Ejecuta un número especificado de réplicas de una aplicación | Ejecuta un pod en cada nodo o en los nodos seleccionados |
| Comportamiento de escalado | Se escala manualmente o mediante autoescalado según el número de réplicas | Se ajusta automáticamente cuando se agregan o eliminan nodos |
| Ideal para | Aplicaciones sin estado, APIs, servicios web, workloads escalables | Agentes de monitoreo, recolectores de logs, servicios a nivel de nodo |
| Ubicación de los pods | El programador de Kubernetes distribuye los pods entre los nodos | Garantiza que haya un pod en cada nodo elegible |
Tutorial de DaemonSet en Kubernetes
Este tutorial explica cómo crear y trabajar con un DaemonSet. Está adaptado de la documentación de Kubernetes.
1. Crear un DaemonSet de Kubernetes
Para crear un DaemonSet de Kubernetes, defínelo en un manifiesto YAML usando apiVersion: apps/v1 y kind: DaemonSet. El manifiesto debe incluir los campos estándar de Kubernetes, como metadata y spec, junto con una plantilla de pod en .spec.template. El .spec.selector del DaemonSet debe coincidir con las etiquetas asignadas a la plantilla del pod; una vez creado el DaemonSet, este selector no se puede cambiar. Kubernetes también exige que la política de reinicio del pod sea Always, ya sea de forma explícita o mediante el valor predeterminado.
Por ejemplo, el siguiente manifiesto crea un DaemonSet simple que ejecuta un contenedor en cada nodo elegible:
apiVersion: apps/v1kind: DaemonSetmetadata: name: example-daemonsetspec: selector: matchLabels: app.kubernetes.io/name: example template: metadata: labels: app.kubernetes.io/name: example spec: containers: - name: pause image: registry.k8s.io/pauseLos administradores pueden ampliar la plantilla del pod con opciones como solicitudes de recursos, montajes de volúmenes, tolerations, node selectors y node affinity. Estas configuraciones determinan cómo se ejecutan los pods del DaemonSet y, cuando se especifican restricciones de programación, qué nodos son elegibles para alojarlos. La documentación de Kubernetes ofrece un ejemplo básico en el que el DaemonSet programa un pod en cada nodo aplicable.
2. Desplegar un DaemonSet
Una vez creado el manifiesto del DaemonSet, despliégalo en el clúster con kubectl apply. Si el manifiesto está guardado localmente como daemonset.yaml, ejecuta:
kubectl apply -f daemonset.yamlKubernetes también muestra cómo aplicar un DaemonSet directamente desde un manifiesto YAML alojado en línea. Por ejemplo:
kubectl apply -f https://k8s.io/examples/application/basic-daemonset.yamlEl comando kubectl apply envía la configuración a la API de Kubernetes; a partir de ahí, el controlador del DaemonSet determina qué nodos son elegibles y crea los pods necesarios. A medida que se unen al clúster más nodos elegibles, el controlador crea automáticamente pods de DaemonSet para ellos. Los pods asociados a nodos eliminados se limpian posteriormente mediante garbage collection.
Después del despliegue, los cambios en el DaemonSet suelen gestionarse modificando el manifiesto y ejecutando de nuevo kubectl apply. En los DaemonSets que usan la estrategia RollingUpdate, los cambios en la plantilla del pod desencadenan una actualización progresiva de los pods gestionados. Kubernetes también admite la estrategia de actualización OnDelete cuando los administradores quieren que los pods de reemplazo se creen únicamente después de eliminar manualmente los existentes.
3. Verificar los pods del DaemonSet
Después de desplegar un DaemonSet, verifica que sus pods se ejecutan en los nodos esperados. La documentación de Kubernetes recomienda listar los pods con la opción -o wide, que incluye el nodo asignado a cada pod:
kubectl get pods -o widePara un DaemonSet que debe ejecutarse en todo el clúster, la salida debería mostrar un pod del DaemonSet en cada nodo elegible. La columna NODE facilita confirmar que los pods están distribuidos como se espera.
En entornos con muchos workloads, usa las etiquetas definidas en la plantilla del pod del DaemonSet para filtrar los resultados. Para el ejemplo anterior, el comando sería:
kubectl get pods -l app.kubernetes.io/name=example -o wideTambién puedes inspeccionar el propio recurso DaemonSet con:
kubectl get daemonset example-daemonseto usar el nombre abreviado del recurso:
kubectl get ds example-daemonsetEl estado del DaemonSet permite a los administradores comparar el número deseado de pods con el número de pods actuales, listos y disponibles. Si algún pod no se ejecuta correctamente, se pueden usar comandos como kubectl describe pod <pod-name> y kubectl logs <pod-name> para investigar problemas de programación o a nivel de contenedor. El tutorial básico de DaemonSet de Kubernetes verifica que el despliegue fue exitoso comprobando que la lista de pods resultante contenga un pod por cada nodo aplicable.
Buenas prácticas para DaemonSets en Kubernetes
1. Ajusta correctamente las solicitudes y límites de CPU y memoria
Definir solicitudes y límites adecuados de CPU y memoria es fundamental para la estabilidad del DaemonSet. Las solicitudes definen los recursos mínimos que necesita un pod, mientras que los límites establecen el máximo que puede consumir. El sobreaprovisionamiento malgasta recursos y puede causar fallos de programación en nodos con recursos limitados. El subaprovisionamiento conlleva el riesgo de que los pods sean expulsados o de que el rendimiento se degrade. Analiza el perfil de recursos del workload para determinar valores predeterminados razonables, de modo que cada pod del DaemonSet quepa con holgura en cada nodo objetivo.
Revisa y ajusta la configuración de recursos de manera periódica a medida que la aplicación evoluciona. Los requisitos de recursos pueden cambiar debido a nuevas funcionalidades, un aumento de la carga o cambios en la infraestructura subyacente. En entornos dinámicos de Kubernetes, el ajuste periódico de solicitudes y límites previene la contención de recursos y favorece un uso eficiente del clúster. Integra las revisiones de recursos en tu proceso de gestión de cambios para una optimización continua.
2. Basa la configuración de recursos en el uso histórico
Las solicitudes de recursos deben reflejar cómo se comportan los pods del DaemonSet con workloads reales, en lugar de depender únicamente de estimaciones iniciales. Usa métricas históricas de CPU y memoria de herramientas como Prometheus, Grafana o tu plataforma de monitoreo en la nube para identificar el uso típico, la demanda pico y las diferencias entre nodos. Define solicitudes lo suficientemente altas para soportar la operación normal, pero evitando reservar recursos innecesarios en cada nodo objetivo.
Revisa métricas basadas en percentiles durante periodos representativos en lugar de usar promedios de corto plazo. Las solicitudes de CPU suelen poder basarse en el uso sostenido con margen para los picos, mientras que las solicitudes de memoria deben contemplar los máximos observados. Como los DaemonSets multiplican su consumo de recursos en todos los nodos, incluso mejoras pequeñas en la configuración de cada pod pueden liberar una capacidad significativa del clúster.
3. Trata la memoria con más cautela que la CPU
Los límites de CPU y memoria tienen modos de fallo distintos en Kubernetes. Cuando un contenedor alcanza su límite de CPU, Kubernetes restringe su uso de CPU, lo que normalmente se traduce en un procesamiento más lento. En cambio, cuando un contenedor supera su límite de memoria, puede ser terminado por el kernel con un error de falta de memoria (OOM). Para los agentes a nivel de nodo, los reinicios repetidos pueden generar brechas en la cobertura de logging, monitoreo o seguridad.
Define solicitudes y límites de memoria con suficiente margen para picos temporales y para el crecimiento del workload. Monitorea el uso máximo de memoria y los eventos OOM antes de reducir las asignaciones. Para agentes con requisitos de memoria impredecibles, un límite de memoria restrictivo puede ser más disruptivo que una sobreasignación moderada, así que valida los límites frente a los patrones de uso en producción.
4. Usa la estrategia de actualización adecuada
Los DaemonSets admiten las estrategias de actualización RollingUpdate y OnDelete. RollingUpdate, que es la predeterminada, reemplaza automáticamente los pods existentes cuando cambia la plantilla del pod del DaemonSet. Parámetros como maxUnavailable y maxSurge permiten controlar cuántos pods del DaemonSet quedan no disponibles o se agregan temporalmente durante una actualización.
Usa OnDelete cuando el reemplazo de pods deba controlarse de forma explícita. Con esta estrategia, actualizar la plantilla del pod no reemplaza automáticamente los pods existentes; los administradores deben eliminarlos antes de que Kubernetes cree pods a partir de la nueva plantilla. Elijas la estrategia que elijas, considera el efecto que la indisponibilidad de los agentes tiene sobre la cobertura de logging, monitoreo, redes o seguridad durante las actualizaciones.
5. Monitorea la eficiencia de forma continua a medida que el clúster cambia
El consumo de recursos de un DaemonSet crece con el número de nodos elegibles. Un pod que usa recursos modestos en un nodo puede representar un consumo agregado considerable de CPU y memoria en un clúster grande. Haz seguimiento tanto del uso por pod como de los recursos totales consumidos por cada DaemonSet para entender su impacto en la capacidad del clúster.
Reevalúa los DaemonSets cuando cambien los tipos de nodo, los workloads o el tamaño del clúster. Mantente atento a solicitudes de recursos sin usar, throttling de CPU, presión de memoria, eventos OOM, reinicios y pods que no logran programarse. El monitoreo continuo ayuda a identificar cuándo la configuración de recursos o las reglas de programación ya no corresponden a las condiciones reales de operación.
Optimiza el uso de recursos de los DaemonSets con PerfectScale
Como un DaemonSet coloca un pod en cada nodo elegible, incluso pequeños excesos o déficits de aprovisionamiento se multiplican en todo el clúster. PerfectScale by DoiT es una plataforma de optimización de Kubernetes que se despliega con un único comando de Helm y luego ofrece información accionable y optimización autónoma en todo el stack de K8s, para que los agentes a nivel de nodo, como recolectores de logs, exportadores de monitoreo y daemons de seguridad, se ejecuten con los recursos que realmente necesitan.
Capacidades clave de PerfectScale:
- Right-sizing autónomo de workloads: Podfit ofrece una vista granular de la salud y los costos del clúster, prioriza las áreas que requieren atención y optimiza los workloads de forma autónoma con recomendaciones de right-sizing basadas en datos que pueden aplicarse automáticamente.
- Optimización del uso de nodos: Infrafit brinda una visibilidad completa del uso de los nodos e información granular que identifica y elimina la capacidad ociosa de los nodos, y ayuda a elegir los nodos adecuados para tus workloads.
- Alineación con autoescaladores: Funciona junto a HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning y Google Autopilot, con recomendaciones accionables para mejorar sus configuraciones.
- Alertas en tiempo real con priorización: La autopriorización avanzada destaca los riesgos de resiliencia, los picos de costos y las anomalías de mayor impacto antes de que afecten a los usuarios o a la factura de la nube, con alertas enviadas a Slack, Datadog, MS Teams o PagerDuty.
- Informes de tendencias y gobernanza: El informe de tendencias ofrece una visibilidad profunda de las métricas de costo, pérdida y riesgo a lo largo del tiempo en clústeres, grupos de nodos, namespaces y workloads, facilitando los pronósticos y el análisis de causa raíz.
- Amplio soporte de entornos: Funciona en clústeres on-premise y en la nube, incluidos OpenShift, EKS, GKE y AKS, y es compatible con contenedores basados en Windows, así como con workloads efímeros y de ML.