


O que é um DaemonSet do Kubernetes?
Um DaemonSet é um controlador de workload essencial do Kubernetes que garante que uma cópia de um Pod específico seja executada em todos os nós (ou em nós selecionados) de um cluster. Quando um novo nó é adicionado ao cluster, o DaemonSet inicia automaticamente um Pod nele; quando um nó é removido, o Pod associado é eliminado pelo garbage collection.
Ao contrário dos Deployments, que se concentram em manter um número específico de réplicas totais em todo o cluster, os DaemonSets focam na cobertura em nível de nó, vinculando o agendamento de pods à topologia de nós do cluster. Isso garante que determinados workloads, como agentes de monitoramento ou coletores de logs, sejam distribuídos de maneira uniforme e consistente por toda a infraestrutura, oferecendo cobertura e funcionalidade homogêneas. Os DaemonSets são indispensáveis para workloads que precisam rodar em todos os nós, ou em nós específicos, para garantir consistência operacional.
Veja um exemplo de manifesto YAML de um DaemonSet:
O exemplo a seguir define um DaemonSet que executa um agente de logging fluentd no cluster:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluentd-logging namespace: kube-systemspec: selector: matchLabels: name: fluentd-logging template: metadata: labels: name: fluentd-logging spec: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists containers: - name: fluentd image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1Casos de uso comuns de DaemonSets:
- Coleta de logs: execute agentes como Fluentd, Filebeat ou Logstash em cada nó para coletar e encaminhar logs de contêineres e do sistema.
- Monitoramento de nós: implante ferramentas como Prometheus Node Exporter ou Datadog Agent em cada nó para coletar métricas de saúde, recursos e workloads.
- Agentes de segurança e observabilidade: garanta que agentes de detecção de intrusão, tracing ou observabilidade rodem em todos os nós para uma cobertura consistente do cluster.
- Device plugins do Kubernetes: execute device plugins em nós com hardware especializado, como GPUs ou FPGAs, para que o Kubernetes possa expor esses recursos aos workloads.
Este artigo faz parte de uma série sobre objetos do Kubernetes
Neste artigo:
- Como funciona um DaemonSet?
- Casos de uso do DaemonSet no Kubernetes
- DaemonSet vs. Deployment no Kubernetes
- Tutorial de DaemonSet no Kubernetes
- Boas práticas de DaemonSet no Kubernetes
Como funciona um DaemonSet?
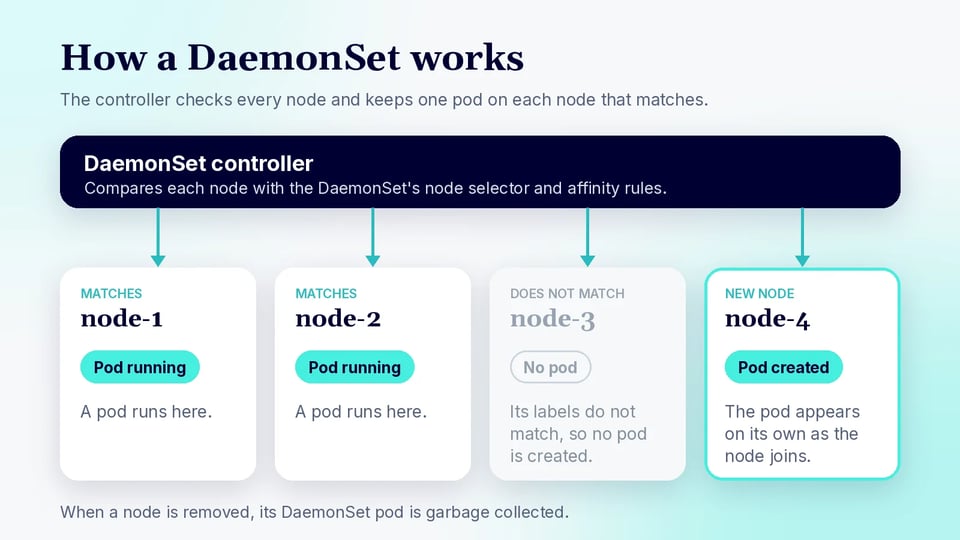
Quando um DaemonSet é criado, o plano de controle do Kubernetes avalia cada nó em relação aos critérios de agendamento do DaemonSet. Se um nó corresponder, o controlador do DaemonSet cria o pod especificado nesse nó. Se o nó for removido do cluster posteriormente, seu pod do DaemonSet é eliminado pelo garbage collection.
Se os rótulos do nó mudarem de forma que ele não corresponda mais ao node selector ou às regras de afinidade do DaemonSet, o controlador exclui o pod. O controlador adiciona automaticamente uma toleration para o taint node.kubernetes.io/unschedulable, de modo que os pods do DaemonSet continuem rodando em nós isolados (cordoned) e possam até ser agendados neles. Esse mecanismo garante que os pods do DaemonSet acompanhem de perto o estado do cluster, adaptando-se às mudanças nos nós sem intervenção do usuário.
Os DaemonSets suportam recursos avançados de agendamento, como afinidade de nós, tolerations e seletores, permitindo que administradores direcionem subconjuntos específicos de nós. Por exemplo, DaemonSets podem ser restritos a rodar apenas em nós com um determinado rótulo ou com hardware específico. À medida que o cluster muda (nós são adicionados, têm seus rótulos alterados ou são excluídos), o controlador do DaemonSet reconcilia continuamente o estado real com o estado desejado, garantindo que os pods estejam sempre implantados onde são necessários.
Casos de uso do DaemonSet no Kubernetes
Coleta de logs
A coleta de logs é um caso de uso comum para DaemonSets. Soluções de logging centralizado geralmente exigem que um agente esteja presente em cada nó para coletar e encaminhar logs de contêineres e componentes do sistema. Ao implantar um coletor de logs, como Fluentd ou Filebeat, como DaemonSet, os administradores garantem que todos os nós estejam cobertos, sem precisar implantar agentes manualmente nem se preocupar com novos nós sem o componente de logging. Essa abordagem simplifica o gerenciamento de logs e garante consistência em todo o cluster.
O uso de DaemonSets para coleta de logs também facilita o escalonamento de clusters. Quando novos nós entram, o controlador do DaemonSet implanta automaticamente o agente de logging, eliminando etapas manuais e reduzindo o risco de perder logs da infraestrutura recém-adicionada. Essa implantação automatizada em nível de nó torna os DaemonSets o método preferido para agregação de logs em todo o cluster em ambientes Kubernetes, apoiando iniciativas de conformidade e troubleshooting.
Conteúdo relacionado: leia nosso guia sobre logs do Kubernetes
Monitoramento de nós
O monitoramento de nós é outro cenário em que os DaemonSets se destacam. Ferramentas de monitoramento como Prometheus Node Exporter ou Datadog Agent costumam ser implantadas como DaemonSets para coletar métricas sobre a saúde dos nós, o uso de recursos e os workloads em execução. Com DaemonSets, esses agentes são distribuídos automaticamente para todos os nós, proporcionando visibilidade completa do estado operacional do cluster.
A implantação automática via DaemonSets garante que o monitoramento permaneça consistente à medida que o cluster muda. Quando nós são adicionados ou removidos, o controlador do DaemonSet ajusta a implantação do agente de monitoramento de acordo. Esse gerenciamento dinâmico simplifica as operações do cluster e garante que os administradores sempre tenham métricas atualizadas de cada nó, o que é fundamental para um planejamento de capacidade eficaz e para a resposta a incidentes.
Conteúdo relacionado: leia nosso guia sobre monitoramento do Kubernetes
Agentes de segurança e observabilidade
Agentes de segurança e observabilidade, como sistemas de detecção de intrusão ou coletores de tracing distribuído, muitas vezes precisam rodar em todos os nós para oferecer cobertura completa do cluster. Os DaemonSets facilitam a implantação uniforme desses agentes, garantindo que todo o tráfego e toda a atividade sejam monitorados em busca de ameaças ou gargalos de desempenho. Essa implantação uniforme é crucial para manter um ambiente Kubernetes seguro e observável.
Usar DaemonSets para agentes de segurança também apoia requisitos de conformidade, ao garantir que nenhum nó fique sem monitoramento. À medida que o cluster evolui, o DaemonSet se adapta automaticamente, mantendo a cobertura de segurança sem intervenção manual. Essa abordagem garante que as medidas de segurança e observabilidade acompanhem a natureza dinâmica dos clusters Kubernetes, reduzindo lacunas operacionais e riscos.
Device plugins do Kubernetes
Os device plugins do Kubernetes permitem expor hardware especializado, como GPUs ou FPGAs, aos pods. Esses plugins geralmente são implantados como DaemonSets para garantir que cada nó com o hardware apropriado execute o pod do device plugin necessário. Essa configuração permite que o Kubernetes agende workloads que exigem recursos de hardware específicos, atendendo a casos de uso como machine learning ou aceleração por hardware.
Implantar device plugins como DaemonSets garante que os recursos de hardware sejam gerenciados de forma consistente em todos os nós aplicáveis. Quando novos nós com hardware especializado são adicionados, o controlador do DaemonSet implanta automaticamente o device plugin correspondente, disponibilizando o recurso para o agendador. Essa abordagem automatizada simplifica as operações do cluster e maximiza a utilização do hardware especializado.
DaemonSet vs. Deployment no Kubernetes
Embora DaemonSets e Deployments gerenciem pods no Kubernetes, seus propósitos e comportamentos diferem significativamente. Os Deployments são projetados para manter um número específico de réplicas de pods, distribuindo-as pelos nós disponíveis para alcançar alta disponibilidade e balanceamento de carga. Isso torna os Deployments adequados para aplicações stateless, nas quais o objetivo principal é garantir um certo nível de redundância e escalabilidade, independentemente de quantos nós existam no cluster.
Os DaemonSets garantem que exatamente um pod (ou um número especificado) rode em cada nó ou em um subconjunto de nós. Isso é ideal para workloads que precisam estar presentes em todos os nós, como agentes de monitoramento, coletores de logs ou device plugins. Os DaemonSets se adaptam automaticamente conforme nós são adicionados ou removidos, enquanto os Deployments exigem escalonamento manual para acompanhar as mudanças nos nós. Entender essa distinção é fundamental para escolher o controlador certo para cada workload no Kubernetes.
| Aspecto | Deployment | DaemonSet |
|---|---|---|
| Propósito principal | Executa um número especificado de réplicas de uma aplicação | Executa um pod em cada nó ou em nós selecionados |
| Comportamento de escalonamento | Escalado manualmente ou via autoscaling com base no número de réplicas | Ajusta-se automaticamente conforme nós são adicionados ou removidos |
| Mais adequado para | Apps stateless, APIs, serviços web, workloads escaláveis | Agentes de monitoramento, coletores de logs, serviços em nível de nó |
| Posicionamento dos pods | O agendador do Kubernetes distribui os pods entre os nós | Garante que os pods sejam posicionados em cada nó elegível |
Tutorial de DaemonSet no Kubernetes
Este tutorial explica como criar e trabalhar com um DaemonSet. Ele foi adaptado da documentação do Kubernetes.
1. Crie um DaemonSet do Kubernetes
Para criar um DaemonSet do Kubernetes, defina-o em um manifesto YAML usando apiVersion: apps/v1 e kind: DaemonSet. O manifesto deve incluir os campos padrão do Kubernetes, como metadata e spec, além de um template de pod em .spec.template. O .spec.selector do DaemonSet deve corresponder aos rótulos atribuídos ao template do pod; depois que o DaemonSet é criado, esse seletor não pode mais ser alterado. O Kubernetes também exige que a política de reinicialização do pod seja Always, seja explicitamente ou pela configuração padrão.
Por exemplo, o manifesto a seguir cria um DaemonSet simples que executa um contêiner em cada nó elegível:
apiVersion: apps/v1kind: DaemonSetmetadata: name: example-daemonsetspec: selector: matchLabels: app.kubernetes.io/name: example template: metadata: labels: app.kubernetes.io/name: example spec: containers: - name: pause image: registry.k8s.io/pauseAdministradores podem estender o template do pod com opções como requests de recursos, montagens de volumes, tolerations, node selectors e afinidade de nós. Essas configurações determinam como os pods do DaemonSet são executados e, quando restrições de agendamento são especificadas, quais nós são elegíveis para hospedá-los. A documentação do Kubernetes traz um exemplo básico em que o DaemonSet agenda um pod em cada nó aplicável.
2. Implante um DaemonSet
Depois de criar o manifesto do DaemonSet, implante-o no cluster com kubectl apply. Se o manifesto estiver salvo localmente como daemonset.yaml, execute:
kubectl apply -f daemonset.yamlO Kubernetes também demonstra como aplicar um DaemonSet diretamente a partir de um manifesto YAML hospedado. Por exemplo:
kubectl apply -f https://k8s.io/examples/application/basic-daemonset.yamlO comando kubectl apply envia a configuração para a API do Kubernetes, e o controlador do DaemonSet determina quais nós são elegíveis e cria os pods necessários. À medida que nós elegíveis adicionais entram no cluster, o controlador cria automaticamente os pods do DaemonSet para eles. Pods associados a nós removidos são posteriormente eliminados pelo garbage collection.
Após a implantação, as alterações no DaemonSet geralmente podem ser gerenciadas modificando o manifesto e executando kubectl apply novamente. Para DaemonSets que usam a estratégia RollingUpdate, alterações no template do pod acionam uma atualização gradual dos pods gerenciados. O Kubernetes também suporta a estratégia de atualização OnDelete, para quando os administradores querem que os pods de substituição sejam criados somente depois que os existentes forem excluídos manualmente.
3. Verifique os pods do DaemonSet
Depois de implantar um DaemonSet, verifique se seus pods estão rodando nos nós esperados. A documentação do Kubernetes recomenda listar os pods com a opção -o wide, que inclui o nó atribuído a cada pod:
kubectl get pods -o widePara um DaemonSet projetado para rodar em todo o cluster, a saída deve mostrar um pod do DaemonSet em cada nó elegível. A coluna NODE facilita confirmar que os pods estão distribuídos conforme esperado.
Em ambientes com muitos workloads, use os rótulos definidos no template do pod do DaemonSet para limitar os resultados. Para o exemplo acima, o comando seria:
kubectl get pods -l app.kubernetes.io/name=example -o wideVocê também pode inspecionar o recurso DaemonSet em si com:
kubectl get daemonset example-daemonsetou usar o nome abreviado do recurso:
kubectl get ds example-daemonsetO status do DaemonSet ajuda os administradores a comparar o número desejado de pods com o número de pods atuais, prontos e disponíveis. Se pods individuais não estiverem rodando corretamente, comandos como kubectl describe pod <pod-name> e kubectl logs <pod-name> podem ser usados para investigar problemas de agendamento ou de contêiner. O tutorial básico de DaemonSet do Kubernetes verifica o sucesso da implantação checando se a lista de pods resultante contém um pod para cada nó aplicável.
Boas práticas de DaemonSet no Kubernetes
1. Faça o right-sizing de requests e limits de CPU e memória
Definir requests e limits apropriados de CPU e memória é fundamental para a estabilidade do DaemonSet. Requests definem os recursos mínimos que um pod exige, enquanto limits definem o máximo que ele pode consumir. O superprovisionamento desperdiça recursos e pode causar falhas de agendamento em nós com recursos limitados. O subprovisionamento traz risco de despejo (eviction) de pods ou degradação de desempenho. Analise o perfil de recursos do workload para determinar padrões razoáveis, garantindo que cada pod do DaemonSet caiba confortavelmente em todos os nós de destino.
Revise e ajuste regularmente as configurações de recursos conforme a aplicação evolui. Os requisitos de recursos podem mudar devido a novas funcionalidades, aumento de carga ou mudanças na infraestrutura subjacente. Em ambientes Kubernetes dinâmicos, o ajuste periódico de requests e limits evita a contenção de recursos e favorece a utilização eficiente do cluster. Integre as revisões de recursos ao seu processo de gestão de mudanças para uma otimização contínua.
2. Baseie as configurações de recursos no uso histórico
Os requests de recursos devem refletir como os pods do DaemonSet se comportam sob workloads reais, em vez de depender apenas de estimativas iniciais. Use métricas históricas de CPU e memória de ferramentas como Prometheus, Grafana ou sua plataforma de monitoramento na nuvem para identificar o uso típico, a demanda de pico e as diferenças entre nós. Defina requests altos o suficiente para sustentar a operação normal, evitando reservas desnecessárias de recursos em cada nó de destino.
Analise métricas baseadas em percentis ao longo de períodos representativos, em vez de usar médias de curto prazo. Os requests de CPU geralmente podem se basear no uso sustentado, com margem para picos, enquanto os requests de memória devem considerar os picos observados. Como os DaemonSets multiplicam seu consumo de recursos por todos os nós, até pequenas melhorias nas configurações por pod podem liberar uma capacidade significativa do cluster.
3. Trate a memória com mais cautela do que a CPU
Os limits de CPU e memória têm modos de falha diferentes no Kubernetes. Quando um contêiner atinge seu limit de CPU, o Kubernetes limita (throttle) o uso de CPU, o que normalmente causa processamento mais lento. Quando um contêiner ultrapassa seu limit de memória, porém, ele pode ser encerrado pelo kernel com um erro de falta de memória (OOM). Para agentes em nível de nó, reinicializações repetidas podem criar lacunas na cobertura de logging, monitoramento ou segurança.
Defina requests e limits de memória com margem suficiente para picos temporários e para o crescimento do workload. Monitore o uso de pico de memória e os eventos de OOM antes de reduzir as alocações. Para agentes com requisitos de memória imprevisíveis, um limit de memória restritivo pode ser mais prejudicial do que uma superalocação moderada; portanto, valide os limits com base nos padrões de uso em produção.
4. Use a estratégia de atualização adequada
Os DaemonSets suportam as estratégias de atualização RollingUpdate e OnDelete. A RollingUpdate, que é o padrão, substitui automaticamente os pods existentes quando o template do pod do DaemonSet muda. Configurações como maxUnavailable e maxSurge podem controlar quantos pods do DaemonSet ficam indisponíveis ou são adicionados temporariamente durante uma atualização.
Use OnDelete quando a substituição de pods precisar ser controlada explicitamente. Com essa estratégia, atualizar o template do pod não substitui automaticamente os pods existentes; os administradores devem excluí-los antes que o Kubernetes crie pods a partir do novo template. Seja qual for a estratégia escolhida, considere o impacto de agentes indisponíveis na cobertura de logging, monitoramento, rede ou segurança durante as atualizações.
5. Monitore continuamente a eficiência conforme o cluster muda
O consumo de recursos de um DaemonSet cresce com o número de nós elegíveis. Um pod que usa recursos modestos em um nó pode representar um consumo agregado substancial de CPU e memória em um cluster grande. Acompanhe tanto o uso por pod quanto o total de recursos consumidos por cada DaemonSet para entender seu impacto na capacidade do cluster.
Reavalie os DaemonSets quando os tipos de nó, os workloads ou o tamanho do cluster mudarem. Fique atento a requests de recursos não utilizados, throttling de CPU, pressão de memória, eventos de OOM, reinicializações e pods que não conseguem ser agendados. O monitoramento contínuo ajuda a identificar quando as configurações de recursos ou as regras de agendamento deixam de corresponder às condições reais de operação.
Otimizando o uso de recursos de DaemonSets com o PerfectScale
Como um DaemonSet posiciona um pod em cada nó elegível, até pequenas quantidades de super ou subprovisionamento se multiplicam pelo cluster. O PerfectScale by DoiT é uma plataforma de otimização de Kubernetes que é implantada com um único comando Helm e, a partir daí, entrega insights acionáveis e otimização autônoma em toda a stack K8s, para que agentes em nível de nó, como coletores de logs, exportadores de monitoramento e daemons de segurança, rodem com os recursos de que realmente precisam.
Principais recursos do PerfectScale:
- Right-sizing autônomo de workloads: o Podfit oferece uma visão granular da saúde e dos custos do cluster, prioriza as áreas que exigem atenção e otimiza workloads de forma autônoma com recomendações de right-sizing baseadas em dados, que podem ser aplicadas automaticamente.
- Otimização da utilização dos nós: o Infrafit fornece visibilidade abrangente da utilização dos nós e insights granulares que identificam e eliminam capacidade ociosa, além de ajudar a selecionar os nós certos para os seus workloads.
- Alinhamento com autoscalers: funciona em conjunto com HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot, com recomendações acionáveis para melhorar suas configurações.
- Alertas em tempo real com priorização: a autopriorização avançada destaca os riscos de resiliência, picos de custo e anomalias de maior impacto antes que afetem os usuários ou a fatura da nuvem, com alertas enviados para Slack, Datadog, MS Teams ou PagerDuty.
- Relatórios de tendências e governança: o relatório de Trends oferece visibilidade aprofundada das métricas de custo, desperdício e risco ao longo do tempo, por clusters, grupos de nós, namespaces e workloads, apoiando previsões e análise de causa raiz.
- Amplo suporte a ambientes: funciona em clusters on-premise e na nuvem, incluindo OpenShift, EKS, GKE e AKS, e suporta contêineres baseados em Windows, além de workloads efêmeros e de ML.