


Kubernetes DaemonSetとは?
DaemonSetは、クラスター内のすべての(または選択した)ノードで特定のPodのコピーが実行されることを保証する、Kubernetesの中核的なワークロードコントローラーです。クラスターに新しいノードが追加されると、DaemonSetは自動的にそのノード上でPodを起動します。ノードが削除されると、関連するPodはガベージコレクションされます。
クラスター全体でレプリカの総「数」を維持することに重点を置くDeploymentとは異なり、DaemonSetはノード単位のカバレッジに重点を置き、Podのスケジューリングをクラスターのノードトポロジーに紐づけます。これにより、監視エージェントやログコレクターといった特定のワークロードが、インフラ全体に均等かつ一貫して配置され、均一なカバレッジと機能が保証されます。DaemonSetは、運用の一貫性を保つためにすべてのノード、または特定のノードで実行する必要があるワークロードに不可欠です。
以下はDaemonSetのYAMLマニフェストの例です:
次の例では、クラスター上でfluentdロギングエージェントを実行するDaemonSetを定義しています。
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluentd-logging namespace: kube-systemspec: selector: matchLabels: name: fluentd-logging template: metadata: labels: name: fluentd-logging spec: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists containers: - name: fluentd image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1DaemonSetの代表的なユースケース:
- ログ収集: Fluentd、Filebeat、Logstashなどのエージェントをすべてのノードで実行し、コンテナやシステムのログを収集・転送します。
- ノード監視: Prometheus Node ExporterやDatadog Agentなどのツールを各ノードにデプロイし、健全性、リソース、ワークロードのメトリクスを収集します。
- セキュリティ・オブザーバビリティエージェント: 侵入検知、トレーシング、オブザーバビリティのエージェントをすべてのノードで実行し、クラスター全体を一貫してカバーします。
- Kubernetesデバイスプラグイン: GPUやFPGAなどの特殊なハードウェアを搭載したノードでデバイスプラグインを実行し、Kubernetesがそれらのリソースをワークロードに公開できるようにします。
本記事は、Kubernetesオブジェクトに関する連載記事の一部です。
この記事の内容:
- DaemonSetの仕組み
- Kubernetes DaemonSetのユースケース
- Kubernetes DaemonSetとDeploymentの比較
- Kubernetes DaemonSetチュートリアル
- Kubernetes DaemonSetのベストプラクティス
DaemonSetの仕組み
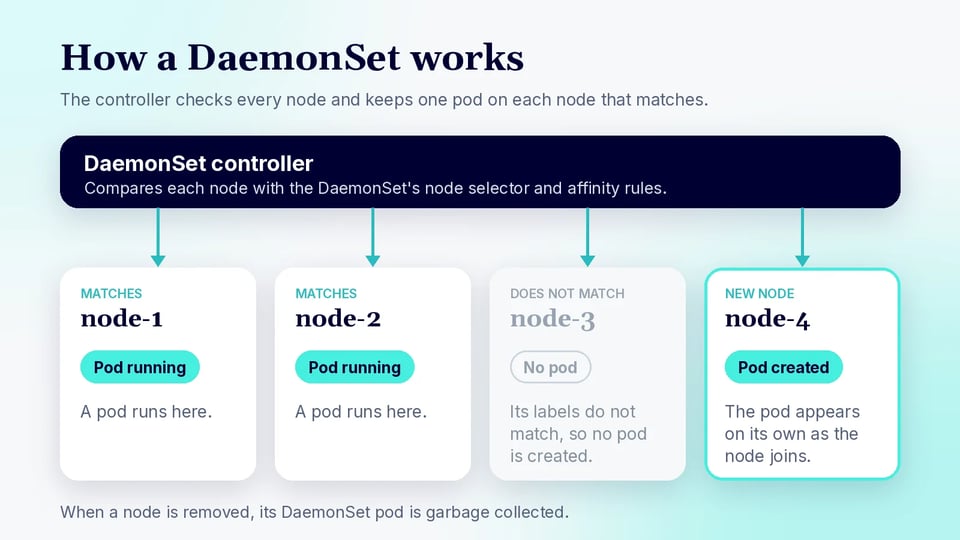
DaemonSetが作成されると、Kubernetesコントロールプレーンは各ノードをDaemonSetのスケジューリング条件に照らして評価します。ノードが条件に一致する場合、DaemonSetコントローラーはそのノード上に指定されたPodを作成します。その後ノードがクラスターから削除されると、そのDaemonSetのPodはガベージコレクションされます。
ノードのラベルが変更され、DaemonSetのノードセレクターやアフィニティルールに一致しなくなった場合、コントローラーはそのPodを削除します。コントローラーはnode.kubernetes.io/unschedulableテイントに対するtolerationを自動的に追加するため、DaemonSetのPodはcordon済みのノード上でも実行され続け、そうしたノードにスケジュールすることも可能です。この仕組みにより、DaemonSetのPodはクラスターの状態に密接に追従し、ユーザーの介入なしにノードの変化に適応します。
DaemonSetは、ノードアフィニティ、toleration、セレクターといった高度なスケジューリング機能をサポートしており、管理者は特定のノードのサブセットを対象にできます。たとえば、特定のキーでラベル付けされたノードや、特定のハードウェアを搭載したノードのみでDaemonSetを実行するよう制限できます。クラスターが変化する(ノードの追加、ラベル変更、削除が行われる)につれて、DaemonSetコントローラーは実際の状態と望ましい状態を継続的に調整し、必要な場所に常にPodがデプロイされるようにします。
Kubernetes DaemonSetのユースケース
ログ収集
ログ収集はDaemonSetの代表的なユースケースです。集中ログ管理ソリューションでは、コンテナやシステムコンポーネントからログを収集・転送するために、すべてのノードにエージェントを配置する必要があることがよくあります。FluentdやFilebeatなどのログコレクターをDaemonSetとしてデプロイすることで、管理者はエージェントを手動でデプロイしたり、新しいノードにロギングコンポーネントが欠けることを心配したりすることなく、すべてのノードをカバーできます。このアプローチにより、ログ管理が効率化され、クラスター全体での一貫性が確保されます。
ログ収集にDaemonSetを使用することで、クラスターのスケーリングも簡単になります。新しいノードが参加すると、DaemonSetコントローラーが自動的にロギングエージェントをデプロイするため、手動の作業が不要になり、新しく追加されたインフラからのログ欠落リスクも低減されます。この自動化されたノード単位のデプロイにより、DaemonSetはKubernetes環境におけるクラスター全体のログ集約の定番手法となっており、コンプライアンスやトラブルシューティングの取り組みを支えています。
関連記事:Kubernetesのログに関するガイドもご覧ください
ノード監視
ノード監視も、DaemonSetが真価を発揮するシナリオです。Prometheus Node ExporterやDatadog Agentなどの監視ツールは、ノードの健全性、リソース使用状況、実行中のワークロードに関するメトリクスを収集するために、通常DaemonSetとしてデプロイされます。DaemonSetを活用することで、これらのエージェントはすべてのノードに自動的に配置され、クラスターの運用状態を包括的に可視化できます。
DaemonSetによる自動デプロイにより、クラスターが変化しても監視の一貫性が保たれます。ノードが追加・削除されると、DaemonSetコントローラーがそれに応じて監視エージェントのデプロイを調整します。この動的な管理によりクラスター運用が簡素化され、管理者は常にすべてのノードの最新メトリクスを把握できます。これは効果的なキャパシティプランニングやインシデント対応に不可欠です。
関連記事:Kubernetesの監視に関するガイドもご覧ください
セキュリティ・オブザーバビリティエージェント
侵入検知システムや分散トレーシングコレクターなどのセキュリティ・オブザーバビリティエージェントは、クラスター全体をカバーするためにすべてのノードで実行する必要があることがよくあります。DaemonSetを使えばこれらのエージェントを均一にデプロイでき、すべてのトラフィックとアクティビティに対して脅威やパフォーマンスのボトルネックを監視できます。この均一なデプロイは、安全で可観測性の高いKubernetes環境を維持するうえで極めて重要です。
セキュリティエージェントにDaemonSetを使用することは、監視されないノードが残らないことを保証するため、コンプライアンス要件への対応にも役立ちます。クラスターが変化しても、DaemonSetは自動的に適応し、手動の介入なしにセキュリティカバレッジを維持します。このアプローチにより、セキュリティとオブザーバビリティの対策がKubernetesクラスターの動的な性質に追従し、運用上のギャップとリスクを低減できます。
Kubernetesデバイスプラグイン
Kubernetesのデバイスプラグインは、GPUやFPGAなどの特殊なハードウェアをPodに公開するための仕組みです。これらのプラグインは通常、適切なハードウェアを搭載した各ノードで必要なデバイスプラグインPodが実行されるよう、DaemonSetとしてデプロイされます。この構成により、Kubernetesは特定のハードウェアリソースを必要とするワークロードをスケジュールでき、機械学習やハードウェアアクセラレーションといったユースケースをサポートします。
デバイスプラグインをDaemonSetとしてデプロイすることで、該当するすべてのノードでハードウェアリソースが一貫して管理されることが保証されます。特殊なハードウェアを搭載した新しいノードが追加されると、DaemonSetコントローラーが対応するデバイスプラグインを自動的にデプロイし、そのリソースをスケジューラーに公開します。この自動化されたアプローチにより、クラスター運用が効率化され、特殊なハードウェアの利用率を最大限に高められます。
Kubernetes DaemonSetとDeploymentの比較
DaemonSetとDeploymentはどちらもKubernetesでPodを管理しますが、その目的と動作は大きく異なります。Deploymentは指定された数のPodレプリカを維持するよう設計されており、利用可能なノード全体にレプリカを分散させて高可用性と負荷分散を実現します。これは、クラスターのノード数に関係なく、一定の冗長性とスケーラビリティを確保することが主な目的であるステートレスなアプリケーションに適しています。
DaemonSetは、各ノード、またはノードのサブセット上で、ちょうど1つの(あるいは指定された数の)Podが実行されることを保証します。これは、監視エージェント、ログコレクター、デバイスプラグインなど、すべてのノードに存在する必要があるワークロードに最適です。DaemonSetはノードの追加や削除に自動的に適応しますが、Deploymentはノードの変化に合わせて手動でスケーリングする必要があります。この違いを理解することは、Kubernetesで特定のワークロードに適したコントローラーを選ぶうえで重要です。
| 観点 | Deployment | DaemonSet |
|---|---|---|
| 主な目的 | アプリケーションの指定された数のレプリカを実行 | すべてのノードまたは選択したノードでPodを実行 |
| スケーリング動作 | レプリカ数に基づいて手動またはオートスケーリングで調整 | ノードの追加・削除に合わせて自動的に調整 |
| 適した用途 | ステートレスアプリ、API、Webサービス、スケーラブルなワークロード | 監視エージェント、ログコレクター、ノードレベルのサービス |
| Podの配置 | KubernetesスケジューラーがノードにPodを分散配置 | 対象となる各ノードにPodが配置されることを保証 |
Kubernetes DaemonSetチュートリアル
このチュートリアルでは、DaemonSetの作成方法と使い方を解説します。内容はKubernetesドキュメントを基にしています。
1. Kubernetes DaemonSetを作成する
Kubernetes DaemonSetを作成するには、apiVersion: apps/v1とkind: DaemonSetを使用してYAMLマニフェストで定義します。マニフェストには、metadataやspecといった標準的なKubernetesフィールドに加えて、.spec.template配下のPodテンプレートを含める必要があります。DaemonSetの.spec.selectorはPodテンプレートに割り当てられたラベルと一致していなければならず、DaemonSetの作成後にこのセレクターを変更することはできません。また、Podの再起動ポリシーは、明示的に指定するかデフォルト設定によって、Alwaysである必要があります。
たとえば、次のマニフェストは、対象となる各ノードでコンテナを実行するシンプルなDaemonSetを作成します。
apiVersion: apps/v1kind: DaemonSetmetadata: name: example-daemonsetspec: selector: matchLabels: app.kubernetes.io/name: example template: metadata: labels: app.kubernetes.io/name: example spec: containers: - name: pause image: registry.k8s.io/pause管理者は、リソースリクエスト、ボリュームマウント、toleration、ノードセレクター、ノードアフィニティなどのオプションでPodテンプレートを拡張できます。これらの設定は、DaemonSetのPodの実行方法と、スケジューリング制約が指定されている場合にはどのノードがPodをホストできるかを決定します。Kubernetesドキュメントでは、DaemonSetが該当するすべてのノードにPodを1つずつスケジュールする基本的な例が紹介されています。
2. DaemonSetをデプロイする
DaemonSetのマニフェストを作成したら、kubectl applyでクラスターにデプロイします。マニフェストをローカルにdaemonset.yamlとして保存している場合は、次のように実行します。
kubectl apply -f daemonset.yamlKubernetesドキュメントでは、Web上で公開されているYAMLマニフェストから直接DaemonSetを適用する例も示されています。たとえば次のとおりです。
kubectl apply -f https://k8s.io/examples/application/basic-daemonset.yamlkubectl applyコマンドは設定をKubernetes APIに送信し、その後DaemonSetコントローラーが対象ノードを判定して必要なPodを作成します。対象となるノードが新たにクラスターに参加すると、コントローラーはそれらのノードに対しても自動的にDaemonSetのPodを作成します。削除されたノードに関連付けられていたPodは、その後ガベージコレクションされます。
デプロイ後のDaemonSetへの変更は、通常、マニフェストを修正して再度kubectl applyを実行することで管理できます。RollingUpdate戦略を使用するDaemonSetでは、Podテンプレートの変更によって管理対象Podのローリングアップデートがトリガーされます。既存のPodを手動で削除した後にのみ置き換えのPodを作成したい場合に備えて、KubernetesはOnDelete更新戦略もサポートしています。
3. DaemonSetのPodを確認する
DaemonSetのデプロイ後は、そのPodが想定どおりのノードで実行されているかを確認します。Kubernetesドキュメントでは、各Podに割り当てられたノードが表示される-o wideオプションを付けてPodを一覧表示することを推奨しています。
kubectl get pods -o wideクラスター全体で実行することを意図したDaemonSetであれば、出力には対象となる各ノードにDaemonSetのPodが表示されるはずです。NODE列を見れば、Podが想定どおりに分散されていることを簡単に確認できます。
多くのワークロードが存在する環境では、DaemonSetのPodテンプレートで定義したラベルを使って結果を絞り込みます。先ほどの例であれば、コマンドは次のようになります。
kubectl get pods -l app.kubernetes.io/name=example -o wideDaemonSetリソース自体を確認することもできます。
kubectl get daemonset example-daemonsetまたは省略形のリソース名を使用します。
kubectl get ds example-daemonsetDaemonSetのステータスを見れば、望ましいPod数と、現在稼働中・Ready・利用可能なPod数を比較できます。個々のPodが正しく実行されていない場合は、kubectl describe pod <pod-name>やkubectl logs <pod-name>などのコマンドで、スケジューリングやコンテナレベルの問題を調査できます。Kubernetesの基本的なDaemonSetチュートリアルでは、該当するすべてのノードに対してPodが1つずつ存在することをPod一覧で確認することで、デプロイの成功を検証しています。
Kubernetes DaemonSetのベストプラクティス
1. CPUとメモリのrequests/limitsをライトサイジングする
適切なCPUおよびメモリのrequestsとlimitsの設定は、DaemonSetの安定性にとって極めて重要です。requestsはPodが必要とする最小リソースを定義し、limitsは消費できる最大量を設定します。過剰なプロビジョニングはリソースの無駄になり、リソースに制約のあるノードでスケジューリングが失敗する原因にもなります。一方、プロビジョニングが不足すると、Podの退避やパフォーマンス低下のリスクがあります。ワークロードのリソースプロファイルを分析して妥当なデフォルト値を決定し、各DaemonSetのPodが対象となるすべてのノードに無理なく収まるようにしましょう。
アプリケーションの進化に合わせて、リソース設定を定期的に見直し、調整してください。新機能の追加、負荷の増加、基盤インフラの変更などにより、リソース要件は変わる可能性があります。動的なKubernetes環境では、requestsとlimitsを定期的にチューニングすることでリソースの競合を防ぎ、クラスターの効率的な利用を支えられます。継続的な最適化のため、リソースの見直しを変更管理プロセスに組み込みましょう。
2. 過去の使用実績に基づいてリソースを設定する
リソースリクエストは、初期の見積もりだけに頼るのではなく、実際のワークロード下でのDaemonSet Podの挙動を反映すべきです。Prometheus、Grafana、またはクラウドの監視プラットフォームなどのツールから得られる過去のCPUとメモリのメトリクスを活用し、通常時の使用量、ピーク時の需要、ノード間の差異を把握しましょう。requestsは通常運用を支えるのに十分な高さに設定しつつ、対象となるすべてのノードで不要なリソース予約が発生しないようにします。
短期的な平均値ではなく、代表的な期間にわたるパーセンタイルベースのメトリクスを確認してください。CPUリクエストは多くの場合、バースト用の余裕を持たせた持続的な使用量を基準にでき、メモリリクエストは観測されたピークを考慮する必要があります。DaemonSetはリソースフットプリントがノード数分だけ増幅されるため、Pod単位の設定をわずかに改善するだけでも、クラスター容量を大きく解放できます。
3. メモリはCPUよりも保守的に扱う
Kubernetesでは、CPUとメモリのlimitsの障害モードが異なります。コンテナがCPU limitに達すると、KubernetesはCPU使用をスロットリングするため、通常は処理が遅くなるだけです。しかし、コンテナがメモリlimitを超えると、カーネルによってOOM(out-of-memory)エラーで強制終了される可能性があります。ノードレベルのエージェントの場合、再起動の繰り返しによって、ロギング、監視、セキュリティのカバレッジに空白が生じかねません。
一時的なスパイクやワークロードの増加を見込んで、メモリのrequestsとlimitsに十分な余裕を持たせましょう。割り当てを削減する前に、ピーク時のメモリ使用量とOOMイベントを監視してください。メモリ要件が予測しにくいエージェントの場合、厳しすぎるメモリlimitは適度な過剰割り当てよりも大きな混乱を招く可能性があるため、本番環境の使用パターンに照らしてlimitsを検証しましょう。
4. 適切な更新戦略を使用する
DaemonSetはRollingUpdateとOnDeleteの更新戦略をサポートしています。デフォルトのRollingUpdateでは、DaemonSetのPodテンプレートが変更されると既存のPodが自動的に置き換えられます。maxUnavailableやmaxSurgeといった設定で、更新中に利用できなくなるPod数や一時的に追加されるPod数を制御できます。
Podの置き換えを明示的に制御する必要がある場合はOnDeleteを使用します。この戦略では、Podテンプレートを更新しても既存のPodは自動的に置き換えられず、管理者が削除した後に初めてKubernetesが新しいテンプレートからPodを作成します。どちらの戦略を選ぶ場合でも、更新中にエージェントが一時的に利用できなくなることが、ロギング、監視、ネットワーク、セキュリティのカバレッジに与える影響を考慮してください。
5. クラスターの変化に合わせて効率を継続的に監視する
DaemonSetのリソース消費は、対象ノード数の増加とともに増大します。1つのノードでは控えめなリソースしか使わないPodでも、大規模クラスターでは合計で相当量のCPUとメモリを消費することになります。Pod単位の使用量と各DaemonSetが消費するリソースの総量の両方を追跡し、クラスター容量への影響を把握しましょう。
ノードタイプ、ワークロード、クラスターサイズが変化したときは、DaemonSetを再評価してください。未使用のリソースリクエスト、CPUスロットリング、メモリ逼迫、OOMイベント、再起動、スケジュールに失敗するPodに注意を払いましょう。継続的な監視により、リソース設定やスケジューリングルールが実際の運用状況と合わなくなったタイミングを特定できます。
PerfectScaleでDaemonSetのリソース使用を最適化
DaemonSetは対象となるすべてのノードにPodを配置するため、わずかな過剰・過少プロビジョニングでもクラスター全体で何倍にも膨らみます。PerfectScale by DoiTは、Helmコマンド1つでデプロイできるKubernetes最適化プラットフォームで、K8sスタック全体にわたって実用的なインサイトと自律的な最適化を提供します。これにより、ログコレクター、監視エクスポーター、セキュリティデーモンといったノードレベルのエージェントが、実際に必要なリソースで稼働するようになります。
PerfectScaleの主な機能:
- 自律的なワークロードのライトサイジング: Podfitは、クラスターの健全性とコストをきめ細かく可視化し、対応が必要な領域に優先順位を付け、データに基づくライトサイジングの推奨事項(自動適用も可能)によってワークロードを自律的に最適化します。
- ノード使用率の最適化: Infrafitは、ノード使用率を包括的に可視化し、きめ細かなインサイトによってアイドル状態のノード容量を特定・排除するとともに、ワークロードに最適なノードの選択を支援します。
- オートスケーラーとの連携: HPA、KEDA、Karpenter、Cluster Autoscaler、EKS Auto Mode、Fargate、Node Auto Provisioning、Google Autopilotと併用でき、それらの設定を改善するための実用的な推奨事項を提供します。
- 優先順位付きのリアルタイムアラート: 高度な自動優先順位付けにより、最も影響の大きいレジリエンスリスク、コスト急増、異常を、ユーザーやクラウド料金に影響が及ぶ前に検出し、Slack、Datadog、MS Teams、PagerDutyにアラートを配信します。
- トレンド・ガバナンスレポート: Trendsレポートは、クラスター、ノードグループ、名前空間、ワークロードを横断して、コスト、無駄、リスクのメトリクスを時系列で詳細に可視化し、予測や根本原因分析を支援します。
- 幅広い環境サポート: OpenShift、EKS、GKE、AKSを含むオンプレミスおよびクラウドベースのクラスターで動作し、Windowsベースのコンテナ、エフェメラルワークロード、MLワークロードもサポートします。