


Was ist ein Kubernetes DaemonSet?
Ein DaemonSet ist ein zentraler Kubernetes-Workload-Controller, der sicherstellt, dass eine Kopie eines bestimmten Pods auf allen (oder ausgewählten) Nodes eines Clusters läuft. Wird dem Cluster ein neuer Node hinzugefügt, startet das DaemonSet darauf automatisch einen Pod; wird ein Node entfernt, wird der zugehörige Pod per Garbage Collection bereinigt.
Im Gegensatz zu Deployments, die eine bestimmte Anzahl von Replikaten über das gesamte Cluster hinweg aufrechterhalten, konzentrieren sich DaemonSets auf Abdeckung auf Node-Ebene und koppeln das Pod-Scheduling an die Node-Topologie des Clusters. So ist garantiert, dass bestimmte Workloads – etwa Monitoring-Agents oder Log-Collectors – gleichmäßig und konsistent über die Infrastruktur verteilt werden und überall dieselbe Abdeckung und Funktionalität bieten. DaemonSets sind unverzichtbar für Workloads, die aus Gründen der betrieblichen Konsistenz auf allen oder auf bestimmten Nodes laufen müssen.
Hier ein Beispiel für ein YAML-Manifest eines DaemonSets:
Das folgende Beispiel definiert ein DaemonSet, das einen fluentd-Logging-Agent im Cluster ausführt:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluentd-logging namespace: kube-systemspec: selector: matchLabels: name: fluentd-logging template: metadata: labels: name: fluentd-logging spec: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists containers: - name: fluentd image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1Typische Use Cases für DaemonSets:
- Log-Erfassung: Agents wie Fluentd, Filebeat oder Logstash laufen auf jedem Node, um Container- und Systemlogs zu sammeln und weiterzuleiten.
- Node-Monitoring: Tools wie Prometheus Node Exporter oder der Datadog Agent werden auf jedem Node bereitgestellt, um Metriken zu Zustand, Ressourcen und Workloads zu erfassen.
- Security- und Observability-Agents: Intrusion-Detection-, Tracing- oder Observability-Agents laufen auf allen Nodes und gewährleisten eine konsistente Cluster-Abdeckung.
- Kubernetes Device Plugins: Device Plugins laufen auf Nodes mit spezieller Hardware wie GPUs oder FPGAs, damit Kubernetes diese Ressourcen Workloads zur Verfügung stellen kann.
Dieser Artikel ist Teil einer Serie über Kubernetes-Objekte.
In diesem Artikel:
- Wie funktioniert ein DaemonSet?
- Use Cases für Kubernetes DaemonSets
- Kubernetes DaemonSet vs. Deployment
- Kubernetes-DaemonSet-Tutorial
- Best Practices für Kubernetes DaemonSets
Wie funktioniert ein DaemonSet?
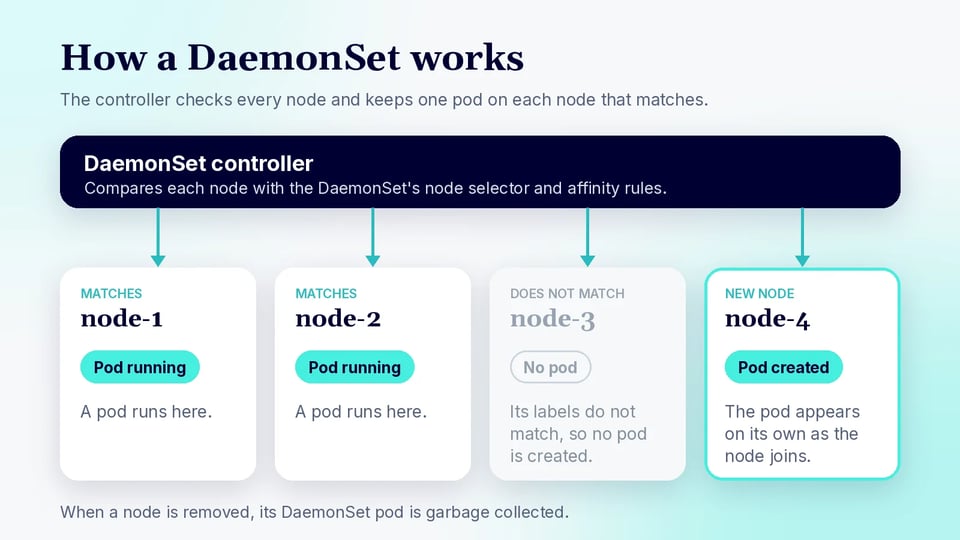
Wird ein DaemonSet erstellt, bewertet die Kubernetes Control Plane jeden Node anhand der Scheduling-Kriterien des DaemonSets. Passt ein Node, erstellt der DaemonSet-Controller den angegebenen Pod auf diesem Node. Wird der Node später aus dem Cluster entfernt, wird sein DaemonSet-Pod per Garbage Collection bereinigt.
Ändern sich die Labels eines Nodes, sodass er nicht mehr zum Node-Selektor oder zu den Affinity-Regeln des DaemonSets passt, löscht der Controller den Pod. Der Controller fügt automatisch eine Toleration für den Taint node.kubernetes.io/unschedulable hinzu, sodass DaemonSet-Pods auf abgesperrten (cordoned) Nodes weiterlaufen und sogar darauf eingeplant werden können. Dieser Mechanismus sorgt dafür, dass DaemonSet-Pods dem Zustand des Clusters eng folgen und sich ohne Eingriff der Nutzer an Node-Änderungen anpassen.
DaemonSets unterstützen erweiterte Scheduling-Funktionen wie Node Affinity, Tolerations und Selektoren, mit denen Administratoren gezielt bestimmte Node-Gruppen ansteuern können. So lassen sich DaemonSets etwa auf Nodes mit einem bestimmten Label oder mit spezieller Hardware beschränken. Wenn sich das Cluster verändert (Nodes werden hinzugefügt, neu gelabelt oder gelöscht), gleicht der DaemonSet-Controller den Ist-Zustand kontinuierlich mit dem Soll-Zustand ab und stellt sicher, dass Pods immer dort laufen, wo sie gebraucht werden.
Use Cases für Kubernetes DaemonSets
Log-Erfassung
Die Log-Erfassung ist ein klassischer Use Case für DaemonSets. Zentralisierte Logging-Lösungen benötigen häufig einen Agent auf jedem Node, um Logs von Containern und Systemkomponenten zu sammeln und weiterzuleiten. Indem Administratoren einen Log-Collector wie Fluentd oder Filebeat als DaemonSet bereitstellen, stellen sie sicher, dass jeder Node abgedeckt ist – ohne Agents manuell zu deployen oder sich Sorgen zu machen, dass neuen Nodes die Logging-Komponente fehlt. Dieser Ansatz vereinfacht das Log-Management und sorgt für Konsistenz im gesamten Cluster.
Der Einsatz von DaemonSets für die Log-Erfassung vereinfacht auch das Skalieren von Clustern. Treten neue Nodes bei, stellt der DaemonSet-Controller den Logging-Agent automatisch bereit, wodurch manuelle Schritte entfallen und das Risiko fehlender Logs von neu hinzugefügter Infrastruktur sinkt. Diese automatisierte Bereitstellung auf Node-Ebene macht DaemonSets zur bevorzugten Methode für clusterweite Log-Aggregation in Kubernetes-Umgebungen und unterstützt Compliance- und Troubleshooting-Initiativen.
Verwandte Inhalte: Lesen Sie unseren Leitfaden zu Kubernetes-Logs
Node-Monitoring
Node-Monitoring ist ein weiteres Szenario, in dem DaemonSets ihre Stärken ausspielen. Monitoring-Tools wie Prometheus Node Exporter oder der Datadog Agent werden typischerweise als DaemonSets bereitgestellt, um Metriken zu Node-Zustand, Ressourcennutzung und laufenden Workloads zu erfassen. Über DaemonSets werden diese Agents automatisch auf jeden Node verteilt und bieten umfassende Transparenz über den Betriebszustand des Clusters.
Die automatische Bereitstellung über DaemonSets stellt sicher, dass das Monitoring auch bei Cluster-Änderungen konsistent bleibt. Werden Nodes hinzugefügt oder entfernt, passt der DaemonSet-Controller die Bereitstellung des Monitoring-Agents entsprechend an. Dieses dynamische Management vereinfacht den Cluster-Betrieb und stellt sicher, dass Administratoren jederzeit aktuelle Metriken für jeden Node haben – entscheidend für effektive Kapazitätsplanung und Incident Response.
Verwandte Inhalte: Lesen Sie unseren Leitfaden zu Kubernetes-Monitoring
Security- und Observability-Agents
Security- und Observability-Agents, etwa Intrusion-Detection-Systeme oder Collector für Distributed Tracing, müssen oft auf jedem Node laufen, um das gesamte Cluster abzudecken. Mit DaemonSets lassen sich diese Agents unkompliziert und einheitlich bereitstellen, sodass der gesamte Traffic und alle Aktivitäten auf Bedrohungen oder Performance-Engpässe überwacht werden. Diese einheitliche Bereitstellung ist entscheidend für eine sichere und beobachtbare Kubernetes-Umgebung.
Der Einsatz von DaemonSets für Security-Agents unterstützt zudem Compliance-Anforderungen, da garantiert kein Node unüberwacht bleibt. Entwickelt sich das Cluster weiter, passt sich das DaemonSet automatisch an und hält die Security-Abdeckung ohne manuelle Eingriffe aufrecht. So halten Security- und Observability-Maßnahmen mit der Dynamik von Kubernetes-Clustern Schritt, und betriebliche Lücken und Risiken werden reduziert.
Kubernetes Device Plugins
Kubernetes Device Plugins ermöglichen es, spezielle Hardware wie GPUs oder FPGAs für Pods verfügbar zu machen. Diese Plugins werden typischerweise als DaemonSets bereitgestellt, damit jeder Node mit der entsprechenden Hardware den nötigen Device-Plugin-Pod ausführt. So kann Kubernetes Workloads einplanen, die bestimmte Hardware-Ressourcen benötigen – etwa für Machine Learning oder Hardware-Beschleunigung.
Die Bereitstellung von Device Plugins als DaemonSets garantiert, dass Hardware-Ressourcen auf allen relevanten Nodes konsistent verwaltet werden. Kommen neue Nodes mit spezieller Hardware hinzu, stellt der DaemonSet-Controller das entsprechende Device Plugin automatisch bereit und macht die Ressource für den Scheduler verfügbar. Dieser automatisierte Ansatz vereinfacht den Cluster-Betrieb und maximiert die Auslastung spezialisierter Hardware.
Kubernetes DaemonSet vs. Deployment
DaemonSets und Deployments verwalten beide Pods in Kubernetes, unterscheiden sich aber deutlich in Zweck und Verhalten. Deployments sind darauf ausgelegt, eine festgelegte Anzahl von Pod-Replikaten aufrechtzuerhalten und über die verfügbaren Nodes zu verteilen, um Hochverfügbarkeit und Lastverteilung zu erreichen. Deployments eignen sich daher für zustandslose Anwendungen, bei denen es primär um Redundanz und Skalierbarkeit geht – unabhängig davon, wie viele Nodes das Cluster hat.
DaemonSets stellen sicher, dass genau ein Pod (oder eine festgelegte Anzahl) auf jedem Node oder auf einer Teilmenge von Nodes läuft. Das ist ideal für Workloads, die auf jedem Node präsent sein müssen, etwa Monitoring-Agents, Log-Collectors oder Device Plugins. DaemonSets passen sich automatisch an, wenn Nodes hinzugefügt oder entfernt werden, während Deployments manuell skaliert werden müssen, um Node-Änderungen abzubilden. Diesen Unterschied zu verstehen ist entscheidend, um den richtigen Controller für den jeweiligen Workload in Kubernetes zu wählen.
| Aspekt | Deployment | DaemonSet |
|---|---|---|
| Hauptzweck | Führt eine festgelegte Anzahl von Replikaten einer Anwendung aus | Führt auf jedem Node oder auf ausgewählten Nodes einen Pod aus |
| Skalierungsverhalten | Manuelle Skalierung oder Autoscaling anhand der Replikatanzahl | Passt sich automatisch an, wenn Nodes hinzugefügt oder entfernt werden |
| Ideal für | Zustandslose Apps, APIs, Webservices, skalierbare Workloads | Monitoring-Agents, Log-Collectors, Dienste auf Node-Ebene |
| Pod-Platzierung | Der Kubernetes-Scheduler verteilt Pods über die Nodes | Stellt sicher, dass Pods auf jedem passenden Node platziert werden |
Kubernetes-DaemonSet-Tutorial
Dieses Tutorial erklärt, wie Sie ein DaemonSet erstellen und damit arbeiten. Es basiert auf der Kubernetes-Dokumentation.
1. Ein Kubernetes DaemonSet erstellen
Um ein Kubernetes DaemonSet zu erstellen, definieren Sie es in einem YAML-Manifest mit apiVersion: apps/v1 und kind: DaemonSet. Das Manifest muss Standard-Kubernetes-Felder wie metadata und spec enthalten sowie ein Pod-Template unter .spec.template. Der .spec.selector des DaemonSets muss mit den Labels des Pod-Templates übereinstimmen; nach der Erstellung des DaemonSets kann dieser Selektor nicht mehr geändert werden. Kubernetes verlangt außerdem, dass die Restart-Policy des Pods auf Always gesetzt ist – entweder explizit oder über die Standardeinstellung.
Das folgende Manifest erstellt beispielsweise ein einfaches DaemonSet, das auf jedem passenden Node einen Container ausführt:
apiVersion: apps/v1kind: DaemonSetmetadata: name: example-daemonsetspec: selector: matchLabels: app.kubernetes.io/name: example template: metadata: labels: app.kubernetes.io/name: example spec: containers: - name: pause image: registry.k8s.io/pauseAdministratoren können das Pod-Template um Optionen wie Resource Requests, Volume Mounts, Tolerations, Node-Selektoren und Node Affinity erweitern. Diese Einstellungen bestimmen, wie die DaemonSet-Pods laufen und – sofern Scheduling-Einschränkungen definiert sind – welche Nodes als Host infrage kommen. Die Kubernetes-Dokumentation zeigt ein einfaches Beispiel, in dem das DaemonSet auf jedem passenden Node einen Pod einplant.
2. Ein DaemonSet bereitstellen
Sobald das DaemonSet-Manifest erstellt ist, stellen Sie es mit kubectl apply im Cluster bereit. Ist das Manifest lokal als daemonset.yaml gespeichert, führen Sie aus:
kubectl apply -f daemonset.yamlDie Kubernetes-Dokumentation zeigt auch, wie sich ein DaemonSet direkt aus einem gehosteten YAML-Manifest anwenden lässt. Zum Beispiel:
kubectl apply -f https://k8s.io/examples/application/basic-daemonset.yamlDer Befehl kubectl apply übermittelt die Konfiguration an die Kubernetes-API. Anschließend ermittelt der DaemonSet-Controller die passenden Nodes und erstellt die erforderlichen Pods. Treten weitere passende Nodes dem Cluster bei, erstellt der Controller automatisch DaemonSet-Pods für sie. Pods entfernter Nodes werden anschließend per Garbage Collection bereinigt.
Nach der Bereitstellung lassen sich Änderungen am DaemonSet in der Regel verwalten, indem Sie das Manifest anpassen und erneut kubectl apply ausführen. Bei DaemonSets mit der Strategie RollingUpdate lösen Änderungen am Pod-Template ein Rolling Update der verwalteten Pods aus. Kubernetes unterstützt außerdem die Update-Strategie OnDelete, wenn Ersatz-Pods erst erstellt werden sollen, nachdem die vorhandenen manuell gelöscht wurden.
3. DaemonSet-Pods überprüfen
Prüfen Sie nach der Bereitstellung eines DaemonSets, ob seine Pods auf den erwarteten Nodes laufen. Die Kubernetes-Dokumentation empfiehlt, Pods mit der Option -o wide aufzulisten, die den jedem Pod zugewiesenen Node mit ausgibt:
kubectl get pods -o wideBei einem DaemonSet, das im gesamten Cluster laufen soll, sollte die Ausgabe auf jedem passenden Node einen DaemonSet-Pod zeigen. Anhand der Spalte NODE lässt sich leicht bestätigen, dass die Pods wie erwartet verteilt sind.
In Umgebungen mit vielen Workloads können Sie die Ergebnisse über die im Pod-Template des DaemonSets definierten Labels einschränken. Für das obige Beispiel lautet der Befehl:
kubectl get pods -l app.kubernetes.io/name=example -o wideSie können auch die DaemonSet-Ressource selbst inspizieren:
kubectl get daemonset example-daemonsetoder den abgekürzten Ressourcennamen verwenden:
kubectl get ds example-daemonsetDer DaemonSet-Status hilft Administratoren, die gewünschte Anzahl an Pods mit der Anzahl der aktuellen, einsatzbereiten und verfügbaren Pods zu vergleichen. Laufen einzelne Pods nicht korrekt, lassen sich mit Befehlen wie kubectl describe pod <pod-name> und kubectl logs <pod-name> Scheduling- oder Container-Probleme untersuchen. Das grundlegende DaemonSet-Tutorial von Kubernetes verifiziert eine erfolgreiche Bereitstellung, indem es prüft, ob die resultierende Pod-Liste für jeden passenden Node genau einen Pod enthält.
Best Practices für Kubernetes DaemonSets
1. CPU- und Memory-Requests und -Limits richtig dimensionieren
Passende CPU- und Memory-Requests und -Limits sind entscheidend für die Stabilität eines DaemonSets. Requests definieren die Mindestressourcen, die ein Pod benötigt, während Limits das Maximum festlegen, das er verbrauchen darf. Überdimensionierung verschwendet Ressourcen und kann auf Nodes mit knappen Ressourcen zu Scheduling-Fehlern führen. Unterdimensionierung riskiert Pod-Evictions oder Leistungseinbußen. Analysieren Sie das Ressourcenprofil des Workloads, um sinnvolle Standardwerte zu bestimmen, sodass jeder DaemonSet-Pod problemlos auf jeden anvisierten Node passt.
Überprüfen und justieren Sie die Ressourceneinstellungen regelmäßig, wenn sich die Anwendung weiterentwickelt. Der Ressourcenbedarf kann sich durch neue Features, höhere Last oder Änderungen an der zugrunde liegenden Infrastruktur verändern. In dynamischen Kubernetes-Umgebungen verhindert das regelmäßige Feintuning von Requests und Limits Ressourcenkonflikte und unterstützt eine effiziente Cluster-Auslastung. Integrieren Sie Ressourcen-Reviews in Ihr Change-Management, um kontinuierlich zu optimieren.
2. Ressourceneinstellungen auf historische Nutzungsdaten stützen
Resource Requests sollten widerspiegeln, wie sich DaemonSet-Pods unter realen Workloads verhalten, statt sich nur auf erste Schätzungen zu verlassen. Nutzen Sie historische CPU- und Memory-Metriken aus Tools wie Prometheus, Grafana oder Ihrer Cloud-Monitoring-Plattform, um typische Nutzung, Lastspitzen und Unterschiede zwischen Nodes zu erkennen. Setzen Sie Requests hoch genug für den Normalbetrieb, ohne auf jedem anvisierten Node unnötig Ressourcen zu reservieren.
Betrachten Sie perzentilbasierte Metriken über repräsentative Zeiträume statt kurzfristiger Durchschnittswerte. CPU-Requests lassen sich oft an der dauerhaften Nutzung mit Spielraum für Lastspitzen ausrichten, während Memory-Requests die beobachteten Spitzen berücksichtigen sollten. Da sich der Ressourcen-Fußabdruck eines DaemonSets über alle Nodes vervielfacht, können schon kleine Verbesserungen an den Pro-Pod-Einstellungen erhebliche Cluster-Kapazität freisetzen.
3. Memory konservativer behandeln als CPU
CPU- und Memory-Limits haben in Kubernetes unterschiedliche Fehlerbilder. Erreicht ein Container sein CPU-Limit, drosselt Kubernetes seine CPU-Nutzung, was in der Regel zu langsamerer Verarbeitung führt. Überschreitet ein Container jedoch sein Memory-Limit, kann er vom Kernel mit einem Out-of-Memory-Fehler (OOM) beendet werden. Bei Node-Level-Agents können wiederholte Neustarts Lücken in der Logging-, Monitoring- oder Security-Abdeckung verursachen.
Setzen Sie Memory-Requests und -Limits mit genügend Puffer für temporäre Spitzen und wachsende Workloads. Beobachten Sie Memory-Spitzenwerte und OOM-Ereignisse, bevor Sie Zuweisungen reduzieren. Bei Agents mit unvorhersehbarem Memory-Bedarf kann ein restriktives Memory-Limit mehr Störungen verursachen als eine moderate Überdimensionierung – validieren Sie Limits daher anhand realer Nutzungsmuster in der Produktion.
4. Die passende Update-Strategie wählen
DaemonSets unterstützen die Update-Strategien RollingUpdate und OnDelete. RollingUpdate, die Standardstrategie, ersetzt vorhandene Pods automatisch, wenn sich das Pod-Template des DaemonSets ändert. Mit Einstellungen wie maxUnavailable und maxSurge lässt sich steuern, wie viele DaemonSet-Pods während eines Updates nicht verfügbar sind oder temporär hinzugefügt werden.
Verwenden Sie OnDelete, wenn der Pod-Austausch explizit kontrolliert werden muss. Bei dieser Strategie ersetzt eine Änderung am Pod-Template vorhandene Pods nicht automatisch; Administratoren müssen sie löschen, bevor Kubernetes Pods aus dem neuen Template erstellt. Unabhängig von der gewählten Strategie sollten Sie bedenken, wie sich nicht verfügbare Agents während eines Updates auf Logging, Monitoring, Netzwerk oder Security-Abdeckung auswirken.
5. Effizienz bei Cluster-Änderungen kontinuierlich überwachen
Der Ressourcenverbrauch eines DaemonSets wächst mit der Zahl der passenden Nodes. Ein Pod, der auf einem einzelnen Node nur moderate Ressourcen nutzt, kann in einem großen Cluster in Summe erheblichen CPU- und Memory-Verbrauch verursachen. Verfolgen Sie sowohl die Nutzung pro Pod als auch die Gesamtressourcen jedes DaemonSets, um dessen Auswirkungen auf die Cluster-Kapazität zu verstehen.
Bewerten Sie DaemonSets neu, wenn sich Node-Typen, Workloads oder die Clustergröße ändern. Achten Sie auf ungenutzte Resource Requests, CPU-Throttling, Memory Pressure, OOM-Ereignisse, Neustarts und Pods, die sich nicht einplanen lassen. Kontinuierliches Monitoring hilft zu erkennen, wann Ressourceneinstellungen oder Scheduling-Regeln nicht mehr zu den tatsächlichen Betriebsbedingungen passen.
DaemonSet-Ressourcennutzung mit PerfectScale optimieren
Da ein DaemonSet auf jedem passenden Node einen Pod platziert, vervielfacht sich selbst eine geringe Über- oder Unterdimensionierung über das gesamte Cluster. PerfectScale by DoiT ist eine Kubernetes-Optimierungsplattform, die sich mit einem einzigen Helm-Befehl bereitstellen lässt und anschließend umsetzbare Erkenntnisse und autonome Optimierung über den gesamten K8s-Stack liefert – damit Node-Level-Agents wie Log-Collectors, Monitoring-Exporter und Security-Daemons mit genau den Ressourcen laufen, die sie tatsächlich benötigen.
Zentrale Funktionen von PerfectScale:
- Autonomes Workload-Right-Sizing: Podfit bietet einen granularen Blick auf Zustand und Kosten des Clusters, priorisiert die Bereiche mit Handlungsbedarf und optimiert Workloads autonom – mit datenbasierten Right-Sizing-Empfehlungen, die sich automatisch anwenden lassen.
- Optimierung der Node-Auslastung: Infrafit bietet umfassende Transparenz über die Node-Auslastung und granulare Einblicke, die ungenutzte Node-Kapazitäten identifizieren und beseitigen, und hilft bei der Auswahl der richtigen Nodes für Ihre Workloads.
- Abstimmung mit Autoscalern: Arbeitet mit HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning und Google Autopilot zusammen – inklusive umsetzbarer Empfehlungen zur Verbesserung der jeweiligen Konfiguration.
- Echtzeit-Alerts mit Priorisierung: Fortschrittliche Auto-Priorisierung macht die folgenreichsten Resilienzrisiken, Kostenspitzen und Anomalien sichtbar, bevor sie Nutzer oder die Cloud-Rechnung treffen – mit Alerts in Slack, Datadog, MS Teams oder PagerDuty.
- Trend- und Governance-Reporting: Der Trends-Report bietet detaillierte Einblicke in Kosten-, Waste- und Risikometriken im Zeitverlauf – über Cluster, Node-Gruppen, Namespaces und Workloads hinweg – und unterstützt Prognosen sowie Root-Cause-Analysen.
- Breite Umgebungsunterstützung: Läuft auf On-Premise- und Cloud-Clustern, darunter OpenShift, EKS, GKE und AKS, und unterstützt Windows-basierte Container ebenso wie ephemere und ML-Workloads.