


Che cos'è un DaemonSet in Kubernetes?
Un DaemonSet è un controller di workload fondamentale di Kubernetes che garantisce che una copia di un determinato Pod sia in esecuzione su tutti i nodi (o su nodi selezionati) di un cluster. Quando un nuovo nodo viene aggiunto al cluster, il DaemonSet vi avvia automaticamente un Pod; quando un nodo viene rimosso, il Pod associato viene eliminato tramite garbage collection.
A differenza dei Deployment, che si concentrano sul mantenimento di un determinato numero totale di repliche nell'intero cluster, i DaemonSet si concentrano sulla copertura a livello di nodo, legando lo scheduling dei pod alla topologia dei nodi del cluster. Questo garantisce che determinati workloads, come agenti di monitoraggio o collettori di log, siano distribuiti in modo uniforme e coerente su tutta l'infrastruttura, assicurando copertura e funzionalità omogenee. I DaemonSet sono essenziali per i workloads che devono essere eseguiti su tutti i nodi, o su nodi specifici, per garantire coerenza operativa.
Ecco un esempio di manifest YAML di un DaemonSet:
L'esempio seguente definisce un DaemonSet che esegue un agente di logging fluentd sul cluster:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluentd-logging namespace: kube-systemspec: selector: matchLabels: name: fluentd-logging template: metadata: labels: name: fluentd-logging spec: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists containers: - name: fluentd image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1Casi d'uso comuni dei DaemonSet:
- Raccolta dei log: esecuzione di agenti come Fluentd, Filebeat o Logstash su ogni nodo per raccogliere e inoltrare i log dei container e di sistema.
- Monitoraggio dei nodi: distribuzione di strumenti come Prometheus Node Exporter o Datadog Agent su ogni nodo per raccogliere metriche su stato, risorse e workloads.
- Agenti di sicurezza e observability: garanzia che agenti di intrusion detection, tracing o observability siano in esecuzione su tutti i nodi per una copertura coerente del cluster.
- Device plugin di Kubernetes: esecuzione di device plugin sui nodi dotati di hardware specializzato, come GPU o FPGA, in modo che Kubernetes possa esporre tali risorse ai workloads.
Questo articolo fa parte di una serie dedicata agli oggetti di Kubernetes
In questo articolo:
- Come funziona un DaemonSet?
- Casi d'uso dei DaemonSet in Kubernetes
- DaemonSet vs. Deployment in Kubernetes
- Tutorial sui DaemonSet in Kubernetes
- Best practice per i DaemonSet in Kubernetes
Come funziona un DaemonSet?
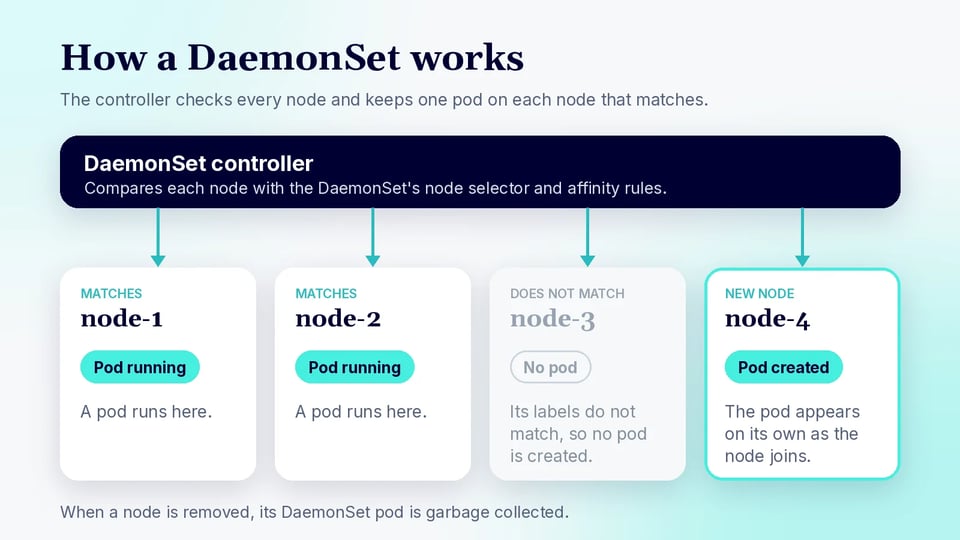
Quando viene creato un DaemonSet, il control plane di Kubernetes valuta ogni nodo rispetto ai criteri di scheduling del DaemonSet. Se un nodo corrisponde, il controller del DaemonSet crea il pod specificato su quel nodo. Se il nodo viene successivamente rimosso dal cluster, il relativo pod del DaemonSet viene eliminato tramite garbage collection.
Se le label del nodo cambiano e non corrispondono più al node selector o alle regole di affinity del DaemonSet, il controller elimina il pod. Il controller aggiunge automaticamente una toleration per il taint node.kubernetes.io/unschedulable, in modo che i pod del DaemonSet continuino a essere eseguiti sui nodi in stato cordoned e possano persino essere schedulati su di essi. Questo meccanismo garantisce che i pod del DaemonSet seguano fedelmente lo stato del cluster, adattandosi alle variazioni dei nodi senza intervento dell'utente.
I DaemonSet supportano funzionalità di scheduling avanzate, come node affinity, toleration e selector, che consentono agli amministratori di indirizzare sottoinsiemi specifici di nodi. Ad esempio, un DaemonSet può essere limitato ai soli nodi contrassegnati da una determinata label o a quelli dotati di hardware specifico. Man mano che il cluster cambia (nodi aggiunti, rietichettati o eliminati), il controller del DaemonSet riconcilia continuamente lo stato effettivo con quello desiderato, assicurando che i pod siano sempre distribuiti dove servono.
Casi d'uso dei DaemonSet in Kubernetes
Raccolta dei log
La raccolta dei log è un caso d'uso comune per i DaemonSet. Le soluzioni di logging centralizzato richiedono spesso la presenza di un agente su ogni nodo per raccogliere e inoltrare i log dei container e dei componenti di sistema. Distribuendo un collettore di log, come Fluentd o Filebeat, sotto forma di DaemonSet, gli amministratori garantiscono la copertura di ogni nodo senza dover installare manualmente gli agenti o preoccuparsi che i nuovi nodi restino privi del componente di logging. Questo approccio semplifica la gestione dei log e garantisce coerenza nell'intero cluster.
L'uso dei DaemonSet per la raccolta dei log semplifica anche la scalabilità dei cluster. Quando nuovi nodi entrano nel cluster, il controller del DaemonSet distribuisce automaticamente l'agente di logging, eliminando passaggi manuali e riducendo il rischio di perdere i log dell'infrastruttura appena aggiunta. Questa distribuzione automatizzata a livello di nodo rende i DaemonSet il metodo preferito per l'aggregazione dei log su scala di cluster negli ambienti Kubernetes, a supporto delle attività di compliance e troubleshooting.
Contenuto correlato: legga la nostra guida ai log di Kubernetes
Monitoraggio dei nodi
Il monitoraggio dei nodi è un altro scenario in cui i DaemonSet eccellono. Strumenti di monitoraggio come Prometheus Node Exporter o Datadog Agent vengono tipicamente distribuiti come DaemonSet per raccogliere metriche sullo stato dei nodi, sull'utilizzo delle risorse e sui workloads in esecuzione. Sfruttando i DaemonSet, questi agenti vengono distribuiti automaticamente su ogni nodo, offrendo una visibilità completa sullo stato operativo del cluster.
La distribuzione automatica tramite DaemonSet garantisce che il monitoraggio rimanga coerente al variare del cluster. Quando i nodi vengono aggiunti o rimossi, il controller del DaemonSet adegua di conseguenza la distribuzione dell'agente di monitoraggio. Questa gestione dinamica semplifica le operazioni sul cluster e assicura che gli amministratori dispongano sempre di metriche aggiornate per ogni nodo, un aspetto cruciale per un capacity planning efficace e per la risposta agli incidenti.
Contenuto correlato: legga la nostra guida al monitoraggio di Kubernetes
Agenti di sicurezza e observability
Gli agenti di sicurezza e observability, come i sistemi di intrusion detection o i collettori di tracing distribuito, devono spesso essere eseguiti su ogni nodo per garantire una copertura completa del cluster. I DaemonSet rendono semplice distribuire questi agenti in modo uniforme, assicurando che tutto il traffico e tutte le attività siano monitorati alla ricerca di minacce o colli di bottiglia nelle prestazioni. Questa distribuzione uniforme è fondamentale per mantenere un ambiente Kubernetes sicuro e osservabile.
L'uso dei DaemonSet per gli agenti di sicurezza supporta anche i requisiti di compliance, garantendo che nessun nodo resti privo di monitoraggio. Con l'evoluzione del cluster, il DaemonSet si adatta automaticamente, mantenendo la copertura di sicurezza senza interventi manuali. Questo approccio assicura che le misure di sicurezza e observability tengano il passo con la natura dinamica dei cluster Kubernetes, riducendo lacune e rischi operativi.
Device plugin di Kubernetes
I device plugin di Kubernetes consentono di esporre ai pod hardware specializzato, come GPU o FPGA. Questi plugin vengono tipicamente distribuiti come DaemonSet per garantire che ogni nodo dotato dell'hardware appropriato esegua il pod del device plugin necessario. Questa configurazione permette a Kubernetes di schedulare workloads che richiedono risorse hardware specifiche, supportando casi d'uso come il machine learning o l'accelerazione hardware.
Distribuire i device plugin come DaemonSet garantisce una gestione coerente delle risorse hardware su tutti i nodi interessati. Quando vengono aggiunti nuovi nodi con hardware specializzato, il controller del DaemonSet distribuisce automaticamente il device plugin corrispondente, rendendo la risorsa disponibile allo scheduler. Questo approccio automatizzato semplifica le operazioni sul cluster e massimizza l'utilizzo dell'hardware specializzato.
DaemonSet vs. Deployment in Kubernetes
Sebbene sia i DaemonSet sia i Deployment gestiscano pod in Kubernetes, i loro scopi e comportamenti differiscono in modo significativo. I Deployment sono progettati per mantenere un numero specificato di repliche di pod, distribuendole sui nodi disponibili per garantire alta disponibilità e bilanciamento del carico. Questo rende i Deployment adatti alle applicazioni stateless, in cui l'obiettivo principale è assicurare un certo livello di ridondanza e scalabilità, indipendentemente dal numero di nodi presenti nel cluster.
I DaemonSet garantiscono che esattamente un pod (o un numero specificato) venga eseguito su ogni nodo o su un sottoinsieme di nodi. Questo è ideale per i workloads che devono essere presenti su ogni nodo, come agenti di monitoraggio, collettori di log o device plugin. I DaemonSet si adattano automaticamente quando i nodi vengono aggiunti o rimossi, mentre i Deployment richiedono uno scaling manuale per adeguarsi alle variazioni dei nodi. Comprendere questa distinzione è fondamentale per scegliere il controller giusto per ogni workload in Kubernetes.
| Aspetto | Deployment | DaemonSet |
|---|---|---|
| Scopo principale | Esegue un numero specificato di repliche per un'applicazione | Esegue un pod su ogni nodo o su nodi selezionati |
| Comportamento di scaling | Scalato manualmente o tramite autoscaling in base al numero di repliche | Si adegua automaticamente quando i nodi vengono aggiunti o rimossi |
| Ideale per | App stateless, API, servizi web, workloads scalabili | Agenti di monitoraggio, collettori di log, servizi a livello di nodo |
| Posizionamento dei pod | Lo scheduler di Kubernetes distribuisce i pod sui nodi | Garantisce la presenza di un pod su ogni nodo idoneo |
Tutorial sui DaemonSet in Kubernetes
Questo tutorial spiega come creare e utilizzare un DaemonSet. È tratto e adattato dalla documentazione di Kubernetes.
1. Creare un DaemonSet in Kubernetes
Per creare un DaemonSet in Kubernetes, lo definisca in un manifest YAML utilizzando apiVersion: apps/v1 e kind: DaemonSet. Il manifest deve includere i campi standard di Kubernetes come metadata e spec, oltre a un template di pod in .spec.template. Il campo .spec.selector del DaemonSet deve corrispondere alle label assegnate al template del pod; una volta creato il DaemonSet, questo selector non può essere modificato. Kubernetes richiede inoltre che la restart policy del pod sia Always, in modo esplicito o tramite l'impostazione predefinita.
Ad esempio, il manifest seguente crea un semplice DaemonSet che esegue un container su ogni nodo idoneo:
apiVersion: apps/v1kind: DaemonSetmetadata: name: example-daemonsetspec: selector: matchLabels: app.kubernetes.io/name: example template: metadata: labels: app.kubernetes.io/name: example spec: containers: - name: pause image: registry.k8s.io/pauseGli amministratori possono estendere il template del pod con opzioni come richieste di risorse, volume mount, toleration, node selector e node affinity. Queste impostazioni determinano come vengono eseguiti i pod del DaemonSet e, quando sono specificati vincoli di scheduling, quali nodi sono idonei a ospitarli. La documentazione di Kubernetes fornisce un esempio di base in cui il DaemonSet schedula un pod su ogni nodo applicabile.
2. Distribuire un DaemonSet
Una volta creato il manifest del DaemonSet, lo distribuisca nel cluster con kubectl apply. Se il manifest è salvato localmente come daemonset.yaml, esegua:
kubectl apply -f daemonset.yamlKubernetes mostra inoltre come applicare un DaemonSet direttamente da un manifest YAML ospitato online. Ad esempio:
kubectl apply -f https://k8s.io/examples/application/basic-daemonset.yamlIl comando kubectl apply invia la configurazione all'API di Kubernetes, dopodiché il controller del DaemonSet determina quali nodi sono idonei e crea i pod necessari. Quando nuovi nodi idonei entrano nel cluster, il controller vi crea automaticamente i pod del DaemonSet. I pod associati ai nodi rimossi vengono successivamente eliminati tramite garbage collection.
Dopo la distribuzione, le modifiche al DaemonSet possono generalmente essere gestite modificando il manifest ed eseguendo nuovamente kubectl apply. Per i DaemonSet che utilizzano la strategia RollingUpdate, le modifiche al template del pod avviano un aggiornamento graduale dei pod gestiti. Kubernetes supporta anche la strategia di aggiornamento OnDelete, per i casi in cui gli amministratori vogliono che i pod sostitutivi vengano creati solo dopo l'eliminazione manuale di quelli esistenti.
3. Verificare i pod del DaemonSet
Dopo aver distribuito un DaemonSet, verifichi che i suoi pod siano in esecuzione sui nodi previsti. La documentazione di Kubernetes consiglia di elencare i pod con l'opzione -o wide, che include il nodo assegnato a ciascun pod:
kubectl get pods -o widePer un DaemonSet destinato a essere eseguito in tutto il cluster, l'output dovrebbe mostrare un pod del DaemonSet su ogni nodo idoneo. La colonna NODE consente di confermare facilmente che i pod sono distribuiti come previsto.
Negli ambienti con molti workloads, utilizzi le label definite nel template del pod del DaemonSet per filtrare i risultati. Per l'esempio precedente, il comando sarebbe:
kubectl get pods -l app.kubernetes.io/name=example -o widePuò anche ispezionare direttamente la risorsa DaemonSet con:
kubectl get daemonset example-daemonsetoppure utilizzare il nome abbreviato della risorsa:
kubectl get ds example-daemonsetLo stato del DaemonSet aiuta gli amministratori a confrontare il numero desiderato di pod con il numero di pod aggiornati, pronti e disponibili. Se singoli pod non funzionano correttamente, comandi come kubectl describe pod <pod-name> e kubectl logs <pod-name> consentono di indagare su problemi di scheduling o a livello di container. Il tutorial di base sui DaemonSet di Kubernetes verifica il successo della distribuzione controllando che l'elenco dei pod risultante contenga un pod per ogni nodo applicabile.
Best practice per i DaemonSet in Kubernetes
1. Dimensionare correttamente richieste e limiti di CPU e memoria
Impostare richieste e limiti adeguati di CPU e memoria è fondamentale per la stabilità di un DaemonSet. Le richieste definiscono le risorse minime necessarie a un pod, mentre i limiti stabiliscono il massimo che può consumare. Un over-provisioning spreca risorse e può causare errori di scheduling sui nodi con risorse limitate. Un under-provisioning comporta il rischio di eviction dei pod o di degrado delle prestazioni. Analizzi il profilo di risorse del workload per determinare valori predefiniti ragionevoli, assicurando che ogni pod del DaemonSet possa essere allocato senza difficoltà su ogni nodo di destinazione.
Riveda e adegui periodicamente le impostazioni delle risorse man mano che l'applicazione evolve. I requisiti di risorse possono cambiare a causa di nuove funzionalità, aumento del carico o modifiche all'infrastruttura sottostante. Negli ambienti Kubernetes dinamici, la messa a punto periodica di richieste e limiti previene la contesa di risorse e favorisce un utilizzo efficiente del cluster. Integri le revisioni delle risorse nel processo di change management per un'ottimizzazione continua.
2. Basare le impostazioni delle risorse sull'utilizzo storico
Le richieste di risorse dovrebbero riflettere il comportamento dei pod del DaemonSet sotto carichi reali, anziché basarsi solo su stime iniziali. Utilizzi le metriche storiche di CPU e memoria provenienti da strumenti come Prometheus, Grafana o la piattaforma di monitoraggio del Suo cloud per identificare l'utilizzo tipico, i picchi di domanda e le differenze tra i nodi. Imposti richieste sufficientemente elevate da sostenere il funzionamento normale, evitando però di riservare risorse inutilmente su ogni nodo di destinazione.
Analizzi metriche basate sui percentili su periodi rappresentativi, invece di affidarsi a medie di breve termine. Le richieste di CPU possono spesso basarsi sull'utilizzo sostenuto con un margine per i picchi, mentre le richieste di memoria devono tenere conto dei picchi osservati. Poiché i DaemonSet moltiplicano il loro footprint di risorse su tutti i nodi, anche piccoli miglioramenti alle impostazioni per singolo pod possono liberare una capacità significativa del cluster.
3. Gestire la memoria in modo più conservativo rispetto alla CPU
I limiti di CPU e memoria hanno comportamenti di errore diversi in Kubernetes. Quando un container raggiunge il proprio limite di CPU, Kubernetes ne limita l'utilizzo (throttling), con il risultato di un'elaborazione più lenta. Quando un container supera il proprio limite di memoria, invece, può essere terminato dal kernel con un errore di out-of-memory (OOM). Per gli agenti a livello di nodo, riavvii ripetuti possono creare lacune nella copertura di logging, monitoraggio o sicurezza.
Imposti richieste e limiti di memoria con un margine sufficiente per picchi temporanei e per la crescita del workload. Monitori i picchi di utilizzo della memoria e gli eventi OOM prima di ridurre le allocazioni. Per gli agenti con requisiti di memoria imprevedibili, un limite di memoria troppo restrittivo può risultare più dannoso di una moderata sovra-allocazione: convalidi quindi i limiti rispetto ai pattern di utilizzo in produzione.
4. Utilizzare la strategia di aggiornamento appropriata
I DaemonSet supportano le strategie di aggiornamento RollingUpdate e OnDelete. RollingUpdate, la strategia predefinita, sostituisce automaticamente i pod esistenti quando il template del pod del DaemonSet cambia. Impostazioni come maxUnavailable e maxSurge consentono di controllare quanti pod del DaemonSet possono risultare non disponibili o essere aggiunti temporaneamente durante un aggiornamento.
Utilizzi OnDelete quando la sostituzione dei pod deve essere controllata in modo esplicito. Con questa strategia, l'aggiornamento del template del pod non sostituisce automaticamente i pod esistenti; gli amministratori devono eliminarli prima che Kubernetes crei i pod dal nuovo template. Qualunque strategia scelga, consideri l'effetto dell'indisponibilità degli agenti sulla copertura di logging, monitoraggio, networking o sicurezza durante gli aggiornamenti.
5. Monitorare continuamente l'efficienza al variare del cluster
Il consumo di risorse di un DaemonSet cresce con il numero di nodi idonei. Un pod che utilizza risorse modeste su un singolo nodo può rappresentare un consumo aggregato considerevole di CPU e memoria in un cluster di grandi dimensioni. Tenga traccia sia dell'utilizzo per singolo pod sia delle risorse totali consumate da ciascun DaemonSet, per comprenderne l'impatto sulla capacità del cluster.
Riesamini i DaemonSet quando cambiano i tipi di nodo, i workloads o le dimensioni del cluster. Presti attenzione a richieste di risorse inutilizzate, throttling della CPU, pressione sulla memoria, eventi OOM, riavvii e pod che non riescono a essere schedulati. Il monitoraggio continuo aiuta a individuare quando le impostazioni delle risorse o le regole di scheduling non corrispondono più alle effettive condizioni operative.
Ottimizzare l'utilizzo delle risorse dei DaemonSet con PerfectScale
Poiché un DaemonSet colloca un pod su ogni nodo idoneo, anche piccole quantità di over- o under-provisioning si moltiplicano nell'intero cluster. PerfectScale by DoiT è una piattaforma di ottimizzazione per Kubernetes che si installa con un singolo comando Helm e offre insight concreti e ottimizzazione autonoma sull'intero stack K8s, in modo che gli agenti a livello di nodo come collettori di log, exporter di monitoraggio e daemon di sicurezza vengano eseguiti con le risorse di cui hanno effettivamente bisogno.
Funzionalità chiave di PerfectScale:
- Right-sizing autonomo dei workloads: Podfit offre una vista granulare dello stato e dei costi del cluster, dà priorità alle aree che richiedono attenzione e ottimizza autonomamente i workloads con raccomandazioni di right-sizing basate sui dati, applicabili automaticamente.
- Ottimizzazione dell'utilizzo dei nodi: Infrafit fornisce visibilità completa sull'utilizzo dei nodi e insight granulari che identificano ed eliminano la capacità inutilizzata, aiutando a scegliere i nodi giusti per i Suoi workloads.
- Allineamento con gli autoscaler: funziona in combinazione con HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot, con raccomandazioni concrete per migliorarne le configurazioni.
- Alerting in tempo reale con prioritizzazione: un'avanzata prioritizzazione automatica mette in evidenza i rischi di resilienza, i picchi di costo e le anomalie più rilevanti prima che impattino gli utenti o la fattura cloud, con avvisi recapitati su Slack, Datadog, MS Teams o PagerDuty.
- Reportistica su trend e governance: il report Trends offre una visibilità approfondita su metriche di costo, spreco e rischio nel tempo, su cluster, gruppi di nodi, namespace e workloads, a supporto di previsioni e root cause analysis.
- Ampio supporto degli ambienti: funziona su cluster on-premise e cloud, tra cui OpenShift, EKS, GKE e AKS, e supporta container basati su Windows oltre a workloads effimeri e di ML.