


Qu'est-ce qu'un DaemonSet Kubernetes ?
Un DaemonSet est un contrôleur de workloads fondamental de Kubernetes qui garantit qu'une copie d'un Pod spécifique s'exécute sur tous les nœuds (ou une sélection de nœuds) d'un cluster. Lorsqu'un nouveau nœud rejoint le cluster, le DaemonSet y lance automatiquement un Pod ; lorsqu'un nœud est supprimé, le Pod associé est nettoyé par le garbage collector.
Contrairement aux Deployments, dont l'objectif est de maintenir un nombre précis de réplicas à l'échelle du cluster, les DaemonSets se concentrent sur la couverture au niveau des nœuds, en liant l'ordonnancement des pods à la topologie du cluster. Cela garantit que certains workloads, comme les agents de monitoring ou les collecteurs de logs, sont distribués de manière uniforme et cohérente sur toute l'infrastructure, assurant une couverture et des fonctionnalités homogènes. Les DaemonSets sont indispensables pour les workloads qui doivent s'exécuter sur tous les nœuds, ou sur des nœuds spécifiques, afin de garantir la cohérence opérationnelle.
Voici un exemple de manifeste YAML d'un DaemonSet :
L'exemple suivant définit un DaemonSet exécutant un agent de logging fluentd sur le cluster :
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluentd-logging namespace: kube-systemspec: selector: matchLabels: name: fluentd-logging template: metadata: labels: name: fluentd-logging spec: tolerations: - key: node-role.kubernetes.io/control-plane operator: Exists containers: - name: fluentd image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1Cas d'usage courants des DaemonSets :
- Collecte de logs : exécutez des agents comme Fluentd, Filebeat ou Logstash sur chaque nœud pour collecter et transférer les logs des conteneurs et du système.
- Monitoring des nœuds : déployez des outils comme Prometheus Node Exporter ou l'agent Datadog sur chaque nœud pour recueillir des métriques de santé, de ressources et de workloads.
- Agents de sécurité et d'observabilité : assurez l'exécution des agents de détection d'intrusion, de tracing ou d'observabilité sur tous les nœuds pour une couverture homogène du cluster.
- Device plugins Kubernetes : exécutez des device plugins sur les nœuds dotés de matériel spécialisé, comme des GPU ou des FPGA, afin que Kubernetes puisse exposer ces ressources aux workloads.
Cet article fait partie d'une série consacrée aux objets Kubernetes.
Dans cet article :
- Comment fonctionne un DaemonSet ?
- Cas d'usage des DaemonSets Kubernetes
- DaemonSet Kubernetes ou Deployment : quelles différences ?
- Tutoriel DaemonSet Kubernetes
- Bonnes pratiques pour les DaemonSets Kubernetes
Comment fonctionne un DaemonSet ?
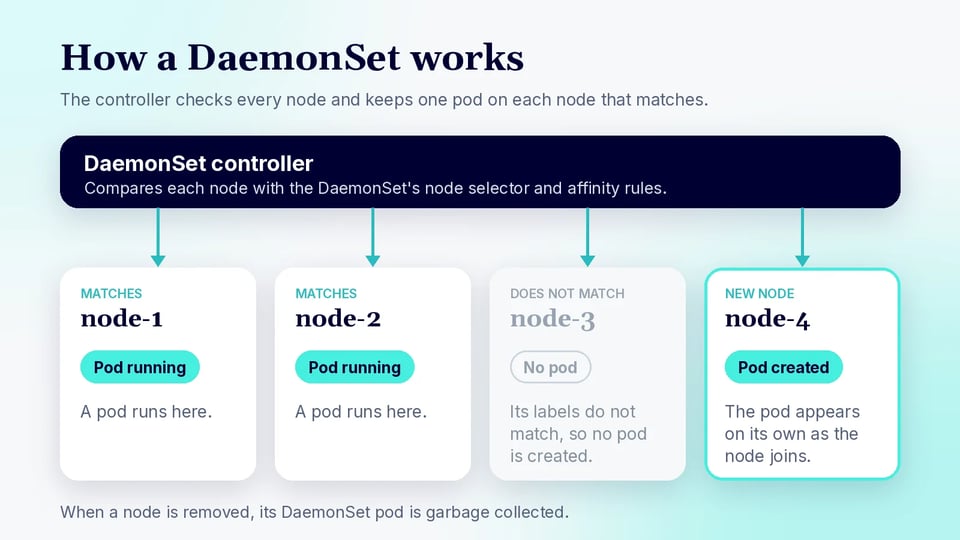
Lorsqu'un DaemonSet est créé, le plan de contrôle Kubernetes évalue chaque nœud au regard des critères d'ordonnancement du DaemonSet. Si un nœud correspond, le contrôleur DaemonSet crée le pod spécifié sur ce nœud. Si le nœud est ensuite retiré du cluster, son pod DaemonSet est nettoyé par le garbage collector.
Si les labels du nœud changent et qu'il ne correspond plus au node selector ou aux règles d'affinité du DaemonSet, le contrôleur supprime le pod. Le contrôleur ajoute automatiquement une toleration pour le taint node.kubernetes.io/unschedulable, de sorte que les pods DaemonSet continuent de s'exécuter sur les nœuds isolés (cordoned) et peuvent même y être planifiés. Ce mécanisme garantit que les pods DaemonSet suivent de près l'état du cluster et s'adaptent aux changements de nœuds sans intervention de l'utilisateur.
Les DaemonSets prennent en charge des fonctionnalités avancées d'ordonnancement, comme la node affinity, les tolerations et les selectors, permettant aux administrateurs de cibler des sous-ensembles précis de nœuds. Par exemple, un DaemonSet peut être limité aux nœuds portant un certain label ou disposant d'un matériel spécifique. À mesure que le cluster évolue (ajout ou suppression de nœuds, modification de leurs labels), le contrôleur DaemonSet réconcilie en continu l'état réel avec l'état souhaité, en veillant à ce que les pods soient toujours déployés là où ils sont nécessaires.
Cas d'usage des DaemonSets Kubernetes
Collecte de logs
La collecte de logs est un cas d'usage courant des DaemonSets. Les solutions de logging centralisé nécessitent souvent la présence d'un agent sur chaque nœud pour collecter et transférer les logs des conteneurs et des composants système. En déployant un collecteur de logs, comme Fluentd ou Filebeat, sous forme de DaemonSet, les administrateurs s'assurent que chaque nœud est couvert, sans devoir déployer les agents manuellement ni craindre que les nouveaux nœuds soient privés du composant de logging. Cette approche simplifie la gestion des logs et garantit la cohérence sur l'ensemble du cluster.
L'utilisation des DaemonSets pour la collecte de logs facilite également la montée en charge des clusters. Lorsque de nouveaux nœuds rejoignent le cluster, le contrôleur DaemonSet déploie automatiquement l'agent de logging, ce qui élimine les étapes manuelles et réduit le risque de perdre des logs sur l'infrastructure fraîchement ajoutée. Ce déploiement automatisé au niveau des nœuds fait des DaemonSets la méthode privilégiée pour l'agrégation de logs à l'échelle du cluster dans les environnements Kubernetes, au service de la conformité et du dépannage.
Contenu associé : consultez notre guide sur les logs Kubernetes
Monitoring des nœuds
Le monitoring des nœuds est un autre scénario où les DaemonSets excellent. Des outils de monitoring comme Prometheus Node Exporter ou l'agent Datadog sont généralement déployés sous forme de DaemonSets pour collecter des métriques sur la santé des nœuds, l'utilisation des ressources et les workloads en cours d'exécution. Grâce aux DaemonSets, ces agents sont automatiquement distribués sur chaque nœud, offrant une visibilité complète sur l'état opérationnel du cluster.
Le déploiement automatique via DaemonSet garantit la cohérence du monitoring au fil des évolutions du cluster. Lorsque des nœuds sont ajoutés ou supprimés, le contrôleur DaemonSet ajuste le déploiement de l'agent de monitoring en conséquence. Cette gestion dynamique simplifie l'exploitation du cluster et assure aux administrateurs des métriques toujours à jour pour chaque nœud, un point essentiel pour la planification de capacité et la réponse aux incidents.
Contenu associé : consultez notre guide sur le monitoring Kubernetes
Agents de sécurité et d'observabilité
Les agents de sécurité et d'observabilité, comme les systèmes de détection d'intrusion ou les collecteurs de tracing distribué, doivent souvent s'exécuter sur chaque nœud pour couvrir l'intégralité du cluster. Les DaemonSets facilitent le déploiement uniforme de ces agents, garantissant que l'ensemble du trafic et de l'activité est surveillé pour détecter les menaces ou les goulots d'étranglement de performance. Ce déploiement homogène est essentiel pour maintenir un environnement Kubernetes sécurisé et observable.
Utiliser des DaemonSets pour les agents de sécurité répond également aux exigences de conformité en garantissant qu'aucun nœud n'échappe à la surveillance. À mesure que le cluster évolue, le DaemonSet s'adapte automatiquement et maintient la couverture de sécurité sans intervention manuelle. Cette approche assure que les mesures de sécurité et d'observabilité suivent le rythme de la nature dynamique des clusters Kubernetes, réduisant les angles morts et les risques opérationnels.
Device plugins Kubernetes
Les device plugins Kubernetes permettent d'exposer du matériel spécialisé, comme des GPU ou des FPGA, aux pods. Ces plugins sont généralement déployés sous forme de DaemonSets afin que chaque nœud disposant du matériel approprié exécute le pod de device plugin nécessaire. Cette configuration permet à Kubernetes de planifier des workloads nécessitant des ressources matérielles spécifiques, par exemple pour le machine learning ou l'accélération matérielle.
Déployer les device plugins sous forme de DaemonSets garantit une gestion cohérente des ressources matérielles sur tous les nœuds concernés. Lorsque de nouveaux nœuds dotés de matériel spécialisé sont ajoutés, le contrôleur DaemonSet déploie automatiquement le device plugin correspondant, rendant la ressource disponible pour le scheduler. Cette approche automatisée simplifie l'exploitation du cluster et maximise l'utilisation du matériel spécialisé.
DaemonSet Kubernetes ou Deployment : quelles différences ?
Si les DaemonSets et les Deployments gèrent tous deux des pods dans Kubernetes, leurs objectifs et leurs comportements diffèrent sensiblement. Les Deployments sont conçus pour maintenir un nombre défini de réplicas de pods, distribués sur les nœuds disponibles afin d'assurer la haute disponibilité et la répartition de charge. Ils conviennent donc aux applications stateless, pour lesquelles l'objectif principal est de garantir un certain niveau de redondance et de scalabilité, quel que soit le nombre de nœuds du cluster.
Les DaemonSets, eux, garantissent qu'exactement un pod (ou un nombre défini) s'exécute sur chaque nœud ou sur un sous-ensemble de nœuds. C'est la solution idéale pour les workloads qui doivent être présents sur chaque nœud, comme les agents de monitoring, les collecteurs de logs ou les device plugins. Les DaemonSets s'adaptent automatiquement à l'ajout ou à la suppression de nœuds, tandis que les Deployments nécessitent un dimensionnement manuel pour suivre ces changements. Comprendre cette distinction est essentiel pour choisir le bon contrôleur selon les workloads dans Kubernetes.
| Aspect | Deployment | DaemonSet |
|---|---|---|
| Objectif principal | Exécute un nombre défini de réplicas pour une application | Exécute un pod sur chaque nœud ou sur une sélection de nœuds |
| Comportement de scaling | Dimensionné manuellement ou via l'autoscaling selon le nombre de réplicas | S'ajuste automatiquement à l'ajout ou à la suppression de nœuds |
| Idéal pour | Applications stateless, API, services web, workloads scalables | Agents de monitoring, collecteurs de logs, services de niveau nœud |
| Placement des pods | Le scheduler Kubernetes répartit les pods sur les nœuds | Garantit le placement des pods sur chaque nœud éligible |
Tutoriel DaemonSet Kubernetes
Ce tutoriel explique comment créer et utiliser un DaemonSet. Il est adapté de la documentation Kubernetes.
1. Créer un DaemonSet Kubernetes
Pour créer un DaemonSet Kubernetes, définissez-le dans un manifeste YAML avec apiVersion: apps/v1 et kind: DaemonSet. Le manifeste doit inclure les champs Kubernetes standard, comme metadata et spec, ainsi qu'un template de pod sous .spec.template. Le .spec.selector du DaemonSet doit correspondre aux labels attribués au template de pod ; une fois le DaemonSet créé, ce selector ne peut plus être modifié. Kubernetes exige également que la politique de redémarrage du pod soit Always, soit explicitement, soit via la valeur par défaut.
Par exemple, le manifeste suivant crée un DaemonSet simple exécutant un conteneur sur chaque nœud éligible :
apiVersion: apps/v1kind: DaemonSetmetadata: name: example-daemonsetspec: selector: matchLabels: app.kubernetes.io/name: example template: metadata: labels: app.kubernetes.io/name: example spec: containers: - name: pause image: registry.k8s.io/pauseLes administrateurs peuvent enrichir le template de pod avec des options comme les resource requests, les montages de volumes, les tolerations, les node selectors et la node affinity. Ces paramètres déterminent comment les pods du DaemonSet s'exécutent et, lorsque des contraintes d'ordonnancement sont spécifiées, quels nœuds sont éligibles pour les héberger. La documentation Kubernetes fournit un exemple de base dans lequel le DaemonSet planifie un pod sur chaque nœud concerné.
2. Déployer un DaemonSet
Une fois le manifeste du DaemonSet créé, déployez-le dans le cluster avec kubectl apply. Si le manifeste est enregistré localement sous le nom daemonset.yaml, exécutez :
kubectl apply -f daemonset.yamlKubernetes montre également comment appliquer un DaemonSet directement depuis un manifeste YAML hébergé. Par exemple :
kubectl apply -f https://k8s.io/examples/application/basic-daemonset.yamlLa commande kubectl apply soumet la configuration à l'API Kubernetes, après quoi le contrôleur DaemonSet détermine les nœuds éligibles et crée les pods requis. Lorsque de nouveaux nœuds éligibles rejoignent le cluster, le contrôleur y crée automatiquement des pods DaemonSet. Les pods associés aux nœuds supprimés sont ensuite nettoyés par le garbage collector.
Après le déploiement, les modifications du DaemonSet se gèrent généralement en modifiant le manifeste puis en exécutant à nouveau kubectl apply. Pour les DaemonSets utilisant la stratégie RollingUpdate, toute modification du template de pod déclenche une mise à jour progressive des pods gérés. Kubernetes prend également en charge la stratégie OnDelete lorsque les administrateurs souhaitent que les pods de remplacement ne soient créés qu'après la suppression manuelle des pods existants.
3. Vérifier les pods du DaemonSet
Après avoir déployé un DaemonSet, vérifiez que ses pods s'exécutent sur les nœuds attendus. La documentation Kubernetes recommande de lister les pods avec l'option -o wide, qui affiche le nœud attribué à chaque pod :
kubectl get pods -o widePour un DaemonSet destiné à s'exécuter sur l'ensemble du cluster, la sortie doit afficher un pod DaemonSet sur chaque nœud éligible. La colonne NODE permet de confirmer facilement que les pods sont distribués comme prévu.
Dans les environnements comptant de nombreux workloads, utilisez les labels définis dans le template de pod du DaemonSet pour filtrer les résultats. Pour l'exemple ci-dessus, la commande serait :
kubectl get pods -l app.kubernetes.io/name=example -o wideVous pouvez également inspecter la ressource DaemonSet elle-même avec :
kubectl get daemonset example-daemonsetou utiliser le nom de ressource abrégé :
kubectl get ds example-daemonsetLe statut du DaemonSet aide les administrateurs à comparer le nombre de pods souhaité avec le nombre de pods à jour, prêts et disponibles. Si certains pods ne s'exécutent pas correctement, des commandes comme kubectl describe pod <pod-name> et kubectl logs <pod-name> permettent d'investiguer les problèmes d'ordonnancement ou de conteneur. Le tutoriel DaemonSet de base de Kubernetes vérifie le succès du déploiement en contrôlant que la liste des pods obtenue contient un pod pour chaque nœud concerné.
Bonnes pratiques pour les DaemonSets Kubernetes
1. Dimensionner correctement les requests et limits CPU et mémoire
Définir des requests et limits CPU et mémoire appropriées est essentiel pour la stabilité d'un DaemonSet. Les requests définissent les ressources minimales dont un pod a besoin, tandis que les limits fixent le maximum qu'il peut consommer. Un surdimensionnement gaspille des ressources et peut provoquer des échecs d'ordonnancement sur les nœuds aux ressources limitées. Un sous-dimensionnement expose à l'éviction des pods ou à une dégradation des performances. Analysez le profil de ressources du workload pour déterminer des valeurs par défaut raisonnables, en veillant à ce que chaque pod DaemonSet tienne aisément sur chaque nœud ciblé.
Révisez et ajustez régulièrement les paramètres de ressources à mesure que l'application évolue. Les besoins en ressources peuvent changer avec de nouvelles fonctionnalités, une charge accrue ou des évolutions de l'infrastructure sous-jacente. Dans les environnements Kubernetes dynamiques, un ajustement périodique des requests et limits prévient la contention des ressources et favorise une utilisation efficace du cluster. Intégrez ces revues de ressources à votre processus de gestion des changements pour une optimisation continue.
2. Baser les paramètres de ressources sur l'historique d'utilisation
Les resource requests doivent refléter le comportement réel des pods DaemonSet en production, et non reposer uniquement sur des estimations initiales. Exploitez l'historique des métriques CPU et mémoire issu d'outils comme Prometheus, Grafana ou votre plateforme de monitoring cloud pour identifier l'utilisation habituelle, les pics de demande et les écarts entre nœuds. Définissez des requests suffisamment élevées pour couvrir le fonctionnement normal tout en évitant de réserver inutilement des ressources sur chaque nœud ciblé.
Analysez des métriques basées sur des percentiles sur des périodes représentatives plutôt que des moyennes à court terme. Les requests CPU peuvent souvent être basées sur l'utilisation soutenue avec une marge pour les pics, tandis que les requests mémoire doivent tenir compte des pics observés. Comme l'empreinte de ressources des DaemonSets se multiplie sur tous les nœuds, même de petites améliorations par pod peuvent libérer une capacité significative du cluster.
3. Traiter la mémoire avec plus de prudence que le CPU
Les limits CPU et mémoire ont des modes de défaillance différents dans Kubernetes. Lorsqu'un conteneur atteint sa limite CPU, Kubernetes limite (throttle) sa consommation, ce qui ralentit généralement les traitements. En revanche, lorsqu'un conteneur dépasse sa limite mémoire, il peut être arrêté par le kernel avec une erreur out-of-memory (OOM). Pour les agents de niveau nœud, des redémarrages répétés peuvent créer des trous dans la couverture de logging, de monitoring ou de sécurité.
Définissez les requests et limits mémoire avec une marge suffisante pour les pics temporaires et la croissance du workload. Surveillez les pics de consommation mémoire et les événements OOM avant de réduire les allocations. Pour les agents aux besoins mémoire imprévisibles, une limite mémoire trop restrictive peut être plus pénalisante qu'un surdimensionnement modéré : validez donc les limits par rapport aux usages observés en production.
4. Utiliser la stratégie de mise à jour appropriée
Les DaemonSets prennent en charge les stratégies de mise à jour RollingUpdate et OnDelete. RollingUpdate, la stratégie par défaut, remplace automatiquement les pods existants lorsque le template de pod du DaemonSet change. Des paramètres comme maxUnavailable et maxSurge permettent de contrôler le nombre de pods DaemonSet indisponibles ou ajoutés temporairement pendant une mise à jour.
Utilisez OnDelete lorsque le remplacement des pods doit être contrôlé explicitement. Avec cette stratégie, la mise à jour du template de pod ne remplace pas automatiquement les pods existants ; les administrateurs doivent les supprimer pour que Kubernetes crée des pods à partir du nouveau template. Quelle que soit la stratégie choisie, évaluez l'impact de l'indisponibilité des agents sur la couverture de logging, de monitoring, de réseau ou de sécurité pendant les mises à jour.
5. Surveiller l'efficience en continu à mesure que le cluster évolue
La consommation de ressources d'un DaemonSet croît avec le nombre de nœuds éligibles. Un pod aux ressources modestes sur un seul nœud peut représenter une consommation agrégée importante de CPU et de mémoire dans un grand cluster. Suivez à la fois l'utilisation par pod et le total des ressources consommées par chaque DaemonSet pour comprendre son impact sur la capacité du cluster.
Réévaluez vos DaemonSets lorsque les types de nœuds, les workloads ou la taille du cluster changent. Soyez attentif aux resource requests inutilisées, au throttling CPU, à la pression mémoire, aux événements OOM, aux redémarrages et aux pods qui ne parviennent pas à être planifiés. Un monitoring continu permet d'identifier le moment où les paramètres de ressources ou les règles d'ordonnancement ne correspondent plus aux conditions réelles d'exploitation.
Optimiser l'utilisation des ressources des DaemonSets avec PerfectScale
Comme un DaemonSet place un pod sur chaque nœud éligible, le moindre sur- ou sous-dimensionnement se multiplie à l'échelle du cluster. PerfectScale by DoiT est une plateforme d'optimisation Kubernetes qui se déploie via une seule commande Helm, puis fournit des insights actionnables et une optimisation autonome sur l'ensemble de la stack K8s, afin que les agents de niveau nœud — collecteurs de logs, exporters de monitoring, daemons de sécurité — s'exécutent avec les ressources dont ils ont réellement besoin.
Fonctionnalités clés de PerfectScale :
- Right-sizing autonome des workloads : Podfit offre une vue granulaire de la santé et des coûts du cluster, priorise les zones nécessitant une attention particulière et optimise les workloads de manière autonome grâce à des recommandations de right-sizing basées sur les données, applicables automatiquement.
- Optimisation de l'utilisation des nœuds : Infrafit fournit une visibilité complète sur l'utilisation des nœuds et des insights granulaires qui identifient et éliminent la capacité inutilisée, tout en aidant à sélectionner les bons nœuds pour vos workloads.
- Alignement avec les autoscalers : fonctionne avec HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning et Google Autopilot, avec des recommandations actionnables pour améliorer leurs configurations.
- Alertes en temps réel avec priorisation : une auto-priorisation avancée met en avant les risques de résilience, les pics de coûts et les anomalies les plus critiques avant qu'ils n'affectent les utilisateurs ou la facture cloud, avec des alertes envoyées vers Slack, Datadog, MS Teams ou PagerDuty.
- Rapports de tendances et de gouvernance : le rapport Trends offre une visibilité approfondie sur les métriques de coûts, de gaspillage et de risques dans le temps, par cluster, groupe de nœuds, namespace et workload, au service de la prévision et de l'analyse des causes racines.
- Large compatibilité d'environnements : fonctionne sur les clusters on-premise et cloud, y compris OpenShift, EKS, GKE et AKS, et prend en charge les conteneurs Windows ainsi que les workloads éphémères et de ML.