
PerfectScale
Cómo corregir políticas de recursos de Kubernetes que optimizan para la fase equivocada
Tus ResourceQuota, LimitRange y políticas de admisión fijan un solo número por contenedor. Los contenedores tienen dos fases. Así se reescribe la capa de políticas para que deje de elegir la equivocada.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Una política de recursos de Kubernetes es cada capa que decide con qué requests y limits termina un contenedor:
ResourceQuota,LimitRange, reglas de admisión (Kyverno, Gatekeeper,ValidatingAdmissionPolicy), los defaults de los charts de Helm y el recomendador que escribe los números. - Cada una de esas capas asume un solo número por contenedor para toda su vida. Los contenedores tienen dos fases, arranque y estado estable, y la brecha entre ambas puede ser de 3x a 10x.
- Las políticas ajustadas al estado estable estrangulan y matan por OOM a los pods durante el arranque. Las políticas ajustadas al arranque reservan capacidad que nadie usa, llenan las cuotas del namespace con requests ociosos y dejan pods en
Pendingmientras el clúster está medio vacío. - La solución es estructural: cuota sobre requests, no sobre limits; un
LimitRangeque permita el burst en lugar de recortarlo; reglas de admisión que exijan requests y limits de memoria pero dejen de imponer limits de CPU; y un recomendador que vea el arranque y el estado estable como números separados. - El resize de pods in-place hace viable el último paso. El arranque recibe lo que necesita, luego el pod se reduce a su meseta sin reiniciarse, y la cuota se recupera en ese mismo instante.
En el artículo anterior vimos cómo detectar un pico de arranque: filtra las métricas de throttling y OOM por edad del contenedor, y el burst que los promedios esconden aparece en los primeros 60 segundos de vida de cada contenedor. Este artículo trata de qué hacer una vez que puedes verlo, porque lo difícil no es editar un Deployment. Lo difícil es que la capa de políticas alrededor de ese Deployment se escribió para una sola fase y seguirá empujando cada workload de vuelta hacia ella.
Qué es realmente una política de recursos de Kubernetes
Cuando alguien busca kubernetes resource quota suele estar configurando uno de dos objetos en un namespace, pero la política que determina los requests y limits finales de un contenedor tiene más capas que eso. Cada una puede estar ajustada a la fase equivocada de forma independiente.
| Capa | Qué controla | El ajuste a estado estable rompe el arranque cuando… | El ajuste al arranque desperdicia capacidad cuando… |
|---|---|---|---|
ResourceQuota |
Techo a nivel de namespace sobre la suma de requests.cpu, requests.memory, limits.cpu, limits.memory y el número de pods |
Una cuota sobre limits.* obliga a los equipos a reducir los limits para caber, así que el arranque choca con la cuota de CFS o con el OOM killer |
Una cuota sobre requests.* se consume con requests dimensionados al pico que quedan 90% ociosos después del primer minuto |
LimitRange |
default, defaultRequest, min, max, maxLimitRequestRatio por contenedor |
Un max o un maxLimitRequestRatio bajo fija el limit cerca del request y elimina el margen de burst que el arranque necesita |
Un defaultRequest alto para que los contenedores sin especificar sobrevivan al boot, lo que infla todos los contenedores que no fijaron el suyo |
Política de admisión (Kyverno, Gatekeeper, ValidatingAdmissionPolicy) |
Qué campos deben estar presentes y qué forma toman | "Todo contenedor debe fijar un limit de CPU" convierte un throttle opcional en uno obligatorio | "Los requests deben igualar a los limits" (QoS Guaranteed en todas partes) convierte el pico de arranque en una reserva permanente |
| Defaults de charts y plantillas | Lo que recibe un contenedor cuando nadie lo pensó | Defaults copiados de un servicio que arranca rápido, aplicados a uno que no | Defaults copiados de un servicio JVM, aplicados a un sidecar en Go |
| Recomendador (VPA, scripts, una plataforma) | Los números que acaban en el spec | Un histograma de varios días recomienda la meseta y el siguiente rollout sufre throttling | El recomendador ve el pico, lo recomienda y nunca lo revisa una vez que el pod se calma |
El scheduler lee los requests. El kernel aplica los limits. El sistema de cuotas cuenta el que le hayas indicado de los dos. Ninguno sabe que el contenedor acaba de terminar de cargar clases y no volverá a necesitar esa CPU hasta el próximo deploy.
Cómo saber para qué fase optimiza tu política
No necesitas leer cada manifiesto. Tres señales indican hacia dónde se inclina la política.
Los pods sufren throttling o mueren por OOM en sus primeros dos minutos y en ningún otro momento. Eso es una política de estado estable. En algún lugar, un LimitRange, una regla de admisión o un recomendador bajó los limits hasta la meseta. Confírmalo con la consulta de throttling en contenedores jóvenes del artículo de detección y con kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} concentrado justo después de los rollouts.
Los namespaces agotan la cuota mientras los nodos corren al 20 o 30% de CPU. Eso es una política de arranque. Los requests están dimensionados para sobrevivir el boot, así que la cuota se consume con reservas que quedan ociosas a los 60 segundos. Compruébalo directamente:
# CPU solicitada vs CPU real, por namespacesum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})/sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))Un ratio de 1.5 a 2 es un margen normal. Un ratio de 5 o más en todo un namespace significa que los requests describen una fase que los contenedores abandonaron hace mucho. kubectl describe resourcequota -n <namespace> cuenta la misma historia desde el otro lado: requests.cpu usado al 95% del valor hard mientras kubectl top pods suma una fracción de eso.
Ambas a la vez. Es más común de lo que parece. Los limits de CPU están recortados al estado estable (throttling en el boot) mientras los requests de memoria están dimensionados al pico de arranque (reservas ociosas). La política eligió la fase equivocada para cada recurso, en direcciones opuestas.
El cálculo de cuota que hace que esto salga caro
Toma el ejemplo del artículo de detección: un servicio con 40 réplicas, un burst de arranque de 2 núcleos durante unos 45 segundos y un estado estable de 200m.
Dimensiona los requests para la meseta y el Deployment consume 8 núcleos de cuota de requests.cpu. Dimensiónalos para el pico y consume 80. La cuota del namespace que alojaba cómodamente diez servicios así ahora aloja uno, y los otros nueve quedan en Pending con exceeded quota en sus eventos mientras los nodos donde habrían aterrizado permanecen ociosos. En un clúster donde los requests determinan el aprovisionamiento de nodos mediante Karpenter o el Cluster Autoscaler, esos 72 núcleos fantasma también se convierten en nodos reales con una factura real.
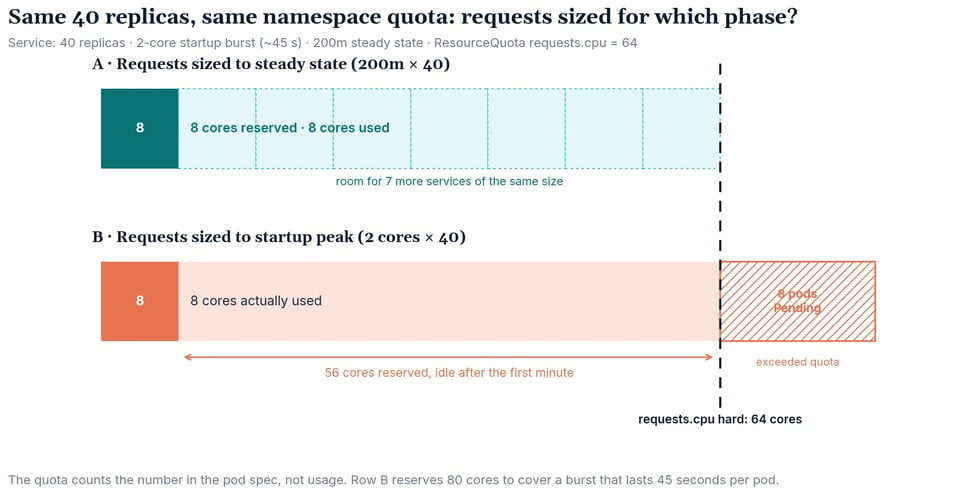
La cuota hace exactamente lo que se le dijo. El problema es que cuenta un número que fue cierto durante 45 segundos y lo trata como cierto durante toda la vida del pod.
Solución 1: Pon la cuota sobre los requests, no sobre los limits
ResourceQuota puede acotar requests.cpu, limits.cpu o ambos. Los equipos suelen añadir limits.cpu a la cuota bajo la premisa de que acota el uso en el peor caso. Lo que hace en la práctica es empujar los limits hacia abajo, hacia los requests, para que el namespace quepa, lo que elimina el margen que el arranque necesita.
Los requests son lo que el scheduler reserva y lo que pagas en capacidad de nodos. Acota eso. Deja que los limits floten.
apiVersion: v1kind: ResourceQuotametadata: name: team-payments namespace: paymentsspec: hard: requests.cpu: "64" requests.memory: 256Gi limits.memory: 512Gi # los limits de memoria son una barrera de seguridad real; consérvalos # sin limits.cpu — los limits de CPU estrangulan, no protegen el nodo pods: "400"Mantén limits.memory en la cuota. La memoria no es compresible: un contenedor que supera su limit de memoria muere en lugar de ralentizarse, y un techo de memoria a nivel de namespace es un control legítimo del radio de impacto. Los limits de CPU son otra historia, como explicó Anton en el artículo sobre limits de CPU: no protegen nada en el nodo y te cuestan latencia justo en el momento en que un pod intenta levantarse.
Una consecuencia que debes planificar: en cuanto una cuota menciona requests.cpu, todo pod del namespace debe especificar un request de CPU o será rechazado en la admisión. Ahí entran los defaults de LimitRange, y es el siguiente punto donde se cuela la fase equivocada.
Solución 2: Haz que el LimitRange permita el burst en lugar de recortarlo
El LimitRange es donde la mayoría de las políticas de estado estable hacen más daño, normalmente a través de dos campos.
maxLimitRequestRatio acota cuánto puede subir un limit por encima de su request. Un ratio de 1 o 2 significa que un contenedor que solicita 200m puede tener un limit de como máximo 400m, y el burst de arranque de 2 núcleos corre a una quinta parte de la velocidad que necesita. Si de todas formas vas a conservar los limits de CPU, el ratio tiene que cubrir la brecha real entre arranque y meseta, que en servicios JVM y Node suele ser de 5 a 10.
Un max en los limits de CPU hace lo mismo de forma más brusca. Un max de 1 núcleo por contenedor es razonable para el estado estable y garantiza que todo servicio con JIT intensivo arranque estrangulado.
apiVersion: v1kind: LimitRangemetadata: name: two-phase-defaults namespace: paymentsspec: limits: - type: Container defaultRequest: cpu: 100m # default de scheduling para contenedores que no fijan nada memory: 128Mi default: memory: 512Mi # default de limit de memoria; sin default de limit de CPU max: memory: 8Gi min: cpu: 10m memory: 32Mi maxLimitRequestRatio: memory: "4" # el limit de memoria puede subir hasta 4x por encima del requestAquí hay dos decisiones deliberadas. No hay default.cpu, así que un contenedor que fija un request de CPU y nada más corre sin limit de CPU y puede hacer burst sobre la capacidad ociosa del nodo durante el boot. Y maxLimitRequestRatio se fija solo para memoria, porque es ahí donde el ratio hace un trabajo útil: permite que el limit supere la asignación del arranque mientras el request se queda en la meseta, sin dejar que nadie fije un request de 128Mi con un limit de 64Gi.
Los valores de defaultRequest son bajos a propósito. Un default de LimitRange se aplica a todo contenedor que no especificó el suyo, y un default generoso infla en silencio los requests de cada sidecar y cada job del namespace. El default debe ser el piso que hace pasar la validación de cuota en la admisión, no una recomendación de dimensionamiento.
Solución 3: Reescribe las reglas de admisión según el propósito de cada recurso
La tercera capa es la que los equipos olvidan que tienen. Una ClusterPolicy de Kyverno o una constraint de Gatekeeper escrita hace dos años que dice "todo contenedor debe declarar requests y limits de CPU y memoria" sigue imponiendo un modelo de un solo número en cada deploy.
Reescríbela para exigir lo que importa y dejar de exigir lo que hace daño:
apiVersion: admissionregistration.k8s.io/v1kind: ValidatingAdmissionPolicymetadata: name: require-requests-and-memory-limitspec: failurePolicy: Fail matchConstraints: resourceRules: - apiGroups: ["apps"] apiVersions: ["v1"] operations: ["CREATE", "UPDATE"] resources: ["deployments", "statefulsets", "daemonsets"] validations: - expression: > object.spec.template.spec.containers.all(c, has(c.resources) && has(c.resources.requests) && has(c.resources.requests.cpu) && has(c.resources.requests.memory)) message: "Every container must set cpu and memory requests." - expression: > object.spec.template.spec.containers.all(c, has(c.resources.limits) && has(c.resources.limits.memory)) message: "Every container must set a memory limit."Requests de CPU: obligatorios, porque el scheduler y el HPA dependen de ellos. Requests y limits de memoria: obligatorios, porque el OOM killer no perdona y un limit de memoria es una barrera de seguridad real. Limits de CPU: ni se mencionan. Los equipos que tengan una razón concreta para fijar uno (un batch job ruidoso, un nodo multi-tenant) todavía pueden hacerlo; la política simplemente deja de hacer que todos los demás paguen el peaje del arranque.
Si tu organización exige QoS Guaranteed (requests iguales a limits) para ciertos niveles, sé explícito sobre el costo. Guaranteed significa que el pico de arranque se convierte en una reserva permanente en cada réplica. Es el compromiso correcto para una base de datos donde la latencia es crítica. Es el equivocado para 40 réplicas de API sin estado.
Solución 4: Dimensiona la memoria para el arranque y la CPU para el estado estable
Cuando la capa de políticas deja de forzar una única respuesta, la decisión por workload se simplifica, y es distinta para cada recurso.
El limit de memoria debe superar el pico de arranque. No existe la degradación elegante para la memoria. Si la inicialización asigna 900Mi y el limit es 768Mi, el contenedor muere con código de salida 137 antes de llegar siquiera a su meseta de 400Mi. Toma max_over_time(container_memory_working_set_bytes[5m]) sobre una ventana que incluya un rollout y fija el limit por encima de ese número con margen. Para workloads JVM, recuerda que el heap es solo una parte del panorama: el metaspace, la code cache y los stacks de los hilos quedan fuera de -Xmx.
El request de memoria se queda en la meseta. El request es lo que el scheduler reserva y lo que la cuota cuenta. Fijarlo en el working set de estado estable con un margen moderado mantiene el bin-packing fiel a la realidad. La brecha entre request y limit coloca al pod en QoS Burstable, lo que significa que es candidato a desalojo bajo presión de memoria del nodo antes que los pods Guaranteed. Para la mayoría de los servicios sin estado es un compromiso aceptable; para los que no, fija el request igual al limit de forma deliberada y acepta la reserva.
El request de CPU se queda en la meseta y el limit de CPU no existe. Sin cuota de CFS, el arranque toma prestados ciclos ociosos del nodo y los devuelve un minuto después. El request sigue importando: es lo que Karpenter y el scheduler usan para ubicar el pod, y lo que el HPA usa como divisor de la utilización. Dimensiónalo al p95 del estado estable, no al burst.
El único punto donde esto se rompe es un rollout que coloca muchos pods con picos en el mismo nodo recién creado a la vez. Sin CPU ociosa que tomar prestada, el arranque va lento por contención en lugar de por throttling. Acota maxSurge para que los pods nuevos lleguen en oleadas y no todos a la vez, y considera un topologySpreadConstraint sobre kubernetes.io/hostname para que los pods nuevos de un rollout no se apilen en un solo nodo. Un startupProbe con un failureThreshold dimensionado para el caso lento evita que el kubelet reinicie un pod que simplemente está arrancando bajo carga.
Solución 5: Deja que el recomendador vea dos fases y que el pod cambie de tamaño
Todo lo anterior evita que la política imponga el número equivocado. No produce el correcto. Para eso, el recomendador tiene que saber que el arranque y el estado estable son distintos, y el pod tiene que poder moverse entre ellos.
El Vertical Pod Autoscaler con su recomendador por defecto construye un histograma con decaimiento sobre aproximadamente ocho días de muestras. Un burst de 45 segundos es ruido para él, así que recomienda la meseta, y el siguiente rollout sufre throttling. Puedes restringirlo con minAllowed para que nunca baje de un piso que sobreviva el boot, pero eso solo vuelve a codificar el número de arranque como reserva permanente por otra puerta.
El resize de pods in-place cambia la forma del problema. Es estable desde Kubernetes 1.35, viene activado por defecto en 1.36, y permite cambiar los requests y limits de un contenedor en ejecución sin reinicio. El patrón es: arranca el pod con suficiente CPU y memoria para hacer el boot limpiamente, y luego redúcelo a los valores de estado estable cuando reporte que está listo. El startup CPU boost de GKE hace una versión de esto para Autopilot. El spec del pod solo necesita declarar que un cambio de CPU no debe provocar un reinicio:
containers:- name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequired - resourceName: memory restartPolicy: NotRequired # o RestartContainer si el runtime no puede reducir el heap en vivo resources: requests: cpu: "2" # valor de arranque; se redimensiona a ~200m tras el readiness memory: 1Gi limits: memory: 1Gi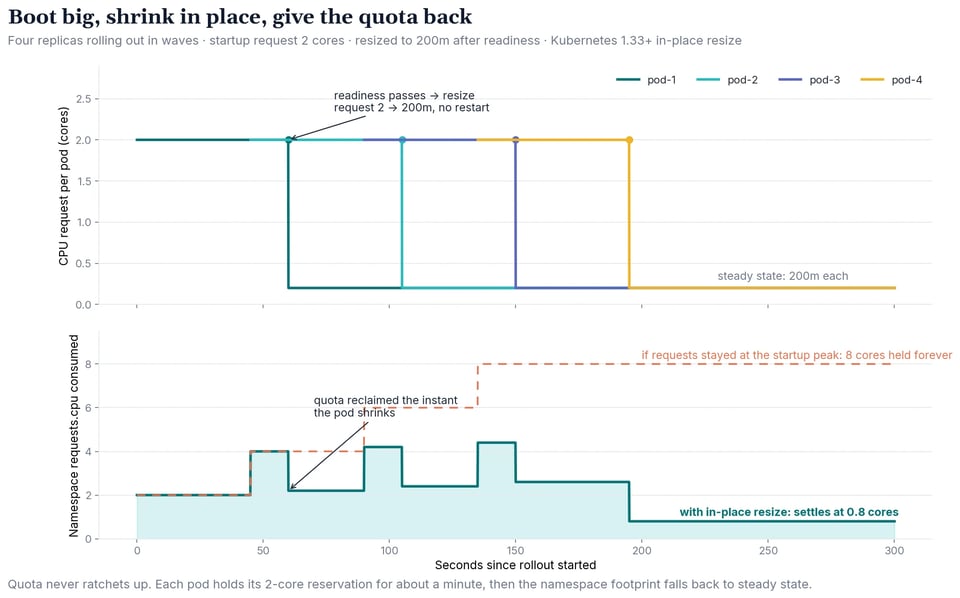
Aquí es donde el trabajo de cuota de la Solución 1 da sus frutos. Un resize se valida contra la ResourceQuota como cualquier otro cambio de requests, así que cuando el pod se reduce de 2 núcleos a 200m, el namespace recupera 1.8 núcleos de cuota de inmediato. Cuarenta réplicas arrancan en oleadas, cada una conserva su reserva de arranque durante alrededor de un minuto, y la huella de estado estable del namespace se estabiliza en 8 núcleos en lugar de 80. Los pods dejan de quedarse en Pending detrás de reservas que describen una fase en la que ya nadie está.
Una restricción de diseño a tener en cuenta: un resize no puede cambiar la clase de QoS de un pod. Un pod que arrancó Burstable sigue siendo Burstable, y un pod Guaranteed debe mantener requests iguales a limits en cada resize. Es otra razón para no imponer Guaranteed por política a workloads que no lo necesitan.
Checklist para reescribir la política
- Haz un inventario de las capas. Para cada namespace:
kubectl get resourcequota,limitrange -o yaml, más cada regla de Kyverno/Gatekeeper/VAP que toqueresources. Anota qué impone cada una. - Identifica la fase que asume cada capa. Cualquier
limits.cpuen una cuota, cualquiermax.cpuomaxLimitRequestRatio.cpubajo en un LimitRange, y cualquier regla de admisión de "debe fijar limit de CPU" es una política de estado estable. CualquierdefaultRequestpor encima de unos cientos de millicores, o cualquier mandato de requests iguales a limits, es una política de arranque. - Mide la brecha. Ejecuta la consulta de ratio entre requests y uso real por namespace. Cualquier valor por encima de 3 a 4 es cuota consumida por la fase equivocada.
- Mueve la cuota a los requests. Quita
limits.cpude laResourceQuota; conservarequests.*ylimits.memory. - Abre el LimitRange. Elimina
default.cpu, sube o eliminamax.cpu, aplicamaxLimitRequestRatiosolo a memoria. - Reescribe la admisión. Exige requests de CPU y memoria y un limit de memoria. Deja de exigir un limit de CPU.
- Redimensiona los diez workloads que más se reinician. Limit de memoria al pico de arranque, requests de memoria y CPU al p95 del estado estable, sin limit de CPU. Añade
maxSurgey restricciones de distribución si los rollouts generan contención. - Habilita el dimensionamiento en dos fases donde el clúster lo soporte. En 1.33+ con resize in-place disponible, declara
resizePolicyy deja que un controlador reduzca los pods después del readiness. - Repite el paso 3 una semana después. El ratio debería bajar hacia 1.5 a 2 y la tasa de throttling en contenedores jóvenes debería caer hacia cero al mismo tiempo. Si solo se movió uno, corregiste un recurso y no el otro.
Preguntas frecuentes
¿Qué es una resource quota de Kubernetes?
Una ResourceQuota es un objeto con alcance de namespace que acota el total de recursos que todos los pods de ese namespace pueden solicitar o tener como límite, junto con conteos de objetos como pods, services y PVCs. Se aplica en la admisión: un pod cuyos requests o limits empujarían al namespace por encima de sus valores hard es rechazado. Las cuotas cuentan los números del spec del pod, no el uso real, y por eso una cuota puede agotarse mientras los nodos detrás de ella están ociosos.
¿Una ResourceQuota debería acotar limits o requests?
Acota requests.cpu y requests.memory, porque los requests son lo que el scheduler reserva y lo que pagas en capacidad de nodos. Acota también limits.memory, ya que es una barrera de seguridad real contra un namespace que consuma toda la memoria del nodo. Evita limits.cpu en las cuotas: presiona a los equipos a reducir los limits de CPU para caber, lo que estrangula a los pods durante el arranque sin proteger el nodo.
¿Cuál es la diferencia entre ResourceQuota y LimitRange?
ResourceQuota fija un total a nivel de namespace. LimitRange fija defaults, mínimos, máximos y el ratio permitido entre limit y request por contenedor (o por pod, o por PVC). La cuota responde "cuánto puede usar este equipo en total"; el LimitRange responde "qué recibe un contenedor si no lo especifica, y qué es lo máximo que puede pedir". Ambos se aplican en la admisión.
¿Los resize de pods in-place cuentan contra la ResourceQuota? Sí. Un resize que aumenta los requests se valida contra la cuota del namespace y se rechaza si la excedería. Un resize que reduce los requests devuelve la diferencia a la cuota de inmediato. Eso es lo que permite que un patrón de arrancar-y-reducir mantenga la huella de cuota de estado estable de un namespace cerca de su uso real.
¿Por qué mis pods sufren throttling en el arranque aunque el nodo tiene CPU ociosa?
Porque un limit de CPU lo aplica la cuota de CFS del kernel por contenedor, independientemente de la carga del nodo. Si el limit es 500m, el contenedor recibe 50ms de cada período de 100ms sin importar cuán ocioso esté el nodo. El trabajo de arranque, como la compilación JIT o la carga de módulos, agota esa cuota al inicio de cada período y espera. Eliminar el limit de CPU, o subir maxLimitRequestRatio para que el limit pueda quedar muy por encima del request, permite que el arranque use la capacidad ociosa.
Políticas acordes a cómo se comportan realmente los contenedores
Todo lo anterior se puede hacer a mano: reescribir la cuota, abrir el LimitRange, actualizar la política de admisión, redimensionar los workloads más ruidosos y repetir cuando el código cambie. Lo difícil es esa última parte. Los perfiles de arranque cambian con cada actualización de dependencias y cada cambio de flag de la JVM, y una política que ajustaste correctamente en marzo vuelve a estar mal en junio.
PerfectScale by DoiT perfila cada contenedor a nivel de workload, así que el comportamiento de arranque y de estado estable aparece como patrones separados en lugar de un promedio mezclado, y sus recomendaciones dimensionan la memoria para superar el pico del boot mientras mantienen los requests en la meseta. Para workloads Java, detecta contenedores JVM automáticamente una vez habilitado el agente de Coroot, hace seguimiento del heap, el non-heap y el GC a lo largo del tiempo, marca los contenedores que corren sin configuración de heap explícita y respeta -Xms y -Xmx cuando propone o aplica un cambio. En clústeres con Kubernetes 1.33 o posterior, su automatización aplica el right-sizing in-place sin reiniciar el pod, y recurre a un rolling restart solo cuando un resize no es viable en el nodo actual, de modo que la cuota del namespace refleja lo que los workloads usan ahora y no lo que necesitaron durante 45 segundos después del último deploy.
¿Quieres ver un pod arrancar con 2 núcleos y estabilizarse en 200m sin reinicio y sin dejar cuota atrapada? Únete al taller sobre el pico de arranque de la JVM, o agenda una sesión técnica y revisaremos juntos las políticas de cuota y LimitRange de tus propios clústeres.