
PerfectScale
Como corrigir políticas de recursos do Kubernetes que otimizam para a fase errada
Suas políticas de ResourceQuota, LimitRange e admissão fixam um número por contêiner. Contêineres têm duas fases. Veja como reescrever a camada de políticas para que ela pare de escolher a errada.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Uma política de recursos do Kubernetes é cada camada que decide quais requests e limits um contêiner acaba recebendo:
ResourceQuota,LimitRange, regras de admissão (Kyverno, Gatekeeper,ValidatingAdmissionPolicy), defaults de Helm charts e qualquer recomendador que escreva os números. - Cada uma dessas camadas assume um único número por contêiner para toda a vida do contêiner. Contêineres têm duas fases, startup e steady state, e a diferença entre elas pode ser de 3x a 10x.
- Políticas ajustadas para o steady state estrangulam e matam pods por OOM durante o startup. Políticas ajustadas para o startup reservam capacidade que ninguém usa, enchem as quotas do namespace com requests ociosos e deixam pods em
Pendingenquanto o cluster fica meio vazio. - A correção é estrutural: quota sobre requests, não sobre limits;
LimitRangeque permite burst em vez de travá-lo; regras de admissão que exigem requests e limits de memória, mas param de obrigar limits de CPU; e um recomendador que enxerga startup e steady state como números separados. - O resize de pods in-place torna o último passo viável. O startup recebe o que precisa, depois o pod encolhe até seu patamar sem reiniciar, e a quota é recuperada no mesmo instante.
No último post, mostramos como enxergar um pico de startup: filtre as métricas de throttling e OOM pela idade do contêiner, e o burst que as médias escondem aparece nos primeiros 60 segundos de vida de cada contêiner. Este post é sobre o que fazer quando você já consegue vê-lo, porque a parte difícil não é editar um Deployment. É que a camada de políticas em volta desse Deployment foi escrita para uma fase e vai continuar empurrando cada workload de volta para ela.
O que é, de fato, uma política de recursos do Kubernetes
Quando as pessoas pesquisam por kubernetes resource quota, geralmente estão configurando um de dois objetos em um namespace, mas a política que determina os requests e limits finais de um contêiner tem mais camadas do que isso. Cada uma delas pode estar ajustada para a fase errada de forma independente.
| Camada | O que controla | O ajuste para steady state quebra o startup quando… | O ajuste para startup desperdiça capacidade quando… |
|---|---|---|---|
ResourceQuota |
Teto do namespace para a soma de requests.cpu, requests.memory, limits.cpu, limits.memory e contagem de pods |
Quota sobre limits.* força os times a encolher os limits para caber, então o startup esbarra na quota do CFS ou no OOM killer |
Quota sobre requests.* é consumida por requests dimensionados para o pico, que ficam 90% ociosos depois do primeiro minuto |
LimitRange |
default, defaultRequest, min, max e maxLimitRequestRatio por contêiner |
max ou um maxLimitRequestRatio baixo prende o limit perto do request, removendo a folga de burst de que o startup precisa |
defaultRequest definido alto para que contêineres sem valores sobrevivam ao boot, o que infla todo contêiner que não definiu o próprio |
Política de admissão (Kyverno, Gatekeeper, ValidatingAdmissionPolicy) |
Quais campos precisam estar presentes e qual formato devem ter | "Todo contêiner deve definir um limit de CPU" transforma um throttle opcional em obrigatório | "Requests devem ser iguais aos limits" (QoS Guaranteed em tudo) grava o pico de startup como reserva permanente |
| Defaults de charts e templates | O que um contêiner recebe quando ninguém pensou no assunto | Defaults copiados de um serviço que sobe rápido, aplicados a um que não sobe rápido | Defaults copiados de um serviço JVM, aplicados a um sidecar em Go |
| Recomendador (VPA, scripts, uma plataforma) | Os números que acabam chegando ao spec | Um histograma de vários dias recomenda o patamar e o próximo rollout sofre throttling | O recomendador vê o pico, recomenda o pico e nunca mais revisita depois que o pod sossega |
O scheduler lê os requests. O kernel aplica os limits. O sistema de quotas conta aquele dos dois que você mandou contar. Nenhum deles sabe que o contêiner acabou de terminar o class loading e não vai precisar daquela CPU de novo até o próximo deploy.
Como saber para qual fase sua política otimiza
Você não precisa ler todos os manifests. Três sinais mostram para que lado a política pende.
Pods sofrem throttling ou são mortos por OOM nos dois primeiros minutos e em nenhum outro momento. Isso é uma política de steady state. Em algum lugar, um LimitRange, uma regra de admissão ou um recomendador puxou os limits para baixo, até o patamar. Confirme com a query de throttling em contêineres jovens do post de detecção e com kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} concentrado logo após os rollouts.
Namespaces batem na quota enquanto os nós rodam com 20 a 30% de CPU. Isso é uma política de startup. Os requests são dimensionados para sobreviver ao boot, então a quota é consumida por reservas que ficam ociosas 60 segundos depois. Verifique diretamente:
# CPU solicitada vs CPU real, por namespacesum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})/sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))Uma razão de 1,5 a 2 é folga normal. Uma razão de 5 ou mais em um namespace inteiro significa que os requests descrevem uma fase que os contêineres deixaram para trás há muito tempo. kubectl describe resourcequota -n <namespace> mostra a mesma história pelo outro lado: requests.cpu usado a 95% do hard enquanto a soma de kubectl top pods dá uma fração disso.
Os dois ao mesmo tempo. Isso é mais comum do que parece. Os limits de CPU estão presos ao steady state (throttling no boot) enquanto os requests de memória estão dimensionados para o pico de startup (reservas ociosas). A política escolheu a fase errada para cada recurso, em direções opostas.
A matemática de quota que torna isso caro
Pegue o exemplo do post de detecção: um serviço com 40 réplicas, um burst de startup de 2 núcleos por cerca de 45 segundos e um steady state de 200m.
Dimensione os requests para o patamar e o Deployment consome 8 núcleos de quota de requests.cpu. Dimensione para o pico e ele consome 80. A quota de namespace que acomodava com folga dez serviços desses agora acomoda um, e os outros nove ficam em Pending com exceeded quota nos eventos, enquanto os nós que os receberiam rodam ociosos. Em um cluster onde os requests guiam o provisionamento de nós via Karpenter ou Cluster Autoscaler, esses 72 núcleos fantasmas também viram nós reais, com conta real.
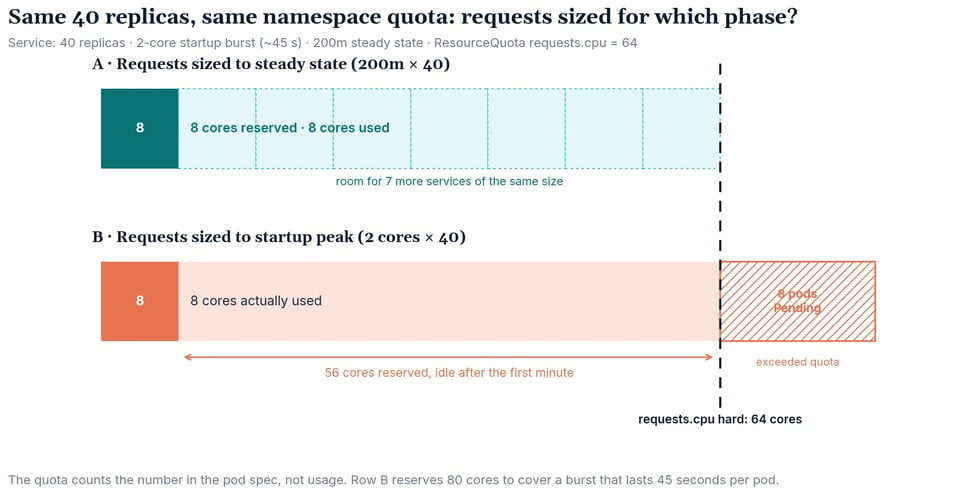
A quota está fazendo exatamente o que mandaram. O problema é que ela conta um número que foi verdadeiro por 45 segundos e o trata como verdadeiro pela vida inteira do pod.
Correção 1: coloque a quota sobre requests, não sobre limits
ResourceQuota pode limitar requests.cpu, limits.cpu ou ambos. Times costumam adicionar limits.cpu à quota partindo da teoria de que isso limita o uso no pior caso. O que acontece na prática é que os limits são forçados para baixo, em direção aos requests, para o namespace caber — o que remove a folga de que o startup precisa.
Requests são o que o scheduler reserva e o que você paga em capacidade de nó. Limite isso. Deixe os limits flutuarem.
apiVersion: v1kind: ResourceQuotametadata: name: team-payments namespace: paymentsspec: hard: requests.cpu: "64" requests.memory: 256Gi limits.memory: 512Gi # limits de memória são uma proteção real; mantenha-os # sem limits.cpu — limits de CPU estrangulam, não protegem o nó pods: "400"Mantenha limits.memory na quota. Memória não é compressível: um contêiner que excede seu limit de memória é morto, não desacelerado, e um teto de memória no nível do namespace é um controle legítimo de raio de impacto. Limits de CPU são diferentes, como o Anton mostrou no post sobre limits de CPU: eles não protegem nada no nó, e o preço é latência justamente no momento em que um pod está tentando subir.
Uma consequência para planejar: quando uma quota menciona requests.cpu, todo pod no namespace precisa especificar um request de CPU, ou é rejeitado na admissão. É aí que entram os defaults do LimitRange — e é o próximo lugar onde a fase errada acaba cravada.
Correção 2: faça o LimitRange permitir burst em vez de travá-lo
LimitRange é onde a maioria das políticas de steady state causa estrago, geralmente por meio de dois campos.
maxLimitRequestRatio limita quão acima do request um limit pode ficar. Uma razão de 1 ou 2 significa que um contêiner solicitando 200m pode ter um limit de no máximo 400m, e o burst de startup de 2 núcleos roda a um quinto da velocidade de que precisa. Se você pretende manter limits de CPU, a razão precisa cobrir a diferença real entre startup e patamar, que para serviços JVM e Node costuma ficar entre 5 e 10.
max em limits de CPU faz a mesma coisa de forma mais bruta. Um max de 1 núcleo por contêiner é razoável para o steady state e garante que todo serviço pesado em JIT faça o boot sob throttling.
apiVersion: v1kind: LimitRangemetadata: name: two-phase-defaults namespace: paymentsspec: limits: - type: Container defaultRequest: cpu: 100m # default de scheduling para contêineres que não definem nada memory: 128Mi default: memory: 512Mi # default de limit de memória; sem default de limit de CPU max: memory: 8Gi min: cpu: 10m memory: 32Mi maxLimitRequestRatio: memory: "4" # o limit de memória pode ficar até 4x acima do requestDuas coisas aqui são deliberadas. Não há default.cpu, então um contêiner que define um request de CPU e nada mais roda sem limit de CPU e pode aproveitar a capacidade ociosa do nó em burst durante o boot. E maxLimitRequestRatio está definido só para memória, porque é na memória que a razão faz trabalho útil: ela permite que o limit cubra a alocação de startup enquanto o request fica no patamar, sem deixar ninguém definir um request de 128Mi com um limit de 64Gi.
Os valores de defaultRequest são baixos de propósito. Um default de LimitRange é aplicado a todo contêiner que não especificou o próprio, e um default generoso infla silenciosamente os requests de cada sidecar e job do namespace. O default deve ser o piso que faz a verificação de admissão da quota passar, não uma recomendação de dimensionamento.
Correção 3: reescreva as regras de admissão em torno da função de cada recurso
A terceira camada é a que os times esquecem que têm. Uma ClusterPolicy do Kyverno ou uma constraint do Gatekeeper escrita dois anos atrás dizendo "todo contêiner deve declarar requests e limits de CPU e memória" ainda está impondo um modelo de número único a cada deploy.
Reescreva para exigir o que importa e parar de exigir o que prejudica:
apiVersion: admissionregistration.k8s.io/v1kind: ValidatingAdmissionPolicymetadata: name: require-requests-and-memory-limitspec: failurePolicy: Fail matchConstraints: resourceRules: - apiGroups: ["apps"] apiVersions: ["v1"] operations: ["CREATE", "UPDATE"] resources: ["deployments", "statefulsets", "daemonsets"] validations: - expression: > object.spec.template.spec.containers.all(c, has(c.resources) && has(c.resources.requests) && has(c.resources.requests.cpu) && has(c.resources.requests.memory)) message: "Every container must set cpu and memory requests." - expression: > object.spec.template.spec.containers.all(c, has(c.resources.limits) && has(c.resources.limits.memory)) message: "Every container must set a memory limit."Requests de CPU: obrigatórios, porque o scheduler e o HPA dependem deles. Requests e limits de memória: obrigatórios, porque o OOM killer não perdoa e um limit de memória é uma proteção real. Limits de CPU: nem mencionados. Times que têm uma razão específica para um (um batch job barulhento, um nó multi-tenant) ainda podem defini-lo; a política apenas para de fazer todo o resto pagar o imposto do startup.
Se a sua organização exige QoS Guaranteed (requests iguais a limits) para certos tiers, seja explícito sobre o custo. Guaranteed significa que o pico de startup vira reserva permanente em cada réplica. Essa é a troca certa para um banco de dados sensível a latência. É a errada para 40 réplicas stateless de API.
Correção 4: dimensione a memória para o startup e a CPU para o steady state
Quando a camada de políticas para de forçar uma resposta única, a decisão por workload fica mais simples — e é diferente para cada recurso.
O limit de memória precisa cobrir o pico de startup. Não existe degradação gradual para memória. Se a inicialização aloca 900Mi e o limit é 768Mi, o contêiner morre com exit code 137 antes mesmo de chegar ao seu patamar de 400Mi. Pegue max_over_time(container_memory_working_set_bytes[5m]) em uma janela que inclua um rollout e defina o limit acima desse número, com margem. Para workloads JVM, lembre que o heap é só parte do quadro: metaspace, code cache e stacks de threads ficam fora do -Xmx.
O request de memória fica no patamar. O request é o que o scheduler reserva e o que a quota conta. Defini-lo no working set de steady state, com uma folga modesta, mantém o bin-packing honesto. A distância entre request e limit coloca o pod em QoS Burstable, o que significa que ele é candidato a eviction sob pressão de memória do nó antes dos pods Guaranteed. Para a maioria dos serviços stateless, é uma troca aceitável; nos casos em que não é, defina request igual a limit deliberadamente e aceite a reserva.
O request de CPU fica no patamar; o limit de CPU, ausente. Sem quota do CFS, o startup pega emprestados ciclos ociosos do nó e os devolve um minuto depois. O request ainda importa: é o que o Karpenter e o scheduler usam para posicionar o pod, e é o denominador que o HPA usa para calcular a utilização. Dimensione-o pelo p95 do steady state, não pelo burst.
O único lugar onde isso quebra é um rollout que coloca muitos pods com picos no mesmo nó recém-criado, todos de uma vez. Sem CPU ociosa para emprestar, o startup roda devagar por contenção, não por throttling. Limite o maxSurge para que os novos pods cheguem em ondas em vez de todos juntos, e considere uma topologySpreadConstraint em kubernetes.io/hostname para que os pods novos de um rollout não se empilhem em um nó só. Um startupProbe com failureThreshold dimensionado para o caso lento impede que o kubelet reinicie um pod que está apenas subindo sob carga.
Correção 5: deixe o recomendador enxergar duas fases e deixe o pod mudar de tamanho
Tudo que está acima impede a política de forçar o número errado. Mas não produz o certo. Para isso, o recomendador precisa saber que startup e steady state são diferentes, e o pod precisa poder se mover entre eles.
O Vertical Pod Autoscaler, com seu recomendador padrão, constrói um histograma com decaimento sobre aproximadamente oito dias de amostras. Um burst de 45 segundos é ruído para ele, então ele recomenda o patamar — e o próximo rollout sofre throttling. Você pode restringi-lo com minAllowed para que nunca caia abaixo de um piso que sobreviva ao boot, mas isso só regrava o número de startup como reserva permanente por outra porta.
O resize de pods in-place muda o formato do problema. Ele ficou estável no Kubernetes 1.35, vem habilitado por padrão no 1.36 e permite que os requests e limits de um contêiner em execução mudem sem restart. O padrão é: inicie o pod com CPU e memória suficientes para um boot limpo e, depois que ele reportar readiness, faça o resize para baixo, até os valores de steady state. O startup CPU boost do GKE faz uma versão disso no Autopilot. O spec do pod só precisa declarar que uma mudança de CPU não deve disparar restart:
containers:- name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequired - resourceName: memory restartPolicy: NotRequired # ou RestartContainer se o runtime não conseguir encolher o heap ao vivo resources: requests: cpu: "2" # valor de startup; redimensionado para ~200m após o readiness memory: 1Gi limits: memory: 1Gi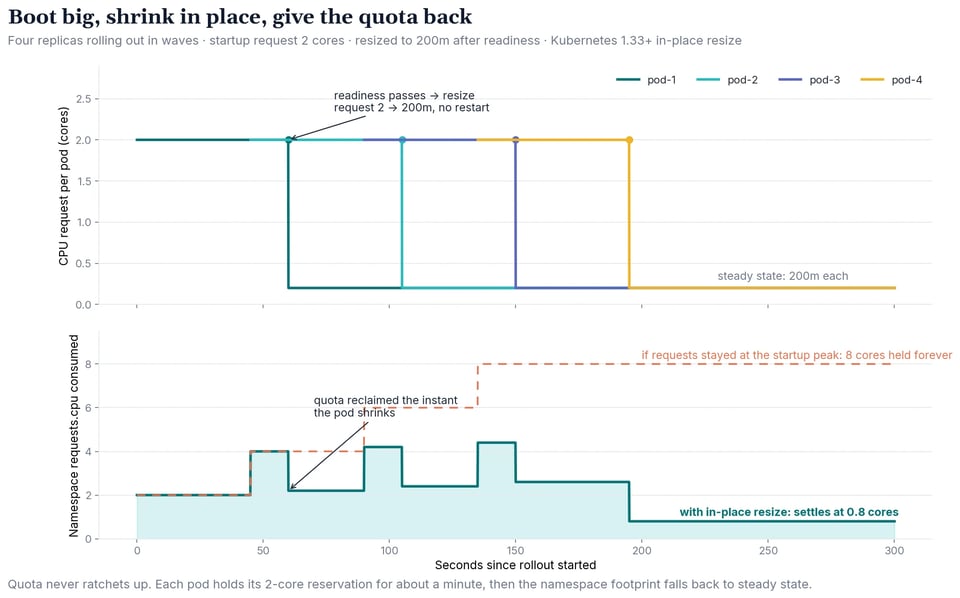
É aqui que o trabalho de quota da Correção 1 se paga. Um resize é verificado contra o ResourceQuota como qualquer outra mudança de request, então quando o pod encolhe de 2 núcleos para 200m, o namespace recupera 1,8 núcleo de quota imediatamente. Quarenta réplicas fazem o boot em ondas, cada uma segurando sua reserva de startup por cerca de um minuto, e a pegada de steady state do namespace se estabiliza em 8 núcleos em vez de 80. Pods param de ficar em Pending atrás de reservas que descrevem uma fase em que ninguém está.
Uma restrição para considerar no design: um resize não pode mudar a classe de QoS de um pod. Um pod que começou Burstable continua Burstable, e um pod Guaranteed tem que manter requests iguais a limits em todo resize. Mais um motivo para não exigir Guaranteed por política em workloads que não precisam disso.
Um checklist para reescrever a política
- Faça o inventário das camadas. Para cada namespace:
kubectl get resourcequota,limitrange -o yaml, mais toda regra de Kyverno/Gatekeeper/VAP que toque emresources. Anote o que cada uma impõe. - Descubra a fase que cada camada assume. Qualquer
limits.cpuem uma quota, qualquermax.cpuoumaxLimitRequestRatio.cpubaixo em um LimitRange, qualquer regra de admissão do tipo "deve definir limit de CPU" é uma política de steady state. QualquerdefaultRequestacima de algumas centenas de millicores, ou qualquer exigência de requests iguais a limits, é uma política de startup. - Meça a distância. Rode a query de razão requests/uso por namespace. Qualquer coisa acima de 3 a 4 é quota consumida pela fase errada.
- Mova a quota para os requests. Tire
limits.cpudoResourceQuota; mantenharequests.*elimits.memory. - Abra o LimitRange. Remova
default.cpu, aumente ou removamax.cpu, apliquemaxLimitRequestRatiosó na memória. - Reescreva a admissão. Exija requests de CPU e memória e um limit de memória. Pare de exigir limit de CPU.
- Redimensione os dez workloads que mais reiniciam. Limit de memória no pico de startup, requests de memória e CPU no p95 do steady state, sem limit de CPU. Adicione
maxSurgee spread constraints se os rollouts disputarem recursos. - Habilite o dimensionamento em duas fases onde o cluster suportar. No 1.33+ com resize in-place disponível, declare
resizePolicye deixe um controller encolher os pods após o readiness. - Repita o passo 3 uma semana depois. A razão deve cair em direção a 1,5 a 2 e a taxa de throttling em contêineres jovens deve cair em direção a zero ao mesmo tempo. Se só uma delas se moveu, você corrigiu um recurso e não o outro.
FAQ
O que é um resource quota no Kubernetes?
Um ResourceQuota é um objeto com escopo de namespace que limita o total de recursos que todos os pods daquele namespace podem solicitar ou ter como limit, além de contagens de objetos como pods, services e PVCs. Ele é aplicado na admissão: um pod cujos requests ou limits levariam o namespace acima dos valores hard é rejeitado. Quotas contam os números do spec do pod, não o uso real — por isso uma quota pode se esgotar enquanto os nós por trás dela ficam ociosos.
Um ResourceQuota deve limitar limits ou requests?
Limite requests.cpu e requests.memory, porque requests são o que o scheduler reserva e o que você paga em capacidade de nó. Limite limits.memory também, já que é uma proteção real contra um namespace consumir toda a memória do nó. Evite limits.cpu em quotas: ele pressiona os times a encolher os limits de CPU para caber, o que estrangula pods durante o startup sem proteger o nó.
Qual é a diferença entre ResourceQuota e LimitRange?
ResourceQuota define um total para o namespace inteiro. LimitRange define defaults, mínimos, máximos e a razão permitida entre limit e request por contêiner (ou por pod, ou por PVC). A quota responde "quanto esse time pode usar no total"; o LimitRange responde "o que um contêiner recebe se não disser nada, e qual o máximo que ele pode pedir". Ambos são aplicados na admissão.
Resizes in-place de pods entram na conta do ResourceQuota? Sim. Um resize que aumenta os requests é validado contra a quota do namespace e rejeitado se for excedê-la. Um resize que reduz os requests devolve a diferença à quota imediatamente. É isso que permite que um padrão de startup-depois-encolher mantenha a pegada de quota de steady state de um namespace próxima do uso real.
Por que meus pods sofrem throttling no startup mesmo com CPU ociosa no nó?
Porque um limit de CPU é aplicado pela quota do CFS do kernel por contêiner, independentemente da carga do nó. Se o limit é 500m, o contêiner recebe 50ms de cada período de 100ms, não importa quão ocioso o nó esteja. O trabalho de startup, como compilação JIT ou carregamento de módulos, esgota essa quota no início de cada período e espera. Remover o limit de CPU, ou aumentar o maxLimitRequestRatio para que o limit fique bem acima do request, permite que o startup use a capacidade ociosa.
Políticas que refletem como os contêineres realmente se comportam
Tudo que está acima pode ser feito à mão: reescreva a quota, abra o LimitRange, atualize a política de admissão, redimensione os workloads mais barulhentos, repita quando o código mudar. A parte difícil é justamente esse último item. Perfis de startup mudam a cada bump de dependência e a cada alteração de flag da JVM, e uma política que você ajustou corretamente em março já está errada de novo em junho.
O PerfectScale by DoiT traça o perfil de cada contêiner no nível do workload, então o comportamento de startup e de steady state aparece como padrões separados em vez de uma média misturada, e suas recomendações dimensionam a memória para cobrir o pico de boot mantendo os requests no patamar. Para workloads Java, ele detecta contêineres JVM automaticamente quando o agente Coroot está habilitado, acompanha heap, non-heap e GC ao longo do tempo, sinaliza contêineres rodando sem configurações explícitas de heap e respeita -Xms e -Xmx ao recomendar ou aplicar uma mudança. Em clusters com Kubernetes 1.33 ou superior, sua automação aplica right-sizing in-place sem reiniciar o pod, recorrendo a um rolling restart apenas quando um resize não é viável no nó atual — assim, a quota do namespace reflete o que os workloads estão usando agora, e não o que precisaram por 45 segundos depois do último deploy.
Quer ver um pod fazer boot com 2 núcleos e se estabilizar em 200m, sem restart e sem deixar quota presa? Participe do workshop sobre o pico de startup da JVM, ou agende uma sessão técnica e vamos analisar juntos as políticas de quota e LimitRange dos seus próprios clusters.