
PerfectScale
Corriger les politiques de ressources Kubernetes qui optimisent la mauvaise phase
Vos ResourceQuota, LimitRange et politiques d'admission encodent un seul chiffre par conteneur. Or un conteneur a deux phases. Voici comment réécrire la couche de politiques pour qu'elle cesse de choisir la mauvaise.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Une politique de ressources Kubernetes, c'est l'ensemble des couches qui déterminent les requests et limits finales d'un conteneur :
ResourceQuota,LimitRange, règles d'admission (Kyverno, Gatekeeper,ValidatingAdmissionPolicy), valeurs par défaut des charts Helm, et le moteur de recommandation qui écrit les chiffres. - Chacune de ces couches suppose un seul chiffre par conteneur pour toute sa durée de vie. Or un conteneur a deux phases, le démarrage et le régime stable, et l'écart entre les deux peut aller de 3x à 10x.
- Les politiques calibrées pour le régime stable provoquent du throttling et des OOM-kill au démarrage des pods. Celles calibrées pour le démarrage réservent de la capacité que personne n'utilise, saturent les quotas de namespace avec des requests inactives et laissent des pods en
Pendingalors que le cluster est à moitié vide. - Le correctif est structurel : des quotas sur les requests, pas sur les limits ; un
LimitRangequi autorise le burst au lieu de le brider ; des règles d'admission qui exigent des requests et des limits mémoire mais cessent d'imposer des limits CPU ; et un moteur de recommandation qui traite démarrage et régime stable comme deux chiffres distincts. - Le redimensionnement in-place des pods rend la dernière étape réaliste : le démarrage obtient ce dont il a besoin, puis le pod revient à son plateau sans redémarrage, et le quota est libéré au même instant.
Dans l'article précédent, nous avons vu comment repérer un pic de démarrage : filtrez les métriques de throttling et d'OOM par âge du conteneur, et le burst que les moyennes masquent apparaît dans les 60 premières secondes de vie de chaque conteneur. Cet article explique ce qu'il faut faire une fois le pic visible, car le plus dur n'est pas de modifier un Deployment. C'est que la couche de politiques autour de ce Deployment a été écrite pour une seule phase et continuera de ramener chaque workload vers elle.
Ce qu'est réellement une politique de ressources Kubernetes
Quand on cherche kubernetes resource quota, on configure généralement l'un des deux objets d'un namespace, mais la politique qui détermine les requests et limits finales d'un conteneur compte davantage de couches que cela. Et chacune peut être calibrée sur la mauvaise phase, indépendamment des autres.
| Couche | Ce qu'elle contrôle | Un calibrage régime stable casse le démarrage quand… | Un calibrage démarrage gaspille de la capacité quand… |
|---|---|---|---|
ResourceQuota |
Plafond à l'échelle du namespace sur la somme de requests.cpu, requests.memory, limits.cpu, limits.memory, et le nombre de pods |
Un quota sur limits.* force les équipes à réduire les limits pour tenir dedans, et le démarrage se heurte au quota CFS ou à l'OOM killer |
Un quota sur requests.* est consommé par des requests dimensionnées au pic, inactives à 90 % passée la première minute |
LimitRange |
default, defaultRequest, min, max, maxLimitRequestRatio par conteneur |
Un max ou un maxLimitRequestRatio bas colle la limit à la request et supprime la marge de burst dont le démarrage a besoin |
Un defaultRequest élevé pour que les conteneurs sans valeurs survivent au boot, ce qui gonfle tous les conteneurs qui n'ont rien défini |
Règles d'admission (Kyverno, Gatekeeper, ValidatingAdmissionPolicy) |
Les champs obligatoires et leur forme | Chaque conteneur doit définir une limit CPU transforme un throttle optionnel en throttle obligatoire | Les requests doivent égaler les limits (QoS Guaranteed partout) fige le pic de démarrage en réservation permanente |
| Valeurs par défaut des charts et templates | Ce qu'un conteneur reçoit quand personne n'y a réfléchi | Des valeurs copiées d'un service qui démarre vite, appliquées à un service qui démarre lentement | Des valeurs copiées d'un service JVM, appliquées à un sidecar Go |
| Moteur de recommandation (VPA, scripts, plateforme) | Les chiffres qui finissent dans la spec | Un histogramme sur plusieurs jours recommande le plateau, et le rollout suivant subit du throttling | Le moteur de recommandation voit le pic, le recommande et n'y revient jamais une fois le pod au calme |
Le scheduler lit les requests. Le noyau applique les limits. Le système de quotas comptabilise celle des deux que vous lui avez indiquée. Aucun des trois ne sait que le conteneur vient de terminer son chargement de classes et n'aura plus besoin de ce CPU avant le prochain déploiement.
Comment savoir pour quelle phase votre politique est calibrée
Pas besoin de relire chaque manifeste. Trois signaux indiquent de quel côté penche la politique.
Les pods subissent du throttling ou se font OOM-kill dans leurs deux premières minutes, et nulle part ailleurs. C'est une politique régime stable. Quelque part, un LimitRange, une règle d'admission ou un moteur de recommandation a ramené les limits au niveau du plateau. Confirmez avec la requête de throttling des conteneurs jeunes de l'article sur la détection, et avec kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} concentré juste après les rollouts.
Des namespaces atteignent leur quota alors que les nœuds tournent à 20 ou 30 % de CPU. C'est une politique démarrage. Les requests sont dimensionnées pour survivre au boot, donc le quota est consommé par des réservations qui deviennent inactives au bout de 60 secondes. Vérifiez directement :
# CPU demandé vs CPU réellement consommé, par namespacesum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})/sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))Un ratio de 1,5 à 2 correspond à une marge normale. Un ratio de 5 ou plus à l'échelle d'un namespace signifie que les requests décrivent une phase que les conteneurs ont quittée depuis longtemps. kubectl describe resourcequota -n <namespace> raconte la même histoire vue de l'autre côté : requests.cpu utilisé à 95 % du hard alors que la somme de kubectl top pods n'en représente qu'une fraction.
Les deux à la fois. C'est plus fréquent qu'il n'y paraît. Les limits CPU sont calées sur le régime stable (throttling au boot) tandis que les requests mémoire sont dimensionnées au pic de démarrage (réservations inactives). La politique a choisi la mauvaise phase pour chaque ressource, dans des directions opposées.
Le calcul de quota qui fait grimper la facture
Reprenons l'exemple de l'article sur la détection : un service à 40 replicas, un burst de démarrage de 2 cœurs pendant environ 45 secondes, et un régime stable à 200m.
Dimensionnez les requests pour le plateau et le Deployment consomme 8 cœurs de quota requests.cpu. Dimensionnez-les pour le pic et il en consomme 80. Le quota de namespace qui logeait confortablement dix services de ce type n'en loge plus qu'un, et les neuf autres restent en Pending avec exceeded quota dans leurs events pendant que les nœuds qui les auraient accueillis tournent à vide. Sur un cluster où les requests pilotent le provisionnement des nœuds via Karpenter ou le Cluster Autoscaler, ces 72 cœurs fantômes deviennent aussi de vrais nœuds, avec une vraie facture.
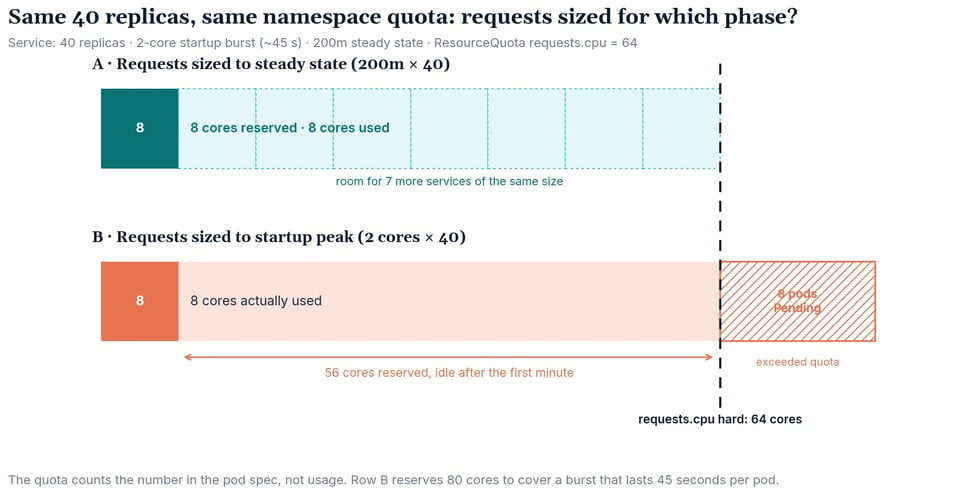
Le quota fait exactement ce qu'on lui a demandé. Le problème, c'est qu'il comptabilise un chiffre qui a été vrai pendant 45 secondes et le traite comme vrai pour toute la vie du pod.
Correctif 1 : mettre le quota sur les requests, pas sur les limits
ResourceQuota peut plafonner requests.cpu, limits.cpu, ou les deux. Les équipes ajoutent souvent limits.cpu au quota en pensant borner le pire cas. En pratique, cela pousse les limits vers les requests pour que le namespace tienne dans le quota, ce qui supprime la marge dont le démarrage a besoin.
Les requests sont ce que le scheduler réserve et ce que vous payez en capacité de nœuds. Plafonnez-les. Laissez les limits flotter.
apiVersion: v1kind: ResourceQuotametadata: name: team-payments namespace: paymentsspec: hard: requests.cpu: "64" requests.memory: 256Gi limits.memory: 512Gi # les limits mémoire sont une vraie borne de sécurité ; à conserver # pas de limits.cpu — les limits CPU throttlent, elles ne protègent pas le nœud pods: "400"Conservez limits.memory dans le quota. La mémoire n'est pas compressible : un conteneur qui dépasse sa limit mémoire est tué, pas ralenti, et un plafond mémoire au niveau du namespace est un contrôle légitime du rayon d'impact. Les limits CPU, c'est différent, comme Anton l'expliquait dans l'article sur les limits CPU : elles ne protègent rien sur le nœud et vous coûtent de la latence précisément au moment où un pod essaie de démarrer.
Une conséquence à anticiper : dès qu'un quota mentionne requests.cpu, chaque pod du namespace doit spécifier une request CPU, sinon il est rejeté à l'admission. C'est là qu'interviennent les valeurs par défaut du LimitRange — et c'est le prochain endroit où la mauvaise phase se retrouve figée.
Correctif 2 : un LimitRange qui autorise le burst au lieu de le brider
C'est dans le LimitRange que la plupart des politiques régime stable font le plus de dégâts, généralement via deux champs.
maxLimitRequestRatio plafonne l'écart entre une limit et sa request. Un ratio de 1 ou 2 signifie qu'un conteneur demandant 200m aura une limit d'au plus 400m, et le burst de démarrage à 2 cœurs tourne à un cinquième de la vitesse requise. Si vous tenez à conserver des limits CPU, le ratio doit couvrir le véritable écart entre démarrage et plateau, souvent de 5 à 10 pour les services JVM et Node.
max sur les limits CPU fait la même chose, plus brutalement. Un max d'un cœur par conteneur est raisonnable en régime stable et garantit que chaque service gourmand en JIT démarre sous throttling.
apiVersion: v1kind: LimitRangemetadata: name: two-phase-defaults namespace: paymentsspec: limits: - type: Container defaultRequest: cpu: 100m # request par défaut pour les conteneurs qui ne définissent rien memory: 128Mi default: memory: 512Mi # limit mémoire par défaut ; pas de limit CPU par défaut max: memory: 8Gi min: cpu: 10m memory: 32Mi maxLimitRequestRatio: memory: "4" # la limit mémoire peut dépasser la request jusqu'à 4xDeux choix sont délibérés ici. Il n'y a pas de default.cpu : un conteneur qui définit une request CPU et rien d'autre tourne sans limit CPU et peut burster dans la capacité inutilisée du nœud au boot. Et maxLimitRequestRatio ne s'applique qu'à la mémoire, parce que c'est là que le ratio est utile : il permet à la limit de couvrir l'allocation de démarrage pendant que la request reste au plateau, sans autoriser une request de 128Mi avec une limit de 64Gi.
Les valeurs de defaultRequest sont volontairement basses. Un défaut de LimitRange s'applique à chaque conteneur qui n'a pas spécifié le sien, et un défaut généreux gonfle silencieusement les requests de chaque sidecar et de chaque job du namespace. Le défaut doit être le plancher qui permet de passer le contrôle d'admission du quota, pas une recommandation de dimensionnement.
Correctif 3 : réécrire les règles d'admission selon le rôle de chaque ressource
La troisième couche est celle que les équipes oublient. Une ClusterPolicy Kyverno ou une contrainte Gatekeeper écrite il y a deux ans qui dit chaque conteneur doit déclarer des requests et des limits CPU et mémoire continue d'imposer un modèle à chiffre unique à chaque déploiement.
Réécrivez-la pour exiger ce qui compte et cesser d'exiger ce qui nuit :
apiVersion: admissionregistration.k8s.io/v1kind: ValidatingAdmissionPolicymetadata: name: require-requests-and-memory-limitspec: failurePolicy: Fail matchConstraints: resourceRules: - apiGroups: ["apps"] apiVersions: ["v1"] operations: ["CREATE", "UPDATE"] resources: ["deployments", "statefulsets", "daemonsets"] validations: - expression: > object.spec.template.spec.containers.all(c, has(c.resources) && has(c.resources.requests) && has(c.resources.requests.cpu) && has(c.resources.requests.memory)) message: "Chaque conteneur doit définir des requests cpu et mémoire." - expression: > object.spec.template.spec.containers.all(c, has(c.resources.limits) && has(c.resources.limits.memory)) message: "Chaque conteneur doit définir une limit mémoire."Requests CPU : obligatoires, parce que le scheduler et le HPA en dépendent. Requests et limits mémoire : obligatoires, parce que l'OOM killer ne pardonne pas et qu'une limit mémoire est une vraie borne de sécurité. Limits CPU : pas mentionnées. Les équipes qui ont une raison précise d'en définir une (un job batch bruyant, un nœud multi-tenant) peuvent toujours le faire ; la politique cesse simplement de faire payer la taxe de démarrage à tout le monde.
Si votre organisation impose la QoS Guaranteed (requests égales aux limits) pour certains niveaux de service, soyez explicite sur le coût : Guaranteed signifie que le pic de démarrage devient une réservation permanente sur chaque replica. C'est le bon compromis pour une base de données critique en latence. C'est le mauvais pour 40 replicas d'API stateless.
Correctif 4 : dimensionner la mémoire pour le démarrage, le CPU pour le régime stable
Une fois que la couche de politiques cesse d'imposer une réponse unique, la décision par workload devient plus simple, et elle diffère selon la ressource.
La limit mémoire couvre le pic de démarrage. Il n'existe pas de dégradation progressive pour la mémoire. Si l'initialisation alloue 900Mi et que la limit est à 768Mi, le conteneur meurt avec le code de sortie 137 avant même d'atteindre son plateau à 400Mi. Prenez max_over_time(container_memory_working_set_bytes[5m]) sur une fenêtre incluant un rollout et placez la limit au-dessus de ce chiffre, avec une marge. Pour les workloads JVM, rappelez-vous que le heap n'est qu'une partie du tableau : metaspace, code cache et piles de threads vivent en dehors de -Xmx.
La request mémoire se place au plateau. La request est ce que le scheduler réserve et ce que le quota comptabilise. La fixer au working set du régime stable avec une marge modeste préserve un bin-packing réaliste. L'écart entre request et limit place le pod en QoS Burstable, c'est-à-dire candidat à l'éviction sous pression mémoire du nœud avant les pods Guaranteed. Pour la plupart des services stateless, le compromis est acceptable ; pour ceux où il ne l'est pas, fixez délibérément la request égale à la limit et assumez la réservation.
La request CPU se place au plateau, la limit CPU est absente. Sans quota CFS, le démarrage emprunte les cycles inutilisés du nœud et les rend une minute plus tard. La request compte toujours : c'est elle que Karpenter et le scheduler utilisent pour placer le pod, et c'est par elle que le HPA divise l'utilisation. Dimensionnez-la au p95 du régime stable, pas au burst.
Le seul scénario où cela coince : un rollout qui fait atterrir d'un coup de nombreux pods à fort pic de démarrage sur le même nœud fraîchement provisionné. Sans CPU inutilisé à emprunter, le démarrage est lent par contention plutôt que par throttling. Bornez maxSurge pour que les nouveaux pods arrivent par vagues plutôt que tous en même temps, et envisagez une topologySpreadConstraint sur kubernetes.io/hostname pour que les nouveaux pods d'un rollout ne s'empilent pas sur un seul nœud. Une startupProbe avec un failureThreshold dimensionné pour le cas lent évite au kubelet de redémarrer un pod qui est simplement en train de booter sous charge.
Correctif 5 : laisser le moteur de recommandation voir deux phases, et laisser le pod changer de taille
Tout ce qui précède empêche la politique d'imposer le mauvais chiffre. Cela ne produit pas le bon. Pour cela, le moteur de recommandation doit savoir que démarrage et régime stable sont différents, et le pod doit pouvoir passer de l'un à l'autre.
Le Vertical Pod Autoscaler avec son moteur de recommandation par défaut construit un histogramme à décroissance sur environ huit jours d'échantillons. Un burst de 45 secondes n'est pour lui que du bruit : il recommande le plateau, et le rollout suivant subit du throttling. Vous pouvez le contraindre avec minAllowed pour qu'il ne descende jamais sous un plancher qui survit au boot, mais cela revient à figer de nouveau le chiffre de démarrage en réservation permanente, simplement par un autre biais.
Le redimensionnement in-place des pods change la nature du problème. Stable depuis Kubernetes 1.35 et activé par défaut en 1.36, il permet de modifier les requests et limits d'un conteneur en cours d'exécution sans redémarrage. Le schéma : démarrer le pod avec assez de CPU et de mémoire pour booter proprement, puis le redimensionner vers les valeurs de régime stable une fois qu'il se déclare prêt. Le startup CPU boost de GKE en propose une variante pour Autopilot. La spec du pod doit simplement déclarer qu'un changement de CPU ne doit pas déclencher de redémarrage :
containers:- name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequired - resourceName: memory restartPolicy: NotRequired # ou RestartContainer si le runtime ne peut pas réduire le heap à chaud resources: requests: cpu: "2" # valeur de démarrage ; redimensionnée à ~200m après readiness memory: 1Gi limits: memory: 1Gi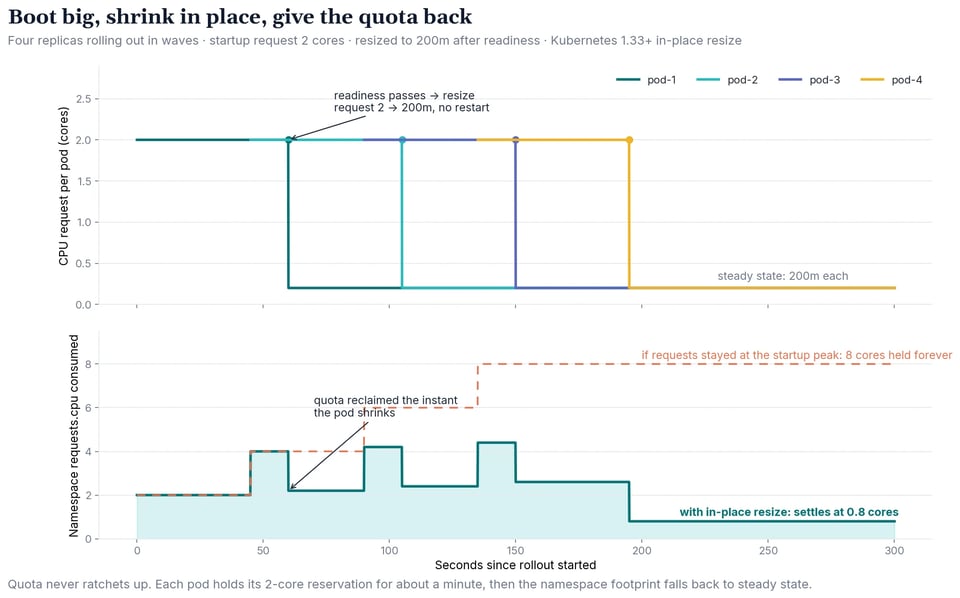
C'est ici que le travail sur le quota du correctif 1 porte ses fruits. Un resize est vérifié contre le ResourceQuota comme n'importe quelle modification de requests : quand le pod passe de 2 cœurs à 200m, le namespace récupère immédiatement 1,8 cœur de quota. Quarante replicas bootent par vagues, chacun gardant sa réservation de démarrage environ une minute, et l'empreinte en régime stable du namespace se stabilise à 8 cœurs au lieu de 80. Les pods cessent d'attendre en Pending derrière des réservations qui décrivent une phase dans laquelle plus personne ne se trouve.
Une contrainte à intégrer dès la conception : un resize ne peut pas changer la classe QoS d'un pod. Un pod parti en Burstable reste Burstable, et un pod Guaranteed doit garder des requests égales aux limits à chaque resize. Une raison de plus de ne pas imposer Guaranteed par politique aux workloads qui n'en ont pas besoin.
Check-list de réécriture des politiques
- Inventoriez les couches. Pour chaque namespace :
kubectl get resourcequota,limitrange -o yaml, plus chaque règle Kyverno/Gatekeeper/VAP qui touche àresources. Notez ce que chacune impose. - Identifiez la phase que chaque couche suppose. Tout
limits.cpudans un quota, toutmax.cpuoumaxLimitRequestRatio.cpubas dans un LimitRange, toute règle d'admission exigeant une limit CPU est une politique régime stable. ToutdefaultRequestau-dessus de quelques centaines de millicores, ou toute obligation d'égalité entre requests et limits, est une politique démarrage. - Mesurez l'écart. Lancez la requête du ratio requests/consommation par namespace. Au-dessus de 3 à 4, le quota est consommé par la mauvaise phase.
- Déplacez le quota vers les requests. Retirez
limits.cpuduResourceQuota; conservezrequests.*etlimits.memory. - Ouvrez le LimitRange. Supprimez
default.cpu, relevez ou supprimezmax.cpu, appliquezmaxLimitRequestRatioà la mémoire uniquement. - Réécrivez l'admission. Exigez des requests CPU et mémoire et une limit mémoire. Cessez d'exiger une limit CPU.
- Redimensionnez les dix workloads qui redémarrent le plus. Limit mémoire au pic de démarrage, requests mémoire et CPU au p95 du régime stable, pas de limit CPU. Ajoutez
maxSurgeet des contraintes de répartition si les rollouts se disputent les ressources. - Activez le dimensionnement en deux phases là où le cluster le permet. Sur 1.33+ avec le resize in-place disponible, déclarez
resizePolicyet laissez un contrôleur réduire les pods après readiness. - Relancez l'étape 3 une semaine plus tard. Le ratio doit retomber vers 1,5 à 2 et le taux de throttling des conteneurs jeunes doit tendre vers zéro en même temps. Si un seul des deux a bougé, vous avez corrigé une ressource mais pas l'autre.
FAQ
Qu'est-ce qu'un resource quota Kubernetes ?
Un ResourceQuota est un objet à portée namespace qui plafonne le total des ressources que l'ensemble des pods de ce namespace peuvent demander ou se voir limiter, ainsi que des compteurs d'objets comme les pods, services et PVC. Il est appliqué à l'admission : un pod dont les requests ou limits feraient dépasser les valeurs hard du namespace est rejeté. Les quotas comptabilisent les chiffres de la spec du pod, pas la consommation réelle — c'est pourquoi un quota peut être épuisé alors que les nœuds derrière tournent à vide.
Un ResourceQuota doit-il plafonner les limits ou les requests ?
Plafonnez requests.cpu et requests.memory : les requests sont ce que le scheduler réserve et ce que vous payez en capacité de nœuds. Plafonnez aussi limits.memory, borne de sécurité réelle contre un namespace qui consommerait toute la mémoire des nœuds. Évitez limits.cpu dans les quotas : cela pousse les équipes à réduire les limits CPU pour respecter le quota, ce qui provoque du throttling au démarrage des pods sans protéger le nœud.
Quelle est la différence entre ResourceQuota et LimitRange ?
ResourceQuota fixe un total à l'échelle du namespace. LimitRange fixe, par conteneur (ou par pod, ou par PVC), des valeurs par défaut, des minimums, des maximums et le ratio autorisé entre limit et request. Le quota répond à la question combien cette équipe peut utiliser au total ; le LimitRange répond à ce que reçoit un conteneur qui ne précise rien, et le maximum qu'il peut demander. Les deux sont appliqués à l'admission.
Les resizes in-place de pods sont-ils décomptés du ResourceQuota ? Oui. Un resize qui augmente les requests est validé contre le quota du namespace et rejeté s'il devait le dépasser. Un resize qui les diminue rend la différence au quota immédiatement. C'est ce qui permet au schéma démarrage-puis-réduction de maintenir l'empreinte de quota en régime stable d'un namespace proche de sa consommation réelle.
Pourquoi mes pods sont-ils throttlés au démarrage alors que le nœud a du CPU disponible ?
Parce qu'une limit CPU est appliquée par le quota CFS du noyau, par conteneur, indépendamment de la charge du nœud. Avec une limit à 500m, le conteneur reçoit 50ms par période de 100ms, quel que soit le degré d'inactivité du nœud. Le travail de démarrage, comme la compilation JIT ou le chargement de modules, épuise ce quota en début de période puis attend. Supprimer la limit CPU, ou relever maxLimitRequestRatio pour que la limit puisse se situer bien au-dessus de la request, permet au démarrage d'exploiter la capacité inutilisée.
Des politiques alignées sur le comportement réel des conteneurs
Tout ce qui précède peut se faire à la main : réécrire le quota, ouvrir le LimitRange, mettre à jour la politique d'admission, redimensionner les workloads les plus bruyants, et recommencer quand le code change. Le plus dur, c'est cette dernière partie. Les profils de démarrage bougent à chaque montée de version d'une dépendance et à chaque changement de flag JVM, et une politique correctement calibrée en mars est de nouveau fausse en juin.
PerfectScale by DoiT profile chaque conteneur au niveau du workload : démarrage et régime stable apparaissent comme des profils distincts plutôt que comme une moyenne lissée, et ses recommandations dimensionnent la mémoire pour couvrir le pic de boot tout en gardant les requests au plateau. Pour les workloads Java, il détecte automatiquement les conteneurs JVM une fois l'agent Coroot activé, suit le heap, le non-heap et le GC dans le temps, signale les conteneurs tournant sans réglages de heap explicites, et respecte -Xms et -Xmx quand il recommande ou applique un changement. Sur les clusters en Kubernetes 1.33 ou plus, son automatisation applique le right-sizing in-place sans redémarrer le pod, et ne recourt à un rolling restart que lorsqu'un resize n'est pas réalisable sur le nœud courant — le quota du namespace reflète ainsi ce que les workloads consomment maintenant, pas ce dont ils ont eu besoin pendant 45 secondes après le dernier déploiement.
Envie de voir un pod booter à 2 cœurs et se stabiliser à 200m, sans redémarrage et sans quota immobilisé inutilement ? Rejoignez le workshop sur le pic de démarrage JVM, ou réservez une session technique et nous examinerons ensemble les politiques de quota et de LimitRange de vos propres clusters.