
PerfectScale
誤ったフェーズに最適化されたKubernetesリソースポリシーの直し方
ResourceQuota、LimitRange、アドミッションポリシーが持てるのは、コンテナごとに1つの数値だけ。しかしコンテナには2つのフェーズがあります。誤ったほうを選び続けるポリシー層の書き換え方を解説します。
このページはEnglish、Deutsch、Español、Français、Italiano、Portuguêsでもご覧いただけます。


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Kubernetesのリソースポリシーとは、コンテナに最終的に設定されるrequestsとlimitsを決めるすべての層のことです。
ResourceQuota、LimitRange、アドミッションルール(Kyverno、Gatekeeper、ValidatingAdmissionPolicy)、Helmチャートのデフォルト値、そして数値を実際に書き込むレコメンダーまで含まれます。 - これらの層はいずれも、コンテナの生存期間全体に対してコンテナごとに1つの数値を前提としています。コンテナには起動時と定常時という2つのフェーズがあり、その差は3倍から10倍に達することがあります。
- 定常時向けにチューニングされたポリシーは、起動中のPodをスロットリングし、OOM killしてしまいます。起動時向けにチューニングされたポリシーは、誰も使わないキャパシティを予約し、アイドルなrequestsでnamespaceのクォータを埋め尽くし、クラスタが半分空いているのにPodを
Pendingのまま放置します。 - 修正は構造的なものです。クォータはlimitsではなくrequestsに。
LimitRangeはバーストを抑え込むのではなく許容するように。アドミッションルールはrequestsとメモリlimitsを必須にしつつCPU limitsの強制をやめる。そしてレコメンダーには起動時と定常時を別々の数値として見せることです。 - In-placeのPodリサイズによって、この最後のステップが現実的になります。起動時に必要なリソースを確保した後、Podは再起動なしで定常値まで縮小され、その瞬間にクォータも回収されます。
前回の記事では、起動時スパイクを可視化する方法を取り上げました。スロットリングとOOMのメトリクスをコンテナの経過時間でフィルタすると、平均値に埋もれていたバーストが、すべてのコンテナのライフタイムの最初の60秒に現れます。本記事では、それが見えるようになった後に何をすべきかを解説します。難しいのは1つのDeploymentを編集することではありません。そのDeploymentを取り巻くポリシー層が1つのフェーズ向けに書かれており、あらゆるworkloadをそこへ押し戻し続けることです。
Kubernetesリソースポリシーとは実際には何か
kubernetes resource quotaで検索する人は、たいていnamespace内の2つのオブジェクトのどちらかを設定しようとしていますが、コンテナの最終的なrequestsとlimitsを決めるポリシーには、それ以上の層があります。そして、それぞれの層が独立して誤ったフェーズにチューニングされ得ます。
| 層 | 制御対象 | 定常時チューニングが起動を壊すのは… | 起動時チューニングがキャパシティを浪費するのは… |
|---|---|---|---|
ResourceQuota |
namespace全体でのrequests.cpu、requests.memory、limits.cpu、limits.memoryの合計とPod数の上限 |
limits.*へのクォータはチームにlimitsの縮小を強いるため、起動時にCFSクォータやOOM killerに引っかかる |
requests.*のクォータが、最初の1分を過ぎると90%アイドルになるピークサイズのrequestsに消費される |
LimitRange |
コンテナごとのdefault、defaultRequest、min、max、maxLimitRequestRatio |
maxや低いmaxLimitRequestRatioがlimitをrequest付近に固定し、起動に必要なバースト用の余裕を奪う |
未指定のコンテナが起動を乗り切れるようdefaultRequestを高く設定した結果、自分で指定しなかったすべてのコンテナが水増しされる |
アドミッションポリシー(Kyverno、Gatekeeper、ValidatingAdmissionPolicy) |
どのフィールドを必須とし、どのような形式を許すか | 「すべてのコンテナはCPU limitを設定しなければならない」というルールが、任意だったスロットリングを強制に変える | 「requestsはlimitsと等しくなければならない」(全面的なGuaranteed QoS)というルールが、起動ピークを恒久的な予約として固定する |
| チャートやテンプレートのデフォルト | 誰も検討しなかった場合にコンテナが受け取る値 | 高速に起動するサービスからコピーされたデフォルトが、そうでないサービスに適用される | JVMサービスからコピーされたデフォルトが、Goのサイドカーに適用される |
| レコメンダー(VPA、スクリプト、プラットフォーム) | 最終的にspecに反映される数値 | 数日分のヒストグラムが定常値を推奨し、次のロールアウトでスロットリングが発生する | レコメンダーがピークを見てそれを推奨し、Podが静かになっても二度と見直さない |
スケジューラはrequestsを読みます。カーネルはlimitsを強制します。クォータシステムは、指定されたほうを数えます。どれも、コンテナがクラスロードを終えたばかりで、次のデプロイまでそのCPUを必要としないことを知りません。
ポリシーがどちらのフェーズに最適化されているかを見分ける方法
すべてのマニフェストを読む必要はありません。3つのシグナルで、ポリシーがどちらに偏っているかが分かります。
Podが最初の2分間だけスロットリングまたはOOM killされ、それ以外では発生しない。 これは定常時向けのポリシーです。どこかでLimitRange、アドミッションルール、またはレコメンダーがlimitsを定常値まで引き下げています。検知編で紹介した起動直後のコンテナに絞ったスロットリングクエリと、ロールアウト直後に集中するkube_pod_container_status_last_terminated_reason{reason="OOMKilled"}で確認してください。
ノードのCPU使用率が20〜30%なのにnamespaceがクォータ上限に達する。 これは起動時向けのポリシーです。requestsが起動を乗り切るサイズになっているため、60秒後にはアイドルになる予約でクォータが消費されています。直接確認できます。
# namespaceごとの要求CPUと実際のCPU使用量の比較sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})/sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))比率が1.5〜2なら通常の余裕です。namespace全体で5以上なら、requestsが示しているのは、コンテナがとうの昔に過ぎ去ったフェーズです。kubectl describe resourcequota -n <namespace>は同じ状況を反対側から示します。requests.cpuがhardの95%使用されているのに、kubectl top podsの合計はその数分の一にしかなりません。
両方が同時に起きている。 これは意外によくあるケースです。CPU limitsは定常値に固定され(起動時のスロットリング)、メモリrequestsは起動ピークに合わせて設定されています(アイドルな予約)。ポリシーがリソースごとに、逆方向に誤ったフェーズを選んでいるのです。
この問題が高くつくクォータの計算
検知編の例を取り上げましょう。40レプリカ、約45秒間続く2コアの起動バースト、200mの定常状態を持つサービスです。
requestsを定常値に合わせれば、Deploymentはrequests.cpuクォータを8コア消費します。ピークに合わせれば80コアです。こうしたサービスを10個余裕で収容できていたnamespaceクォータは1個しか収容できなくなり、残りの9個は、本来着地するはずだったノードがアイドルのまま稼働する中、イベントにexceeded quotaを残してPendingで待ち続けます。requestsがKarpenterやCluster Autoscalerを通じてノードのプロビジョニングを駆動するクラスタでは、その幻の72コアも実際のノードとなり、実際の請求につながります。
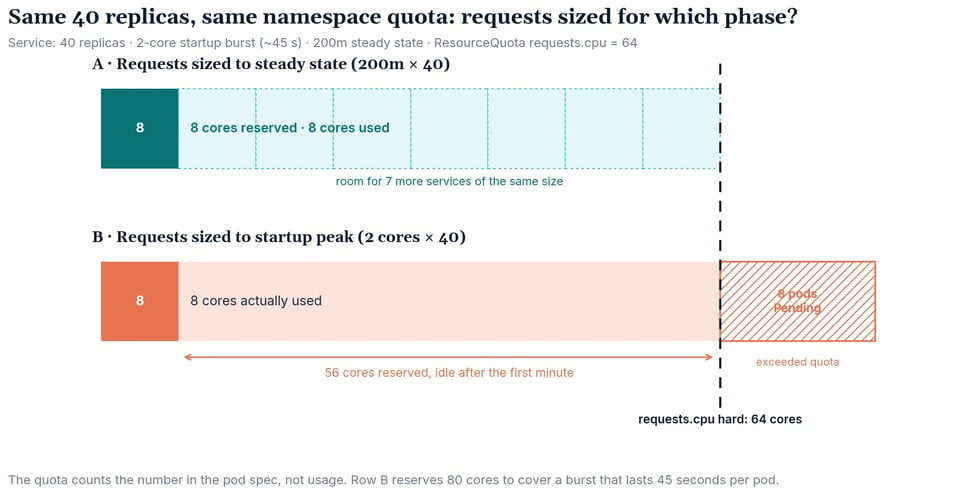
クォータは指示されたとおりに動いているだけです。問題は、45秒間だけ正しかった数値を、Podの生存期間全体で正しいものとして数えてしまうことです。
修正1:クォータはlimitsではなくrequestsにかける
ResourceQuotaはrequests.cpu、limits.cpu、またはその両方に上限を設定できます。最悪ケースの使用量を抑えられるという理屈でlimits.cpuをクォータに追加するチームが少なくありません。しかし実際に起きるのは、namespaceに収まるようlimitsがrequests方向に押し下げられ、起動に必要な余裕が失われることです。
requestsはスケジューラが予約するものであり、ノードキャパシティとして支払う対象です。上限をかけるならそちらに。limitsは自由に動かせるようにしておきましょう。
apiVersion: v1kind: ResourceQuotametadata: name: team-payments namespace: paymentsspec: hard: requests.cpu: "64" requests.memory: 256Gi limits.memory: 512Gi # メモリlimitsは実質的な安全境界なので維持する # limits.cpuは設定しない — CPU limitsはスロットリングするだけでノードを守らない pods: "400"クォータにはlimits.memoryを残してください。メモリは圧縮不可能であり、メモリlimitを超えたコンテナは減速ではなく強制終了されます。namespaceレベルのメモリ上限は、影響範囲を抑える正当な制御手段です。CPU limitsは違います。AntonのCPU limitsの記事で取り上げたとおり、ノード上の何も守らず、Podが立ち上がろうとしているまさにその瞬間にレイテンシという代償を払わせます。
計画しておくべき影響が1つあります。クォータがrequests.cpuを指定した時点で、namespace内のすべてのPodはCPU requestを指定しなければアドミッションで拒否されます。そこでLimitRangeのデフォルトの出番ですが、ここが誤ったフェーズが刻み込まれる次の場所でもあります。
修正2:LimitRangeはバーストを抑え込むのではなく許容するように
LimitRangeは、多くの定常時向けポリシーが被害をもたらす場所であり、たいてい2つのフィールドが原因です。
maxLimitRequestRatioは、limitがrequestをどこまで上回れるかを制限します。比率が1や2だと、200mをリクエストするコンテナのlimitは最大400mとなり、2コアの起動バーストは必要な速度の5分の1で実行されます。CPU limitsをどうしても残すなら、この比率は起動時と定常時の実際の差をカバーする必要があり、JVMやNodeのサービスではしばしば5〜10になります。
CPU limitsのmaxは、同じことをもっと直接的に行います。コンテナあたり1コアというmaxは定常時には妥当ですが、JIT負荷の高いサービスは確実にスロットリングされながら起動することになります。
apiVersion: v1kind: LimitRangemetadata: name: two-phase-defaults namespace: paymentsspec: limits: - type: Container defaultRequest: cpu: 100m # 何も指定しないコンテナ向けのスケジューリング用デフォルト memory: 128Mi default: memory: 512Mi # メモリlimitのデフォルト。CPU limitのデフォルトは設けない max: memory: 8Gi min: cpu: 10m memory: 32Mi maxLimitRequestRatio: memory: "4" # メモリlimitはrequestの最大4倍までここには意図的な点が2つあります。default.cpuがないため、CPU requestだけを設定したコンテナはCPU limitなしで動作し、起動時にノードのアイドルキャパシティへバーストできます。また、maxLimitRequestRatioはメモリのみに設定しています。この比率が有効に働くのはメモリだからです。requestを定常値に保ったままlimitが起動時のアロケーションを超えられるようにしつつ、128Miのrequestに64Giのlimitを設定するような事態を防ぎます。
defaultRequestの値は意図的に低くしています。LimitRangeのデフォルトは自分で指定しなかったすべてのコンテナに適用されるため、余裕を持たせすぎたデフォルトはnamespace内のすべてのサイドカーやジョブのrequestsを静かに水増しします。デフォルトはクォータのアドミッションチェックを通すための下限であるべきで、サイジングの推奨値であってはなりません。
修正3:アドミッションルールを各リソースの目的に沿って書き直す
3つ目の層は、チームが存在自体を忘れがちな層です。2年前に書かれた「すべてのコンテナはCPUとメモリのrequestsとlimitsを宣言しなければならない」というKyvernoのClusterPolicyやGatekeeperのconstraintは、今もすべてのデプロイに単一数値モデルを強制し続けています。
重要なものを必須にし、害になるものの必須化をやめるよう書き直しましょう。
apiVersion: admissionregistration.k8s.io/v1kind: ValidatingAdmissionPolicymetadata: name: require-requests-and-memory-limitspec: failurePolicy: Fail matchConstraints: resourceRules: - apiGroups: ["apps"] apiVersions: ["v1"] operations: ["CREATE", "UPDATE"] resources: ["deployments", "statefulsets", "daemonsets"] validations: - expression: > object.spec.template.spec.containers.all(c, has(c.resources) && has(c.resources.requests) && has(c.resources.requests.cpu) && has(c.resources.requests.memory)) message: "Every container must set cpu and memory requests." - expression: > object.spec.template.spec.containers.all(c, has(c.resources.limits) && has(c.resources.limits.memory)) message: "Every container must set a memory limit."CPU requestsは必須。スケジューラとHPAがこれに依存するためです。メモリのrequestsとlimitsも必須。OOM killerは容赦がなく、メモリlimitは実質的な安全境界だからです。CPU limitsには言及しません。特定の理由(ノイジーなバッチジョブ、マルチテナントノード)があるチームは引き続き設定できます。ポリシーは、それ以外の全員に起動時のコストを負わせるのをやめるだけです。
組織が特定のティアにGuaranteed QoS(requestsとlimitsが等しい状態)を義務付けている場合は、そのコストを明示してください。Guaranteedとは、起動ピークがすべてのレプリカで恒久的な予約になるということです。レイテンシ要件の厳しいデータベースには正しいトレードオフですが、40個のステートレスなAPIレプリカには誤った選択です。
修正4:メモリは起動時に、CPUは定常時に合わせてサイジングする
ポリシー層が単一の答えを強制しなくなれば、workloadごとの判断はシンプルになります。しかもその判断はリソースごとに異なります。
メモリlimitは起動ピークを超える値に。 メモリには緩やかな劣化というものがありません。初期化で900Miを割り当てるのにlimitが768Miなら、コンテナは400Miの定常状態に到達する前に終了コード137で死にます。ロールアウトを含むウィンドウでmax_over_time(container_memory_working_set_bytes[5m])を取り、その数値に余裕を上乗せした値をlimitに設定してください。JVM workloadsでは、ヒープは全体の一部にすぎないことを忘れないでください。メタスペース、コードキャッシュ、スレッドスタックはすべて-Xmxの外にあります。
メモリrequestは定常値に。 requestはスケジューラが予約し、クォータが数える対象です。定常時のワーキングセットに控えめな余裕を加えた値に設定すれば、ビンパッキングの精度が保たれます。requestとlimitの差によってPodはBurstable QoSになり、ノードのメモリ逼迫時にはGuaranteedなPodより先に退避(eviction)の候補になります。多くのステートレスサービスにとっては許容できるトレードオフですが、そうでないものについては、意図的にrequestをlimitと等しく設定し、予約を受け入れてください。
CPU requestは定常値に、CPU limitは設定しない。 CFSクォータがなければ、起動時はノードのアイドルサイクルを借り、1分後に返します。requestは依然として重要です。Karpenterとスケジューラが配置に使い、HPAが使用率の分母に使うからです。バーストではなく定常時のp95に合わせて設定してください。
これが破綻する唯一の場面は、ロールアウトで多数のスパイキーなPodが同じ新しいノードに一斉に着地する場合です。借りられるアイドルCPUがなければ、起動はスロットリングではなく競合によって遅くなります。maxSurgeを制限して新しいPodが一斉ではなく波状に到着するようにし、ロールアウトの新しいPodが1つのノードに積み重ならないよう、kubernetes.io/hostnameに対するtopologySpreadConstraintの利用を検討してください。遅いケースに合わせたfailureThresholdを持つstartupProbeがあれば、負荷の下で単に起動中なだけのPodをkubeletが再起動してしまうのを防げます。
修正5:レコメンダーに2つのフェーズを見せ、Podがサイズを変えられるようにする
ここまでの修正は、ポリシーが誤った数値を強制するのを止めるものであり、正しい数値を生み出すものではありません。そのためには、レコメンダーが起動時と定常時は別物だと知っている必要があり、Podがその2つの間を移動できる必要があります。
Vertical Pod Autoscalerのデフォルトのレコメンダーは、約8日分のサンプルから減衰ヒストグラムを構築します。45秒のバーストはそれにとってノイズなので定常値を推奨し、次のロールアウトでスロットリングが起きます。minAllowedで起動を乗り切れる下限を下回らないよう制約することもできますが、それは形を変えて、起動時の数値を恒久的な予約として再び固定するだけです。
In-placeのPodリサイズは問題の形そのものを変えます。Kubernetes 1.35でstableになり、1.36ではデフォルトで有効です。実行中のコンテナのrequestsとlimitsを再起動なしで変更できます。パターンはこうです。クリーンに起動できるだけのCPUとメモリでPodを開始し、readyを報告したら定常値までリサイズして縮小する。GKEのstartup CPU boostは、Autopilot向けにこれに相当する仕組みを提供しています。Pod specでは、CPUの変更が再起動を引き起こさないことを宣言するだけです。
containers:- name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequired - resourceName: memory restartPolicy: NotRequired # ランタイムがヒープをライブで縮小できない場合はRestartContainer resources: requests: cpu: "2" # 起動時の値。readiness通過後に約200mへリサイズ memory: 1Gi limits: memory: 1Gi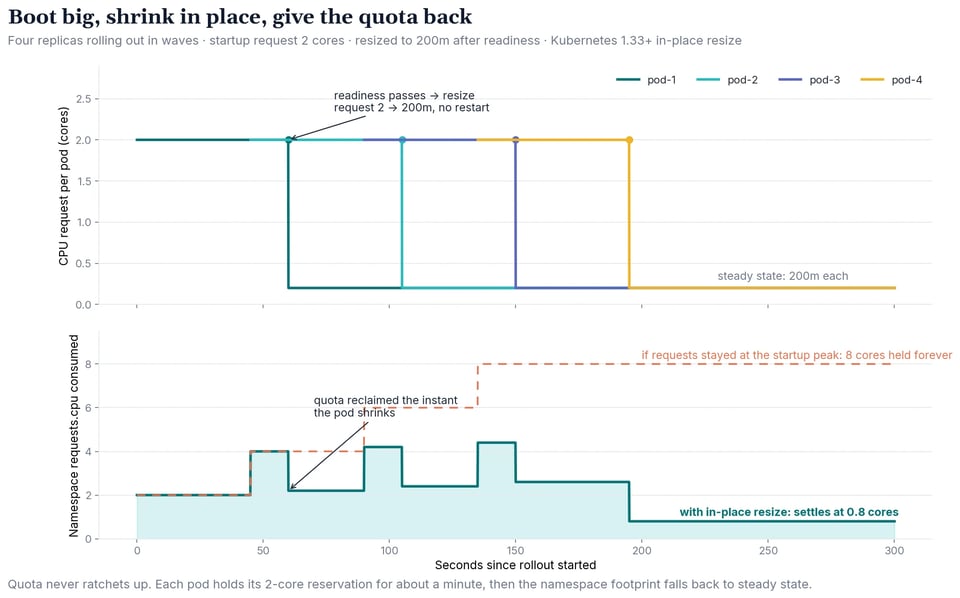
ここで修正1のクォータの取り組みが効いてきます。リサイズは他のrequest変更と同様にResourceQuotaに対して検証されるため、Podが2コアから200mに縮小すると、namespaceは即座に1.8コア分のクォータを取り戻します。40レプリカが波状に起動し、それぞれが起動時の予約を約1分だけ保持し、namespaceの定常時フットプリントは80コアではなく8コアに落ち着きます。誰も使っていないフェーズを反映した予約の後ろで、PodがPendingのまま待たされることはなくなります。
設計上考慮すべき制約が1つあります。リサイズでPodのQoSクラスは変更できません。Burstableで始まったPodはBurstableのままで、GuaranteedなPodはすべてのリサイズを通じてrequestsとlimitsを等しく保たなければなりません。これも、必要のないworkloadsにポリシーでGuaranteedを義務付けるべきでない理由の1つです。
ポリシー書き換えチェックリスト
- 層を棚卸しする。 namespaceごとに
kubectl get resourcequota,limitrange -o yamlを実行し、さらにresourcesに触れるすべてのKyverno/Gatekeeper/VAPルールを確認します。それぞれが何を強制しているかを書き出してください。 - 各層が前提とするフェーズを特定する。 クォータ内の
limits.cpu、LimitRange内のmax.cpuや低いmaxLimitRequestRatio.cpu、「CPU limitを必ず設定」というアドミッションルールはすべて定常時向けのポリシーです。数百ミリコアを超えるdefaultRequestや、requestsとlimitsの一致の義務付けはすべて起動時向けのポリシーです。 - ギャップを測定する。 namespaceごとにrequestsと使用量の比率クエリを実行します。3〜4を超えていれば、誤ったフェーズにクォータが消費されている証拠です。
- クォータをrequestsに移す。
ResourceQuotaからlimits.cpuを削除し、requests.*とlimits.memoryを残します。 - LimitRangeの制約を緩める。
default.cpuを削除し、max.cpuを引き上げるか削除し、maxLimitRequestRatioはメモリのみに適用します。 - アドミッションを書き直す。 CPUとメモリのrequestsとメモリlimitを必須にします。CPU limitの必須化をやめます。
- 再起動回数トップ10のworkloadsをリサイズする。 メモリlimitは起動ピークに、メモリとCPUのrequestsは定常時のp95に、CPU limitは設定しない。ロールアウトで競合が起きる場合は
maxSurgeとspread constraintsを追加します。 - クラスタが対応していれば2フェーズのサイジングを有効にする。 In-placeリサイズが利用可能な1.33以降では、
resizePolicyを宣言し、readiness後にコントローラがPodを縮小できるようにします。 - 1週間後にステップ3を再実行する。 比率は1.5〜2に向かって下がり、同時に起動直後コンテナのスロットリング率はゼロに向かって下がるはずです。片方しか動かなかったなら、修正できたのは一方のリソースだけです。
FAQ
Kubernetesのresource quotaとは何ですか?
ResourceQuotaはnamespaceスコープのオブジェクトで、そのnamespace内のすべてのPodがリクエストまたは制限できるリソースの合計と、Pod、Service、PVCといったオブジェクト数に上限を設けます。アドミッション時に強制され、requestsまたはlimitsがnamespaceをhardの値を超えて押し上げるPodは拒否されます。クォータは実際の使用量ではなくPod specの数値を数えるため、背後のノードがアイドルのままでもクォータが枯渇することがあります。
ResourceQuotaはlimitsとrequestsのどちらに上限をかけるべきですか?
requests.cpuとrequests.memoryに上限をかけてください。requestsはスケジューラが予約し、ノードキャパシティとして支払う対象だからです。limits.memoryにも上限をかけてください。namespaceがノードの全メモリを消費することに対する実質的な安全境界です。クォータでのlimits.cpuは避けてください。収まるようにCPU limitsを縮小する圧力がチームにかかり、ノードを守ることなく起動中のPodをスロットリングします。
ResourceQuotaとLimitRangeの違いは何ですか?
ResourceQuotaはnamespace全体の合計を設定します。LimitRangeはコンテナごと(またはPodごと、PVCごと)のデフォルト、最小値、最大値、limitとrequestの許容比率を設定します。クォータは「このチームが合計でどれだけ使えるか」に答え、LimitRangeは「指定しなかったコンテナが何を受け取るか、最大でどれだけ要求できるか」に答えます。どちらもアドミッション時に強制されます。
In-placeのPodリサイズはResourceQuotaにカウントされますか? はい。requestsを引き上げるリサイズはnamespaceのクォータに対して検証され、超過する場合は拒否されます。requestsを引き下げるリサイズは、差分を即座にクォータに返します。これにより、起動後に縮小するパターンで、namespaceの定常時のクォータフットプリントを実際の使用量に近く保てます。
ノードにアイドルCPUがあるのに、なぜ起動時にPodがスロットリングされるのですか?
CPU limitはカーネルのCFSクォータによってコンテナごとに、ノードの負荷とは無関係に強制されるからです。limitが500mなら、ノードがどれだけアイドルでも、コンテナは100msの各期間のうち50msしか得られません。JITコンパイルやモジュール読み込みのような起動時の処理は、各期間の早い段階でそのクォータを使い切り、待たされます。CPU limitを削除するか、limitがrequestを大きく上回れるようmaxLimitRequestRatioを引き上げれば、起動時にアイドルキャパシティを使えるようになります。
コンテナの実際の挙動に合ったポリシーへ
ここまでの内容はすべて手作業でも実施できます。クォータを書き直し、LimitRangeの制約を緩め、アドミッションポリシーを更新し、最もノイジーなworkloadsをリサイズし、コードが変わるたびに繰り返す。難しいのは、この最後の「繰り返す」の部分です。起動プロファイルは依存関係の更新やJVMフラグの変更のたびに変化し、3月に正しくチューニングしたポリシーは6月には再びずれています。
PerfectScale by DoiTはすべてのコンテナをworkloadレベルでプロファイルするため、起動時と定常時の挙動が1つの混ざった平均ではなく、別々のパターンとして現れます。その推奨は、requestsを定常値に保ちつつ、起動ピークを超えられるメモリサイズを提示します。Java workloadsについては、Corootエージェントを有効にするとJVMコンテナを自動的に検出し、ヒープ、非ヒープ、GCを経時的に追跡し、明示的なヒープ設定なしで動くコンテナにフラグを立て、変更を推奨・適用する際には-Xmsと-Xmxを尊重します。Kubernetes 1.33以降のクラスタでは、自動化がPodを再起動せずにライトサイジングをin-placeで適用し、現在のノードでリサイズが実行できない場合にのみローリング再起動にフォールバックします。これにより、namespaceのクォータは、前回のデプロイ後の45秒間に必要だった値ではなく、workloadsが今使っている値を反映するようになります。
2コアで起動し、再起動なしで200mに落ち着き、クォータを無駄に取り残さないPodを実際に見てみませんか?JVM起動スパイクワークショップに参加するか、技術セッションを予約してください。お客様のクラスタのクォータとLimitRangeポリシーを一緒に確認します。