
PerfectScale
Come correggere le policy di risorse Kubernetes ottimizzate per la fase sbagliata
ResourceQuota, LimitRange e policy di admission codificano un solo numero per container. Ma i container hanno due fasi. Ecco come riscrivere il livello di policy perché smetta di scegliere quella sbagliata.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Una resource policy in Kubernetes è l'insieme dei livelli che decidono quali requests e limits finisce per avere un container:
ResourceQuota,LimitRange, regole di admission (Kyverno, Gatekeeper,ValidatingAdmissionPolicy), i default dei chart Helm e qualunque recommender scriva quei numeri. - Ognuno di questi livelli presuppone un solo numero per container, valido per tutta la sua vita. I container hanno però due fasi, startup e steady state, e il divario tra le due può andare da 3x a 10x.
- Le policy tarate sullo steady state causano throttling e OOM-kill dei pod durante lo startup. Quelle tarate sullo startup riservano capacità che nessuno usa, saturano le quota dei namespace con requests inattive e lasciano i pod in
Pendingmentre il cluster resta mezzo vuoto. - La soluzione è strutturale: quota sulle requests, non sui limits;
LimitRangeche consente il burst invece di comprimerlo; regole di admission che richiedono requests e limiti di memoria ma smettono di imporre limiti di CPU; e un recommender che tratta startup e steady state come numeri separati. - Il resize in-place dei pod rende praticabile l'ultimo passaggio. Lo startup ottiene ciò che gli serve, poi il pod si riduce al suo plateau senza riavvio e la quota viene recuperata nello stesso istante.
Nel post precedente abbiamo visto come individuare uno spike di startup: filtrando le metriche di throttling e OOM per età del container, il burst che le medie nascondono emerge nei primi 60 secondi di vita di ogni container. Questo post spiega cosa fare una volta che lo spike è visibile, perché la parte difficile non è modificare un singolo Deployment: è che il livello di policy intorno a quel Deployment è stato scritto per una sola fase e continuerà a spingere ogni workload verso di essa.
Cos'è davvero una resource policy in Kubernetes
Chi cerca kubernetes resource quota di solito sta configurando uno di due oggetti in un namespace, ma la policy che determina le requests e i limits finali di un container ha più livelli di così. E ciascuno può essere tarato sulla fase sbagliata in modo indipendente.
| Livello | Cosa controlla | Il tuning sullo steady state rompe lo startup quando… | Il tuning sullo startup spreca capacità quando… |
|---|---|---|---|
ResourceQuota |
Tetto a livello di namespace sulla somma di requests.cpu, requests.memory, limits.cpu, limits.memory e sul numero di pod |
La quota su limits.* costringe i team a ridurre i limits per rientrarci, così lo startup sbatte contro la CFS quota o l'OOM killer |
La quota su requests.* viene consumata da requests dimensionate sul picco che restano inattive al 90% dopo il primo minuto |
LimitRange |
default, defaultRequest, min, max, maxLimitRequestRatio per container |
max o un maxLimitRequestRatio basso schiaccia il limit vicino alla request, eliminando il margine di burst di cui lo startup ha bisogno |
defaultRequest impostato alto perché i container senza valori sopravvivano al boot, il che gonfia ogni container che non ha specificato il proprio |
Policy di admission (Kyverno, Gatekeeper, ValidatingAdmissionPolicy) |
Quali campi devono essere presenti e che forma devono avere | "Ogni container deve impostare un limite di CPU" trasforma un throttling facoltativo in uno obbligatorio | "Le requests devono essere uguali ai limits" (QoS Guaranteed ovunque) cristallizza il picco di startup in una riserva permanente |
| Default di chart e template | Cosa riceve un container quando nessuno ci ha pensato | Default copiati da un servizio che si avvia rapidamente, applicati a uno che non lo fa | Default copiati da un servizio JVM, applicati a un sidecar in Go |
| Recommender (VPA, script, una piattaforma) | I numeri che finiscono nella spec | L'istogramma su più giorni raccomanda il plateau, e al rollout successivo scatta il throttling | Il recommender vede il picco, lo raccomanda e non lo rivede più una volta che il pod si è stabilizzato |
Lo scheduler legge le requests. Il kernel applica i limits. Il sistema di quota conta quello dei due che gli è stato indicato. Nessuno dei tre sa che il container ha appena terminato il class loading e non avrà più bisogno di quella CPU fino al prossimo deploy.
Come capire per quale fase è ottimizzata la policy
Non serve leggere ogni manifest. Tre segnali indicano in quale direzione pende la policy.
I pod subiscono throttling o OOM-kill nei primi due minuti e mai altrove. È una policy da steady state. Da qualche parte un LimitRange, una regola di admission o un recommender ha abbassato i limits fino al plateau. La conferma arriva dalla query sul throttling dei container giovani del post sulla detection e da kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} concentrato subito dopo i rollout.
I namespace esauriscono la quota mentre i nodi girano al 20-30% di CPU. È una policy da startup. Le requests sono dimensionate per sopravvivere al boot, quindi la quota è consumata da riserve che diventano inattive dopo 60 secondi. Si può verificare direttamente:
# CPU richiesta vs CPU effettiva, per namespacesum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})/sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))Un rapporto tra 1,5 e 2 è un margine normale. Un rapporto pari o superiore a 5 su un intero namespace significa che le requests descrivono una fase che i container hanno abbandonato da un pezzo. kubectl describe resourcequota -n <namespace> mostra la stessa situazione dall'altro lato: requests.cpu usata al 95% del valore hard mentre la somma di kubectl top pods è una frazione di quella cifra.
Entrambe le cose insieme. È più comune di quanto sembri. I limiti di CPU sono schiacciati sullo steady state (throttling al boot) mentre le requests di memoria sono dimensionate sul picco di startup (riserve inattive). La policy ha scelto la fase sbagliata per ciascuna risorsa, in direzioni opposte.
I conti delle quota che rendono tutto questo costoso
Prendiamo l'esempio del post sulla detection: un servizio con 40 repliche, un burst di startup da 2 core per circa 45 secondi e uno steady state da 200m.
Dimensionando le requests sul plateau, il Deployment consuma 8 core di quota requests.cpu. Dimensionandole sul picco, ne consuma 80. La quota di namespace che ospitava comodamente dieci servizi di questo tipo ora ne contiene uno solo, e gli altri nove restano in Pending con exceeded quota negli eventi, mentre i nodi su cui sarebbero finiti restano inattivi. In un cluster in cui le requests guidano il provisioning dei nodi tramite Karpenter o il Cluster Autoscaler, quei 72 core fantasma diventano anche nodi reali con una bolletta reale.
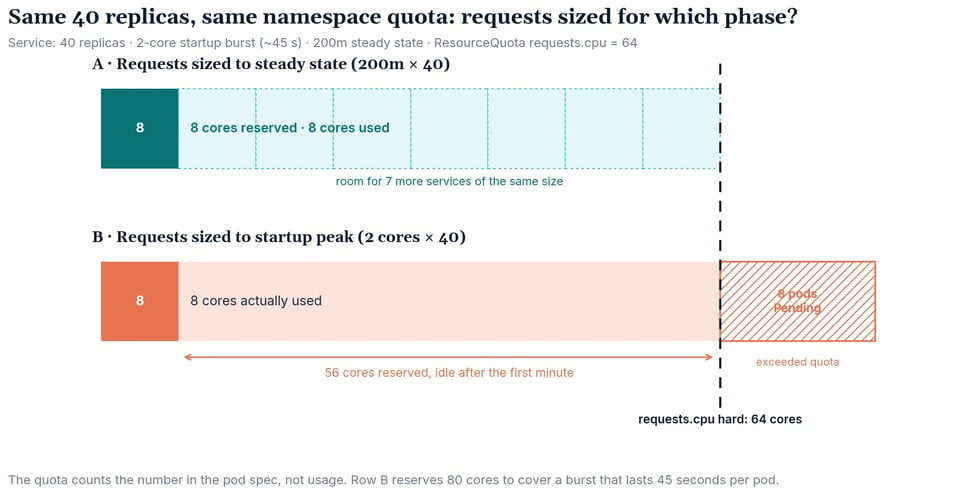
La quota fa esattamente ciò che le è stato detto. Il problema è che una quota conta un numero che è stato vero per 45 secondi e lo tratta come vero per tutta la vita del pod.
Fix 1: quota sulle requests, non sui limits
ResourceQuota può limitare requests.cpu, limits.cpu o entrambi. Spesso i team aggiungono limits.cpu a una quota con l'idea che vincoli l'utilizzo nel caso peggiore. In pratica, però, spinge i limits verso il basso, verso le requests, perché il namespace rientri nella quota, eliminando il margine di cui lo startup ha bisogno.
Le requests sono ciò che lo scheduler riserva e ciò che si paga in capacità dei nodi. Sono quelle da vincolare, lasciando fluttuare i limits.
apiVersion: v1kind: ResourceQuotametadata: name: team-payments namespace: paymentsspec: hard: requests.cpu: "64" requests.memory: 256Gi limits.memory: 512Gi # i limiti di memoria sono una vera barriera di sicurezza; vanno mantenuti # niente limits.cpu — i limiti di CPU fanno throttling, non proteggono il nodo pods: "400"Il campo limits.memory va mantenuto nella quota. La memoria non è comprimibile, un container che supera il proprio limite di memoria viene terminato anziché rallentato, e un tetto di memoria a livello di namespace è un legittimo controllo del raggio d'impatto. I limiti di CPU sono un'altra cosa, come spiega Anton nel post sui CPU limits: non proteggono nulla sul nodo e costano latenza esattamente nel momento in cui un pod sta cercando di avviarsi.
Una conseguenza da pianificare: una volta che una quota menziona requests.cpu, ogni pod del namespace deve specificare una CPU request, altrimenti viene rifiutato in admission. È qui che entrano in gioco i default del LimitRange, ed è il punto successivo in cui la fase sbagliata finisce incorporata.
Fix 2: un LimitRange che consente il burst invece di comprimerlo
LimitRange è il punto in cui la maggior parte delle policy da steady state fa danni, di solito attraverso due campi.
maxLimitRequestRatio limita quanto un limit può superare la propria request. Un rapporto di 1 o 2 significa che un container che richiede 200m può avere un limit massimo di 400m, e il burst di startup da 2 core gira a un quinto della velocità necessaria. Se si vogliono comunque mantenere i limiti di CPU, il rapporto deve coprire il reale divario tra startup e plateau, che per i servizi JVM e Node è spesso tra 5 e 10.
max sui limiti di CPU fa la stessa cosa in modo più brutale. Un max di 1 core per container è ragionevole per lo steady state e garantisce che ogni servizio con JIT pesante si avvii in throttling.
apiVersion: v1kind: LimitRangemetadata: name: two-phase-defaults namespace: paymentsspec: limits: - type: Container defaultRequest: cpu: 100m # default di scheduling per i container che non impostano nulla memory: 128Mi default: memory: 512Mi # default per il limite di memoria; nessun default per il limite di CPU max: memory: 8Gi min: cpu: 10m memory: 32Mi maxLimitRequestRatio: memory: "4" # il limite di memoria può superare la request fino a 4xDue scelte qui sono deliberate. Non c'è default.cpu, quindi un container che imposta una CPU request e nient'altro gira senza limite di CPU e al boot può fare burst nella capacità inattiva del nodo. E maxLimitRequestRatio è impostato solo per la memoria, perché è lì che il rapporto lavora in modo utile: consente al limit di superare l'allocazione di startup mentre la request resta al plateau, senza permettere a nessuno di impostare una request da 128Mi con un limit da 64Gi.
I valori di defaultRequest sono bassi di proposito. Un default del LimitRange viene applicato a ogni container che non specifica il proprio, e un default generoso gonfia silenziosamente le requests di ogni sidecar e job del namespace. Il default deve essere la soglia minima che fa passare il controllo di admission della quota, non una raccomandazione di dimensionamento.
Fix 3: regole di admission riscritte in base allo scopo di ogni risorsa
Il terzo livello è quello che i team dimenticano di avere. Una ClusterPolicy Kyverno o un constraint Gatekeeper scritti due anni fa che dicono "ogni container deve dichiarare requests e limits di CPU e memoria" continuano a imporre un modello a numero unico a ogni deploy.
Va riscritta in modo da richiedere ciò che conta e smettere di richiedere ciò che danneggia:
apiVersion: admissionregistration.k8s.io/v1kind: ValidatingAdmissionPolicymetadata: name: require-requests-and-memory-limitspec: failurePolicy: Fail matchConstraints: resourceRules: - apiGroups: ["apps"] apiVersions: ["v1"] operations: ["CREATE", "UPDATE"] resources: ["deployments", "statefulsets", "daemonsets"] validations: - expression: > object.spec.template.spec.containers.all(c, has(c.resources) && has(c.resources.requests) && has(c.resources.requests.cpu) && has(c.resources.requests.memory)) message: "Every container must set cpu and memory requests." - expression: > object.spec.template.spec.containers.all(c, has(c.resources.limits) && has(c.resources.limits.memory)) message: "Every container must set a memory limit."CPU requests: obbligatorie, perché scheduler e HPA dipendono da esse. Requests e limits di memoria: obbligatori, perché l'OOM killer non perdona e un limite di memoria è una vera barriera di sicurezza. Limiti di CPU: non menzionati. I team che hanno un motivo specifico per impostarne uno (un job batch rumoroso, un nodo multi-tenant) possono comunque farlo; la policy smette semplicemente di far pagare a tutti gli altri la tassa dello startup.
Se l'organizzazione impone la QoS Guaranteed (requests uguali ai limits) per determinati tier, bisogna essere espliciti sul costo. Guaranteed significa che il picco di startup diventa una riserva permanente su ogni replica. È il compromesso giusto per un database critico per la latenza. È quello sbagliato per 40 repliche stateless di un'API.
Fix 4: memoria dimensionata sullo startup, CPU sullo steady state
Una volta che il livello di policy smette di imporre una risposta unica, la decisione per singolo workload diventa più semplice, ed è diversa per ciascuna risorsa.
Il limite di memoria deve superare il picco di startup. Per la memoria non esiste degradazione graduale. Se l'inizializzazione alloca 900Mi e il limite è 768Mi, il container muore con exit code 137 prima ancora di raggiungere il suo plateau da 400Mi. Si prende max_over_time(container_memory_working_set_bytes[5m]) su una finestra che include un rollout e si imposta il limite sopra quel numero, con margine. Per i workloads JVM va ricordato che lo heap è solo una parte del quadro: metaspace, code cache e stack dei thread stanno tutti fuori da -Xmx.
La request di memoria sta al plateau. La request è ciò che lo scheduler riserva e ciò che la quota conta. Impostarla sul working set di steady state con un margine moderato mantiene il bin-packing aderente alla realtà. Il divario tra request e limit colloca il pod nella QoS Burstable, il che significa che sotto pressione di memoria del nodo è candidato all'eviction prima dei pod Guaranteed. Per la maggior parte dei servizi stateless è un compromesso accettabile; per quelli in cui non lo è, si imposta deliberatamente la request uguale al limit e si accetta la riserva.
La CPU request sta al plateau, il limite di CPU è assente. Senza CFS quota, lo startup prende in prestito cicli inattivi dal nodo e li restituisce un minuto dopo. La request conta comunque: è ciò che Karpenter e lo scheduler usano per collocare il pod, ed è il denominatore su cui l'HPA calcola l'utilizzo. Va dimensionata sul p95 dello steady state, non sul burst.
L'unico punto in cui questo schema si rompe è un rollout che porta molti pod con spike sullo stesso nodo appena creato, tutti insieme. Senza CPU inattiva da prendere in prestito, lo startup gira lento per contesa anziché per throttling. Conviene limitare maxSurge così che i nuovi pod arrivino a ondate anziché tutti in una volta, e valutare un topologySpreadConstraint su kubernetes.io/hostname perché i nuovi pod di un rollout non si accumulino su un solo nodo. Una startupProbe con un failureThreshold dimensionato sul caso lento impedisce al kubelet di riavviare un pod che sta semplicemente facendo il boot sotto carico.
Fix 5: un recommender che vede due fasi e un pod che può cambiare dimensioni
Tutto quanto sopra impedisce alla policy di imporre il numero sbagliato. Ma non produce quello giusto. Per questo il recommender deve sapere che startup e steady state sono diversi, e il pod deve potersi spostare tra i due.
Il Vertical Pod Autoscaler con il suo recommender predefinito costruisce un istogramma a decadimento su circa otto giorni di campioni. Un burst di 45 secondi per lui è rumore, quindi raccomanda il plateau, e al rollout successivo scatta il throttling. Lo si può vincolare con minAllowed perché non scenda mai sotto una soglia che sopravvive al boot, ma questo non fa che ricodificare il numero di startup come riserva permanente, passando da un'altra porta.
Il resize in-place dei pod cambia la forma del problema. È diventato stabile in Kubernetes 1.35 ed è attivo per impostazione predefinita nella 1.36, e consente di modificare requests e limits di un container in esecuzione senza riavvio. Il pattern è: avviare il pod con CPU e memoria sufficienti per un boot pulito, poi ridimensionarlo ai valori di steady state una volta che risulta ready. Lo startup CPU boost di GKE ne implementa una versione per Autopilot. La spec del pod deve solo dichiarare che una modifica della CPU non deve innescare un riavvio:
containers:- name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequired - resourceName: memory restartPolicy: NotRequired # oppure RestartContainer se il runtime non può ridurre lo heap a caldo resources: requests: cpu: "2" # valore di startup; ridimensionato a ~200m dopo la readiness memory: 1Gi limits: memory: 1Gi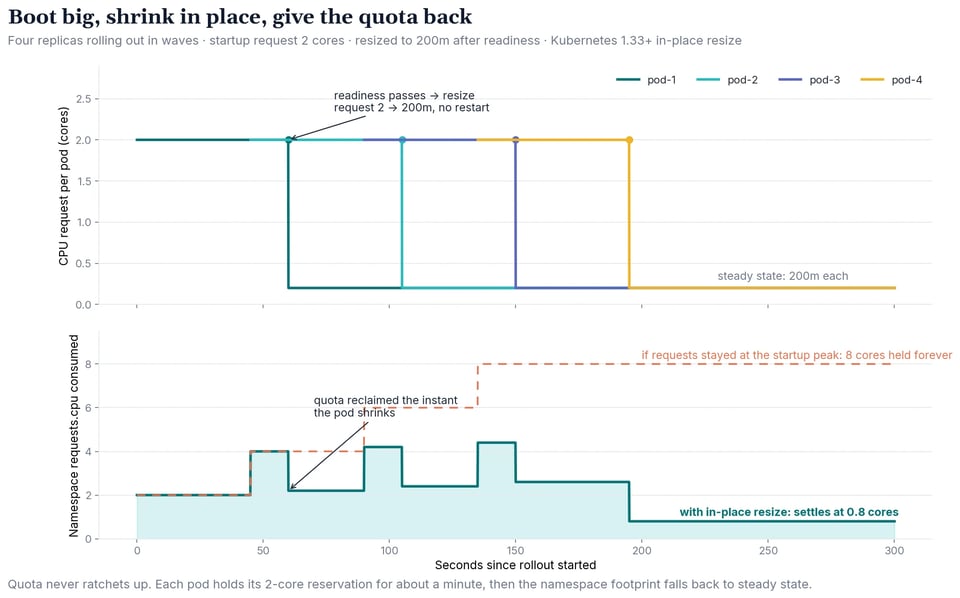
È qui che il lavoro sulla quota del Fix 1 ripaga. Un resize viene verificato rispetto alla ResourceQuota come qualsiasi altra modifica delle requests, quindi quando il pod si riduce da 2 core a 200m il namespace recupera immediatamente 1,8 core di quota. Quaranta repliche si avviano a ondate, ciascuna mantiene la propria riserva di startup per circa un minuto, e il footprint di steady state del namespace si assesta a 8 core invece di 80. I pod smettono di restare in Pending dietro riserve che descrivono una fase in cui nessuno si trova più.
Un vincolo di cui tenere conto in fase di progettazione: un resize non può cambiare la classe QoS di un pod. Un pod partito Burstable resta Burstable, e un pod Guaranteed deve mantenere requests uguali ai limits a ogni resize. Un motivo in più per non imporre Guaranteed via policy ai workloads che non ne hanno bisogno.
Checklist per riscrivere le policy
- Inventariare i livelli. Per ogni namespace:
kubectl get resourcequota,limitrange -o yaml, più ogni regola Kyverno/Gatekeeper/VAP che toccaresources. Annotare cosa impone ciascuna. - Individuare la fase presupposta da ogni livello. Qualsiasi
limits.cpuin una quota, qualsiasimax.cpuomaxLimitRequestRatio.cpubasso in un LimitRange, qualsiasi regola di admission "deve impostare un limite di CPU" è una policy da steady state. QualsiasidefaultRequestsopra qualche centinaio di millicore, o qualsiasi obbligo di requests uguali ai limits, è una policy da startup. - Misurare il divario. Eseguire la query del rapporto requests/utilizzo per namespace. Qualsiasi valore sopra 3-4 è quota consumata dalla fase sbagliata.
- Spostare la quota sulle requests. Eliminare
limits.cpudallaResourceQuota; mantenererequests.*elimits.memory. - Aprire il LimitRange. Rimuovere
default.cpu, alzare o rimuoveremax.cpu, applicaremaxLimitRequestRatiosolo alla memoria. - Riscrivere l'admission. Richiedere requests di CPU e memoria e un limite di memoria. Smettere di richiedere un limite di CPU.
- Ridimensionare i dieci workloads che si riavviano di più. Limite di memoria al picco di startup, requests di memoria e CPU al p95 dello steady state, nessun limite di CPU. Aggiungere
maxSurgee vincoli di spread se i rollout creano contesa. - Abilitare il dimensionamento a due fasi dove il cluster lo supporta. Su 1.33+ con resize in-place disponibile, dichiarare
resizePolicye lasciare che un controller riduca i pod dopo la readiness. - Rieseguire il punto 3 una settimana dopo. Il rapporto dovrebbe scendere verso 1,5-2 e, allo stesso tempo, il tasso di throttling dei container giovani dovrebbe scendere verso zero. Se si è mosso solo uno dei due, è stata sistemata una risorsa e non l'altra.
FAQ
Che cos'è una resource quota in Kubernetes?
Una ResourceQuota è un oggetto a livello di namespace che limita il totale delle risorse che tutti i pod di quel namespace possono richiedere o avere come limite, oltre al numero di oggetti come pod, service e PVC. Viene applicata in admission: un pod le cui requests o i cui limits porterebbero il namespace oltre i valori hard viene rifiutato. Le quota contano i numeri nella spec del pod, non l'utilizzo effettivo, ed è per questo che una quota può esaurirsi mentre i nodi dietro di essa restano inattivi.
Una ResourceQuota deve vincolare i limits o le requests?
Vanno limitate requests.cpu e requests.memory, perché le requests sono ciò che lo scheduler riserva e ciò che si paga in capacità dei nodi. Va limitato anche limits.memory, perché è una vera barriera di sicurezza contro un namespace che consuma tutta la memoria dei nodi. Meglio evitare limits.cpu nelle quota: spinge i team a ridurre i limiti di CPU per rientrare, il che causa throttling dei pod durante lo startup senza proteggere il nodo.
Qual è la differenza tra ResourceQuota e LimitRange?
ResourceQuota imposta un totale a livello di namespace. LimitRange imposta default, minimi, massimi e il rapporto consentito tra limit e request per singolo container (o pod, o PVC). La quota risponde alla domanda "quanto può usare questo team in totale"; il LimitRange risponde a "cosa riceve un container se non dichiara nulla, e qual è il massimo che può chiedere". Entrambi vengono applicati in admission.
I resize in-place dei pod vengono conteggiati nella ResourceQuota? Sì. Un resize che aumenta le requests viene validato rispetto alla quota del namespace e rifiutato se la supererebbe. Un resize che riduce le requests restituisce immediatamente la differenza alla quota. È questo che permette al pattern "startup e poi riduzione" di mantenere il footprint di quota di steady state di un namespace vicino al suo utilizzo reale.
Perché i miei pod subiscono throttling allo startup anche se il nodo ha CPU inattiva?
Perché un limite di CPU viene applicato dalla CFS quota del kernel per singolo container, indipendentemente dal carico del nodo. Se il limite è 500m, il container ottiene 50ms di ogni periodo da 100ms a prescindere da quanto il nodo sia scarico. Il lavoro di startup, come la compilazione JIT o il caricamento dei moduli, esaurisce quella quota all'inizio di ogni periodo e poi aspetta. Rimuovere il limite di CPU, o alzare maxLimitRequestRatio perché il limit possa stare ben sopra la request, consente allo startup di usare la capacità inattiva.
Policy che rispecchiano il comportamento reale dei container
Tutto quanto sopra si può fare a mano: riscrivere la quota, aprire il LimitRange, aggiornare la policy di admission, ridimensionare i workloads più rumorosi, e ripetere quando il codice cambia. La parte difficile è proprio quest'ultimo passaggio. I profili di startup cambiano a ogni aggiornamento di dipendenza e a ogni modifica dei flag JVM, e una policy tarata correttamente a marzo è di nuovo sbagliata a giugno.
PerfectScale by DoiT profila ogni container a livello di workload, così il comportamento di startup e quello di steady state emergono come pattern separati anziché come un'unica media aggregata, e le sue raccomandazioni dimensionano la memoria perché superi il picco di boot mantenendo le requests al plateau. Per i workloads Java rileva automaticamente i container JVM una volta abilitato l'agent Coroot, traccia heap, non-heap e GC nel tempo, segnala i container in esecuzione senza impostazioni esplicite dello heap e rispetta -Xms e -Xmx quando raccomanda o applica una modifica. Sui cluster con Kubernetes 1.33 o successivo, la sua automazione applica il right-sizing in place senza riavviare il pod, e ricorre a un rolling restart solo quando un resize non è fattibile sul nodo corrente, così la quota del namespace riflette ciò che i workloads stanno usando adesso e non ciò di cui hanno avuto bisogno per 45 secondi dopo l'ultimo deploy.
Vuole vedere un pod avviarsi a 2 core e assestarsi a 200m senza riavvii e senza quota rimasta bloccata? Partecipi al workshop sullo spike di startup della JVM, oppure prenoti una sessione tecnica e analizzeremo insieme le policy di quota e LimitRange dei suoi cluster.