
PerfectScale
So beheben Sie Kubernetes-Resource-Policies, die für die falsche Phase optimieren
Ihre ResourceQuota, LimitRange und Admission-Policies hinterlegen eine einzige Zahl pro Container. Container haben zwei Phasen. So schreiben Sie die Policy-Ebene um, damit sie nicht länger die falsche wählt.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Eine Kubernetes-Resource-Policy umfasst jede Ebene, die festlegt, mit welchen Requests und Limits ein Container am Ende läuft:
ResourceQuota,LimitRange, Admission-Regeln (Kyverno, Gatekeeper,ValidatingAdmissionPolicy), Helm-Chart-Defaults und der Recommender, der die Werte einträgt. - Jede dieser Ebenen geht von einer einzigen Zahl pro Container aus – für dessen gesamte Lebensdauer. Container haben zwei Phasen, Startphase und Steady State, und der Abstand zwischen beiden kann das 3- bis 10-Fache betragen.
- Policies, die auf den Steady State abgestimmt sind, drosseln Pods in der Startphase und lassen sie per OOM-Kill sterben. Policies, die auf die Startphase abgestimmt sind, reservieren Kapazität, die niemand nutzt, füllen Namespace-Quotas mit brachliegenden Requests und lassen Pods im Status
Pendinghängen, während der Cluster halb leer ist. - Die Lösung ist strukturell: Quota auf Requests statt auf Limits; eine
LimitRange, die Bursts zulässt, statt sie abzuwürgen; Admission-Regeln, die Requests und Memory-Limits verlangen, aber keine CPU-Limits mehr vorschreiben; und ein Recommender, der Startphase und Steady State als getrennte Zahlen betrachtet. - In-Place Pod Resize macht den letzten Schritt praktikabel. Die Startphase bekommt, was sie braucht, dann schrumpft der Pod ohne Neustart auf sein Plateau – und die Quota wird im selben Moment freigegeben.
Im letzten Beitrag ging es darum, wie man einen Startup-Spike sichtbar macht: Throttling- und OOM-Metriken nach Container-Alter filtern, und der Burst, den Durchschnittswerte verstecken, zeigt sich in den ersten 60 Sekunden im Leben jedes Containers. In diesem Beitrag geht es darum, was zu tun ist, sobald man ihn sieht – denn der schwierige Teil ist nicht, ein einzelnes Deployment anzupassen. Es ist die Policy-Ebene rund um dieses Deployment, die für eine Phase geschrieben wurde und jeden Workload immer wieder dorthin zurückdrängt.
Was eine Kubernetes-Resource-Policy wirklich ist
Wer nach kubernetes resource quota sucht, konfiguriert meist eines von zwei Objekten in einem Namespace – doch die Policy, die die endgültigen Requests und Limits eines Containers bestimmt, hat mehr Ebenen. Jede davon kann unabhängig auf die falsche Phase abgestimmt sein.
| Ebene | Was sie steuert | Steady-State-Tuning sabotiert die Startphase, wenn… | Startup-Tuning verschwendet Kapazität, wenn… |
|---|---|---|---|
ResourceQuota |
Namespace-weite Obergrenze für die Summen aus requests.cpu, requests.memory, limits.cpu, limits.memory und Pod-Anzahl |
Quota auf limits.* zwingt Teams, Limits zu verkleinern, damit alles passt – die Startphase läuft gegen die CFS-Quota oder den OOM-Killer |
Quota auf requests.* wird von auf den Peak dimensionierten Requests aufgezehrt, die nach der ersten Minute zu 90 % brachliegen |
LimitRange |
Pro Container default, defaultRequest, min, max, maxLimitRequestRatio |
max oder ein niedriges maxLimitRequestRatio klemmt das Limit nahe am Request fest und nimmt der Startphase den nötigen Burst-Spielraum |
defaultRequest ist hoch angesetzt, damit Container ohne eigene Angaben den Start überleben – was jeden Container aufbläht, der keine eigenen Werte gesetzt hat |
Admission-Policy (Kyverno, Gatekeeper, ValidatingAdmissionPolicy) |
Welche Felder vorhanden sein müssen und welche Form sie haben | "Jeder Container muss ein CPU-Limit setzen" macht aus einer optionalen Drossel eine Pflicht | "Requests müssen gleich Limits sein" (Guaranteed QoS überall) zementiert den Startup-Peak als dauerhafte Reservierung |
| Chart- und Template-Defaults | Was ein Container bekommt, wenn niemand darüber nachgedacht hat | Defaults von einem schnell startenden Service kopiert und auf einen angewendet, der es nicht tut | Defaults von einem JVM-Service kopiert und auf einen Go-Sidecar angewendet |
| Recommender (VPA, Skripte, eine Plattform) | Die Zahlen, die am Ende in der Spec landen | Ein Histogramm über Tage empfiehlt das Plateau, der nächste Rollout drosselt | Der Recommender sieht den Peak, empfiehlt ihn und schaut nie wieder hin, sobald der Pod ruhig läuft |
Der Scheduler liest Requests. Der Kernel setzt Limits durch. Das Quota-System zählt, was immer Sie ihm vorgegeben haben. Keines davon weiß, dass der Container gerade das Class Loading abgeschlossen hat und diese CPU bis zum nächsten Deploy nicht mehr braucht.
Woran Sie erkennen, für welche Phase Ihre Policy optimiert
Sie müssen nicht jedes Manifest lesen. Drei Signale zeigen, in welche Richtung die Policy kippt.
Pods werden in den ersten zwei Minuten gedrosselt oder per OOM-Kill beendet – und sonst nie. Das ist eine Steady-State-Policy. Irgendwo hat eine LimitRange, eine Admission-Regel oder ein Recommender die Limits auf das Plateau heruntergezogen. Bestätigen Sie es mit der Throttling-Query für junge Container aus dem Detection-Beitrag und mit kube_pod_container_status_last_terminated_reason{reason="OOMKilled"}, gehäuft direkt nach Rollouts.
Namespaces laufen in die Quota, während die Nodes bei 20 bis 30 % CPU liegen. Das ist eine Startup-Policy. Die Requests sind so bemessen, dass sie den Start überleben – also wird die Quota von Reservierungen aufgezehrt, die nach 60 Sekunden brachliegen. Prüfen Sie es direkt:
# Angeforderte CPU vs. tatsächliche CPU, pro Namespacesum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})/sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))Ein Verhältnis von 1,5 bis 2 ist normaler Spielraum. Ein Verhältnis von 5 oder mehr über einen Namespace hinweg bedeutet, dass die Requests eine Phase beschreiben, die die Container längst hinter sich haben. kubectl describe resourcequota -n <namespace> zeigt dasselbe Bild von der anderen Seite: requests.cpu zu 95 % des Hard-Werts belegt, während kubectl top pods in Summe nur einen Bruchteil davon ergibt.
Beides gleichzeitig. Das kommt häufiger vor, als es klingt. CPU-Limits sind auf den Steady State festgeklemmt (Throttling beim Start), während Memory-Requests auf den Startup-Peak bemessen sind (brachliegende Reservierungen). Die Policy hat für jede Ressource die falsche Phase gewählt – in entgegengesetzte Richtungen.
Die Quota-Rechnung, die das teuer macht
Nehmen wir das Beispiel aus dem Detection-Beitrag: ein Service mit 40 Replikas, einem Startup-Burst von 2 Cores über rund 45 Sekunden und einem Steady State von 200m.
Bemessen Sie die Requests nach dem Plateau, verbraucht das Deployment 8 Cores an requests.cpu-Quota. Bemessen Sie sie nach dem Peak, sind es 80. Die Namespace-Quota, in die bequem zehn solcher Services passten, fasst jetzt noch einen – und die anderen neun hängen mit exceeded quota in den Events im Status Pending, während die Nodes, auf denen sie gelandet wären, leer laufen. Auf einem Cluster, in dem Requests über Karpenter oder den Cluster Autoscaler die Node-Bereitstellung steuern, werden aus diesen 72 Phantom-Cores außerdem echte Nodes mit einer echten Rechnung.
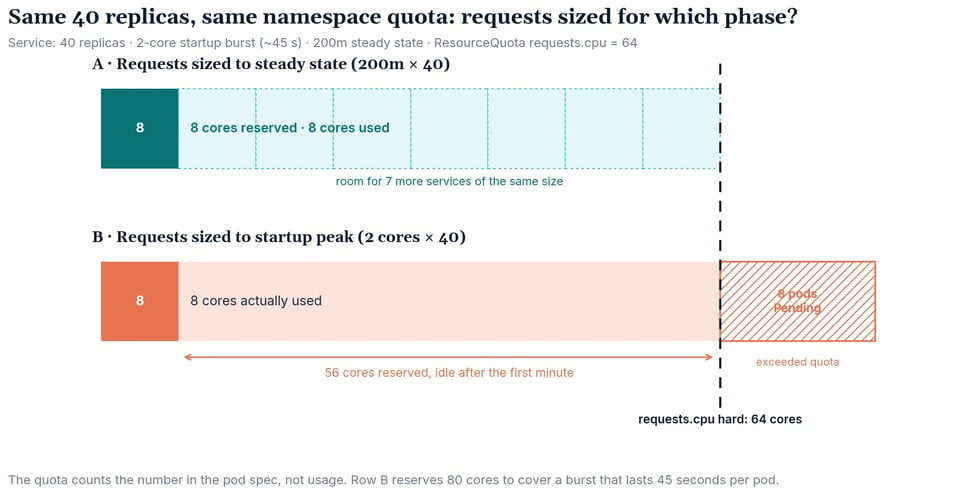
Die Quota tut genau, was man ihr aufgetragen hat. Das Problem: Sie zählt eine Zahl, die 45 Sekunden lang stimmte, und behandelt sie, als gälte sie für die gesamte Lebensdauer des Pods.
Fix 1: Quota auf Requests statt auf Limits
ResourceQuota kann requests.cpu, limits.cpu oder beides deckeln. Teams nehmen oft limits.cpu in eine Quota auf – in der Annahme, das begrenze den Worst Case. In der Praxis drückt es die Limits Richtung Requests, damit der Namespace passt, und nimmt der Startphase genau den Spielraum, den sie braucht.
Requests sind das, was der Scheduler reserviert und was Sie an Node-Kapazität bezahlen. Deckeln Sie diese. Lassen Sie die Limits frei.
apiVersion: v1kind: ResourceQuotametadata: name: team-payments namespace: paymentsspec: hard: requests.cpu: "64" requests.memory: 256Gi limits.memory: 512Gi # Memory-Limits sind eine echte Sicherheitsgrenze; behalten # kein limits.cpu – CPU-Limits drosseln, sie schützen den Node nicht pods: "400"Behalten Sie limits.memory in der Quota. Memory ist nicht komprimierbar, ein Container, der sein Memory-Limit überschreitet, wird beendet statt gebremst, und eine Memory-Obergrenze auf Namespace-Ebene ist eine legitime Begrenzung des Schadensradius. CPU-Limits sind anders, wie Anton im Beitrag zu CPU-Limits gezeigt hat: Sie schützen auf dem Node nichts und kosten Latenz – genau in dem Moment, in dem ein Pod hochkommen will.
Eine Konsequenz, die Sie einplanen sollten: Sobald eine Quota requests.cpu nennt, muss jeder Pod im Namespace einen CPU-Request angeben, sonst wird er bei der Admission abgelehnt. Hier kommen die LimitRange-Defaults ins Spiel – und das ist die nächste Stelle, an der sich die falsche Phase einnistet.
Fix 2: Die LimitRange soll Bursts erlauben, statt sie abzuwürgen
In der LimitRange richten die meisten Steady-State-Policies den größten Schaden an, meist über zwei Felder.
maxLimitRequestRatio begrenzt, wie weit ein Limit über seinem Request liegen darf. Ein Verhältnis von 1 oder 2 bedeutet: Ein Container mit 200m Request darf höchstens ein Limit von 400m haben – und der 2-Core-Startup-Burst läuft mit einem Fünftel der nötigen Geschwindigkeit. Wenn Sie CPU-Limits überhaupt behalten wollen, muss das Verhältnis die reale Lücke zwischen Startphase und Plateau abdecken, bei JVM- und Node-Services oft 5 bis 10.
max auf CPU-Limits bewirkt dasselbe, nur unverblümter. Ein max von 1 Core pro Container ist für den Steady State vernünftig – und garantiert, dass jeder JIT-lastige Service gedrosselt startet.
apiVersion: v1kind: LimitRangemetadata: name: two-phase-defaults namespace: paymentsspec: limits: - type: Container defaultRequest: cpu: 100m # Scheduling-Default für Container ohne eigene Angaben memory: 128Mi default: memory: 512Mi # Memory-Limit-Default; kein CPU-Limit-Default max: memory: 8Gi min: cpu: 10m memory: 32Mi maxLimitRequestRatio: memory: "4" # Memory-Limit darf bis zum 4-Fachen über dem Request liegenZwei Dinge sind hier Absicht. Es gibt kein default.cpu – ein Container, der einen CPU-Request und sonst nichts setzt, läuft also ohne CPU-Limit und kann beim Start in freie Node-Kapazität bursten. Und maxLimitRequestRatio ist nur für Memory gesetzt, denn dort leistet das Verhältnis echte Arbeit: Es lässt das Limit über die Startup-Allokation hinausreichen, während der Request auf dem Plateau bleibt – ohne dass jemand einen 128Mi-Request mit einem 64Gi-Limit kombinieren kann.
Die defaultRequest-Werte sind bewusst niedrig. Ein LimitRange-Default wird auf jeden Container angewendet, der keinen eigenen Wert angibt, und ein großzügiger Default bläht still und leise die Requests jedes Sidecars und jedes Jobs im Namespace auf. Der Default sollte die Untergrenze sein, mit der die Quota-Admission-Prüfung besteht – keine Sizing-Empfehlung.
Fix 3: Admission-Regeln daran ausrichten, wofür jede Ressource da ist
Die dritte Ebene ist die, deren Existenz Teams gerne vergessen. Eine vor zwei Jahren geschriebene Kyverno-ClusterPolicy oder ein Gatekeeper-Constraint mit der Vorgabe "jeder Container muss CPU- und Memory-Requests und -Limits deklarieren" erzwingt bei jedem Deploy weiterhin das Modell mit nur einer Zahl.
Schreiben Sie sie so um, dass sie verlangt, was zählt – und nicht mehr verlangt, was schadet:
apiVersion: admissionregistration.k8s.io/v1kind: ValidatingAdmissionPolicymetadata: name: require-requests-and-memory-limitspec: failurePolicy: Fail matchConstraints: resourceRules: - apiGroups: ["apps"] apiVersions: ["v1"] operations: ["CREATE", "UPDATE"] resources: ["deployments", "statefulsets", "daemonsets"] validations: - expression: > object.spec.template.spec.containers.all(c, has(c.resources) && has(c.resources.requests) && has(c.resources.requests.cpu) && has(c.resources.requests.memory)) message: "Every container must set cpu and memory requests." - expression: > object.spec.template.spec.containers.all(c, has(c.resources.limits) && has(c.resources.limits.memory)) message: "Every container must set a memory limit."CPU-Requests: Pflicht, weil Scheduler und HPA davon abhängen. Memory-Requests und -Limits: Pflicht, weil der OOM-Killer unnachgiebig ist und ein Memory-Limit eine echte Sicherheitsgrenze darstellt. CPU-Limits: nicht erwähnt. Teams mit einem konkreten Grund dafür (ein ressourcenhungriger Batch-Job, ein Multi-Tenant-Node) können weiterhin eines setzen; die Policy verlangt nur nicht mehr von allen anderen, den Preis dafür beim Start zu zahlen.
Wenn Ihre Organisation für bestimmte Tiers Guaranteed QoS (Requests gleich Limits) vorschreibt, benennen Sie die Kosten klar. Guaranteed bedeutet: Der Startup-Peak wird auf jeder Replika zur dauerhaften Reservierung. Für eine latenzkritische Datenbank ist das der richtige Kompromiss. Für 40 zustandslose API-Replikas ist er der falsche.
Fix 4: Memory für die Startphase bemessen, CPU für den Steady State
Sobald die Policy-Ebene keine Einheitsantwort mehr erzwingt, wird die Entscheidung pro Workload einfacher – und sie fällt für jede Ressource anders aus.
Das Memory-Limit muss über dem Startup-Peak liegen. Bei Memory gibt es keine sanfte Degradierung. Allokiert die Initialisierung 900Mi und das Limit liegt bei 768Mi, stirbt der Container mit Exit-Code 137, bevor er je sein 400Mi-Plateau erreicht. Nehmen Sie max_over_time(container_memory_working_set_bytes[5m]) über ein Zeitfenster, das einen Rollout enthält, und setzen Sie das Limit mit Puffer über diesen Wert. Denken Sie bei JVM-Workloads daran, dass der Heap nur ein Teil des Bildes ist: Metaspace, Code Cache und Thread-Stacks liegen allesamt außerhalb von -Xmx.
Der Memory-Request liegt auf dem Plateau. Der Request ist, was der Scheduler reserviert und was die Quota zählt. Ihn auf das Steady-State-Working-Set mit moderatem Puffer zu setzen, hält das Bin-Packing realistisch. Die Lücke zwischen Request und Limit bringt den Pod in die Burstable-QoS-Klasse – bei Memory-Druck auf dem Node ist er damit vor Guaranteed-Pods ein Kandidat für die Eviction. Für die meisten zustandslosen Services ist das ein akzeptabler Kompromiss; wo nicht, setzen Sie den Request bewusst gleich dem Limit und akzeptieren die Reservierung.
Der CPU-Request liegt auf dem Plateau, ein CPU-Limit fehlt. Ohne CFS-Quota leiht sich die Startphase freie Zyklen vom Node und gibt sie eine Minute später zurück. Der Request bleibt wichtig: Karpenter und der Scheduler platzieren den Pod danach, und der HPA teilt die Auslastung dadurch. Bemessen Sie ihn nach dem Steady-State-p95, nicht nach dem Burst.
Der einzige Fall, in dem das nicht aufgeht: ein Rollout, bei dem viele Spike-lastige Pods gleichzeitig auf demselben frischen Node landen. Ohne freie CPU zum Ausleihen läuft die Startphase durch Contention langsam statt gedrosselt. Begrenzen Sie maxSurge, damit neue Pods in Wellen statt auf einen Schlag eintreffen, und erwägen Sie eine topologySpreadConstraint auf kubernetes.io/hostname, damit sich die neuen Pods eines Rollouts nicht auf einem Node stapeln. Eine startupProbe mit einem failureThreshold, der auf den langsamen Fall bemessen ist, hält das Kubelet davon ab, einen Pod neu zu starten, der lediglich unter Last bootet.
Fix 5: Dem Recommender zwei Phasen zeigen – und den Pod die Größe wechseln lassen
Alles oben Genannte verhindert, dass die Policy die falsche Zahl erzwingt. Die richtige Zahl liefert das noch nicht. Dafür muss der Recommender wissen, dass Startphase und Steady State verschieden sind – und der Pod muss sich zwischen beiden bewegen können.
Der Vertical Pod Autoscaler baut mit seinem Standard-Recommender ein abklingendes Histogramm über rund acht Tage an Samples. Ein 45-Sekunden-Burst ist dafür Rauschen, also empfiehlt er das Plateau – und der nächste Rollout drosselt. Sie können ihn mit minAllowed einschränken, damit er nie unter eine Untergrenze fällt, die den Start übersteht – doch damit schreiben Sie den Startup-Wert nur auf anderem Weg wieder als dauerhafte Reservierung fest.
In-Place Pod Resize verändert die Ausgangslage. Das Feature ist seit Kubernetes 1.35 stabil, in 1.36 standardmäßig aktiv und erlaubt, Requests und Limits eines laufenden Containers ohne Neustart zu ändern. Das Muster: Der Pod startet mit genug CPU und Memory, um sauber zu booten, und wird nach dem Readiness-Signal auf Steady-State-Werte verkleinert. Der Startup CPU Boost von GKE macht für Autopilot etwas Ähnliches. Die Pod-Spec muss nur deklarieren, dass eine CPU-Änderung keinen Neustart auslösen soll:
containers:- name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequired - resourceName: memory restartPolicy: NotRequired # oder RestartContainer, wenn die Runtime den Heap nicht live verkleinern kann resources: requests: cpu: "2" # Startwert; nach Readiness auf ~200m verkleinert memory: 1Gi limits: memory: 1Gi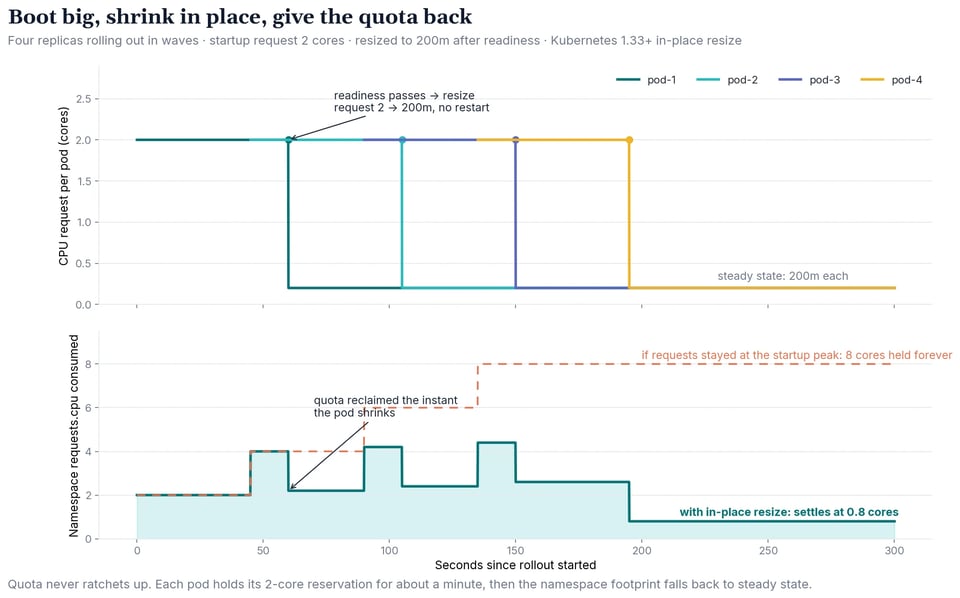
Hier zahlt sich die Quota-Arbeit aus Fix 1 aus. Ein Resize wird wie jede andere Request-Änderung gegen die ResourceQuota geprüft – schrumpft der Pod also von 2 Cores auf 200m, bekommt der Namespace sofort 1,8 Cores Quota zurück. Vierzig Replikas booten in Wellen, jede hält ihre Startup-Reservierung etwa eine Minute, und der Steady-State-Footprint des Namespace pendelt sich bei 8 statt 80 Cores ein. Pods hängen nicht mehr im Status Pending hinter Reservierungen, die eine Phase beschreiben, in der längst niemand mehr steckt.
Eine Einschränkung, die Sie einplanen müssen: Ein Resize kann die QoS-Klasse eines Pods nicht ändern. Ein Pod, der als Burstable gestartet ist, bleibt Burstable, und ein Guaranteed-Pod muss durch jedes Resize hindurch Requests gleich Limits halten. Ein Grund mehr, Guaranteed nicht per Policy für Workloads vorzuschreiben, die es nicht brauchen.
Eine Checkliste für die Policy-Überarbeitung
- Ebenen inventarisieren. Pro Namespace:
kubectl get resourcequota,limitrange -o yaml, plus jede Kyverno-/Gatekeeper-/VAP-Regel, dieresourcesberührt. Notieren Sie, was jede davon erzwingt. - Die angenommene Phase jeder Ebene finden. Jedes
limits.cpuin einer Quota, jedesmax.cpuoder niedrigemaxLimitRequestRatio.cpuin einer LimitRange, jede Admission-Regel mit "CPU-Limit ist Pflicht" ist eine Steady-State-Policy. JederdefaultRequestüber ein paar hundert Millicores oder jede Vorgabe "Requests gleich Limits" ist eine Startup-Policy. - Die Lücke messen. Führen Sie die Requests-zu-Nutzung-Query pro Namespace aus. Alles über 3 bis 4 ist Quota, die von der falschen Phase belegt wird.
- Quota auf Requests umstellen.
limits.cpuaus derResourceQuotaentfernen;requests.*undlimits.memorybehalten. - Die LimitRange öffnen.
default.cpuentfernen,max.cpuanheben oder entfernen,maxLimitRequestRationur auf Memory anwenden. - Admission neu schreiben. CPU- und Memory-Requests sowie ein Memory-Limit verlangen. Kein CPU-Limit mehr vorschreiben.
- Die zehn größten Restarter neu dimensionieren. Memory-Limit auf den Startup-Peak, Memory- und CPU-Requests auf den Steady-State-p95, kein CPU-Limit.
maxSurgeund Spread-Constraints ergänzen, falls Rollouts um Ressourcen konkurrieren. - Zwei-Phasen-Sizing aktivieren, wo der Cluster es unterstützt. Ab 1.33 mit verfügbarem In-Place Resize:
resizePolicydeklarieren und einen Controller die Pods nach Readiness verkleinern lassen. - Schritt 3 eine Woche später wiederholen. Das Verhältnis sollte Richtung 1,5 bis 2 fallen und die Throttling-Rate junger Container gleichzeitig gegen null gehen. Bewegt sich nur eines von beiden, haben Sie eine Ressource korrigiert – und die andere nicht.
FAQ
Was ist eine Kubernetes Resource Quota?
Eine ResourceQuota ist ein Namespace-gebundenes Objekt, das die Gesamtressourcen deckelt, die alle Pods in diesem Namespace anfordern oder als Limit haben dürfen, dazu Objektzahlen wie Pods, Services und PVCs. Sie wird bei der Admission durchgesetzt: Ein Pod, dessen Requests oder Limits den Namespace über seine hard-Werte heben würden, wird abgelehnt. Quotas zählen die Zahlen in der Pod-Spec, nicht die tatsächliche Nutzung – darum kann eine Quota erschöpft sein, während die Nodes dahinter leer laufen.
Sollte eine ResourceQuota Limits oder Requests deckeln?
Deckeln Sie requests.cpu und requests.memory, denn Requests sind das, was der Scheduler reserviert und was Sie an Node-Kapazität bezahlen. Deckeln Sie auch limits.memory, denn das ist eine echte Sicherheitsgrenze dagegen, dass ein Namespace den gesamten Node-Speicher verbraucht. Vermeiden Sie limits.cpu in Quotas: Es drängt Teams dazu, CPU-Limits zu verkleinern, damit alles passt – das drosselt Pods in der Startphase, ohne den Node zu schützen.
Was ist der Unterschied zwischen ResourceQuota und LimitRange?
ResourceQuota setzt eine Namespace-weite Gesamtsumme. LimitRange setzt pro Container (oder pro Pod bzw. pro PVC) Defaults, Minima, Maxima und das zulässige Verhältnis zwischen Limit und Request. Die Quota beantwortet "wie viel darf dieses Team insgesamt nutzen"; die LimitRange beantwortet "was bekommt ein Container, der nichts angibt, und wie viel darf er höchstens verlangen". Beide werden bei der Admission durchgesetzt.
Werden In-Place Pod Resizes auf die ResourceQuota angerechnet? Ja. Ein Resize, das Requests erhöht, wird gegen die Namespace-Quota validiert und abgelehnt, wenn es sie überschreiten würde. Ein Resize, das Requests senkt, gibt die Differenz sofort an die Quota zurück. Genau das ermöglicht es dem Muster "groß starten, dann schrumpfen", den Steady-State-Quota-Footprint eines Namespace nahe an der tatsächlichen Nutzung zu halten.
Warum werden meine Pods beim Start gedrosselt, obwohl der Node freie CPU hat?
Weil ein CPU-Limit vom Kernel über die CFS-Quota pro Container durchgesetzt wird – unabhängig von der Node-Last. Bei einem Limit von 500m bekommt der Container 50ms von jeder 100ms-Periode, egal wie leer der Node ist. Startup-Arbeit wie JIT-Kompilierung oder das Laden von Modulen schöpft diese Quota früh in jeder Periode aus und wartet. Das CPU-Limit zu entfernen – oder maxLimitRequestRatio so anzuheben, dass das Limit deutlich über dem Request liegen kann – lässt die Startphase die freie Kapazität nutzen.
Policies, die zum tatsächlichen Verhalten von Containern passen
Alles oben Beschriebene lässt sich von Hand erledigen: Quota umschreiben, LimitRange öffnen, Admission-Policy aktualisieren, die auffälligsten Workloads neu dimensionieren – und das Ganze wiederholen, sobald sich der Code ändert. Der schwierige Teil ist der letzte Halbsatz. Startup-Profile verschieben sich mit jedem Dependency-Update und jeder geänderten JVM-Flag, und eine Policy, die Sie im März korrekt abgestimmt haben, ist im Juni schon wieder falsch.
PerfectScale by DoiT profiliert jeden Container auf Workload-Ebene, sodass Startup- und Steady-State-Verhalten als getrennte Muster sichtbar werden, statt in einem Durchschnitt zu verschwimmen – und die Empfehlungen bemessen Memory so, dass der Boot-Peak abgedeckt ist, während die Requests auf dem Plateau bleiben. Bei Java-Workloads erkennt es JVM-Container automatisch, sobald der Coroot-Agent aktiviert ist, verfolgt Heap, Non-Heap und GC über die Zeit, markiert Container ohne explizite Heap-Einstellungen und respektiert -Xms und -Xmx, wenn es eine Änderung empfiehlt oder anwendet. Auf Clustern mit Kubernetes 1.33 oder neuer wendet die Automatisierung Right-Sizing in-place an, ohne den Pod neu zu starten, und greift nur dann auf einen Rolling Restart zurück, wenn ein Resize auf dem aktuellen Node nicht möglich ist – damit die Namespace-Quota widerspiegelt, was die Workloads jetzt nutzen, und nicht, was sie 45 Sekunden nach dem letzten Deploy brauchten.
Sie möchten sehen, wie ein Pod mit 2 Cores bootet und sich ohne Neustart und ohne blockierte Quota bei 200m einpendelt? Nehmen Sie am Workshop zum JVM-Startup-Spike teil, oder buchen Sie eine technische Session – dann schauen wir uns gemeinsam die Quota- und LimitRange-Policies in Ihren eigenen Clustern an.