


¿Qué es la observabilidad en Kubernetes?
La observabilidad en Kubernetes es el proceso de recopilar, agregar y analizar datos de telemetría para entender el estado interno, el rendimiento y la salud de un clúster de Kubernetes y sus workloads. A diferencia del monitoreo tradicional de infraestructura, que solo alerta cuando se supera un umbral estático de alguna métrica, la observabilidad permite inferir por qué un sistema se comporta de forma anómala, al ofrecer visibilidad de extremo a extremo sobre microservicios altamente dinámicos y efímeros.
La observabilidad ayuda a los equipos a investigar fallas, problemas de rendimiento y comportamientos inesperados en un entorno distribuido. Por ejemplo, las métricas pueden revelar saturación de recursos, los logs pueden explicar por qué falló un contenedor y las trazas pueden mostrar dónde se produce la latencia entre servicios. Al combinar estas señales, resulta más fácil identificar la causa raíz en lugar de examinar cada componente por separado.
Los 4 pilares de la observabilidad en Kubernetes:
- Métricas: Datos cuantitativos de series de tiempo que miden características del sistema (p. ej., utilización de CPU, consumo de memoria y E/S de red). En Kubernetes, los componentes las exponen mediante endpoints
/metrics, generalmente en formato compatible con Prometheus. - Logs: Registros de texto cronológicos de eventos generados por las aplicaciones, el plano de control (servidor de API, scheduler) o los nodos. Son esenciales para diagnosticar errores específicos y fallas de secuencia.
- Trazas: Mapas de extremo a extremo que muestran cómo una sola solicitud recorre distintos microservicios y atraviesa los límites de la infraestructura. Son vitales para identificar cuellos de botella de red y problemas de latencia.
- Perfiles: Perfilado continuo del rendimiento de las aplicaciones (a menudo basado en tecnología eBPF) que mide CPU y memoria hasta la línea exacta de código sin introducir sobrecarga de agentes.
Este artículo forma parte de una serie sobre el monitoreo de Kubernetes
En este artículo:
- ¿Por qué es importante la observabilidad en Kubernetes?
- Observabilidad vs. monitoreo en Kubernetes
- Los 4 pilares de la observabilidad en Kubernetes
- Métricas clave de observabilidad en Kubernetes que debes monitorear
- Desafíos de la observabilidad en Kubernetes y cómo superarlos
- Mejores prácticas de observabilidad en Kubernetes
¿Por qué es importante la observabilidad en Kubernetes?
Los entornos de Kubernetes son dinámicos. Los pods se reinician, los workloads se mueven entre nodos y los recursos escalan automáticamente. La observabilidad brinda a los equipos los datos necesarios para entender estos cambios y detectar problemas antes de que afecten a los usuarios.
- Resolución de problemas más rápida: Las métricas, los logs y las trazas ayudan a identificar dónde ocurren las fallas y a determinar su causa raíz.
- Monitoreo del rendimiento: La observabilidad muestra el uso de recursos, la latencia de las aplicaciones, las tasas de error y otras señales que pueden revelar cuellos de botella de rendimiento.
- Optimización de recursos: Los datos de CPU, memoria y almacenamiento ayudan a detectar workloads sobredimensionados o restringidos y a ajustar las requests y los limits de recursos.
- Mayor confiabilidad: Monitorear la salud del clúster y de las aplicaciones ayuda a detectar pods con fallas, servicios no disponibles, problemas en los nodos y otras condiciones que pueden reducir la disponibilidad.
- Mejor visibilidad de los sistemas distribuidos: Las aplicaciones en Kubernetes suelen abarcar muchos pods y servicios. La observabilidad conecta las señales entre estos componentes, lo que facilita entender las dependencias y los flujos de solicitudes.
- Planificación de capacidad: Los datos históricos de uso y rendimiento ayudan a estimar los requisitos futuros de infraestructura y a tomar decisiones de escalado informadas.
Observabilidad vs. monitoreo en Kubernetes
El monitoreo da seguimiento a métricas y condiciones predefinidas para determinar si los componentes de Kubernetes funcionan como se espera. Los equipos suelen usar dashboards y alertas para vigilar señales como el uso de CPU, la disponibilidad de pods, el número de reinicios y la latencia de las solicitudes. Funciona bien para detectar condiciones de falla conocidas y responder preguntas que los equipos anticiparon al configurar el sistema de monitoreo.
La observabilidad aporta un contexto más amplio para investigar problemas que no se previeron. Combina métricas, logs, trazas, eventos y metadatos de Kubernetes para ayudar a los equipos a explorar las relaciones entre los workloads y la infraestructura. Por ejemplo, el monitoreo puede alertar que la latencia de las solicitudes aumentó, mientras que la observabilidad puede ayudar a determinar si la causa es un servicio downstream lento, el throttling de recursos o un nodo con fallas.
Por lo tanto, el monitoreo es una parte de la observabilidad en Kubernetes y no una alternativa independiente. El monitoreo identifica síntomas con base en señales conocidas, mientras que la observabilidad proporciona los datos y el contexto necesarios para investigar tanto comportamientos conocidos como inesperados.
Contenido relacionado: Lee nuestro artículo sobre herramientas de monitoreo de Kubernetes
Los 4 pilares de la observabilidad en Kubernetes
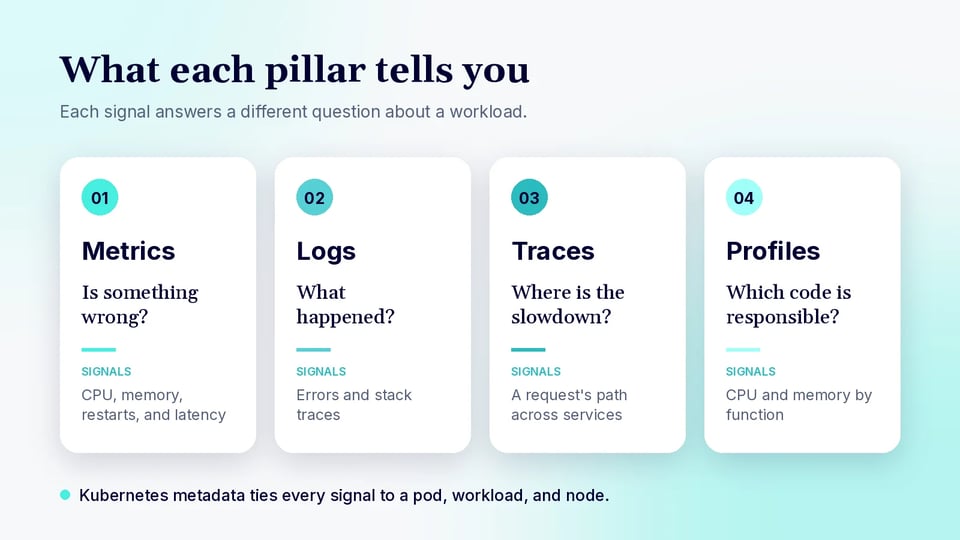
Tradicionalmente, la observabilidad se basaba en tres pilares: métricas, logs y trazas. Sin embargo, en los entornos nativos de la nube se usa cada vez más un cuarto elemento: los perfiles.
1. Métricas
Las métricas son mediciones numéricas recopiladas a lo largo del tiempo desde la infraestructura y las aplicaciones de Kubernetes. Algunos ejemplos comunes incluyen el uso de CPU y memoria, el número de reinicios de pods, las tasas de solicitudes, las tasas de error y la latencia de respuesta. Las métricas se agregan y consultan de forma eficiente, lo que las hace útiles para dashboards, alertas, planificación de capacidad y detección de cambios en el comportamiento del sistema.
Las métricas de Kubernetes pueden provenir de nodos, contenedores, componentes del plano de control y aplicaciones. Las etiquetas y otros metadatos de Kubernetes aportan contexto como el namespace, el workload, el pod y el nodo, lo que ayuda a determinar qué recursos están asociados a un problema de rendimiento o confiabilidad.
2. Logs
Los logs son registros con marca de tiempo de los eventos generados por las aplicaciones, los contenedores, los componentes de Kubernetes y la infraestructura subyacente. Pueden contener mensajes de error, stack traces, detalles de solicitudes, cambios de estado y otra información que explica qué ocurrió en un momento específico.
Como los pods pueden tener una vida corta, depender de los logs almacenados dentro de los contenedores puede dificultar la investigación histórica. La recopilación centralizada de logs los preserva fuera del ciclo de vida del pod y permite buscarlos en todos los workloads. Agregar metadatos de Kubernetes como pod, namespace, contenedor y nodo también ayuda a correlacionar las entradas de log con los recursos que las produjeron.
3. Trazas
Las trazas registran cómo se mueven las solicitudes individuales a través de las aplicaciones distribuidas. Una traza se compone de spans que representan operaciones realizadas por servicios, bases de datos, colas y otros componentes. Cada span puede incluir información de tiempos, estado, atributos y relaciones con otros spans.
El tracing es especialmente útil en entornos de Kubernetes construidos con microservicios. Cuando una solicitud es lenta o falla, los equipos pueden seguir su ruta entre servicios para identificar la operación responsable. Los datos de trazas también se pueden correlacionar con métricas y logs para conectar los síntomas a nivel de aplicación con información de diagnóstico detallada.
4. Perfiles
Los perfiles miden cómo una aplicación consume recursos mientras su código se ejecuta. Los profilers pueden muestrear el uso de CPU, las asignaciones de memoria, la contención de bloqueos y otros comportamientos en tiempo de ejecución, y luego asociar el consumo de recursos con funciones o rutas de código específicas.
El perfilado continuo extiende este análisis a los workloads de producción a lo largo del tiempo. Puede revelar código que consume CPU o memoria en exceso incluso cuando las métricas de infraestructura solo muestran que un pod está limitado en recursos. Combinados con métricas, logs y trazas, los perfiles ayudan a los equipos a pasar de identificar un workload afectado a localizar el código ineficiente de la aplicación.
Métricas clave de observabilidad en Kubernetes que debes monitorear
Kubernetes genera métricas en varias capas, desde la infraestructura del clúster hasta las aplicaciones individuales. Monitorear un conjunto enfocado de métricas ayuda a detectar restricciones de recursos, fallas en los workloads, problemas de escalado y problemas de rendimiento de las aplicaciones.
| Métrica | Qué mide | Por qué importa |
|---|---|---|
| Uso y throttling de CPU | CPU consumida por nodos, pods y contenedores, y si los límites de CPU están aplicando throttling a los workloads | Identifica restricciones de recursos y workloads limitados por los límites de CPU |
| Uso de memoria | Memoria consumida por los workloads y los nodos | Ayuda a detectar workloads cerca de sus límites o nodos con presión de memoria |
| Estado y disponibilidad de los pods | Pods en ejecución, pendientes, fallidos y no disponibles | Revela problemas de despliegue, programación o disponibilidad |
| Número de reinicios de contenedores | Cantidad de veces que se reinician los contenedores | Indica fallos, health checks fallidos o problemas con los límites de recursos |
| Salud y utilización de recursos de los nodos | Disponibilidad del nodo, CPU, memoria, uso de disco y presión de recursos | Detecta problemas de infraestructura que afectan la estabilidad del clúster |
| Requests y limits de recursos | Recursos solicitados y limitados en comparación con el uso real | Identifica workloads sobredimensionados o restringidos |
| Tráfico y errores de red | Volumen de tráfico, errores de paquetes y paquetes descartados | Ayuda a diagnosticar problemas de conectividad y rendimiento de red |
| Tasa de solicitudes, errores y latencia | Tráfico de la aplicación, solicitudes fallidas y tiempos de respuesta | Mide la salud del servicio y el rendimiento de cara al usuario |
| Uso de volúmenes persistentes | Capacidad y utilización del almacenamiento | Identifica volúmenes en riesgo de quedarse sin espacio |
| Métricas del plano de control de Kubernetes | Latencia, errores y señales de salud del servidor de API, el scheduler y etcd | Detecta problemas del plano de control que pueden afectar las operaciones del clúster |
Contenido relacionado: Lee nuestro artículo sobre alertas en Kubernetes
Desafíos de la observabilidad en Kubernetes y cómo superarlos
Workloads efímeros y de corta duración
Kubernetes crea, reemplaza y elimina pods con frecuencia a medida que las aplicaciones escalan, los despliegues cambian o se producen fallas. Cuando un pod desaparece, los logs y la información de ejecución almacenados localmente pueden desaparecer con él. Esto puede dificultar la investigación de fallas una vez que el workload afectado ya no existe.
Los sistemas de observabilidad necesitan recopilar telemetría de forma continua y almacenarla fuera de los workloads individuales. Los metadatos de Kubernetes, como el nombre del pod, el namespace, el deployment, el nodo y las etiquetas, pueden preservar el contexto necesario para analizar eventos incluso después de que los recursos hayan sido reemplazados.
Cómo superarlo:
- Recopila logs, métricas, trazas y eventos de forma continua en lugar de depender de la telemetría almacenada dentro de los pods.
- Envía la telemetría a un almacenamiento centralizado que persista independientemente del ciclo de vida de los pods y los nodos.
- Enriquece la telemetría con metadatos de Kubernetes como namespace, workload, pod, contenedor, nodo y etiquetas.
- Monitorea los eventos del ciclo de vida de los pods, los reinicios de contenedores, las expulsiones y los motivos de terminación para preservar el contexto de las fallas.
- Usa identificadores estables de workloads, como los nombres de deployments o statefulsets, al consultar la telemetría histórica.
Grandes volúmenes de logs y datos de telemetría
Los entornos grandes de Kubernetes pueden generar volúmenes considerables de métricas, logs, trazas y perfiles. El autoescalado y las arquitecturas de microservicios aumentan el número de fuentes de telemetría, mientras que las etiquetas de alta cardinalidad, como los IDs de pods, pueden incrementar significativamente los costos de almacenamiento y consulta.
Los equipos necesitan controlar el volumen de telemetría sin eliminar los datos necesarios para la resolución de problemas. Los enfoques comunes incluyen el filtrado de logs, el muestreo de trazas, la agregación de métricas, las políticas de retención y la limitación de atributos de alta cardinalidad innecesarios. Las políticas de recopilación deben priorizar las señales que aportan información operativa útil.
Cómo superarlo:
- Filtra los logs repetitivos y de bajo valor en la capa de recopilación antes de enviarlos al almacenamiento centralizado.
- Usa el muestreo de trazas para conservar solicitudes representativas y, al mismo tiempo, capturar a mayor tasa los errores y las trazas de alta latencia.
- Agrega las métricas cuando no se necesiten datos detallados por pod o por contenedor.
- Limita las etiquetas y atributos de alta cardinalidad, en especial los identificadores que crean una serie de tiempo única para cada solicitud o recurso.
- Define políticas de retención según el tipo de telemetría y su valor operativo, y conserva los datos de alta resolución solo el tiempo necesario para la resolución de problemas.
Visibilidad multiclúster
Las organizaciones suelen operar múltiples clústeres de Kubernetes en distintas regiones, proveedores de nube, entornos o unidades de negocio. Observar cada clúster por separado genera dashboards fragmentados y dificulta comparar el rendimiento, investigar dependencias compartidas o entender incidentes que afectan a todo el sistema.
Centralizar o federar la telemetría puede ofrecer una vista consistente entre clústeres. Los identificadores de clúster y las etiquetas estandarizadas ayudan a distinguir los recursos y, a la vez, permiten consultas entre clústeres. Los equipos también deben considerar la conectividad de red, la residencia de datos, los controles de acceso y el costo de transferir telemetría entre entornos.
Cómo superarlo:
- Centraliza o federa la telemetría de múltiples clústeres para que los equipos puedan consultar y comparar entornos desde una interfaz común.
- Aplica etiquetas consistentes de clúster, región, entorno, namespace y workload en todas las fuentes de telemetría.
- Estandariza los dashboards, las alertas y las políticas de recopilación de telemetría entre clústeres cuando los requisitos operativos sean similares.
- Aplica controles de acceso para que los usuarios solo vean los clústeres y la telemetría relevantes para sus responsabilidades.
- Considera la residencia de datos, el ancho de banda de red, la disponibilidad y los costos de transferencia de telemetría al decidir dónde se almacenan y procesan los datos.
Correlacionar datos entre microservicios
Una sola solicitud de usuario puede pasar por muchos servicios, pods, bases de datos y colas. Las métricas pueden mostrar que un servicio es lento, mientras que el error relevante aparece en los logs de otro servicio. Sin un contexto compartido, los equipos deben conectar manualmente las señales de distintos sistemas.
Los metadatos de servicio consistentes y los identificadores como los IDs de traza y de solicitud facilitan la correlación. El tracing distribuido puede conectar operaciones a través de los límites entre servicios, mientras que los metadatos de Kubernetes vinculan la telemetría de las aplicaciones con los pods y los nodos. Esto permite pasar de un síntoma de alto nivel al servicio, workload o componente de infraestructura específico involucrado.
Cómo superarlo:
- Propaga los IDs de traza y de solicitud a través de los límites entre servicios para poder conectar la telemetría generada por una misma solicitud.
- Usa tracing distribuido para seguir las solicitudes a través de servicios, bases de datos, colas y otras dependencias.
- Aplica nombres de servicio consistentes y metadatos de Kubernetes a las métricas, los logs y las trazas.
- Incluye identificadores de traza y de span en los logs de la aplicación para que los engineers puedan moverse directamente entre las trazas y las entradas de log relacionadas.
- Preserva el contexto de workload, pod, contenedor y nodo para poder correlacionar las fallas a nivel de aplicación con las condiciones de la infraestructura de Kubernetes.
Mejores prácticas de observabilidad en Kubernetes
Monitorea el rendimiento de la infraestructura y de las aplicaciones
Monitorea la infraestructura de Kubernetes junto con las aplicaciones que se ejecutan sobre ella. La CPU de los nodos, la presión de memoria, el uso de disco, el estado de los pods, las condiciones de red y las métricas del plano de control pueden revelar problemas de infraestructura. La latencia de las solicitudes, las tasas de error, el throughput, los logs de aplicación y las trazas muestran cómo esas condiciones afectan a los servicios y a los usuarios.
Correlacionar ambas capas ayuda a distinguir las fallas de la aplicación de los problemas subyacentes del clúster. Por ejemplo, un aumento de la latencia puede deberse a código de aplicación ineficiente, throttling de CPU, memoria insuficiente, problemas de red o un nodo en mal estado. Analizar juntas la telemetría de infraestructura y de aplicación reduce el tiempo necesario para aislar la capa afectada.
Cuando sea posible, también se deben incluir las dependencias. Un workload de Kubernetes puede parecer saludable mientras las solicitudes se retrasan por una base de datos, una cola, una caché o una API externa. Las trazas distribuidas y las métricas a nivel de servicio ayudan a exponer estas dependencias y a mostrar dónde se originan las fallas o la latencia.
Compara las requests de recursos con el uso real
Compara las requests de CPU y memoria de los contenedores con el consumo de recursos observado. Kubernetes usa las requests al programar los pods, por lo que los valores imprecisos afectan directamente la eficiencia con la que los workloads se ubican en los nodos. Las requests que superan de forma constante el uso real pueden dejar capacidad sin utilizar, mientras que las requests demasiado bajas pueden contribuir a la contención y a un rendimiento inestable.
Evalúa el uso durante períodos representativos en lugar de depender de instantáneas breves. Considera el tráfico normal, los picos de demanda, los despliegues, los trabajos por lotes y los workloads programados, para que la configuración de recursos refleje condiciones de operación realistas. Los datos de uso basados en percentiles pueden ser más útiles que los promedios, ya que estos pueden ocultar períodos cortos de alta demanda.
Los limits deben evaluarse por separado de las requests. Los límites de CPU pueden provocar throttling cuando los workloads necesitan capacidad de procesamiento adicional, mientras que superar un límite de memoria puede terminar un contenedor con un error de falta de memoria. Comparar los limits, las requests y el uso real ofrece una vista más completa de la configuración de recursos.
Aplica right-sizing continuo a los workloads de Kubernetes
Los requisitos de recursos cambian a medida que evolucionan el código de la aplicación, los patrones de tráfico y las dependencias. Revisa con regularidad las requests y los limits de CPU y memoria en lugar de tratar sus valores iniciales como una configuración permanente. Un workload que estaba correctamente dimensionado al desplegarse puede quedar sobredimensionado o restringido a medida que cambia su comportamiento.
Usa la utilización histórica, el throttling de CPU, los eventos de falta de memoria, la latencia y los datos de rendimiento al ajustar los recursos. El right-sizing debe equilibrar la utilización eficiente del clúster con capacidad suficiente para la variabilidad de los workloads y los picos de demanda esperados. Los cambios también deben validarse contra el rendimiento de la aplicación y no solo contra la utilización de recursos.
Las recomendaciones automatizadas pueden ayudar a identificar workloads con diferencias persistentes entre los recursos solicitados y los consumidos. Sin embargo, los equipos deben considerar los requisitos de arranque, los workloads con picos, la capacidad de conmutación por error y los objetivos de nivel de servicio antes de aplicar las recomendaciones.
Monitorea Kubernetes a nivel de workload
Las métricas a nivel de pod son útiles para la resolución de problemas, pero los pods son detalles de implementación temporales. Agrega la telemetría por objetos de workload estables, como deployments, statefulsets y daemonsets, para entender el comportamiento de la aplicación a lo largo de reemplazos de pods, actualizaciones continuas y eventos de escalado.
El monitoreo a nivel de workload también reduce el ruido cuando las réplicas cambian con frecuencia. Los equipos pueden identificar si todo un workload está degradado y luego inspeccionar pods, contenedores o nodos individuales para aislar la causa. Este enfoque es especialmente útil cuando el autoescalado crea y elimina réplicas con frecuencia.
Preserva las relaciones entre los workloads y sus recursos subyacentes. Por ejemplo, los dashboards deben permitir pasar de un deployment con alta latencia a sus pods, contenedores, nodos, logs y trazas. Las etiquetas y los metadatos de propiedad de Kubernetes aportan el contexto necesario para mantener estas relaciones.
Usa datos históricos para identificar tendencias de recursos
Retén suficiente telemetría histórica para distinguir los picos temporales de los cambios sostenidos en la demanda de recursos. Las tendencias de CPU, memoria, almacenamiento, volumen de solicitudes, tráfico de red y número de réplicas pueden revelar restricciones graduales de capacidad que quizás no activen alertas inmediatas.
Los datos históricos también respaldan la planificación de capacidad y los cambios de configuración. Comparar el comportamiento actual con despliegues anteriores, períodos de tráfico o picos estacionales ayuda a determinar si el crecimiento de los recursos es esperado o indica un problema. También puede mostrar cómo los cambios en la configuración de recursos afectan el rendimiento con el tiempo.
Elige los períodos de retención según los requisitos operativos y los ciclos esperados de los workloads. Los datos de alta resolución a corto plazo son útiles para investigar incidentes, mientras que los datos agregados a largo plazo pueden respaldar análisis de tendencias mensuales o estacionales sin retener cada punto de telemetría sin procesar.
Da seguimiento al comportamiento del autoescalado
Monitorea las decisiones de autoescalado horizontal y vertical junto con las métricas que las activan. Las señales útiles incluyen el número de réplicas deseadas y actuales, la frecuencia de escalado, la utilización de recursos, los pods pendientes, los cambios en las recomendaciones y si se están alcanzando los números mínimos o máximos de réplicas configurados.
El escalado frecuente puede indicar umbrales inestables, mientras que los workloads atascados en su capacidad máxima pueden requerir recursos adicionales o políticas de escalado revisadas. Un escalado horizontal lento también puede causar latencia o errores si los nuevos pods tardan demasiado en estar listos. Correlacionar los eventos de escalado con el rendimiento de la aplicación ayuda a determinar si el autoescalado está respondiendo eficazmente a la demanda.
Monitorea también si el clúster tiene capacidad suficiente para satisfacer las decisiones de escalado. Aumentar el número de réplicas deseadas no sirve de nada si los pods quedan pendientes porque los nodos no tienen CPU o memoria. Dar seguimiento a la programación de pods y a la actividad del cluster autoscaler junto con el autoescalado de workloads ofrece una vista más clara del proceso completo de escalado.
Preguntas frecuentes
¿Qué es la observabilidad en Kubernetes? La observabilidad en Kubernetes es la práctica de recopilar, agregar y analizar datos de telemetría para entender el estado interno, el rendimiento y la salud de un clúster y sus workloads. Permite a los equipos inferir por qué un sistema se comporta de forma anómala, y no solo ver que lo hace.
¿Cuál es la diferencia entre observabilidad y monitoreo en Kubernetes? El monitoreo da seguimiento a métricas y condiciones predefinidas, como el uso de CPU o el número de reinicios, y alerta cuando se superan. La observabilidad suma métricas, logs, trazas, eventos y metadatos de Kubernetes para que los equipos puedan investigar problemas que nadie previó. El monitoreo es una parte de la observabilidad.
¿Cuáles son los cuatro pilares de la observabilidad en Kubernetes? Los cuatro pilares son las métricas, los logs, las trazas y los perfiles. Las métricas son mediciones numéricas a lo largo del tiempo, los logs son registros de eventos con marca de tiempo, las trazas siguen una solicitud a través de los servicios y los perfiles muestran cómo el código de la aplicación usa la CPU y la memoria.
¿Por qué la observabilidad es más difícil en Kubernetes? Los pods tienen una vida corta, por lo que los logs y los datos de ejecución pueden desaparecer cuando se reemplaza un pod. Los entornos grandes también producen enormes volúmenes de telemetría, abarcan múltiples clústeres y envían una sola solicitud a través de muchos servicios, lo que dificulta conectar las señales.
¿Qué métricas de Kubernetes debería monitorear primero? Comienza con el uso y el throttling de CPU, el uso de memoria, el estado y la disponibilidad de los pods, el número de reinicios de contenedores y la salud de los nodos. Compara también las requests y los limits de recursos con el uso real, ya que esa comparación revela workloads sobredimensionados y restringidos.
Observabilidad total de Kubernetes con PerfectScale
Recopilar métricas, logs, trazas y perfiles solo es útil si los equipos pueden convertir esas señales en decisiones sobre costos, rendimiento y estabilidad. PerfectScale ofrece visibilidad total de Kubernetes sin puntos ciegos, con insights guiados por IA que destacan riesgos, pérdidas y oportunidades de optimización en cada clúster. Combina observabilidad, monitoreo y análisis continuo de costos, pérdidas, rendimiento y otras métricas en tiempo real e históricas en clústeres, namespaces, workloads y grupos de nodos, para que los equipos mantengan los costos y el rendimiento bajo control sin descuidar la eficiencia operativa y la salud del entorno.
Capacidades clave de PerfectScale:
- Vista integral de costos: Proporciona un desglose completo de los costos de K8s por clúster, namespace, workload y etiqueta, y descubre oportunidades de optimización con visibilidad granular del gasto en todo el entorno.
- Análisis e insights precisos: Usa precios predeterminados o un informe personalizado integrado, como AWS CUR, Azure Cost Management o GCP Cloud Billing, para combinar los datos de facturación con métricas de uso en tiempo real e históricas e identificar tendencias de costos, pérdidas, capacidad inactiva y una asignación de costos precisa.
- Optimización basada en políticas: Aplica políticas de optimización personalizables para que la gestión de recursos se alinee con los objetivos de SLA/SLO y las metas de eficiencia de costos.
- Automatización guiada por IA: Permite una automatización flexible, controlada y sin intervención manual, para que los equipos puedan personalizar cada aspecto de su estrategia de optimización.
- Alertas basadas en el impacto: Prioriza los problemas automáticamente y aplica límites de presupuesto, junto con detección de anomalías de costos y resiliencia que mantiene informados a los equipos antes de que ocurran interrupciones o facturas inesperadas.
- Insights de rendimiento y resiliencia: Analiza continuamente el rendimiento, el comportamiento de los workloads y los patrones de uso de recursos para detectar riesgos de forma proactiva, como throttling de CPU, OOM, requests y limits mal configurados o escalado ineficiente, lo que ayuda a prevenir reinicios de pods, degradación del rendimiento, latencia y tiempo de inactividad.
- Right-sizing autónomo de workloads: Elimina la pérdida sin comprometer el rendimiento mediante una optimización segura y sin intervención manual, con remediación proactiva de problemas impulsada por inteligencia predictiva.
- Escalado y presupuestos inteligentes: Mejora la estrategia de escalado y la previsión presupuestaria para respaldar las operaciones de día 2 a gran escala.
- Integraciones con flujos de trabajo y observabilidad: Conecta a desarrolladores, DevOps, platform engineers y FinOps a través de las herramientas existentes de colaboración, tickets y observabilidad en un ecosistema de optimización unificado.
Conoce más sobre la visibilidad y la gobernanza de Kubernetes guiadas por IA con PerfectScale