


Qu'est-ce que l'observabilité Kubernetes ?
L'observabilité Kubernetes est le processus qui consiste à collecter, agréger et analyser des données de télémétrie afin de comprendre l'état interne, les performances et la santé d'un cluster Kubernetes et de ses workloads. Contrairement au monitoring d'infrastructure traditionnel, qui se contente de vous alerter lorsqu'un seuil statique est dépassé, l'observabilité vous permet de comprendre pourquoi un système dysfonctionne, en offrant une visibilité de bout en bout sur des microservices extrêmement dynamiques et éphémères.
L'observabilité aide les équipes à investiguer les pannes, les problèmes de performance et les comportements inattendus dans un environnement distribué. Par exemple, les métriques peuvent révéler une saturation des ressources, les logs expliquer pourquoi un conteneur a échoué, et les traces montrer où la latence apparaît entre les services. En combinant ces signaux, il devient plus facile d'identifier la cause racine plutôt que d'examiner chaque composant séparément.
Les 4 piliers de l'observabilité Kubernetes :
- Métriques : données quantitatives de séries temporelles mesurant les caractéristiques du système (utilisation CPU, empreinte mémoire, E/S réseau, etc.). Dans Kubernetes, les composants les exposent via des endpoints
/metrics, généralement au format Prometheus. - Logs : enregistrements textuels chronologiques des événements générés par les applications, le plan de contrôle (serveur d'API, scheduler) ou les nœuds. Essentiels pour diagnostiquer des traces d'erreur précises et des échecs séquentiels.
- Traces : cartographies de bout en bout qui suivent le parcours d'une requête à travers les différents microservices et couches d'infrastructure. Indispensables pour identifier les goulots d'étranglement réseau et les problèmes de latence.
- Profils : profilage continu des performances applicatives (souvent basé sur la technologie eBPF) qui mesure CPU et mémoire jusqu'à la ligne de code exacte, sans surcharge d'agent.
Cet article fait partie d'une série consacrée au monitoring Kubernetes
Dans cet article :
- Pourquoi l'observabilité Kubernetes est-elle importante ?
- Observabilité Kubernetes et monitoring : quelles différences ?
- Les 4 piliers de l'observabilité Kubernetes
- Les métriques d'observabilité Kubernetes essentielles à surveiller
- Les défis de l'observabilité Kubernetes et comment les surmonter
- Bonnes pratiques d'observabilité Kubernetes
Pourquoi l'observabilité Kubernetes est-elle importante ?
Les environnements Kubernetes sont dynamiques. Les pods redémarrent, les workloads migrent d'un nœud à l'autre et les ressources s'adaptent automatiquement. L'observabilité fournit aux équipes les données nécessaires pour comprendre ces changements et détecter les problèmes avant qu'ils n'affectent les utilisateurs.
- Dépannage plus rapide : les métriques, logs et traces aident les équipes à localiser les défaillances et à en déterminer la cause racine.
- Suivi des performances : l'observabilité révèle l'utilisation des ressources, la latence applicative, les taux d'erreur et d'autres signaux susceptibles de mettre en évidence des goulots d'étranglement.
- Optimisation des ressources : les données CPU, mémoire et stockage aident les équipes à repérer les workloads surprovisionnés ou contraints et à ajuster les requests et limits.
- Fiabilité renforcée : le monitoring de la santé des clusters et des applications aide les équipes à détecter les pods défaillants, les services indisponibles, les problèmes de nœuds et d'autres conditions susceptibles de réduire la disponibilité.
- Meilleure visibilité sur les systèmes distribués : les applications Kubernetes s'étendent souvent sur de nombreux pods et services. L'observabilité relie les signaux entre ces composants, rendant les dépendances et les flux de requêtes plus faciles à comprendre.
- Planification de capacité : les données historiques d'utilisation et de performance aident les équipes à estimer les besoins futurs en infrastructure et à prendre des décisions de scaling éclairées.
Observabilité Kubernetes et monitoring : quelles différences ?
Le monitoring suit des métriques et conditions prédéfinies afin de déterminer si les composants Kubernetes fonctionnent comme prévu. Les équipes utilisent généralement des dashboards et des alertes pour surveiller des signaux comme l'utilisation CPU, la disponibilité des pods, le nombre de redémarrages et la latence des requêtes. Cette approche fonctionne bien pour détecter des conditions de défaillance connues et répondre aux questions anticipées lors de la configuration du système de monitoring.
L'observabilité offre un contexte plus large pour investiguer des problèmes qui n'avaient pas été anticipés. Elle combine métriques, logs, traces, événements et métadonnées Kubernetes pour aider les équipes à explorer les relations entre workloads et infrastructure. Par exemple, le monitoring peut alerter sur une hausse de la latence des requêtes, tandis que l'observabilité aide à déterminer si la cause est un service en aval lent, un throttling des ressources ou un nœud défaillant.
Le monitoring fait donc partie intégrante de l'observabilité Kubernetes plutôt que d'en constituer une alternative distincte. Le monitoring identifie des symptômes à partir de signaux connus, tandis que l'observabilité fournit les données et le contexte nécessaires pour investiguer les comportements connus comme inattendus.
Contenu associé : lisez notre article sur les outils de monitoring Kubernetes
Les 4 piliers de l'observabilité Kubernetes
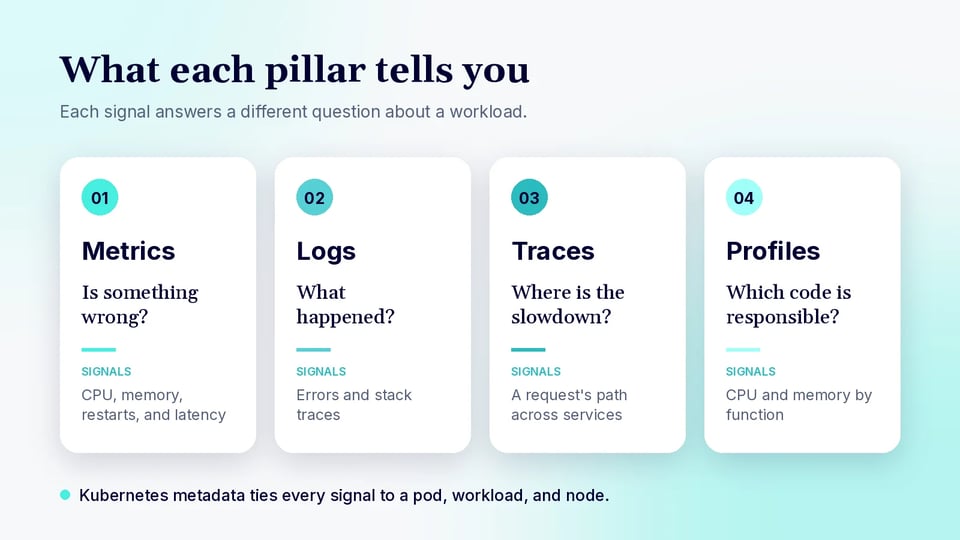
Traditionnellement, l'observabilité reposait sur trois piliers : métriques, logs et traces. Mais dans les environnements cloud-native, un quatrième élément s'impose de plus en plus : les profils.
1. Métriques
Les métriques sont des mesures numériques collectées au fil du temps depuis l'infrastructure Kubernetes et les applications. Exemples courants : utilisation CPU et mémoire, nombre de redémarrages de pods, débit de requêtes, taux d'erreur et latence des réponses. Les métriques sont faciles à agréger et à interroger, ce qui les rend utiles pour les dashboards, les alertes, la planification de capacité et la détection de changements de comportement du système.
Les métriques Kubernetes peuvent provenir des nœuds, des conteneurs, des composants du plan de contrôle et des applications. Les labels et autres métadonnées Kubernetes apportent du contexte (namespace, workload, pod, nœud), aidant les équipes à déterminer quelles ressources sont impliquées dans un problème de performance ou de fiabilité.
2. Logs
Les logs sont des enregistrements horodatés des événements générés par les applications, les conteneurs, les composants Kubernetes et l'infrastructure sous-jacente. Ils peuvent contenir des messages d'erreur, des stack traces, des détails de requêtes, des changements d'état et d'autres informations expliquant ce qui s'est passé à un instant précis.
Les pods pouvant être éphémères, s'appuyer sur des logs stockés dans les conteneurs complique les investigations a posteriori. La collecte centralisée des logs les conserve en dehors du cycle de vie des pods et les rend consultables sur l'ensemble des workloads. L'ajout de métadonnées Kubernetes (pod, namespace, conteneur, nœud) aide également les équipes à corréler les entrées de logs avec les ressources qui les ont produites.
3. Traces
Les traces enregistrent le parcours de chaque requête à travers les applications distribuées. Une trace se compose de spans représentant les opérations effectuées par les services, bases de données, files d'attente et autres composants. Chaque span peut inclure des informations de durée, un statut, des attributs et des relations avec d'autres spans.
Le tracing est particulièrement utile dans les environnements Kubernetes bâtis sur des microservices. Lorsqu'une requête est lente ou échoue, les équipes peuvent suivre son parcours entre les services pour identifier l'opération responsable. Les données de traces peuvent également être corrélées aux métriques et aux logs afin de relier les symptômes applicatifs à des informations de diagnostic détaillées.
4. Profils
Les profils mesurent la façon dont une application consomme des ressources pendant l'exécution de son code. Les profileurs peuvent échantillonner l'utilisation CPU, les allocations mémoire, la contention de verrous et d'autres comportements à l'exécution, puis associer cette consommation à des fonctions ou chemins de code spécifiques.
Le profilage continu étend cette analyse aux workloads de production dans la durée. Il peut révéler du code consommant trop de CPU ou de mémoire, même lorsque les métriques d'infrastructure indiquent seulement qu'un pod est à court de ressources. Combinés aux métriques, logs et traces, les profils aident les équipes à passer de l'identification d'un workload affecté à la localisation du code applicatif inefficace.
Les métriques d'observabilité Kubernetes essentielles à surveiller
Kubernetes produit des métriques à plusieurs niveaux, de l'infrastructure du cluster jusqu'aux applications. Surveiller un ensemble ciblé de métriques aide les équipes à détecter les contraintes de ressources, les défaillances de workloads, les problèmes de scaling et les problèmes de performance applicative.
| Métrique | Ce qu'elle mesure | Pourquoi c'est important |
|---|---|---|
| Utilisation et throttling CPU | CPU consommé par les nœuds, pods et conteneurs, et éventuel throttling des workloads par les limits CPU | Identifie les contraintes de ressources et les workloads bridés par les limits CPU |
| Utilisation mémoire | Mémoire consommée par les workloads et les nœuds | Aide à détecter les workloads proches de leurs limits ou les nœuds sous pression mémoire |
| Statut et disponibilité des pods | Pods en cours d'exécution, en attente, en échec ou indisponibles | Révèle des problèmes de déploiement, d'ordonnancement ou de disponibilité |
| Nombre de redémarrages de conteneurs | Nombre de redémarrages des conteneurs | Signale des crashs, des health checks en échec ou des problèmes de limites de ressources |
| Santé et utilisation des ressources des nœuds | Disponibilité des nœuds, CPU, mémoire, utilisation disque et pression sur les ressources | Détecte les problèmes d'infrastructure affectant la stabilité du cluster |
| Requests et limits | Ressources demandées et limitées comparées à l'utilisation réelle | Identifie les workloads surprovisionnés ou contraints |
| Trafic et erreurs réseau | Volume de trafic, erreurs de paquets et paquets perdus | Aide à diagnostiquer les problèmes de connectivité et de performance réseau |
| Débit de requêtes, erreurs et latence | Trafic applicatif, requêtes en échec et temps de réponse | Mesure la santé des services et les performances perçues par les utilisateurs |
| Utilisation des volumes persistants | Capacité et utilisation du stockage | Identifie les volumes risquant de manquer d'espace |
| Métriques du plan de contrôle Kubernetes | Latence, erreurs et signaux de santé du serveur d'API, du scheduler et d'etcd | Détecte les problèmes du plan de contrôle pouvant affecter le fonctionnement du cluster |
Contenu associé : lisez notre article sur l'alerting Kubernetes
Les défis de l'observabilité Kubernetes et comment les surmonter
Workloads éphémères et de courte durée
Kubernetes crée, remplace et supprime fréquemment des pods au fil du scaling des applications, des changements de déploiement ou des pannes. Lorsqu'un pod disparaît, les logs et informations d'exécution stockés localement peuvent disparaître avec lui. Il devient alors difficile d'investiguer des défaillances une fois que le workload concerné n'existe plus.
Les systèmes d'observabilité doivent collecter la télémétrie en continu et la stocker en dehors des workloads individuels. Les métadonnées Kubernetes comme le nom du pod, le namespace, le déploiement, le nœud et les labels permettent de conserver le contexte nécessaire pour analyser les événements, même après le remplacement des ressources.
Comment y remédier :
- Collectez les logs, métriques, traces et événements en continu plutôt que de vous appuyer sur la télémétrie stockée dans les pods.
- Envoyez la télémétrie vers un stockage centralisé qui persiste indépendamment du cycle de vie des pods et des nœuds.
- Enrichissez la télémétrie avec des métadonnées Kubernetes : namespace, workload, pod, conteneur, nœud et labels.
- Surveillez les événements du cycle de vie des pods, les redémarrages de conteneurs, les évictions et les motifs de terminaison pour préserver le contexte des défaillances.
- Utilisez des identifiants de workloads stables, comme les noms de deployments ou de statefulsets, pour interroger la télémétrie historique.
Volumes massifs de logs et de données de télémétrie
Les environnements Kubernetes de grande taille peuvent générer des volumes considérables de métriques, logs, traces et profils. L'autoscaling et les architectures microservices multiplient les sources de télémétrie, tandis que les labels à forte cardinalité, comme les identifiants de pods, peuvent faire grimper significativement les coûts de stockage et de requête.
Les équipes doivent maîtriser le volume de télémétrie sans supprimer les données nécessaires au dépannage. Les approches courantes incluent le filtrage des logs, l'échantillonnage des traces, l'agrégation des métriques, les politiques de rétention et la limitation des attributs à forte cardinalité superflus. Les politiques de collecte doivent privilégier les signaux qui apportent des informations opérationnelles utiles.
Comment y remédier :
- Filtrez les logs répétitifs et à faible valeur au niveau de la collecte, avant de les envoyer vers le stockage centralisé.
- Utilisez l'échantillonnage des traces pour conserver des requêtes représentatives, tout en capturant à des taux plus élevés les erreurs et les traces à forte latence.
- Agrégez les métriques lorsque le détail par pod ou par conteneur n'est pas nécessaire.
- Limitez les labels et attributs à forte cardinalité, en particulier les identifiants qui créent une série temporelle unique pour chaque requête ou ressource.
- Définissez des politiques de rétention par type de télémétrie et valeur opérationnelle, en ne conservant les données haute résolution que le temps nécessaire au dépannage.
Visibilité multi-cluster
Les organisations exploitent souvent plusieurs clusters Kubernetes répartis entre régions, fournisseurs cloud, environnements ou unités métier. Observer chaque cluster séparément crée des dashboards fragmentés et complique la comparaison des performances, l'investigation des dépendances partagées ou la compréhension des incidents à l'échelle du système.
Centraliser ou fédérer la télémétrie permet d'obtenir une vue cohérente sur l'ensemble des clusters. Les identifiants de clusters et les labels standardisés aident à distinguer les ressources tout en permettant des requêtes inter-clusters. Les équipes doivent aussi prendre en compte la connectivité réseau, la localisation des données, les contrôles d'accès et le coût du transfert de télémétrie entre environnements.
Comment y remédier :
- Centralisez ou fédérez la télémétrie de plusieurs clusters afin que les équipes puissent interroger et comparer les environnements depuis une interface commune.
- Appliquez des labels cohérents pour le cluster, la région, l'environnement, le namespace et le workload sur toutes les sources de télémétrie.
- Standardisez les dashboards, les alertes et les politiques de collecte de télémétrie entre clusters lorsque les exigences opérationnelles sont similaires.
- Appliquez des contrôles d'accès afin que les utilisateurs ne voient que les clusters et la télémétrie relevant de leurs responsabilités.
- Tenez compte de la localisation des données, de la bande passante réseau, de la disponibilité et des coûts de transfert de télémétrie au moment de choisir où les données sont stockées et traitées.
Corréler les données entre microservices
Une seule requête utilisateur peut traverser de nombreux services, pods, bases de données et files d'attente. Les métriques peuvent indiquer qu'un service est lent, alors que l'erreur pertinente apparaît dans les logs d'un autre service. Sans contexte partagé, les équipes doivent relier manuellement des signaux issus de systèmes différents.
Des métadonnées de services cohérentes et des identifiants comme les IDs de trace et de requête facilitent la corrélation. Le tracing distribué relie les opérations entre les services, tandis que les métadonnées Kubernetes rattachent la télémétrie applicative aux pods et aux nœuds. Les équipes peuvent ainsi passer d'un symptôme de haut niveau au service, au workload ou au composant d'infrastructure concerné.
Comment y remédier :
- Propagez les IDs de trace et de requête d'un service à l'autre afin de pouvoir relier la télémétrie générée par une même requête.
- Utilisez le tracing distribué pour suivre les requêtes à travers les services, bases de données, files d'attente et autres dépendances.
- Appliquez des noms de services et des métadonnées Kubernetes cohérents aux métriques, logs et traces.
- Incluez les identifiants de trace et de span dans les logs applicatifs pour que les ingénieurs puissent naviguer directement entre les traces et les entrées de logs associées.
- Préservez le contexte workload, pod, conteneur et nœud afin de corréler les défaillances applicatives avec l'état de l'infrastructure Kubernetes.
Bonnes pratiques d'observabilité Kubernetes
Surveiller à la fois l'infrastructure et les performances applicatives
Surveillez l'infrastructure Kubernetes en parallèle des applications qui y tournent. CPU des nœuds, pression mémoire, utilisation disque, statut des pods, conditions réseau et métriques du plan de contrôle peuvent révéler des problèmes d'infrastructure. La latence des requêtes, les taux d'erreur, le débit, les logs applicatifs et les traces montrent comment ces conditions affectent les services et les utilisateurs.
Corréler les deux couches aide à distinguer les défaillances applicatives des problèmes sous-jacents du cluster. Par exemple, une hausse de latence peut résulter d'un code applicatif inefficace, d'un throttling CPU, d'une mémoire insuffisante, de problèmes réseau ou d'un nœud défaillant. Examiner ensemble la télémétrie d'infrastructure et applicative réduit le temps nécessaire pour isoler la couche affectée.
Les dépendances doivent également être prises en compte dans la mesure du possible. Un workload Kubernetes peut sembler sain alors que les requêtes sont ralenties par une base de données, une file d'attente, un cache ou une API externe. Les traces distribuées et les métriques au niveau service aident à mettre en évidence ces dépendances et à montrer d'où proviennent les défaillances ou la latence.
Comparer les requests de ressources à l'utilisation réelle
Comparez les requests CPU et mémoire des conteneurs à la consommation de ressources observée. Kubernetes s'appuie sur les requests pour ordonnancer les pods : des valeurs inexactes affectent donc directement l'efficacité du placement des workloads sur les nœuds. Des requests systématiquement supérieures à l'utilisation réelle peuvent laisser de la capacité inutilisée, tandis que des requests trop basses peuvent provoquer de la contention et des performances instables.
Évaluez l'utilisation sur des périodes représentatives plutôt que sur de courts instantanés. Prenez en compte le trafic normal, les pics de demande, les déploiements, les jobs batch et les workloads planifiés afin que les réglages de ressources reflètent des conditions d'exploitation réalistes. Les données d'utilisation basées sur des percentiles peuvent être plus utiles que les moyennes, car celles-ci peuvent masquer de courtes périodes de forte demande.
Les limits doivent être évaluées séparément des requests. Les limits CPU peuvent provoquer du throttling lorsque les workloads ont besoin de capacité de calcul supplémentaire, tandis que dépasser une limit mémoire peut entraîner l'arrêt d'un conteneur avec une erreur out-of-memory. Comparer limits, requests et utilisation réelle offre une vue plus complète de la configuration des ressources.
Appliquer un right-sizing continu aux workloads Kubernetes
Les besoins en ressources évoluent avec le code applicatif, les profils de trafic et les dépendances. Révisez régulièrement les requests et limits CPU et mémoire plutôt que de considérer leurs valeurs initiales comme une configuration définitive. Un workload correctement dimensionné au déploiement peut devenir surprovisionné ou contraint à mesure que son comportement change.
Appuyez-vous sur l'utilisation historique, le throttling CPU, les événements out-of-memory, la latence et les données de performance pour ajuster les ressources. Le right-sizing doit concilier une utilisation efficace du cluster et une capacité suffisante pour absorber la variabilité des workloads et les pics de demande attendus. Les changements doivent également être validés au regard des performances applicatives, et pas seulement de l'utilisation des ressources.
Les recommandations automatisées peuvent aider à identifier les workloads présentant des écarts persistants entre ressources demandées et consommées. Les équipes doivent toutefois tenir compte des besoins au démarrage, des workloads en rafale, de la capacité de failover et des objectifs de niveau de service avant d'appliquer ces recommandations.
Superviser Kubernetes au niveau des workloads
Les métriques au niveau des pods sont utiles pour le dépannage, mais les pods ne sont que des détails d'implémentation temporaires. Agrégez la télémétrie par objets de workload stables, comme les deployments, statefulsets et daemonsets, pour comprendre le comportement applicatif à travers les remplacements de pods, les rolling updates et les événements de scaling.
Le monitoring au niveau des workloads réduit aussi le bruit lorsque les réplicas changent fréquemment. Les équipes peuvent déterminer si un workload entier est dégradé, puis inspecter les pods, conteneurs ou nœuds individuels pour isoler la cause. Cette approche est particulièrement utile lorsque l'autoscaling crée et supprime fréquemment des réplicas.
Préservez les relations entre les workloads et leurs ressources sous-jacentes. Par exemple, les dashboards doivent permettre de passer d'un deployment à forte latence à ses pods, conteneurs, nœuds, logs et traces. Les labels Kubernetes et les métadonnées de propriété fournissent le contexte nécessaire pour maintenir ces relations.
Exploiter les données historiques pour identifier les tendances de ressources
Conservez suffisamment de télémétrie historique pour distinguer les pics temporaires des évolutions durables de la demande en ressources. Les tendances CPU, mémoire, stockage, volume de requêtes, trafic réseau et nombre de réplicas peuvent révéler des contraintes de capacité progressives qui ne déclenchent pas forcément d'alertes immédiates.
Les données historiques appuient également la planification de capacité et les changements de configuration. Comparer le comportement actuel aux déploiements précédents, aux périodes de trafic ou aux pics saisonniers aide les équipes à déterminer si la croissance des ressources est attendue ou révélatrice d'un problème. Elles montrent aussi comment les modifications des réglages de ressources affectent les performances dans le temps.
Choisissez les durées de rétention en fonction des exigences opérationnelles et des cycles de workloads attendus. Les données haute résolution à court terme sont utiles pour l'investigation d'incidents, tandis que les données agrégées à long terme permettent l'analyse de tendances mensuelles ou saisonnières sans conserver chaque point de télémétrie brut.
Suivre le comportement de l'autoscaling
Surveillez les décisions d'autoscaling horizontal et vertical en parallèle des métriques qui les déclenchent. Signaux utiles : nombres de réplicas souhaités et actuels, fréquence de scaling, utilisation des ressources, pods en attente, évolutions des recommandations, et atteinte éventuelle des nombres de réplicas minimum ou maximum configurés.
Un scaling fréquent peut révéler des seuils instables, tandis que des workloads bloqués à leur capacité maximale peuvent nécessiter des ressources supplémentaires ou des politiques de scaling révisées. Un scale-out trop lent peut aussi provoquer de la latence ou des erreurs si les nouveaux pods mettent trop de temps à devenir prêts. Corréler les événements de scaling avec les performances applicatives aide à déterminer si l'autoscaling répond efficacement à la demande.
Vérifiez également que le cluster dispose d'une capacité suffisante pour honorer les décisions de scaling. Augmenter le nombre de réplicas souhaité ne sert à rien si les pods restent en attente faute de CPU ou de mémoire sur les nœuds. Suivre l'ordonnancement des pods et l'activité du cluster autoscaler en parallèle de l'autoscaling des workloads offre une vision plus claire du processus de scaling complet.
FAQ
Qu'est-ce que l'observabilité Kubernetes ? L'observabilité Kubernetes est la pratique consistant à collecter, agréger et analyser des données de télémétrie afin de comprendre l'état interne, les performances et la santé d'un cluster et de ses workloads. Elle permet aux équipes de comprendre pourquoi un système dysfonctionne, et pas seulement de constater qu'il dysfonctionne.
Quelle est la différence entre observabilité Kubernetes et monitoring ? Le monitoring suit des métriques et conditions prédéfinies, comme l'utilisation CPU ou le nombre de redémarrages, et alerte en cas de dépassement. L'observabilité y ajoute métriques, logs, traces, événements et métadonnées Kubernetes afin que les équipes puissent investiguer des problèmes que personne n'avait anticipés. Le monitoring est une composante de l'observabilité.
Quels sont les quatre piliers de l'observabilité Kubernetes ? Les quatre piliers sont les métriques, les logs, les traces et les profils. Les métriques sont des mesures numériques dans le temps, les logs des enregistrements d'événements horodatés, les traces suivent une requête à travers les services et les profils montrent comment le code applicatif utilise le CPU et la mémoire.
Pourquoi l'observabilité est-elle plus difficile dans Kubernetes ? Les pods sont éphémères : les logs et données d'exécution peuvent disparaître lorsqu'un pod est remplacé. Les grands environnements produisent aussi d'énormes volumes de télémétrie, s'étendent sur plusieurs clusters et font transiter une même requête par de nombreux services, ce qui rend les signaux difficiles à relier.
Quelles métriques Kubernetes surveiller en priorité ? Commencez par l'utilisation et le throttling CPU, l'utilisation mémoire, le statut et la disponibilité des pods, le nombre de redémarrages de conteneurs et la santé des nœuds. Comparez également les requests et limits à l'utilisation réelle : cette comparaison révèle les workloads surprovisionnés ou contraints.
Une observabilité Kubernetes complète avec PerfectScale
Collecter métriques, logs, traces et profils n'a de valeur que si les équipes peuvent transformer ces signaux en décisions sur les coûts, les performances et la stabilité. PerfectScale offre une visibilité Kubernetes complète, sans angle mort, grâce à des insights guidés par l'IA qui mettent en lumière les risques, le gaspillage et les opportunités d'optimisation sur chaque cluster. La solution combine observabilité, monitoring et analyse continue des coûts, du gaspillage, des performances et d'autres métriques en temps réel et historiques à travers les clusters, namespaces, workloads et groupes de nœuds, afin que les équipes maîtrisent coûts et performances tout en préservant l'efficacité opérationnelle et la santé de l'environnement.
Fonctionnalités clés de PerfectScale :
- Vue globale des coûts : fournit une ventilation complète des coûts K8s par cluster, namespace, workload et label, et révèle les opportunités d'optimisation grâce à une visibilité granulaire sur les dépenses de l'ensemble de l'environnement.
- Analyses et insights précis : utilise la tarification par défaut ou un rapport personnalisé intégré (AWS CUR, Azure Cost Management ou GCP Cloud Billing) pour combiner les données de facturation avec les métriques d'utilisation en temps réel et historiques, et identifier tendances de coûts, gaspillage, capacité inutilisée et allocation précise des coûts.
- Optimisation pilotée par des politiques : applique des politiques d'optimisation personnalisables afin que la gestion des ressources reste alignée sur les objectifs SLA/SLO comme sur les objectifs d'efficience économique.
- Automatisation guidée par l'IA : permet une automatisation flexible, contrôlée et sans intervention, pour que les équipes ajustent chaque aspect de leur stratégie d'optimisation.
- Alertes basées sur l'impact : priorise automatiquement les problèmes et applique des garde-fous budgétaires, avec une détection d'anomalies de coûts et de résilience qui informe les équipes avant toute interruption ou facture inattendue.
- Insights de performance et de résilience : analyse en continu les performances, le comportement des workloads et les schémas d'utilisation des ressources pour détecter de manière proactive les risques tels que le throttling CPU, les OOM, les requests et limits mal configurés ou un scaling inefficace, afin de prévenir redémarrages de pods, dégradations de performance, latence et interruptions.
- Right-sizing autonome des workloads : élimine le gaspillage sans compromettre les performances grâce à une optimisation sûre et sans intervention, avec une remédiation proactive des problèmes pilotée par l'intelligence prédictive.
- Scaling et budgétisation intelligents : améliore la stratégie de scaling et les prévisions budgétaires pour soutenir les opérations day-2 à grande échelle.
- Intégrations workflow et observabilité : connecte développeurs, DevOps, platform engineers et FinOps via les outils existants de collaboration, de ticketing et d'observabilité au sein d'un écosystème d'optimisation unifié.
Découvrez la visibilité et la gouvernance Kubernetes guidées par l'IA avec PerfectScale