


Che cos'è l'osservabilità di Kubernetes?
L'osservabilità di Kubernetes è il processo di raccolta, aggregazione e analisi dei dati di telemetria per comprendere lo stato interno, le prestazioni e la salute di un cluster Kubernetes e dei suoi workloads. A differenza del monitoraggio tradizionale dell'infrastruttura, che si limita ad avvisare quando viene superata una soglia statica di una metrica, l'osservabilità permette di capire perché un sistema si comporta in modo anomalo, offrendo visibilità end-to-end su microservizi altamente dinamici ed effimeri.
L'osservabilità aiuta i team a indagare su guasti, problemi di prestazioni e comportamenti imprevisti in un ambiente distribuito. Ad esempio, le metriche possono rivelare la saturazione delle risorse, i log possono spiegare perché un container è andato in errore e le tracce possono mostrare dove si verifica la latenza tra i servizi. Combinare questi segnali rende più semplice individuare la causa principale, invece di esaminare ogni componente separatamente.
I 4 pilastri dell'osservabilità di Kubernetes:
- Metriche: dati quantitativi in serie temporali che misurano le caratteristiche del sistema (ad es. utilizzo della CPU, footprint di memoria e I/O di rete). In Kubernetes, i componenti le espongono tramite endpoint
/metrics, generalmente in formato Prometheus. - Log: registrazioni testuali in ordine cronologico degli eventi generati dalle applicazioni, dal control plane (API server, scheduler) o dai nodi. Essenziali per diagnosticare specifici errori e sequenze di guasti.
- Tracce: mappe end-to-end che tracciano il percorso di una singola richiesta attraverso i vari microservizi e i confini dell'infrastruttura. Sono fondamentali per individuare colli di bottiglia di rete e problemi di latenza.
- Profili: profilazione continua delle prestazioni applicative (spesso basata sulla tecnologia eBPF) che misura CPU e memoria fino alla singola riga di codice, senza introdurre overhead legato agli agent.
Questo articolo fa parte di una serie dedicata al monitoraggio di Kubernetes
In questo articolo:
- Perché l'osservabilità di Kubernetes è importante?
- Osservabilità vs. monitoraggio di Kubernetes
- I 4 pilastri dell'osservabilità di Kubernetes
- Le metriche chiave di osservabilità di Kubernetes da monitorare
- Le sfide dell'osservabilità di Kubernetes e come superarle
- Best practice di osservabilità di Kubernetes
Perché l'osservabilità di Kubernetes è importante?
Gli ambienti Kubernetes sono dinamici. I pod si riavviano, i workloads si spostano tra i nodi e le risorse scalano automaticamente. L'osservabilità fornisce ai team i dati necessari per comprendere questi cambiamenti e rilevare i problemi prima che abbiano un impatto sugli utenti.
- Risoluzione dei problemi più rapida: metriche, log e tracce aiutano i team a identificare dove si verificano i guasti e a determinarne la causa principale.
- Monitoraggio delle prestazioni: l'osservabilità mostra l'utilizzo delle risorse, la latenza delle applicazioni, i tassi di errore e altri segnali in grado di rivelare colli di bottiglia nelle prestazioni.
- Ottimizzazione delle risorse: i dati su CPU, memoria e storage aiutano i team a individuare workloads sovradimensionati o con risorse insufficienti e a regolare richieste e limiti di risorse.
- Maggiore affidabilità: monitorare la salute del cluster e delle applicazioni aiuta i team a rilevare pod in errore, servizi non disponibili, problemi dei nodi e altre condizioni che possono ridurre la disponibilità.
- Migliore visibilità sui sistemi distribuiti: le applicazioni Kubernetes si estendono spesso su molti pod e servizi. L'osservabilità collega i segnali tra questi componenti, rendendo più comprensibili dipendenze e flussi delle richieste.
- Pianificazione della capacità: i dati storici di utilizzo e prestazioni aiutano i team a stimare i requisiti infrastrutturali futuri e a prendere decisioni di scaling informate.
Osservabilità vs. monitoraggio di Kubernetes
Il monitoraggio tiene traccia di metriche e condizioni predefinite per determinare se i componenti Kubernetes funzionano come previsto. I team usano in genere dashboard e avvisi per osservare segnali come l'utilizzo della CPU, la disponibilità dei pod, il numero di riavvii e la latenza delle richieste. Funziona bene per rilevare condizioni di guasto note e rispondere a domande che i team avevano previsto durante la configurazione del sistema di monitoraggio.
L'osservabilità fornisce un contesto più ampio per indagare su problemi non previsti in anticipo. Combina metriche, log, tracce, eventi e metadati di Kubernetes per aiutare i team a esplorare le relazioni tra workloads e infrastruttura. Ad esempio, il monitoraggio può segnalare che la latenza delle richieste è aumentata, mentre l'osservabilità può aiutare a determinare se la causa è un servizio a valle lento, il throttling delle risorse o un nodo in errore.
Il monitoraggio è quindi una parte dell'osservabilità di Kubernetes, non un'alternativa separata. Il monitoraggio identifica i sintomi sulla base di segnali noti, mentre l'osservabilità fornisce i dati e il contesto necessari per indagare su comportamenti sia noti sia imprevisti.
Contenuti correlati: legga il nostro articolo sugli strumenti di monitoraggio per Kubernetes
I 4 pilastri dell'osservabilità di Kubernetes
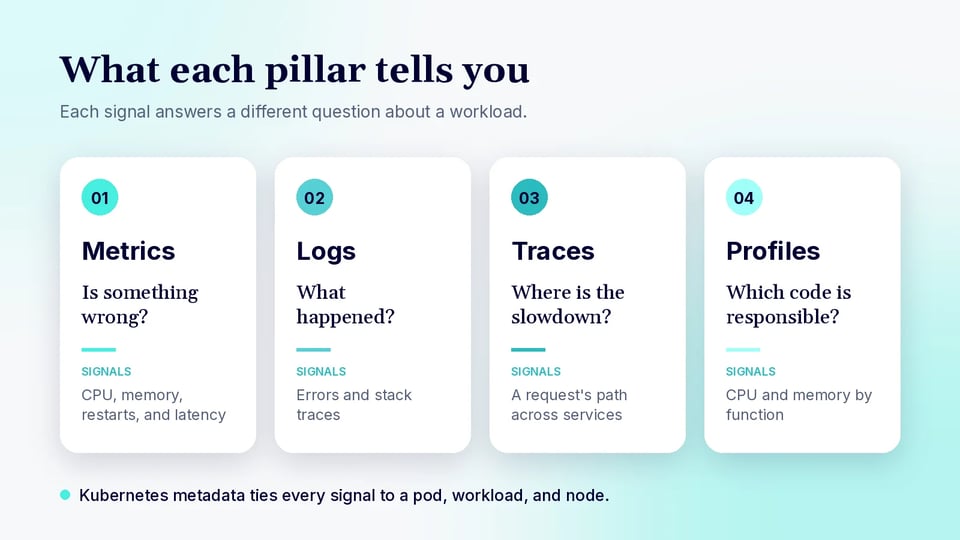
Tradizionalmente, l'osservabilità si basava su tre pilastri: metriche, log e tracce. Tuttavia, negli ambienti cloud-native si fa un uso crescente di un quarto elemento: i profili.
1. Metriche
Le metriche sono misurazioni numeriche raccolte nel tempo dall'infrastruttura e dalle applicazioni Kubernetes. Esempi comuni includono l'utilizzo di CPU e memoria, il numero di riavvii dei pod, i tassi di richieste, i tassi di errore e la latenza di risposta. Le metriche sono efficienti da aggregare e interrogare, il che le rende utili per dashboard, avvisi, pianificazione della capacità e rilevamento di cambiamenti nel comportamento del sistema.
Le metriche di Kubernetes possono provenire da nodi, container, componenti del control plane e applicazioni. Le label e gli altri metadati di Kubernetes forniscono contesto come namespace, workload, pod e nodo, aiutando i team a determinare quali risorse sono associate a un problema di prestazioni o affidabilità.
2. Log
I log sono registrazioni con timestamp degli eventi generati da applicazioni, container, componenti di Kubernetes e infrastruttura sottostante. Possono contenere messaggi di errore, stack trace, dettagli delle richieste, cambiamenti di stato e altre informazioni che spiegano cosa è accaduto in un momento specifico.
Poiché i pod possono avere vita breve, affidarsi ai log memorizzati all'interno dei container può rendere difficile l'analisi storica. La raccolta centralizzata dei log li conserva al di fuori del ciclo di vita dei pod e li rende ricercabili tra i workloads. Aggiungere metadati di Kubernetes come pod, namespace, container e nodo aiuta inoltre i team a correlare le voci di log con le risorse che le hanno generate.
3. Tracce
Le tracce registrano il percorso delle singole richieste attraverso le applicazioni distribuite. Una traccia è composta da span che rappresentano operazioni eseguite da servizi, database, code e altri componenti. Ogni span può includere informazioni temporali, stato, attributi e relazioni con altri span.
Il tracing è particolarmente utile negli ambienti Kubernetes basati su microservizi. Quando una richiesta è lenta o fallisce, i team possono seguirne il percorso tra i servizi per identificare l'operazione responsabile. I dati di traccia possono inoltre essere correlati con metriche e log per collegare i sintomi a livello applicativo a informazioni diagnostiche dettagliate.
4. Profili
I profili misurano come un'applicazione consuma risorse durante l'esecuzione del codice. I profiler possono campionare l'utilizzo della CPU, le allocazioni di memoria, la contesa sui lock e altri comportamenti a runtime, associando poi il consumo di risorse a funzioni o percorsi di codice specifici.
La profilazione continua estende questa analisi ai workloads di produzione nel tempo. Può rivelare codice che consuma CPU o memoria in modo eccessivo anche quando le metriche infrastrutturali mostrano solo che un pod ha risorse limitate. Combinati con metriche, log e tracce, i profili aiutano i team a passare dall'identificazione di un workload interessato alla localizzazione del codice applicativo inefficiente.
Le metriche chiave di osservabilità di Kubernetes da monitorare
Kubernetes produce metriche su più livelli, dall'infrastruttura del cluster alle singole applicazioni. Monitorare un insieme mirato di metriche aiuta i team a rilevare vincoli di risorse, guasti dei workloads, problemi di scaling e problemi di prestazioni applicative.
| Metrica | Cosa misura | Perché è importante |
|---|---|---|
| Utilizzo e throttling della CPU | CPU consumata da nodi, pod e container, oltre a indicare se i limiti di CPU stanno applicando throttling ai workloads | Identifica vincoli di risorse e workloads limitati dai limiti di CPU |
| Utilizzo della memoria | Memoria consumata da workloads e nodi | Aiuta a rilevare workloads vicini ai limiti o nodi con memoria sotto pressione |
| Stato e disponibilità dei pod | Pod in esecuzione, in attesa, in errore e non disponibili | Rivela problemi di deployment, scheduling o disponibilità |
| Numero di riavvii dei container | Numero di volte in cui i container si riavviano | Indica crash, health check falliti o problemi legati ai limiti di risorse |
| Salute dei nodi e utilizzo delle risorse | Readiness dei nodi, CPU, memoria, utilizzo del disco e pressione sulle risorse | Rileva problemi infrastrutturali che influiscono sulla stabilità del cluster |
| Richieste e limiti di risorse | Risorse richieste e limitate confrontate con l'utilizzo effettivo | Identifica workloads sovradimensionati o con risorse insufficienti |
| Traffico ed errori di rete | Volume di traffico, errori di pacchetti e pacchetti scartati | Aiuta a diagnosticare problemi di connettività e prestazioni di rete |
| Tasso di richieste, errori e latenza | Traffico applicativo, richieste fallite e tempi di risposta | Misura la salute dei servizi e le prestazioni percepite dagli utenti |
| Utilizzo dei volumi persistenti | Capacità e utilizzo dello storage | Identifica i volumi a rischio di esaurire lo spazio |
| Metriche del control plane di Kubernetes | Latenza, errori e segnali di salute di API server, scheduler ed etcd | Rileva problemi del control plane che possono influire sulle operazioni del cluster |
Contenuti correlati: legga il nostro articolo sull'alerting in Kubernetes
Le sfide dell'osservabilità di Kubernetes e come superarle
Workloads effimeri e di breve durata
Kubernetes crea, sostituisce e rimuove frequentemente i pod man mano che le applicazioni scalano, i deployment cambiano o si verificano guasti. Quando un pod scompare, i log e le informazioni di runtime memorizzati localmente possono scomparire con esso. Questo può rendere difficile indagare sui guasti quando il workload interessato non esiste più.
I sistemi di osservabilità devono raccogliere la telemetria in modo continuo e archiviarla al di fuori dei singoli workloads. I metadati di Kubernetes come nome del pod, namespace, deployment, nodo e label possono preservare il contesto necessario per analizzare gli eventi anche dopo la sostituzione delle risorse.
Come superarla:
- Raccogliere log, metriche, tracce ed eventi in modo continuo, invece di affidarsi alla telemetria memorizzata all'interno dei pod.
- Inviare la telemetria a uno storage centralizzato che persista indipendentemente dal ciclo di vita di pod e nodi.
- Arricchire la telemetria con metadati di Kubernetes come namespace, workload, pod, container, nodo e label.
- Monitorare gli eventi del ciclo di vita dei pod, i riavvii dei container, le eviction e i motivi di terminazione per preservare il contesto dei guasti.
- Utilizzare identificatori di workload stabili, come i nomi di deployment o statefulset, quando si interroga la telemetria storica.
Grandi volumi di log e dati di telemetria
Gli ambienti Kubernetes di grandi dimensioni possono generare volumi considerevoli di metriche, log, tracce e profili. L'autoscaling e le architetture a microservizi aumentano il numero di sorgenti di telemetria, mentre le label ad alta cardinalità, come gli ID dei pod, possono aumentare significativamente i costi di archiviazione e interrogazione.
I team devono controllare il volume della telemetria senza eliminare i dati necessari per la risoluzione dei problemi. Gli approcci comuni includono il filtraggio dei log, il campionamento delle tracce, l'aggregazione delle metriche, le policy di conservazione e la limitazione degli attributi ad alta cardinalità non necessari. Le policy di raccolta dovrebbero dare priorità ai segnali che forniscono informazioni operative utili.
Come superarla:
- Filtrare i log ripetitivi e di scarso valore a livello di raccolta, prima di inviarli allo storage centralizzato.
- Utilizzare il campionamento delle tracce per conservare richieste rappresentative, acquisendo a tassi più elevati gli errori e le tracce ad alta latenza.
- Aggregare le metriche laddove non sono necessari dati dettagliati per singolo pod o container.
- Limitare label e attributi ad alta cardinalità, soprattutto gli identificatori che creano una serie temporale univoca per ogni richiesta o risorsa.
- Definire policy di conservazione in base al tipo di telemetria e al valore operativo, mantenendo i dati ad alta risoluzione solo per il tempo necessario alla risoluzione dei problemi.
Visibilità multi-cluster
Le organizzazioni gestiscono spesso più cluster Kubernetes distribuiti tra regioni, cloud provider, ambienti o unità di business. Osservare ogni cluster in modo indipendente crea dashboard frammentate e rende più difficile confrontare le prestazioni, indagare sulle dipendenze condivise o comprendere gli incidenti a livello di sistema.
Centralizzare o federare la telemetria può fornire una vista coerente tra i cluster. Gli identificatori dei cluster e le label standardizzate aiutano a distinguere le risorse supportando al contempo le query cross-cluster. I team devono inoltre tenere conto della connettività di rete, della residenza dei dati, dei controlli di accesso e dei costi di trasferimento della telemetria tra gli ambienti.
Come superarla:
- Centralizzare o federare la telemetria di più cluster, in modo che i team possano interrogare e confrontare gli ambienti da un'interfaccia comune.
- Applicare label coerenti per cluster, regione, ambiente, namespace e workload in tutte le sorgenti di telemetria.
- Standardizzare dashboard, avvisi e policy di raccolta della telemetria tra i cluster con requisiti operativi simili.
- Applicare controlli di accesso in modo che gli utenti possano visualizzare solo i cluster e la telemetria pertinenti alle proprie responsabilità.
- Tenere conto di residenza dei dati, larghezza di banda di rete, disponibilità e costi di trasferimento della telemetria nella scelta di dove archiviare ed elaborare i dati.
Correlare i dati tra i microservizi
Una singola richiesta utente può attraversare molti servizi, pod, database e code. Le metriche possono mostrare che un servizio è lento, mentre l'errore rilevante compare nei log di un altro servizio. Senza un contesto condiviso, i team devono collegare manualmente i segnali provenienti da sistemi diversi.
Metadati di servizio coerenti e identificatori come trace ID e request ID semplificano la correlazione. Il tracing distribuito può collegare le operazioni oltre i confini dei servizi, mentre i metadati di Kubernetes collegano la telemetria applicativa a pod e nodi. Questo permette ai team di passare da un sintomo di alto livello al servizio, workload o componente infrastrutturale specifico coinvolto.
Come superarla:
- Propagare trace ID e request ID oltre i confini dei servizi, in modo da poter collegare la telemetria generata dalla stessa richiesta.
- Utilizzare il tracing distribuito per seguire le richieste tra servizi, database, code e altre dipendenze.
- Applicare nomi di servizio coerenti e metadati di Kubernetes a metriche, log e tracce.
- Includere gli identificatori di traccia e span nei log applicativi, così che gli engineer possano passare direttamente dalle tracce alle voci di log correlate.
- Preservare il contesto di workload, pod, container e nodo, in modo da poter correlare i guasti a livello applicativo con le condizioni dell'infrastruttura Kubernetes.
Best practice di osservabilità di Kubernetes
Monitorare le prestazioni sia dell'infrastruttura sia delle applicazioni
Monitorare l'infrastruttura Kubernetes insieme alle applicazioni che vi vengono eseguite. CPU dei nodi, pressione sulla memoria, utilizzo del disco, stato dei pod, condizioni di rete e metriche del control plane possono rivelare problemi infrastrutturali. Latenza delle richieste, tassi di errore, throughput, log applicativi e tracce mostrano come tali condizioni influiscono su servizi e utenti.
Correlare entrambi i livelli aiuta a distinguere i guasti applicativi dai problemi sottostanti del cluster. Ad esempio, un aumento della latenza può derivare da codice applicativo inefficiente, throttling della CPU, memoria insufficiente, problemi di rete o un nodo in cattivo stato. Esaminare insieme la telemetria di infrastruttura e applicazioni riduce il tempo necessario per isolare il livello interessato.
Dove possibile, è bene includere anche le dipendenze. Un workload Kubernetes può apparire in buono stato mentre le richieste vengono rallentate da un database, una coda, una cache o un'API esterna. Le tracce distribuite e le metriche a livello di servizio aiutano a far emergere queste dipendenze e a mostrare dove hanno origine guasti o latenza.
Confrontare le richieste di risorse con l'utilizzo effettivo
Confrontare le richieste di CPU e memoria dei container con il consumo di risorse osservato. Kubernetes utilizza le richieste durante lo scheduling dei pod, quindi valori imprecisi influiscono direttamente sull'efficienza con cui i workloads vengono allocati sui nodi. Richieste che superano costantemente l'utilizzo effettivo possono lasciare capacità inutilizzata, mentre richieste troppo basse possono contribuire a contese e prestazioni instabili.
Valutare l'utilizzo su periodi rappresentativi anziché affidarsi a brevi istantanee. Considerare traffico normale, picchi di domanda, deployment, job batch e workloads pianificati, in modo che le impostazioni delle risorse riflettano condizioni operative realistiche. I dati di utilizzo basati sui percentili possono essere più utili delle medie, poiché queste ultime possono nascondere brevi periodi di domanda elevata.
I limiti dovrebbero essere valutati separatamente dalle richieste. I limiti di CPU possono causare throttling quando i workloads necessitano di capacità di elaborazione aggiuntiva, mentre superare un limite di memoria può terminare un container con un errore di out-of-memory. Confrontare limiti, richieste e utilizzo effettivo offre una visione più completa della configurazione delle risorse.
Eseguire il right-sizing continuo dei workloads Kubernetes
I requisiti di risorse cambiano man mano che codice applicativo, pattern di traffico e dipendenze evolvono. Rivedere regolarmente richieste e limiti di CPU e memoria, invece di considerare i valori iniziali una configurazione permanente. Un workload dimensionato correttamente al momento del deployment può diventare sovradimensionato o sottodimensionato con il cambiare del suo comportamento.
Utilizzare dati storici di utilizzo, throttling della CPU, eventi di out-of-memory, latenza e prestazioni quando si regolano le risorse. Il right-sizing dovrebbe bilanciare un utilizzo efficiente del cluster con capacità sufficiente per la variabilità dei workloads e i picchi di domanda previsti. Le modifiche dovrebbero inoltre essere convalidate rispetto alle prestazioni applicative e non solo all'utilizzo delle risorse.
Le raccomandazioni automatizzate possono aiutare a individuare i workloads con differenze persistenti tra risorse richieste e consumate. Tuttavia, prima di applicarle, i team dovrebbero tenere conto dei requisiti di avvio, dei workloads con picchi improvvisi, della capacità di failover e degli obiettivi di livello di servizio.
Monitorare Kubernetes a livello di workload
Le metriche a livello di pod sono utili per la risoluzione dei problemi, ma i pod sono dettagli implementativi temporanei. Aggregare la telemetria per oggetti workload stabili, come deployment, statefulset e daemonset, per comprendere il comportamento delle applicazioni attraverso sostituzioni di pod, rolling update ed eventi di scaling.
Il monitoraggio a livello di workload riduce inoltre il rumore quando le repliche cambiano di frequente. I team possono capire se un intero workload è degradato e poi ispezionare singoli pod, container o nodi per isolare la causa. Questo approccio è particolarmente utile quando l'autoscaling crea e rimuove repliche di frequente.
Preservare le relazioni tra i workloads e le risorse sottostanti. Ad esempio, le dashboard dovrebbero permettere di passare da un deployment con latenza elevata ai suoi pod, container, nodi, log e tracce. Le label di Kubernetes e i metadati di ownership forniscono il contesto necessario per mantenere queste relazioni.
Utilizzare i dati storici per individuare i trend delle risorse
Conservare telemetria storica sufficiente per distinguere i picchi temporanei dai cambiamenti duraturi nella domanda di risorse. I trend di CPU, memoria, storage, volume delle richieste, traffico di rete e numero di repliche possono rivelare vincoli di capacità graduali che potrebbero non attivare avvisi immediati.
I dati storici supportano anche la pianificazione della capacità e le modifiche di configurazione. Confrontare il comportamento attuale con deployment precedenti, periodi di traffico o picchi stagionali aiuta i team a determinare se la crescita delle risorse è prevista o indica un problema. Può inoltre mostrare come le modifiche alle impostazioni delle risorse influiscono sulle prestazioni nel tempo.
Scegliere i periodi di conservazione in base ai requisiti operativi e ai cicli di workload previsti. I dati ad alta risoluzione a breve termine sono utili per l'analisi degli incidenti, mentre i dati aggregati a lungo termine possono supportare l'analisi dei trend mensili o stagionali senza conservare ogni singolo punto di telemetria grezza.
Tenere traccia del comportamento dell'autoscaling
Monitorare le decisioni di autoscaling orizzontale e verticale insieme alle metriche che le attivano. I segnali utili includono il numero di repliche desiderato e attuale, la frequenza di scaling, l'utilizzo delle risorse, i pod in attesa, le variazioni delle raccomandazioni e il raggiungimento dei valori minimi o massimi di repliche configurati.
Uno scaling frequente può indicare soglie instabili, mentre workloads bloccati alla capacità massima possono richiedere risorse aggiuntive o policy di scaling riviste. Uno scale-out lento può inoltre causare latenza o errori se i nuovi pod impiegano troppo tempo a diventare pronti. Correlare gli eventi di scaling con le prestazioni applicative aiuta a determinare se l'autoscaling risponde efficacemente alla domanda.
Monitorare anche se il cluster dispone di capacità sufficiente per soddisfare le decisioni di scaling. Aumentare il numero di repliche desiderato non serve se i pod restano in attesa perché i nodi non hanno CPU o memoria sufficienti. Tenere traccia dello scheduling dei pod e dell'attività del cluster autoscaler insieme all'autoscaling dei workloads offre una visione più chiara dell'intero processo di scaling.
FAQ
Che cos'è l'osservabilità di Kubernetes? L'osservabilità di Kubernetes è la pratica di raccogliere, aggregare e analizzare i dati di telemetria per comprendere lo stato interno, le prestazioni e la salute di un cluster e dei suoi workloads. Permette ai team di capire perché un sistema si comporta in modo anomalo, non solo di constatarlo.
Qual è la differenza tra osservabilità e monitoraggio di Kubernetes? Il monitoraggio tiene traccia di metriche e condizioni predefinite, come l'utilizzo della CPU o il numero di riavvii, e genera avvisi quando vengono superate. L'osservabilità aggiunge metriche, log, tracce, eventi e metadati di Kubernetes, così che i team possano indagare su problemi che nessuno aveva previsto. Il monitoraggio è una parte dell'osservabilità.
Quali sono i quattro pilastri dell'osservabilità di Kubernetes? I quattro pilastri sono metriche, log, tracce e profili. Le metriche sono misurazioni numeriche nel tempo, i log sono registrazioni di eventi con timestamp, le tracce seguono una richiesta tra i servizi e i profili mostrano come il codice applicativo utilizza CPU e memoria.
Perché l'osservabilità è più difficile in Kubernetes? I pod hanno vita breve, quindi log e dati di runtime possono scomparire quando un pod viene sostituito. Gli ambienti di grandi dimensioni producono inoltre enormi volumi di telemetria, si estendono su più cluster e fanno passare una singola richiesta attraverso molti servizi, il che rende difficile collegare i segnali.
Quali metriche di Kubernetes dovrei monitorare per prime? Inizi da utilizzo e throttling della CPU, utilizzo della memoria, stato e disponibilità dei pod, numero di riavvii dei container e salute dei nodi. Confronti inoltre richieste e limiti di risorse con l'utilizzo effettivo, poiché questo confronto evidenzia workloads sovradimensionati o con risorse insufficienti.
Ottenere la piena osservabilità di Kubernetes con PerfectScale
Raccogliere metriche, log, tracce e profili è utile solo se i team possono trasformare questi segnali in decisioni su costi, prestazioni e stabilità. PerfectScale offre visibilità completa su Kubernetes senza punti ciechi, grazie a insight guidati dall'AI che fanno emergere rischi, sprechi e opportunità di ottimizzazione in ogni cluster. Combina osservabilità, monitoraggio e analisi continua di costi, sprechi, prestazioni e altre metriche in tempo reale e storiche su cluster, namespace, workloads e gruppi di nodi, così i team possono tenere sotto controllo costi e prestazioni mantenendo efficienza operativa e salute dell'ambiente.
Le funzionalità chiave di PerfectScale:
- Vista olistica dei costi: fornisce una ripartizione completa dei costi K8s per cluster, namespace, workload e label, facendo emergere opportunità di ottimizzazione con visibilità granulare sulla spesa dell'intero ambiente.
- Analisi e insight accurati: utilizza i prezzi predefiniti o un report personalizzato integrato, come AWS CUR, Azure Cost Management o GCP Cloud Billing, per combinare i dati di fatturazione con metriche di utilizzo in tempo reale e storiche e identificare trend di costo, sprechi, capacità inattiva e un'allocazione precisa dei costi.
- Ottimizzazione basata su policy: applica policy di ottimizzazione personalizzabili affinché la gestione delle risorse sia allineata agli obiettivi SLA/SLO oltre che agli obiettivi di efficienza dei costi.
- Automazione guidata dall'AI: abilita un'automazione flessibile, controllata e hands-free, consentendo ai team di personalizzare ogni aspetto della propria strategia di ottimizzazione.
- Avvisi basati sull'impatto: assegna automaticamente priorità ai problemi e applica guardrail di budget, insieme al rilevamento di anomalie di costo e resilienza che tiene informati i team prima che si verifichino interruzioni o fatture inattese.
- Insight su prestazioni e resilienza: analizza continuamente prestazioni, comportamento dei workloads e pattern di utilizzo delle risorse per rilevare proattivamente rischi come throttling della CPU, OOM, richieste e limiti mal configurati o scaling inefficiente, aiutando a prevenire riavvii dei pod, degrado delle prestazioni, latenza e downtime.
- Right-sizing autonomo dei workloads: elimina gli sprechi senza compromettere le prestazioni grazie a un'ottimizzazione sicura e hands-free, con risoluzione proattiva dei problemi guidata da intelligenza predittiva.
- Scaling e budgeting intelligenti: migliora la strategia di scaling e le previsioni di budget per supportare le operazioni day-2 su larga scala.
- Integrazioni con workflow e strumenti di osservabilità: collega sviluppatori, DevOps, platform engineer e FinOps attraverso gli strumenti esistenti di collaborazione, ticketing e osservabilità in un ecosistema di ottimizzazione unificato.
Scopra di più sulla visibilità e la governance di Kubernetes guidate dall'AI con PerfectScale