


Kubernetesオブザーバビリティとは
Kubernetesオブザーバビリティとは、テレメトリーデータを収集・集約・分析し、Kubernetesクラスターとそのワークロードの内部状態、パフォーマンス、健全性を把握するプロセスです。静的なメトリクスのベースラインを超えた際にアラートを発するだけの従来型のインフラ監視とは異なり、オブザーバビリティは、きわめて動的で短命なマイクロサービスへのエンドツーエンドの可視性を提供することで、システムがなぜ異常な動作をしているのかを推測できるようにします。
オブザーバビリティは、分散環境全体における障害、パフォーマンスの問題、予期しない挙動の調査に役立ちます。たとえば、メトリクスはリソースの飽和状態を明らかにし、ログはコンテナが異常終了した理由を説明し、トレースはサービス間のどこでレイテンシが発生しているかを示します。これらのシグナルを組み合わせることで、各コンポーネントを個別に調べることなく、根本原因を特定しやすくなります。
Kubernetesオブザーバビリティの4つの柱:
- メトリクス: システムの特性を測定する定量的な時系列データ(CPU使用率、メモリフットプリント、ネットワークI/Oなど)。Kubernetesでは、各コンポーネントが
/metricsエンドポイント経由で出力し、通常はPrometheus向けの形式になっています。 - ログ: アプリケーション、コントロールプレーン(APIサーバー、スケジューラー)、またはノードが生成するイベントの時系列テキスト記録。特定のエラートレースや一連の障害を診断するうえで不可欠です。
- トレース: 単一のリクエストがさまざまなマイクロサービスやインフラの境界をどのように通過するかを追跡するエンドツーエンドのマップ。ネットワークのボトルネックやレイテンシの問題を特定するうえで重要です。
- プロファイル: エージェントのオーバーヘッドを発生させることなく、CPU/メモリの使用状況をコードの行単位まで測定する継続的なアプリケーションパフォーマンスプロファイリング(多くの場合eBPF技術を活用)。
本記事は、Kubernetesモニタリングに関する連載記事の一部です
本記事の内容:
- なぜKubernetesオブザーバビリティが重要なのか
- Kubernetesオブザーバビリティとモニタリングの違い
- Kubernetesオブザーバビリティの4つの柱
- 監視すべき主要なKubernetesオブザーバビリティメトリクス
- Kubernetesオブザーバビリティの課題と克服方法
- Kubernetesオブザーバビリティのベストプラクティス
なぜKubernetesオブザーバビリティが重要なのか
Kubernetes環境は動的です。Podは再起動し、ワークロードはノード間を移動し、リソースは自動的にスケールします。オブザーバビリティは、こうした変化を理解し、ユーザーに影響が及ぶ前に問題を検知するために必要なデータをチームに提供します。
- トラブルシューティングの迅速化: メトリクス、ログ、トレースにより、障害の発生箇所を特定し、根本原因を突き止めることができます。
- パフォーマンス監視: オブザーバビリティは、リソース使用状況、アプリケーションのレイテンシ、エラー率など、パフォーマンスのボトルネックを明らかにし得るシグナルを示します。
- リソースの最適化: CPU、メモリ、ストレージのデータから、過剰にプロビジョニングされた、あるいはリソースが不足しているワークロードを見つけ、リソースのリクエストとリミットを調整できます。
- 信頼性の向上: クラスターとアプリケーションの健全性を監視することで、障害が発生しているPod、利用できないサービス、ノードの問題など、可用性を低下させ得る状態を検知できます。
- 分散システムの可視性向上: Kubernetesアプリケーションは多数のPodやサービスにまたがることが少なくありません。オブザーバビリティはこれらのコンポーネント間のシグナルを結び付け、依存関係やリクエストの流れを理解しやすくします。
- キャパシティプランニング: 過去の使用状況とパフォーマンスデータから、将来のインフラ要件を見積もり、根拠に基づいたスケーリングの意思決定を行えます。
Kubernetesオブザーバビリティとモニタリングの違い
モニタリングは、事前に定義されたメトリクスや条件を追跡し、Kubernetesコンポーネントが期待どおりに動作しているかどうかを判断するものです。チームは通常、ダッシュボードとアラートを使って、CPU使用率、Podの可用性、再起動回数、リクエストのレイテンシといったシグナルを監視します。既知の障害状態を検知し、監視システムの設定時に想定していた問いに答えるうえでは有効です。
オブザーバビリティは、事前に予測できなかった問題を調査するための、より広いコンテキストを提供します。メトリクス、ログ、トレース、イベント、Kubernetesのメタデータを組み合わせ、ワークロードとインフラの関係を探索できるようにします。たとえば、モニタリングはリクエストのレイテンシが増加したことを通知できますが、オブザーバビリティは、その原因が下流サービスの遅延、リソースのスロットリング、障害が発生しているノードのいずれなのかを判断するのに役立ちます。
したがって、モニタリングは独立した代替手段ではなく、Kubernetesオブザーバビリティの一部です。モニタリングが既知のシグナルに基づいて症状を特定するのに対し、オブザーバビリティは既知・未知を問わず挙動を調査するために必要なデータとコンテキストを提供します。
関連記事:Kubernetesモニタリングツールの記事もあわせてご覧ください
Kubernetesオブザーバビリティの4つの柱
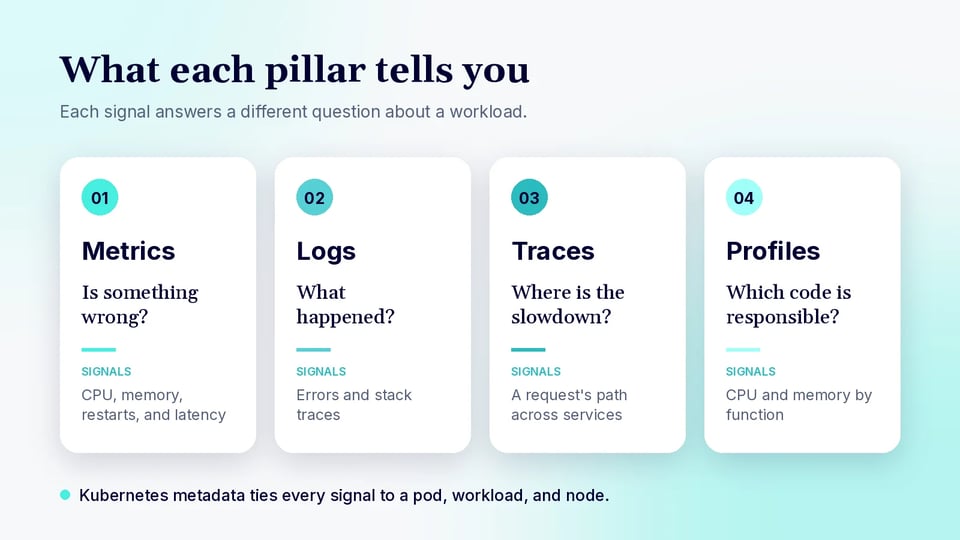
従来、オブザーバビリティはメトリクス、ログ、トレースの3つの柱に基づいていました。しかし、クラウドネイティブ環境では、4つ目の要素であるプロファイルの活用が広がっています。
1. メトリクス
メトリクスは、Kubernetesのインフラとアプリケーションから時間の経過とともに収集される数値データです。代表的な例として、CPUとメモリの使用量、Podの再起動回数、リクエストレート、エラー率、応答レイテンシが挙げられます。メトリクスは集約やクエリを効率的に行えるため、ダッシュボード、アラート、キャパシティプランニング、システム挙動の変化の検知に役立ちます。
Kubernetesのメトリクスは、ノード、コンテナ、コントロールプレーンのコンポーネント、アプリケーションから取得できます。ラベルをはじめとするKubernetesのメタデータは、ネームスペース、ワークロード、Pod、ノードといったコンテキストを提供し、パフォーマンスや信頼性の問題に関係するリソースの特定に役立ちます。
2. ログ
ログは、アプリケーション、コンテナ、Kubernetesコンポーネント、基盤インフラが生成するタイムスタンプ付きのイベント記録です。エラーメッセージ、スタックトレース、リクエストの詳細、状態の変化など、特定の時点で何が起きたかを説明する情報を含みます。
Podは短命である場合があるため、コンテナ内部に保存されたログに依存すると、過去にさかのぼった調査が困難になることがあります。ログを一元的に収集すれば、Podのライフサイクルとは独立してログが保持され、ワークロードを横断して検索できるようになります。Pod、ネームスペース、コンテナ、ノードといったKubernetesメタデータを付加することで、ログエントリとそれを生成したリソースの関連付けも容易になります。
3. トレース
トレースは、個々のリクエストが分散アプリケーション内をどのように移動するかを記録します。トレースは、サービス、データベース、キューなどのコンポーネントが実行する処理を表すスパンで構成されます。各スパンには、タイミング情報、ステータス、属性、他のスパンとの関係を含めることができます。
トレーシングは、マイクロサービスで構成されたKubernetes環境で特に有用です。リクエストが遅い、あるいは失敗した場合、サービス間の経路をたどって原因となっている処理を特定できます。トレースデータをメトリクスやログと関連付けることで、アプリケーションレベルの症状と詳細な診断情報を結び付けることもできます。
4. プロファイル
プロファイルは、コードの実行中にアプリケーションがどのようにリソースを消費しているかを測定します。プロファイラーは、CPU使用率、メモリ割り当て、ロック競合などのランタイム挙動をサンプリングし、リソース消費を特定の関数やコードパスに紐付けます。
継続的プロファイリングは、この分析を本番ワークロード全体に時間軸で拡張します。インフラメトリクスではPodのリソース不足しか分からない場合でも、CPUやメモリを過剰に消費しているコードを明らかにできます。メトリクス、ログ、トレースと組み合わせることで、影響を受けたワークロードの特定から、非効率なアプリケーションコードの発見へと進むことができます。
監視すべき主要なKubernetesオブザーバビリティメトリクス
Kubernetesは、クラスターインフラから個々のアプリケーションまで、複数のレイヤーでメトリクスを生成します。重要なメトリクスに絞って監視することで、リソースの制約、ワークロードの障害、スケーリングの問題、アプリケーションのパフォーマンス問題を検知できます。
| メトリクス | 測定対象 | 重要な理由 |
|---|---|---|
| CPU使用率とスロットリング | ノード、Pod、コンテナが消費するCPU、およびCPUリミットによるワークロードのスロットリングの有無 | リソースの制約と、CPUリミットによって制限されているワークロードを特定 |
| メモリ使用量 | ワークロードとノードが消費するメモリ | リミットに近づいているワークロードや、メモリプレッシャーが発生しているノードの検知に役立つ |
| Podのステータスと可用性 | Running、Pending、Failed、利用不可のPod | デプロイ、スケジューリング、可用性の問題を明らかにする |
| コンテナ再起動回数 | コンテナが再起動した回数 | クラッシュ、ヘルスチェックの失敗、リソースリミットの問題を示す |
| ノードの健全性とリソース使用率 | ノードのReady状態、CPU、メモリ、ディスク使用量、リソースプレッシャー | クラスターの安定性に影響するインフラの問題を検知 |
| リソースのリクエストとリミット | リクエストおよびリミットとして設定されたリソースと実際の使用量との比較 | 過剰プロビジョニングまたはリソース不足のワークロードを特定 |
| ネットワークトラフィックとエラー | トラフィック量、パケットエラー、パケットドロップ | 接続性やネットワークパフォーマンスの問題の診断に役立つ |
| リクエストレート、エラー、レイテンシ | アプリケーションのトラフィック、失敗したリクエスト、応答時間 | サービスの健全性とユーザー向けパフォーマンスを測定 |
| 永続ボリュームの使用状況 | ストレージの容量と使用率 | 容量不足のリスクがあるボリュームを特定 |
| Kubernetesコントロールプレーンのメトリクス | APIサーバー、スケジューラー、etcdのレイテンシ、エラー、健全性シグナル | クラスター運用に影響し得るコントロールプレーンの問題を検知 |
関連記事:Kubernetesアラートの記事もあわせてご覧ください
Kubernetesオブザーバビリティの課題と克服方法
短命で一時的なワークロード
Kubernetesでは、アプリケーションのスケール、デプロイの変更、障害の発生に伴い、Podの作成・置き換え・削除が頻繁に行われます。Podが消えると、ローカルに保存されていたログやランタイム情報も一緒に失われることがあります。その結果、対象のワークロードがすでに存在しない状態では、障害の調査が困難になります。
オブザーバビリティシステムは、テレメトリーを継続的に収集し、個々のワークロードの外部に保存する必要があります。Pod名、ネームスペース、Deployment、ノード、ラベルといったKubernetesメタデータがあれば、リソースが置き換えられた後でもイベントを分析するためのコンテキストを保持できます。
克服方法:
- Pod内部に保存されたテレメトリーに依存せず、ログ、メトリクス、トレース、イベントを継続的に収集する。
- Podやノードのライフサイクルとは独立して保持される一元的なストレージにテレメトリーを送信する。
- ネームスペース、ワークロード、Pod、コンテナ、ノード、ラベルといったKubernetesメタデータでテレメトリーを補強する。
- 障害のコンテキストを保持するため、Podのライフサイクルイベント、コンテナの再起動、Eviction、終了理由を監視する。
- 過去のテレメトリーを検索する際は、DeploymentやStatefulSetの名前など、安定したワークロード識別子を使用する。
大量のログとテレメトリーデータ
大規模なKubernetes環境では、膨大な量のメトリクス、ログ、トレース、プロファイルが生成されることがあります。オートスケーリングとマイクロサービスアーキテクチャはテレメトリーの発生源を増やし、Pod IDのような高カーディナリティのラベルは、ストレージとクエリのコストを大幅に増加させる可能性があります。
チームは、トラブルシューティングに必要なデータを失うことなく、テレメトリーの量を制御する必要があります。一般的なアプローチとして、ログのフィルタリング、トレースのサンプリング、メトリクスの集約、保持ポリシーの設定、不要な高カーディナリティ属性の制限があります。収集ポリシーでは、運用上有用な情報を提供するシグナルを優先すべきです。
克服方法:
- 一元的なストレージに送信する前に、収集レイヤーで反復的で価値の低いログをフィルタリングする。
- トレースサンプリングを活用し、代表的なリクエストを保持しつつ、エラーや高レイテンシのトレースをより高いレートで取得する。
- Podやコンテナ単位の詳細なデータが不要な場合はメトリクスを集約する。
- 高カーディナリティのラベルや属性、特にリクエストやリソースごとに一意の時系列を生成する識別子を制限する。
- テレメトリーの種類と運用上の価値に応じて保持ポリシーを定義し、高解像度データはトラブルシューティングに必要な期間だけ保持する。
マルチクラスターの可視性
組織は多くの場合、リージョン、クラウドプロバイダー、環境、事業部門をまたいで複数のKubernetesクラスターを運用しています。クラスターごとに個別に観測すると、ダッシュボードが分断され、パフォーマンスの比較、共有依存関係の調査、システム全体のインシデントの把握が難しくなります。
テレメトリーを一元化またはフェデレーションすることで、クラスター横断で一貫したビューを得られます。クラスター識別子と標準化されたラベルにより、リソースを区別しながらクラスター横断のクエリを実行できます。また、ネットワーク接続性、データレジデンシー、アクセス制御、環境間のテレメトリー転送コストも考慮する必要があります。
克服方法:
- 複数クラスターのテレメトリーを一元化またはフェデレーションし、共通のインターフェースから環境を照会・比較できるようにする。
- クラスター、リージョン、環境、ネームスペース、ワークロードに対して、テレメトリーソース全体で一貫したラベルを適用する。
- 運用要件が類似するクラスター間で、ダッシュボード、アラート、テレメトリー収集ポリシーを標準化する。
- ユーザーが自身の責任範囲に関連するクラスターとテレメトリーのみを閲覧できるよう、アクセス制御を適用する。
- データの保存・処理場所を選択する際は、データレジデンシー、ネットワーク帯域、可用性、テレメトリー転送コストを考慮する。
マイクロサービス間のデータの関連付け
1つのユーザーリクエストが、多数のサービス、Pod、データベース、キューを通過することがあります。メトリクスではあるサービスの遅延が示される一方で、該当するエラーは別のサービスのログに記録されていることがあります。共有されたコンテキストがなければ、チームは異なるシステムのシグナルを手作業で突き合わせなければなりません。
一貫したサービスメタデータと、トレースIDやリクエストIDといった識別子があれば、関連付けが容易になります。分散トレーシングはサービス境界をまたいで処理をつなぎ、KubernetesメタデータはアプリケーションのテレメトリーをPodやノードに結び付けます。これにより、全体的な症状から、関係する特定のサービス、ワークロード、インフラコンポーネントへとたどることができます。
克服方法:
- 同じリクエストから生成されたテレメトリーをつなげられるよう、トレースIDとリクエストIDをサービス境界をまたいで伝播させる。
- 分散トレーシングを使い、サービス、データベース、キューなどの依存先を横断してリクエストを追跡する。
- メトリクス、ログ、トレースに一貫したサービス名とKubernetesメタデータを適用する。
- エンジニアがトレースと関連するログエントリを直接行き来できるよう、アプリケーションログにトレースとスパンの識別子を含める。
- アプリケーションレベルの障害をKubernetesインフラの状態と関連付けられるよう、ワークロード、Pod、コンテナ、ノードのコンテキストを保持する。
Kubernetesオブザーバビリティのベストプラクティス
インフラとアプリケーションの両方のパフォーマンスを監視する
Kubernetesインフラは、その上で動作するアプリケーションと併せて監視しましょう。ノードのCPU、メモリプレッシャー、ディスク使用量、Podのステータス、ネットワーク状態、コントロールプレーンのメトリクスは、インフラの問題を明らかにします。リクエストのレイテンシ、エラー率、スループット、アプリケーションログ、トレースは、こうした状態がサービスとユーザーにどう影響するかを示します。
両レイヤーを関連付けることで、アプリケーション障害と基盤となるクラスターの問題を切り分けやすくなります。たとえば、レイテンシの増加は、非効率なアプリケーションコード、CPUスロットリング、メモリ不足、ネットワークの問題、異常のあるノードのいずれかが原因である可能性があります。インフラとアプリケーションのテレメトリーを併せて確認することで、影響を受けているレイヤーの切り分けにかかる時間を短縮できます。
可能であれば依存先も対象に含めるべきです。Kubernetesワークロードは正常に見えても、データベース、キュー、キャッシュ、外部APIによってリクエストが遅延していることがあります。分散トレースとサービスレベルのメトリクスは、こうした依存関係を可視化し、障害やレイテンシの発生源を示します。
リソースリクエストと実際の使用量を比較する
コンテナのCPUおよびメモリのリクエストを、観測されたリソース消費量と比較しましょう。KubernetesはPodのスケジューリングにリクエスト値を使用するため、不正確な値は、ワークロードがノードに配置される効率に直接影響します。実際の使用量を常に上回るリクエストはキャパシティの遊休化を招き、低すぎるリクエストは競合や不安定なパフォーマンスの原因になり得ます。
短時間のスナップショットに頼るのではなく、代表的な期間にわたって使用状況を評価しましょう。通常のトラフィック、ピーク時の需要、デプロイ、バッチジョブ、スケジュール実行されるワークロードを考慮し、リソース設定が現実的な運用条件を反映するようにします。平均値は短時間の高負荷を覆い隠すことがあるため、パーセンタイルに基づく使用量データのほうが有用な場合があります。
リミットはリクエストとは別に評価すべきです。CPUリミットは、ワークロードが追加の処理能力を必要とする際にスロットリングを引き起こす可能性があり、メモリリミットを超えるとOut of Memoryエラーでコンテナが終了させられることがあります。リミット、リクエスト、実際の使用量を比較することで、リソース設定をより包括的に把握できます。
Kubernetesワークロードを継続的にライトサイジングする
リソース要件は、アプリケーションコード、トラフィックパターン、依存関係の変化に伴って変わります。初期値を恒久的な設定として扱うのではなく、CPUとメモリのリクエストとリミットを定期的に見直しましょう。デプロイ時に適切なサイズだったワークロードも、挙動の変化によって過剰プロビジョニングやリソース不足になることがあります。
リソースを調整する際は、過去の使用率、CPUスロットリング、Out of Memoryイベント、レイテンシ、パフォーマンスデータを活用しましょう。ライトサイジングでは、クラスターの効率的な利用と、ワークロードの変動や想定される需要の急増に対応できる十分なキャパシティとのバランスを取る必要があります。変更は、リソース使用率だけでなくアプリケーションのパフォーマンスに照らして検証すべきです。
自動化されたレコメンデーションは、リクエスト値と実際の消費量の乖離が続いているワークロードの特定に役立ちます。ただし、レコメンデーションを適用する前に、起動時の要件、バースト性のあるワークロード、フェイルオーバー用のキャパシティ、サービスレベル目標を考慮する必要があります。
ワークロードレベルでKubernetesを監視する
Podレベルのメトリクスはトラブルシューティングに有用ですが、Podは一時的な実装の詳細にすぎません。Deployment、StatefulSet、DaemonSetといった安定したワークロードオブジェクト単位でテレメトリーを集約し、Podの置き換え、ローリングアップデート、スケーリングイベントをまたいだアプリケーションの挙動を把握しましょう。
ワークロードレベルの監視は、レプリカが頻繁に変化する際のノイズも軽減します。ワークロード全体が劣化しているかどうかを確認したうえで、個々のPod、コンテナ、ノードを調べて原因を切り分けられます。このアプローチは、オートスケーリングによってレプリカの作成と削除が頻繁に行われる場合に特に有効です。
ワークロードとその基盤リソースの関係も保持しましょう。たとえば、ダッシュボードでは、レイテンシの高いDeploymentから、そのPod、コンテナ、ノード、ログ、トレースへとたどれるようにすべきです。Kubernetesのラベルと所有関係のメタデータが、こうした関係を維持するために必要なコンテキストを提供します。
履歴データでリソースのトレンドを把握する
一時的なスパイクと持続的なリソース需要の変化を区別できるだけの履歴テレメトリーを保持しましょう。CPU、メモリ、ストレージ、リクエスト量、ネットワークトラフィック、レプリカ数のトレンドは、即座にアラートを発生させないような緩やかなキャパシティ制約を明らかにすることがあります。
履歴データは、キャパシティプランニングや設定変更にも役立ちます。現在の挙動を過去のデプロイ、トラフィック状況、季節的なピークと比較することで、リソースの増加が想定内なのか、問題の兆候なのかを判断できます。また、リソース設定の変更がパフォーマンスに与える影響を時間の経過とともに確認することもできます。
保持期間は、運用要件と想定されるワークロードのサイクルに基づいて選択しましょう。短期の高解像度データはインシデント調査に有用であり、集約された長期データは、すべての生テレメトリーを保持しなくても、月次や季節単位のトレンド分析に活用できます。
オートスケーリングの挙動を追跡する
水平・垂直オートスケーリングの決定を、それをトリガーするメトリクスと併せて監視しましょう。有用なシグナルとして、希望レプリカ数と現在のレプリカ数、スケーリングの頻度、リソース使用率、Pending状態のPod、レコメンデーションの変化、設定された最小・最大レプリカ数への到達状況などがあります。
頻繁なスケーリングはしきい値が不安定であることを示している可能性があり、最大キャパシティに張り付いているワークロードには、追加リソースやスケーリングポリシーの見直しが必要かもしれません。新しいPodの準備に時間がかかりすぎると、スケールアウトの遅れがレイテンシやエラーの原因になることもあります。スケーリングイベントとアプリケーションのパフォーマンスを関連付けることで、オートスケーリングが需要に効果的に応答しているかどうかを判断できます。
また、クラスターにスケーリングの決定を満たすだけのキャパシティがあるかどうかも監視しましょう。ノードのCPUやメモリが不足してPodがPendingのままでは、希望レプリカ数を増やしても意味がありません。ワークロードのオートスケーリングと併せて、PodのスケジューリングとCluster Autoscalerの動作を追跡することで、スケーリングプロセス全体をより明確に把握できます。
FAQ
Kubernetesオブザーバビリティとは何ですか? Kubernetesオブザーバビリティとは、テレメトリーデータを収集・集約・分析し、クラスターとそのワークロードの内部状態、パフォーマンス、健全性を把握する取り組みです。システムに異常があることを確認するだけでなく、なぜ異常な動作をしているのかを推測できるようになります。
Kubernetesオブザーバビリティとモニタリングの違いは何ですか? モニタリングは、CPU使用率や再起動回数など、事前に定義されたメトリクスや条件を追跡し、しきい値を超えた際にアラートを発します。オブザーバビリティは、メトリクス、ログ、トレース、イベント、Kubernetesメタデータを加えることで、誰も予測していなかった問題を調査できるようにします。モニタリングはオブザーバビリティの一部です。
Kubernetesオブザーバビリティの4つの柱とは何ですか? 4つの柱とは、メトリクス、ログ、トレース、プロファイルです。メトリクスは時間の経過に伴う数値測定、ログはタイムスタンプ付きのイベント記録、トレースはサービスをまたぐリクエストの追跡、プロファイルはアプリケーションコードのCPU・メモリ使用状況を示します。
Kubernetesではなぜオブザーバビリティが難しいのですか? Podは短命なため、Podが置き換えられるとログやランタイムデータが消失することがあります。また、大規模環境では膨大な量のテレメトリーが生成され、複数のクラスターにまたがり、1つのリクエストが多数のサービスを通過するため、シグナルの関連付けが難しくなります。
どのKubernetesメトリクスから監視を始めるべきですか? まずは、CPU使用率とスロットリング、メモリ使用量、Podのステータスと可用性、コンテナの再起動回数、ノードの健全性から始めましょう。また、リソースのリクエストとリミットを実際の使用量と比較しましょう。この比較により、過剰プロビジョニングやリソース不足のワークロードが分かります。
PerfectScaleで実現するKubernetesの完全なオブザーバビリティ
メトリクス、ログ、トレース、プロファイルの収集は、それらのシグナルをコスト、パフォーマンス、安定性に関する意思決定につなげられてこそ価値があります。PerfectScaleは、AIによるインサイトであらゆるクラスターのリスク、無駄、最適化の機会を浮かび上がらせ、死角のない完全なKubernetesの可視性を提供します。オブザーバビリティとモニタリング、そしてクラスター、ネームスペース、ワークロード、ノードグループをまたいだコスト、無駄、パフォーマンスなどのリアルタイム・履歴メトリクスの継続的な分析を組み合わせることで、運用効率と環境の健全性を維持しながら、コストとパフォーマンスをコントロールできます。
PerfectScaleの主な機能:
- 包括的なコストビュー: クラスター、ネームスペース、ワークロード、ラベル別にK8sコストを完全に分解し、環境全体の支出をきめ細かく可視化して最適化の機会を発見します。
- 正確な分析とインサイト: デフォルトの料金体系、またはAWS CUR、Azure Cost Management、GCP Cloud Billingなどの統合カスタムレポートを使用し、請求データとリアルタイム・履歴の使用状況メトリクスを組み合わせて、コストトレンド、無駄、遊休キャパシティ、正確なコスト配分を特定します。
- ポリシー主導の最適化: カスタマイズ可能な最適化ポリシーを適用し、リソース管理をコスト効率の目標とSLA/SLO目標の両方に整合させます。
- AIによる自動化: 柔軟で制御可能なハンズフリーの自動化により、最適化戦略のあらゆる側面をチームの要件に合わせて調整できます。
- 影響度を考慮したアラート: 問題を自動的に優先順位付けし、予算ガードレールを適用します。コストとレジリエンシーの異常検知により、障害や想定外の請求が発生する前にチームへ通知します。
- パフォーマンスとレジリエンシーのインサイト: パフォーマンス、ワークロードの挙動、リソース使用パターンを継続的に分析し、CPUスロットリング、OOM、誤設定されたリクエストとリミット、非効率なスケーリングといったリスクをプロアクティブに検知して、Podの再起動、パフォーマンス劣化、レイテンシ、ダウンタイムの防止に貢献します。
- ワークロードの自律的なライトサイジング: 予測インテリジェンスによるプロアクティブな問題修復を備えた、安全でハンズフリーの最適化により、パフォーマンスを損なうことなく無駄を排除します。
- スマートなスケーリングと予算管理: スケーリング戦略と予算予測を改善し、大規模なDay 2運用を支援します。
- ワークフローとオブザーバビリティの統合: 既存のコラボレーション、チケッティング、オブザーバビリティツールを通じて、開発者、DevOps、プラットフォームエンジニア、FinOpsを統一された最適化エコシステムで結び付けます。