


O que é observabilidade no Kubernetes?
Observabilidade no Kubernetes é o processo de coletar, agregar e analisar dados de telemetria para entender o estado interno, o desempenho e a saúde de um cluster Kubernetes e de seus workloads. Diferente do monitoramento tradicional de infraestrutura, que apenas dispara alertas quando uma linha de base estática de métricas é ultrapassada, a observabilidade permite inferir por que um sistema está se comportando de forma inesperada, oferecendo visibilidade de ponta a ponta sobre microsserviços altamente dinâmicos e efêmeros.
A observabilidade ajuda as equipes a investigar falhas, problemas de desempenho e comportamentos inesperados em um ambiente distribuído. Por exemplo, métricas podem revelar saturação de recursos, logs podem explicar por que um contêiner falhou e traces podem mostrar onde a latência ocorre entre os serviços. Combinar esses sinais facilita identificar a causa raiz em vez de examinar cada componente separadamente.
Os 4 pilares da observabilidade no Kubernetes:
- Métricas: dados quantitativos de séries temporais que medem características do sistema (por exemplo, utilização de CPU, consumo de memória e I/O de rede). No Kubernetes, os componentes as expõem por meio de endpoints
/metrics, geralmente no formato do Prometheus. - Logs: registros de texto em ordem cronológica de eventos gerados por aplicações, pelo control plane (API server, scheduler) ou pelos nós. Essenciais para diagnosticar rastros de erro específicos e falhas em sequência.
- Traces: mapas de ponta a ponta que acompanham como uma única requisição percorre diversos microsserviços e barreiras de infraestrutura. São vitais para identificar gargalos de rede e problemas de latência.
- Profiles: profiling contínuo de desempenho da aplicação (muitas vezes baseado em tecnologia eBPF) que mede CPU/memória até a linha exata de código, sem introduzir overhead de agente.
Este artigo faz parte de uma série sobre monitoramento do Kubernetes
Neste artigo:
- Por que a observabilidade no Kubernetes é importante?
- Observabilidade vs. monitoramento no Kubernetes
- Os 4 pilares da observabilidade no Kubernetes
- Principais métricas de observabilidade do Kubernetes para monitorar
- Desafios da observabilidade no Kubernetes e como superá-los
- Boas práticas de observabilidade no Kubernetes
Por que a observabilidade no Kubernetes é importante?
Ambientes Kubernetes são dinâmicos. Pods reiniciam, workloads migram entre nós e recursos escalam automaticamente. A observabilidade dá às equipes os dados necessários para entender essas mudanças e detectar problemas antes que afetem os usuários.
- Resolução de problemas mais rápida: métricas, logs e traces ajudam as equipes a identificar onde as falhas ocorrem e determinar a causa raiz.
- Monitoramento de desempenho: a observabilidade mostra uso de recursos, latência da aplicação, taxas de erro e outros sinais que podem revelar gargalos de desempenho.
- Otimização de recursos: dados de CPU, memória e armazenamento ajudam as equipes a encontrar workloads superprovisionados ou limitados e a ajustar requests e limits de recursos.
- Mais confiabilidade: monitorar a saúde do cluster e das aplicações ajuda a detectar pods com falha, serviços indisponíveis, problemas em nós e outras condições que podem reduzir a disponibilidade.
- Melhor visibilidade de sistemas distribuídos: aplicações em Kubernetes costumam abranger muitos pods e serviços. A observabilidade conecta sinais entre esses componentes, tornando dependências e fluxos de requisições mais fáceis de entender.
- Planejamento de capacidade: dados históricos de uso e desempenho ajudam as equipes a estimar necessidades futuras de infraestrutura e a tomar decisões de escalabilidade embasadas.
Observabilidade vs. monitoramento no Kubernetes
O monitoramento acompanha métricas e condições predefinidas para determinar se os componentes do Kubernetes estão operando como esperado. As equipes normalmente usam dashboards e alertas para observar sinais como uso de CPU, disponibilidade de pods, contagem de reinicializações e latência de requisições. Ele funciona bem para detectar condições de falha conhecidas e responder a perguntas que as equipes já previam ao configurar o sistema de monitoramento.
A observabilidade oferece um contexto mais amplo para investigar problemas que não foram previstos com antecedência. Ela combina métricas, logs, traces, eventos e metadados do Kubernetes para ajudar as equipes a explorar as relações entre workloads e infraestrutura. Por exemplo, o monitoramento pode alertar que a latência das requisições aumentou, enquanto a observabilidade pode ajudar a determinar se a causa é um serviço downstream lento, throttling de recursos ou um nó com falha.
O monitoramento é, portanto, uma parte da observabilidade no Kubernetes, e não uma alternativa separada. Ele identifica sintomas com base em sinais conhecidos, enquanto a observabilidade fornece os dados e o contexto necessários para investigar tanto comportamentos conhecidos quanto inesperados.
Conteúdo relacionado: leia nosso artigo sobre ferramentas de monitoramento do Kubernetes
Os 4 pilares da observabilidade no Kubernetes
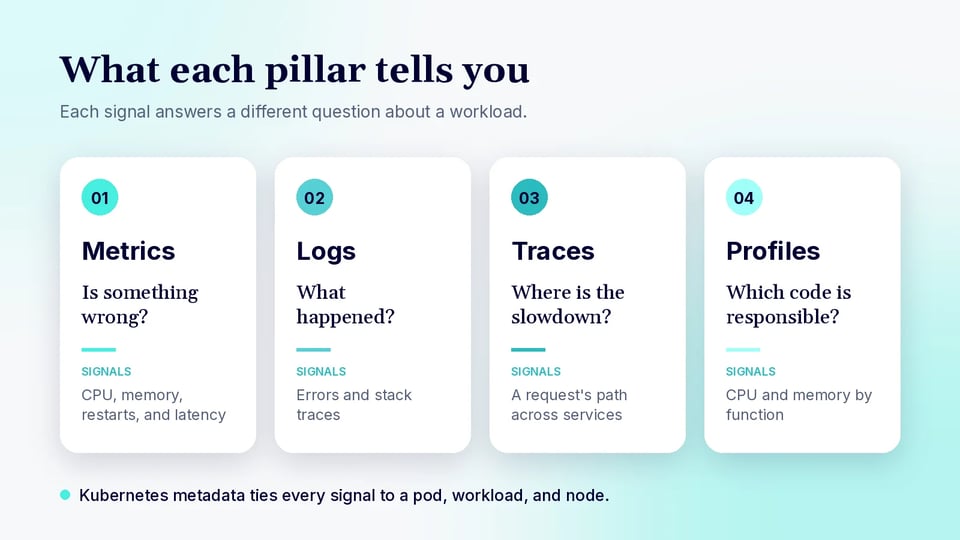
Tradicionalmente, a observabilidade se baseava em três pilares: métricas, logs e traces. No entanto, em ambientes nativos da nuvem, cresce o uso de um quarto elemento: os profiles.
1. Métricas
Métricas são medições numéricas coletadas ao longo do tempo da infraestrutura e das aplicações do Kubernetes. Exemplos comuns incluem uso de CPU e memória, contagem de reinicializações de pods, taxas de requisições, taxas de erro e latência de resposta. Métricas são eficientes para agregar e consultar, o que as torna úteis para dashboards, alertas, planejamento de capacidade e detecção de mudanças no comportamento do sistema.
As métricas do Kubernetes podem vir de nós, contêineres, componentes do control plane e aplicações. Labels e outros metadados do Kubernetes fornecem contexto, como namespace, workload, pod e nó, ajudando as equipes a determinar quais recursos estão associados a um problema de desempenho ou confiabilidade.
2. Logs
Logs são registros com carimbo de data e hora de eventos gerados por aplicações, contêineres, componentes do Kubernetes e pela infraestrutura subjacente. Podem conter mensagens de erro, stack traces, detalhes de requisições, mudanças de estado e outras informações que explicam o que aconteceu em um momento específico.
Como os pods podem ter vida curta, depender de logs armazenados dentro dos contêineres pode dificultar investigações históricas. A coleta centralizada de logs preserva os registros fora do ciclo de vida do pod e os torna pesquisáveis em todos os workloads. Adicionar metadados do Kubernetes, como pod, namespace, contêiner e nó, também ajuda as equipes a correlacionar as entradas de log com os recursos que as produziram.
3. Traces
Traces registram como requisições individuais percorrem aplicações distribuídas. Um trace é composto por spans que representam operações realizadas por serviços, bancos de dados, filas e outros componentes. Cada span pode incluir informações de tempo, status, atributos e relações com outros spans.
O tracing é particularmente útil em ambientes Kubernetes construídos com microsserviços. Quando uma requisição está lenta ou falha, as equipes podem seguir seu caminho pelos serviços para identificar a operação responsável. Os dados de trace também podem ser correlacionados com métricas e logs para conectar sintomas no nível da aplicação a informações detalhadas de diagnóstico.
4. Profiles
Profiles medem como uma aplicação consome recursos enquanto seu código é executado. Profilers podem amostrar uso de CPU, alocações de memória, contenção de locks e outros comportamentos em tempo de execução e, em seguida, associar o consumo de recursos a funções ou caminhos de código específicos.
O profiling contínuo estende essa análise aos workloads de produção ao longo do tempo. Ele pode revelar código que consome CPU ou memória em excesso mesmo quando as métricas de infraestrutura mostram apenas que um pod está com recursos limitados. Combinados com métricas, logs e traces, os profiles ajudam as equipes a ir da identificação de um workload afetado à localização de código ineficiente na aplicação.
Principais métricas de observabilidade do Kubernetes para monitorar
O Kubernetes produz métricas em várias camadas, da infraestrutura do cluster às aplicações individuais. Monitorar um conjunto focado de métricas ajuda as equipes a detectar restrições de recursos, falhas de workloads, problemas de escalabilidade e questões de desempenho das aplicações.
| Métrica | O que mede | Por que importa |
|---|---|---|
| Uso de CPU e throttling | CPU consumida por nós, pods e contêineres, além de indicar se os limits de CPU estão causando throttling nos workloads | Identifica restrições de recursos e workloads limitados por limits de CPU |
| Uso de memória | Memória consumida por workloads e nós | Ajuda a detectar workloads próximos dos limits ou nós sob pressão de memória |
| Status e disponibilidade dos pods | Pods em execução, pendentes, com falha e indisponíveis | Revela problemas de deployment, agendamento ou disponibilidade |
| Contagem de reinicializações de contêineres | Número de vezes que os contêineres reiniciam | Indica crashes, health checks com falha ou problemas de limits de recursos |
| Saúde dos nós e utilização de recursos | Prontidão dos nós, CPU, memória, uso de disco e pressão de recursos | Detecta problemas de infraestrutura que afetam a estabilidade do cluster |
| Requests e limits de recursos | Recursos solicitados e limitados em comparação com o uso real | Identifica workloads superprovisionados ou limitados |
| Tráfego de rede e erros | Volume de tráfego, erros de pacotes e pacotes descartados | Ajuda a diagnosticar problemas de conectividade e desempenho de rede |
| Taxa de requisições, erros e latência | Tráfego da aplicação, requisições com falha e tempos de resposta | Mede a saúde dos serviços e o desempenho percebido pelo usuário |
| Uso de volumes persistentes | Capacidade e utilização de armazenamento | Identifica volumes em risco de ficar sem espaço |
| Métricas do control plane do Kubernetes | Latência, erros e sinais de saúde do API server, do scheduler e do etcd | Detecta problemas no control plane que podem afetar as operações do cluster |
Conteúdo relacionado: leia nosso artigo sobre alertas no Kubernetes
Desafios da observabilidade no Kubernetes e como superá-los
Workloads efêmeros e de vida curta
O Kubernetes cria, substitui e remove pods com frequência conforme as aplicações escalam, os deployments mudam ou ocorrem falhas. Quando um pod desaparece, logs armazenados localmente e informações de runtime podem desaparecer junto. Isso pode dificultar a investigação de falhas depois que o workload afetado deixa de existir.
Os sistemas de observabilidade precisam coletar telemetria continuamente e armazená-la fora dos workloads individuais. Metadados do Kubernetes, como nome do pod, namespace, deployment, nó e labels, podem preservar o contexto necessário para analisar eventos mesmo depois que os recursos foram substituídos.
Como superar:
- Colete logs, métricas, traces e eventos continuamente, em vez de depender de telemetria armazenada dentro dos pods.
- Envie a telemetria para um armazenamento centralizado que persista independentemente dos ciclos de vida de pods e nós.
- Enriqueça a telemetria com metadados do Kubernetes, como namespace, workload, pod, contêiner, nó e labels.
- Monitore eventos do ciclo de vida dos pods, reinicializações de contêineres, evictions e motivos de encerramento para preservar o contexto das falhas.
- Use identificadores estáveis de workloads, como nomes de deployment ou statefulset, ao consultar telemetria histórica.
Grandes volumes de logs e dados de telemetria
Ambientes Kubernetes de grande porte podem gerar volumes consideráveis de métricas, logs, traces e profiles. O autoscaling e as arquiteturas de microsserviços aumentam o número de fontes de telemetria, enquanto labels de alta cardinalidade, como IDs de pods, podem elevar significativamente os custos de armazenamento e consulta.
As equipes precisam controlar o volume de telemetria sem remover dados necessários para a resolução de problemas. Abordagens comuns incluem filtragem de logs, amostragem de traces, agregação de métricas, políticas de retenção e limitação de atributos de alta cardinalidade desnecessários. As políticas de coleta devem priorizar sinais que forneçam informações operacionais úteis.
Como superar:
- Filtre logs repetitivos e de baixo valor na camada de coleta antes de enviá-los ao armazenamento centralizado.
- Use amostragem de traces para reter requisições representativas, capturando erros e traces de alta latência em taxas maiores.
- Agregue métricas quando dados detalhados por pod ou por contêiner não forem necessários.
- Limite labels e atributos de alta cardinalidade, especialmente identificadores que criam uma série temporal única para cada requisição ou recurso.
- Defina políticas de retenção por tipo de telemetria e valor operacional, mantendo dados de alta resolução apenas pelo tempo necessário para a resolução de problemas.
Visibilidade multicluster
As organizações costumam operar vários clusters Kubernetes em diferentes regiões, provedores de nuvem, ambientes ou unidades de negócio. Observar cada cluster de forma independente cria dashboards fragmentados e dificulta comparar desempenho, investigar dependências compartilhadas ou entender incidentes que afetam todo o sistema.
Centralizar ou federar a telemetria pode proporcionar uma visão consistente entre os clusters. Identificadores de cluster e labels padronizados ajudam a distinguir recursos e dão suporte a consultas entre clusters. As equipes também precisam considerar conectividade de rede, residência de dados, controles de acesso e o custo de transferir telemetria entre ambientes.
Como superar:
- Centralize ou federe a telemetria de vários clusters para que as equipes possam consultar e comparar ambientes a partir de uma interface comum.
- Aplique labels consistentes de cluster, região, ambiente, namespace e workload em todas as fontes de telemetria.
- Padronize dashboards, alertas e políticas de coleta de telemetria entre clusters com requisitos operacionais semelhantes.
- Aplique controles de acesso para que os usuários vejam apenas os clusters e a telemetria relevantes para suas responsabilidades.
- Considere residência de dados, largura de banda da rede, disponibilidade e custos de transferência de telemetria ao escolher onde os dados serão armazenados e processados.
Correlação de dados entre microsserviços
Uma única requisição de usuário pode passar por muitos serviços, pods, bancos de dados e filas. As métricas podem mostrar que um serviço está lento, enquanto o erro relevante aparece nos logs de outro serviço. Sem contexto compartilhado, as equipes precisam conectar manualmente sinais de sistemas diferentes.
Metadados de serviço consistentes e identificadores, como IDs de trace e de requisição, facilitam a correlação. O tracing distribuído pode conectar operações entre os limites dos serviços, enquanto os metadados do Kubernetes vinculam a telemetria da aplicação a pods e nós. Isso permite que as equipes partam de um sintoma de alto nível até chegar ao serviço, workload ou componente de infraestrutura específico envolvido.
Como superar:
- Propague IDs de trace e de requisição entre os limites dos serviços para que a telemetria gerada pela mesma requisição possa ser conectada.
- Use tracing distribuído para acompanhar requisições entre serviços, bancos de dados, filas e outras dependências.
- Aplique nomes de serviço e metadados do Kubernetes consistentes a métricas, logs e traces.
- Inclua identificadores de trace e span nos logs da aplicação para que os engenheiros possam navegar diretamente entre traces e entradas de log relacionadas.
- Preserve o contexto de workload, pod, contêiner e nó para que falhas no nível da aplicação possam ser correlacionadas com as condições da infraestrutura do Kubernetes.
Boas práticas de observabilidade no Kubernetes
Monitore o desempenho da infraestrutura e das aplicações
Monitore a infraestrutura do Kubernetes junto com as aplicações que rodam nela. CPU dos nós, pressão de memória, uso de disco, status dos pods, condições de rede e métricas do control plane podem revelar problemas de infraestrutura. Latência de requisições, taxas de erro, throughput, logs de aplicação e traces mostram como essas condições afetam serviços e usuários.
Correlacionar as duas camadas ajuda a distinguir falhas de aplicação de problemas subjacentes do cluster. Por exemplo, o aumento da latência pode resultar de código de aplicação ineficiente, throttling de CPU, memória insuficiente, problemas de rede ou um nó não íntegro. Analisar a telemetria de infraestrutura e de aplicação em conjunto reduz o tempo necessário para isolar a camada afetada.
As dependências também devem ser incluídas sempre que possível. Um workload do Kubernetes pode parecer saudável enquanto as requisições são atrasadas por um banco de dados, uma fila, um cache ou uma API externa. Traces distribuídos e métricas no nível de serviço ajudam a expor essas dependências e mostram onde as falhas ou a latência se originam.
Compare os requests de recursos com o uso real
Compare os requests de CPU e memória dos contêineres com o consumo de recursos observado. O Kubernetes usa os requests ao agendar pods, então valores imprecisos afetam diretamente a eficiência com que os workloads são alocados nos nós. Requests que excedem consistentemente o uso real podem deixar capacidade ociosa, enquanto requests muito baixos podem contribuir para contenção e desempenho instável.
Avalie o uso em períodos representativos, em vez de depender de capturas pontuais. Considere tráfego normal, picos de demanda, deployments, jobs em lote e workloads agendados, para que as configurações de recursos reflitam condições reais de operação. Dados de uso baseados em percentis podem ser mais úteis do que médias, já que as médias podem ocultar períodos curtos de alta demanda.
Os limits devem ser avaliados separadamente dos requests. Limits de CPU podem causar throttling quando os workloads precisam de capacidade adicional de processamento, enquanto exceder um limit de memória pode encerrar um contêiner com um erro de out-of-memory. Comparar limits, requests e uso real oferece uma visão mais completa da configuração de recursos.
Faça right-sizing contínuo dos workloads Kubernetes
Os requisitos de recursos mudam conforme o código da aplicação, os padrões de tráfego e as dependências evoluem. Revise os requests e limits de CPU e memória regularmente, em vez de tratar os valores iniciais como configuração permanente. Um workload dimensionado corretamente no momento do deployment pode ficar superprovisionado ou limitado à medida que seu comportamento muda.
Use utilização histórica, throttling de CPU, eventos de out-of-memory, latência e dados de desempenho ao ajustar recursos. O right-sizing deve equilibrar a utilização eficiente do cluster com capacidade suficiente para a variabilidade dos workloads e os picos de demanda esperados. As mudanças também devem ser validadas em relação ao desempenho da aplicação, e não apenas à utilização de recursos.
Recomendações automatizadas podem ajudar a identificar workloads com diferenças persistentes entre recursos solicitados e consumidos. No entanto, as equipes devem considerar requisitos de inicialização, workloads com picos repentinos, capacidade de failover e objetivos de nível de serviço antes de aplicar as recomendações.
Monitore o Kubernetes no nível do workload
Métricas no nível de pod são úteis para a resolução de problemas, mas pods são detalhes de implementação temporários. Agregue a telemetria por objetos estáveis de workload, como deployments, statefulsets e daemonsets, para entender o comportamento da aplicação ao longo de substituições de pods, rolling updates e eventos de escalonamento.
O monitoramento no nível do workload também reduz o ruído quando as réplicas mudam com frequência. As equipes podem identificar se um workload inteiro está degradado e, em seguida, inspecionar pods, contêineres ou nós individuais para isolar a causa. Essa abordagem é especialmente útil quando o autoscaling cria e remove réplicas com frequência.
Preserve as relações entre os workloads e seus recursos subjacentes. Por exemplo, os dashboards devem permitir ir de um deployment com alta latência aos seus pods, contêineres, nós, logs e traces. Labels e metadados de propriedade do Kubernetes fornecem o contexto necessário para manter essas relações.
Use dados históricos para identificar tendências de recursos
Mantenha telemetria histórica suficiente para distinguir picos temporários de mudanças sustentadas na demanda de recursos. Tendências de CPU, memória, armazenamento, volume de requisições, tráfego de rede e número de réplicas podem revelar restrições graduais de capacidade que talvez não disparem alertas imediatos.
Os dados históricos também dão suporte ao planejamento de capacidade e a mudanças de configuração. Comparar o comportamento atual com deployments anteriores, períodos de tráfego ou picos sazonais ajuda as equipes a determinar se o crescimento no uso de recursos é esperado ou indica um problema. Também pode mostrar como mudanças nas configurações de recursos afetam o desempenho ao longo do tempo.
Escolha períodos de retenção com base nos requisitos operacionais e nos ciclos esperados dos workloads. Dados de alta resolução de curto prazo são úteis para investigar incidentes, enquanto dados agregados de longo prazo podem apoiar análises de tendências mensais ou sazonais sem reter cada ponto bruto de telemetria.
Acompanhe o comportamento do autoscaling
Monitore as decisões de autoscaling horizontal e vertical junto com as métricas que as acionam. Sinais úteis incluem número desejado e atual de réplicas, frequência de escalonamento, utilização de recursos, pods pendentes, mudanças nas recomendações e se os números mínimo ou máximo de réplicas configurados estão sendo atingidos.
Escalonamentos frequentes podem indicar limiares instáveis, enquanto workloads travados na capacidade máxima podem exigir recursos adicionais ou políticas de escalonamento revisadas. Um scale-out lento também pode causar latência ou erros se os novos pods demorarem demais para ficar prontos. Correlacionar eventos de escalonamento com o desempenho da aplicação ajuda a determinar se o autoscaling está respondendo de forma eficaz à demanda.
Monitore também se o cluster tem capacidade suficiente para atender às decisões de escalonamento. Aumentar o número desejado de réplicas não adianta se os pods continuarem pendentes porque os nós não têm CPU ou memória. Acompanhar o agendamento de pods e a atividade do cluster autoscaler junto com o autoscaling dos workloads oferece uma visão mais clara do processo completo de escalonamento.
Perguntas frequentes
O que é observabilidade no Kubernetes? Observabilidade no Kubernetes é a prática de coletar, agregar e analisar dados de telemetria para entender o estado interno, o desempenho e a saúde de um cluster e de seus workloads. Ela permite que as equipes infiram por que um sistema está se comportando de forma inesperada, e não apenas constatem que algo está errado.
Qual é a diferença entre observabilidade e monitoramento no Kubernetes? O monitoramento acompanha métricas e condições predefinidas, como uso de CPU ou contagem de reinicializações, e gera alertas quando são ultrapassadas. A observabilidade adiciona métricas, logs, traces, eventos e metadados do Kubernetes para que as equipes possam investigar problemas que ninguém previu. O monitoramento é uma parte da observabilidade.
Quais são os quatro pilares da observabilidade no Kubernetes? Os quatro pilares são métricas, logs, traces e profiles. Métricas são medições numéricas ao longo do tempo, logs são registros de eventos com carimbo de data e hora, traces acompanham uma requisição entre serviços e profiles mostram como o código da aplicação usa CPU e memória.
Por que a observabilidade é mais difícil no Kubernetes? Pods têm vida curta, então logs e dados de runtime podem desaparecer quando um pod é substituído. Ambientes grandes também produzem enormes volumes de telemetria, abrangem vários clusters e enviam uma única requisição por muitos serviços, o que torna difícil conectar os sinais.
Quais métricas do Kubernetes devo monitorar primeiro? Comece com uso de CPU e throttling, uso de memória, status e disponibilidade dos pods, contagem de reinicializações de contêineres e saúde dos nós. Compare também os requests e limits de recursos com o uso real, já que essa comparação revela workloads superprovisionados e limitados.
Observabilidade completa do Kubernetes com a PerfectScale
Coletar métricas, logs, traces e profiles só é útil se as equipes conseguirem transformar esses sinais em decisões sobre custo, desempenho e estabilidade. A PerfectScale oferece visibilidade total do Kubernetes, sem pontos cegos, usando insights guiados por IA que revelam riscos, desperdícios e oportunidades de otimização em todos os clusters. Ela combina observabilidade, monitoramento e análise contínua de custo, desperdício, desempenho e outras métricas em tempo real e históricas em clusters, namespaces, workloads e grupos de nós, para que as equipes mantenham custos e desempenho sob controle, preservando a eficiência operacional e a saúde do ambiente.
Principais recursos da PerfectScale:
- Visão holística de custos: fornece uma análise completa dos custos de K8s por cluster, namespace, workload e label, revelando oportunidades de otimização com visibilidade granular dos gastos em todo o ambiente.
- Análises e insights precisos: usa preços padrão ou um relatório personalizado integrado, como AWS CUR, Azure Cost Management ou GCP Cloud Billing, para combinar dados de faturamento com métricas de uso em tempo real e históricas e identificar tendências de custo, desperdício, capacidade ociosa e alocação precisa de custos.
- Otimização orientada por políticas: aplica políticas de otimização personalizáveis para que o gerenciamento de recursos esteja alinhado às metas de SLA/SLO e aos objetivos de eficiência de custos.
- Automação guiada por IA: habilita automação flexível, controlada e sem intervenção manual, permitindo que as equipes personalizem todos os aspectos da estratégia de otimização.
- Alertas sensíveis ao impacto: prioriza problemas automaticamente e aplica guardrails de orçamento, além de detecção de anomalias de custo e resiliência que mantém as equipes informadas antes que ocorram interrupções ou faturas inesperadas.
- Insights de desempenho e resiliência: analisa continuamente desempenho, comportamento dos workloads e padrões de uso de recursos para detectar riscos de forma proativa, como throttling de CPU, OOM, requests e limits mal configurados ou escalonamento ineficiente, ajudando a evitar reinicializações de pods, degradação de desempenho, latência e indisponibilidade.
- Right-sizing autônomo de workloads: elimina desperdícios sem comprometer o desempenho por meio de uma otimização segura e sem intervenção manual, com correção proativa de problemas guiada por inteligência preditiva.
- Escalonamento e orçamento inteligentes: aprimora a estratégia de escalonamento e a previsão de orçamento para dar suporte a operações de day-2 em escala.
- Integrações de workflow e observabilidade: conecta desenvolvedores, DevOps, engenheiros de plataforma e FinOps por meio das ferramentas existentes de colaboração, tickets e observabilidade em um ecossistema de otimização unificado.
Saiba mais sobre visibilidade e governança do Kubernetes guiadas por IA com a PerfectScale