


Was ist Kubernetes Observability?
Kubernetes Observability bezeichnet den Prozess, Telemetriedaten zu erfassen, zu aggregieren und zu analysieren, um den internen Zustand, die Performance und die Gesundheit eines Kubernetes-Clusters und seiner Workloads zu verstehen. Anders als klassisches Infrastruktur-Monitoring, das lediglich Alarm schlägt, wenn ein statischer Schwellenwert überschritten wird, lässt sich mit Observability nachvollziehen, warum sich ein System fehlerhaft verhält – dank durchgängiger Transparenz über hochdynamische, kurzlebige Microservices hinweg.
Observability hilft Teams, Ausfälle, Performance-Probleme und unerwartetes Verhalten in verteilten Umgebungen zu untersuchen. Metriken können etwa eine Ressourcensättigung aufzeigen, Logs erklären, warum ein Container ausgefallen ist, und Traces zeigen, wo über Services hinweg Latenz entsteht. Die Kombination dieser Signale erleichtert es, die Ursache zu identifizieren, statt jede Komponente einzeln zu untersuchen.
Die 4 Säulen der Kubernetes Observability:
- Metriken: Quantitative Zeitreihendaten, die Systemeigenschaften messen (z. B. CPU-Auslastung, Speicherbedarf und Netzwerk-I/O). In Kubernetes stellen Komponenten diese über
/metrics-Endpunkte bereit, meist im Prometheus-Format. - Logs: Chronologische Textaufzeichnungen von Ereignissen, die von Anwendungen, der Control Plane (API-Server, Scheduler) oder Nodes erzeugt werden. Unverzichtbar für die Diagnose konkreter Fehler-Traces und Ablauffehler.
- Traces: Verfolgen End-to-End, wie eine einzelne Anfrage verschiedene Microservices und Infrastrukturgrenzen durchläuft. Sie sind entscheidend, um Netzwerk-Engpässe und Latenzprobleme zu identifizieren.
- Profile: Kontinuierliches Application Performance Profiling (oft auf Basis von eBPF-Technologie), das CPU und Speicher bis auf die exakte Codezeile misst – ohne Agent-Overhead.
Dieser Artikel ist Teil einer Serie über Kubernetes-Monitoring
In diesem Artikel:
- Warum ist Kubernetes Observability wichtig?
- Kubernetes Observability vs. Monitoring
- 4 Säulen der Kubernetes Observability
- Die wichtigsten Kubernetes-Observability-Metriken
- Herausforderungen der Kubernetes Observability und wie Sie sie meistern
- Best Practices für Kubernetes Observability
Warum ist Kubernetes Observability wichtig?
Kubernetes-Umgebungen sind dynamisch: Pods starten neu, Workloads wandern zwischen Nodes, und Ressourcen skalieren automatisch. Observability liefert Teams die Daten, um diese Veränderungen zu verstehen und Probleme zu erkennen, bevor sie sich auf Nutzer auswirken.
- Schnelleres Troubleshooting: Metriken, Logs und Traces helfen Teams zu erkennen, wo Fehler auftreten, und deren Ursache zu ermitteln.
- Performance-Monitoring: Observability zeigt Ressourcenverbrauch, Anwendungslatenz, Fehlerraten und weitere Signale, die Performance-Engpässe sichtbar machen.
- Ressourcenoptimierung: Daten zu CPU, Speicher und Storage helfen Teams, überprovisionierte oder zu knapp dimensionierte Workloads zu finden und Resource Requests und Limits anzupassen.
- Höhere Zuverlässigkeit: Das Monitoring von Cluster- und Anwendungszustand hilft Teams, fehlerhafte Pods, nicht verfügbare Services, Node-Probleme und andere Zustände zu erkennen, die die Verfügbarkeit beeinträchtigen können.
- Mehr Transparenz in verteilten Systemen: Kubernetes-Anwendungen erstrecken sich oft über viele Pods und Services. Observability verknüpft die Signale dieser Komponenten und macht Abhängigkeiten und Request-Flows leichter verständlich.
- Kapazitätsplanung: Historische Nutzungs- und Performance-Daten helfen Teams, künftigen Infrastrukturbedarf abzuschätzen und fundierte Skalierungsentscheidungen zu treffen.
Kubernetes Observability vs. Monitoring
Monitoring verfolgt vordefinierte Metriken und Bedingungen, um festzustellen, ob Kubernetes-Komponenten wie erwartet funktionieren. Teams nutzen dafür typischerweise Dashboards und Alerts, um Signale wie CPU-Auslastung, Pod-Verfügbarkeit, Neustart-Zahlen und Request-Latenz im Blick zu behalten. Das funktioniert gut, um bekannte Fehlerzustände zu erkennen und Fragen zu beantworten, die Teams bei der Konfiguration des Monitoring-Systems vorhergesehen haben.
Observability liefert einen breiteren Kontext, um Probleme zu untersuchen, die nicht im Voraus absehbar waren. Sie kombiniert Metriken, Logs, Traces, Events und Kubernetes-Metadaten, damit Teams die Zusammenhänge zwischen Workloads und Infrastruktur erkunden können. Monitoring kann beispielsweise melden, dass die Request-Latenz gestiegen ist – Observability hilft herauszufinden, ob die Ursache ein langsamer nachgelagerter Service, Resource Throttling oder ein ausfallender Node ist.
Monitoring ist damit ein Teil von Kubernetes Observability und keine separate Alternative. Monitoring identifiziert Symptome auf Basis bekannter Signale, während Observability die Daten und den Kontext liefert, um sowohl bekanntes als auch unerwartetes Verhalten zu untersuchen.
Weiterführende Inhalte: Lesen Sie unseren Artikel über Kubernetes-Monitoring-Tools
4 Säulen der Kubernetes Observability
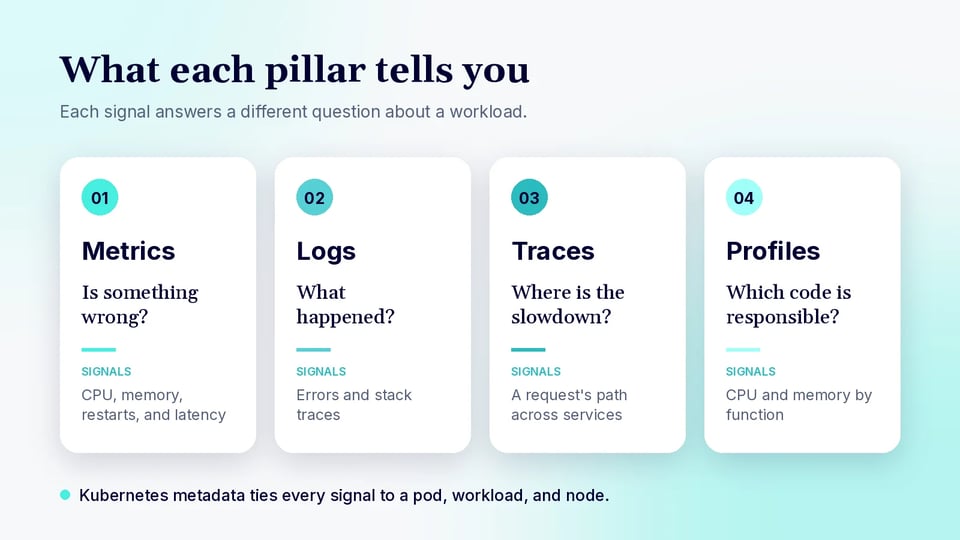
Traditionell basierte Observability auf drei Säulen: Metriken, Logs und Traces. In cloud-nativen Umgebungen kommt jedoch zunehmend ein viertes Element zum Einsatz: Profile.
1. Metriken
Metriken sind numerische Messwerte, die über die Zeit von Kubernetes-Infrastruktur und Anwendungen erfasst werden. Gängige Beispiele sind CPU- und Speicherauslastung, Pod-Neustarts, Request-Raten, Fehlerraten und Antwortlatenz. Metriken lassen sich effizient aggregieren und abfragen und eignen sich daher für Dashboards, Alerts, Kapazitätsplanung und das Erkennen von Verhaltensänderungen im System.
Kubernetes-Metriken können von Nodes, Containern, Control-Plane-Komponenten und Anwendungen stammen. Labels und andere Kubernetes-Metadaten liefern Kontext wie Namespace, Workload, Pod und Node und helfen Teams festzustellen, welche Ressourcen mit einem Performance- oder Zuverlässigkeitsproblem zusammenhängen.
2. Logs
Logs sind mit Zeitstempeln versehene Aufzeichnungen von Ereignissen, die von Anwendungen, Containern, Kubernetes-Komponenten und der zugrunde liegenden Infrastruktur erzeugt werden. Sie können Fehlermeldungen, Stack-Traces, Request-Details, Zustandsänderungen und andere Informationen enthalten, die erklären, was zu einem bestimmten Zeitpunkt passiert ist.
Da Pods kurzlebig sein können, erschwert die Ablage von Logs innerhalb von Containern die nachträgliche Analyse. Eine zentrale Log-Sammlung bewahrt Logs unabhängig vom Pod-Lebenszyklus auf und macht sie Workload-übergreifend durchsuchbar. Kubernetes-Metadaten wie Pod, Namespace, Container und Node helfen Teams zudem, Log-Einträge den Ressourcen zuzuordnen, die sie erzeugt haben.
3. Traces
Traces zeichnen auf, wie einzelne Anfragen durch verteilte Anwendungen laufen. Ein Trace besteht aus Spans, die Operationen von Services, Datenbanken, Queues und anderen Komponenten repräsentieren. Jeder Span kann Zeitinformationen, Status, Attribute und Beziehungen zu anderen Spans enthalten.
Tracing ist besonders nützlich in Kubernetes-Umgebungen, die aus Microservices bestehen. Wenn eine Anfrage langsam ist oder fehlschlägt, können Teams ihren Weg über die Services hinweg verfolgen und die verantwortliche Operation identifizieren. Trace-Daten lassen sich zudem mit Metriken und Logs korrelieren, um Symptome auf Anwendungsebene mit detaillierten Diagnoseinformationen zu verknüpfen.
4. Profile
Profile messen, wie eine Anwendung Ressourcen verbraucht, während ihr Code ausgeführt wird. Profiler können CPU-Nutzung, Speicherallokationen, Lock Contention und anderes Laufzeitverhalten samplen und den Ressourcenverbrauch anschließend konkreten Funktionen oder Codepfaden zuordnen.
Continuous Profiling erweitert diese Analyse über Produktions-Workloads hinweg über die Zeit. Es kann Code aufdecken, der übermäßig viel CPU oder Speicher verbraucht – selbst wenn Infrastruktur-Metriken nur zeigen, dass ein Pod an seine Ressourcengrenzen stößt. In Kombination mit Metriken, Logs und Traces helfen Profile Teams, vom betroffenen Workload direkt zum ineffizienten Anwendungscode zu gelangen.
Die wichtigsten Kubernetes-Observability-Metriken
Kubernetes erzeugt Metriken auf mehreren Ebenen – von der Cluster-Infrastruktur bis zu einzelnen Anwendungen. Das Monitoring eines fokussierten Metrik-Sets hilft Teams, Ressourcenengpässe, Workload-Ausfälle, Skalierungsprobleme und Performance-Probleme von Anwendungen zu erkennen.
| Metrik | Was sie misst | Warum sie wichtig ist |
|---|---|---|
| CPU-Auslastung und Throttling | Von Nodes, Pods und Containern verbrauchte CPU sowie ob CPU-Limits Workloads drosseln | Identifiziert Ressourcenengpässe und Workloads, die durch CPU-Limits eingeschränkt werden |
| Speicherauslastung | Von Workloads und Nodes verbrauchter Speicher | Hilft, Workloads nahe am Limit oder Nodes unter Speicherdruck zu erkennen |
| Pod-Status und -Verfügbarkeit | Laufende, ausstehende, fehlgeschlagene und nicht verfügbare Pods | Deckt Deployment-, Scheduling- oder Verfügbarkeitsprobleme auf |
| Container-Neustarts | Anzahl der Container-Neustarts | Weist auf Abstürze, fehlgeschlagene Health Checks oder Probleme mit Ressourcen-Limits hin |
| Node-Zustand und Ressourcenauslastung | Node-Readiness, CPU, Speicher, Festplattennutzung und Ressourcendruck | Erkennt Infrastrukturprobleme, die die Cluster-Stabilität beeinträchtigen |
| Resource Requests und Limits | Angeforderte und limitierte Ressourcen im Vergleich zur tatsächlichen Nutzung | Identifiziert überprovisionierte oder zu knapp dimensionierte Workloads |
| Netzwerkverkehr und -fehler | Traffic-Volumen, Paketfehler und verworfene Pakete | Hilft bei der Diagnose von Konnektivitäts- und Netzwerk-Performance-Problemen |
| Request-Rate, Fehler und Latenz | Anwendungs-Traffic, fehlgeschlagene Requests und Antwortzeiten | Misst den Service-Zustand und die nutzerseitige Performance |
| Nutzung von Persistent Volumes | Speicherkapazität und -auslastung | Identifiziert Volumes, denen der Speicherplatz auszugehen droht |
| Kubernetes-Control-Plane-Metriken | Latenz, Fehler und Health-Signale von API-Server, Scheduler und etcd | Erkennt Control-Plane-Probleme, die den Cluster-Betrieb beeinträchtigen können |
Weiterführende Inhalte: Lesen Sie unseren Artikel über Kubernetes-Alerting
Herausforderungen der Kubernetes Observability und wie Sie sie meistern
Kurzlebige und flüchtige Workloads
Kubernetes erstellt, ersetzt und entfernt Pods laufend, wenn Anwendungen skalieren, Deployments sich ändern oder Fehler auftreten. Verschwindet ein Pod, können lokal gespeicherte Logs und Laufzeitinformationen mit ihm verschwinden. Das erschwert die Untersuchung von Fehlern, wenn der betroffene Workload nicht mehr existiert.
Observability-Systeme müssen Telemetrie kontinuierlich erfassen und außerhalb einzelner Workloads speichern. Kubernetes-Metadaten wie Pod-Name, Namespace, Deployment, Node und Labels bewahren den Kontext, der für die Analyse von Ereignissen nötig ist – auch nachdem Ressourcen ersetzt wurden.
So meistern Sie die Herausforderung:
- Erfassen Sie Logs, Metriken, Traces und Events kontinuierlich, statt sich auf in Pods gespeicherte Telemetrie zu verlassen.
- Senden Sie Telemetrie an einen zentralen Speicher, der unabhängig vom Lebenszyklus von Pods und Nodes besteht.
- Reichern Sie Telemetrie mit Kubernetes-Metadaten wie Namespace, Workload, Pod, Container, Node und Labels an.
- Überwachen Sie Pod-Lifecycle-Events, Container-Neustarts, Evictions und Terminierungsgründe, um den Fehlerkontext zu bewahren.
- Verwenden Sie stabile Workload-Bezeichner wie Deployment- oder StatefulSet-Namen, wenn Sie historische Telemetrie abfragen.
Große Mengen an Logs und Telemetriedaten
Große Kubernetes-Umgebungen können erhebliche Mengen an Metriken, Logs, Traces und Profilen erzeugen. Autoscaling und Microservice-Architekturen erhöhen die Zahl der Telemetriequellen, während Labels mit hoher Kardinalität wie Pod-IDs die Speicher- und Abfragekosten deutlich in die Höhe treiben können.
Teams müssen das Telemetrievolumen kontrollieren, ohne Daten zu entfernen, die fürs Troubleshooting nötig sind. Gängige Ansätze sind Log-Filterung, Trace-Sampling, Metrik-Aggregation, Aufbewahrungsrichtlinien und die Begrenzung unnötiger Attribute mit hoher Kardinalität. Erfassungsrichtlinien sollten Signale priorisieren, die nützliche operative Informationen liefern.
So meistern Sie die Herausforderung:
- Filtern Sie repetitive Logs mit geringem Wert bereits auf der Erfassungsebene, bevor sie an den zentralen Speicher gesendet werden.
- Nutzen Sie Trace-Sampling, um repräsentative Requests zu behalten, und erfassen Sie Fehler sowie Traces mit hoher Latenz mit höherer Rate.
- Aggregieren Sie Metriken dort, wo detaillierte Daten pro Pod oder Container nicht erforderlich sind.
- Begrenzen Sie Labels und Attribute mit hoher Kardinalität – insbesondere Bezeichner, die für jeden Request oder jede Ressource eine eigene Zeitreihe erzeugen.
- Definieren Sie Aufbewahrungsrichtlinien nach Telemetrietyp und operativem Wert und behalten Sie hochauflösende Daten nur so lange, wie sie fürs Troubleshooting gebraucht werden.
Transparenz über mehrere Cluster hinweg
Unternehmen betreiben oft mehrere Kubernetes-Cluster über Regionen, Cloud-Anbieter, Umgebungen oder Geschäftsbereiche hinweg. Jedes Cluster einzeln zu beobachten führt zu fragmentierten Dashboards und erschwert es, Performance zu vergleichen, gemeinsame Abhängigkeiten zu untersuchen oder systemweite Vorfälle zu verstehen.
Telemetrie zu zentralisieren oder zu föderieren kann eine konsistente Sicht über alle Cluster hinweg schaffen. Cluster-Bezeichner und standardisierte Labels helfen, Ressourcen zu unterscheiden und Cluster-übergreifende Abfragen zu ermöglichen. Teams müssen zudem Netzwerkkonnektivität, Datenresidenz, Zugriffskontrollen und die Kosten für den Telemetrietransfer zwischen Umgebungen berücksichtigen.
So meistern Sie die Herausforderung:
- Zentralisieren oder föderieren Sie Telemetrie aus mehreren Clustern, damit Teams Umgebungen über eine gemeinsame Oberfläche abfragen und vergleichen können.
- Verwenden Sie konsistente Labels für Cluster, Region, Umgebung, Namespace und Workload über alle Telemetriequellen hinweg.
- Standardisieren Sie Dashboards, Alerts und Richtlinien zur Telemetrieerfassung über Cluster hinweg, wo die betrieblichen Anforderungen ähnlich sind.
- Setzen Sie Zugriffskontrollen ein, damit Nutzer nur die Cluster und Telemetriedaten sehen, die für ihre Aufgaben relevant sind.
- Berücksichtigen Sie Datenresidenz, Netzwerkbandbreite, Verfügbarkeit und Telemetrie-Transferkosten bei der Entscheidung, wo Daten gespeichert und verarbeitet werden.
Datenkorrelation über Microservices hinweg
Eine einzelne Nutzeranfrage kann viele Services, Pods, Datenbanken und Queues durchlaufen. Metriken zeigen vielleicht, dass ein Service langsam ist, während der relevante Fehler in den Logs eines anderen Services auftaucht. Ohne gemeinsamen Kontext müssen Teams Signale aus verschiedenen Systemen manuell verknüpfen.
Konsistente Service-Metadaten und Bezeichner wie Trace- und Request-IDs erleichtern die Korrelation. Distributed Tracing kann Operationen über Servicegrenzen hinweg verbinden, während Kubernetes-Metadaten Anwendungstelemetrie mit Pods und Nodes verknüpfen. So gelangen Teams von einem übergeordneten Symptom zum konkreten Service, Workload oder zur beteiligten Infrastrukturkomponente.
So meistern Sie die Herausforderung:
- Propagieren Sie Trace-IDs und Request-IDs über Servicegrenzen hinweg, damit Telemetrie desselben Requests verknüpft werden kann.
- Nutzen Sie Distributed Tracing, um Requests über Services, Datenbanken, Queues und andere Abhängigkeiten hinweg zu verfolgen.
- Verwenden Sie konsistente Service-Namen und Kubernetes-Metadaten für Metriken, Logs und Traces.
- Nehmen Sie Trace- und Span-IDs in Anwendungs-Logs auf, damit Engineers direkt zwischen Traces und zugehörigen Log-Einträgen wechseln können.
- Bewahren Sie den Kontext zu Workload, Pod, Container und Node, damit Fehler auf Anwendungsebene mit den Bedingungen der Kubernetes-Infrastruktur korreliert werden können.
Best Practices für Kubernetes Observability
Infrastruktur- und Anwendungs-Performance gemeinsam überwachen
Überwachen Sie die Kubernetes-Infrastruktur zusammen mit den darauf laufenden Anwendungen. Node-CPU, Speicherdruck, Festplattennutzung, Pod-Status, Netzwerkbedingungen und Control-Plane-Metriken können Infrastrukturprobleme aufdecken. Request-Latenz, Fehlerraten, Durchsatz, Anwendungs-Logs und Traces zeigen, wie sich diese Bedingungen auf Services und Nutzer auswirken.
Die Korrelation beider Ebenen hilft, Anwendungsfehler von zugrunde liegenden Cluster-Problemen zu unterscheiden. Erhöhte Latenz kann etwa auf ineffizienten Anwendungscode, CPU-Throttling, zu wenig Speicher, Netzwerkprobleme oder einen fehlerhaften Node zurückgehen. Infrastruktur- und Anwendungstelemetrie gemeinsam zu betrachten verkürzt die Zeit, um die betroffene Ebene einzugrenzen.
Wo möglich sollten auch Abhängigkeiten einbezogen werden. Ein Kubernetes-Workload kann gesund wirken, während Requests durch eine Datenbank, eine Queue, einen Cache oder eine externe API verzögert werden. Distributed Traces und Metriken auf Service-Ebene machen diese Abhängigkeiten sichtbar und zeigen, wo Fehler oder Latenz ihren Ursprung haben.
Resource Requests mit der tatsächlichen Nutzung vergleichen
Vergleichen Sie die CPU- und Speicher-Requests von Containern mit dem beobachteten Ressourcenverbrauch. Kubernetes nutzt Requests beim Scheduling von Pods – ungenaue Werte wirken sich daher direkt darauf aus, wie effizient Workloads auf Nodes platziert werden. Requests, die dauerhaft über der tatsächlichen Nutzung liegen, lassen Kapazität ungenutzt; zu niedrige Requests können zu Ressourcenkonflikten und instabiler Performance führen.
Bewerten Sie die Nutzung über repräsentative Zeiträume statt über kurze Momentaufnahmen. Berücksichtigen Sie normalen Traffic, Lastspitzen, Deployments, Batch-Jobs und geplante Workloads, damit die Ressourceneinstellungen realistische Betriebsbedingungen widerspiegeln. Perzentilbasierte Nutzungsdaten sind oft aussagekräftiger als Durchschnittswerte, da Durchschnitte kurze Phasen hoher Last verdecken können.
Limits sollten getrennt von Requests bewertet werden. CPU-Limits können Throttling verursachen, wenn Workloads zusätzliche Rechenkapazität benötigen, während das Überschreiten eines Speicher-Limits einen Container mit einem Out-of-Memory-Fehler beenden kann. Der Vergleich von Limits, Requests und tatsächlicher Nutzung liefert ein vollständigeres Bild der Ressourcenkonfiguration.
Kontinuierliches Right-Sizing von Kubernetes-Workloads
Ressourcenanforderungen ändern sich, wenn sich Anwendungscode, Traffic-Muster und Abhängigkeiten weiterentwickeln. Überprüfen Sie CPU- und Speicher-Requests und -Limits regelmäßig, statt die ursprünglichen Werte als dauerhafte Konfiguration zu betrachten. Ein Workload, der beim Deployment korrekt dimensioniert war, kann mit verändertem Verhalten überprovisioniert oder zu knapp bemessen sein.
Nutzen Sie historische Auslastung, CPU-Throttling, Out-of-Memory-Events, Latenz und Performance-Daten, wenn Sie Ressourcen anpassen. Right-Sizing sollte effiziente Cluster-Auslastung mit genügend Kapazität für Workload-Schwankungen und erwartete Lastspitzen in Einklang bringen. Änderungen sollten zudem anhand der Anwendungs-Performance validiert werden – nicht allein anhand der Ressourcenauslastung.
Automatisierte Empfehlungen können helfen, Workloads mit dauerhaften Abweichungen zwischen angeforderten und verbrauchten Ressourcen zu identifizieren. Teams sollten jedoch Startanforderungen, Workloads mit Lastspitzen, Failover-Kapazität und Service Level Objectives berücksichtigen, bevor sie Empfehlungen umsetzen.
Kubernetes auf Workload-Ebene überwachen
Metriken auf Pod-Ebene sind fürs Troubleshooting nützlich, doch Pods sind temporäre Implementierungsdetails. Aggregieren Sie Telemetrie nach stabilen Workload-Objekten wie Deployments, StatefulSets und DaemonSets, um das Anwendungsverhalten über Pod-Austausch, Rolling Updates und Skalierungsereignisse hinweg zu verstehen.
Monitoring auf Workload-Ebene reduziert zudem das Rauschen, wenn sich Replicas häufig ändern. Teams können erkennen, ob ein gesamter Workload beeinträchtigt ist, und anschließend einzelne Pods, Container oder Nodes untersuchen, um die Ursache einzugrenzen. Dieser Ansatz ist besonders nützlich, wenn Autoscaling häufig Replicas erstellt und entfernt.
Bewahren Sie die Beziehungen zwischen Workloads und ihren zugrunde liegenden Ressourcen. Dashboards sollten es beispielsweise ermöglichen, von einem Deployment mit hoher Latenz zu seinen Pods, Containern, Nodes, Logs und Traces zu gelangen. Kubernetes-Labels und Ownership-Metadaten liefern den Kontext, um diese Beziehungen aufrechtzuerhalten.
Historische Daten für Ressourcentrends nutzen
Bewahren Sie genügend historische Telemetrie auf, um vorübergehende Spitzen von anhaltenden Veränderungen im Ressourcenbedarf zu unterscheiden. Trends bei CPU, Speicher, Storage, Request-Volumen, Netzwerkverkehr und Replica-Zahlen können schleichende Kapazitätsengpässe aufdecken, die keine unmittelbaren Alerts auslösen.
Historische Daten unterstützen außerdem Kapazitätsplanung und Konfigurationsänderungen. Der Vergleich des aktuellen Verhaltens mit früheren Deployments, Traffic-Phasen oder saisonalen Spitzen hilft Teams festzustellen, ob Ressourcenwachstum erwartbar ist oder auf ein Problem hindeutet. Er zeigt zudem, wie sich Änderungen an den Ressourceneinstellungen über die Zeit auf die Performance auswirken.
Wählen Sie Aufbewahrungszeiträume anhand der betrieblichen Anforderungen und erwarteten Workload-Zyklen. Kurzfristige hochauflösende Daten sind für die Incident-Analyse nützlich, während aggregierte Langzeitdaten monatliche oder saisonale Trendanalysen ermöglichen, ohne jeden einzelnen Rohdatenpunkt aufzubewahren.
Autoscaling-Verhalten im Blick behalten
Überwachen Sie horizontale und vertikale Autoscaling-Entscheidungen zusammen mit den Metriken, die sie auslösen. Nützliche Signale sind gewünschte und aktuelle Replica-Zahlen, Skalierungsfrequenz, Ressourcenauslastung, ausstehende Pods, Änderungen an Empfehlungen und ob konfigurierte Mindest- oder Höchstwerte für Replicas erreicht werden.
Häufiges Skalieren kann auf instabile Schwellenwerte hindeuten, während Workloads, die dauerhaft am Maximum hängen, zusätzliche Ressourcen oder überarbeitete Skalierungsrichtlinien benötigen. Langsames Scale-out kann außerdem Latenz oder Fehler verursachen, wenn neue Pods zu lange brauchen, um bereit zu sein. Die Korrelation von Skalierungsereignissen mit der Anwendungs-Performance hilft festzustellen, ob das Autoscaling effektiv auf die Nachfrage reagiert.
Überwachen Sie auch, ob das Cluster genügend Kapazität hat, um Skalierungsentscheidungen umzusetzen. Die gewünschte Replica-Zahl zu erhöhen bringt nichts, wenn Pods ausstehend bleiben, weil den Nodes CPU oder Speicher fehlt. Wer Pod-Scheduling und die Aktivität des Cluster Autoscalers zusammen mit dem Workload-Autoscaling verfolgt, erhält ein klareres Bild des gesamten Skalierungsprozesses.
FAQ
Was ist Kubernetes Observability? Kubernetes Observability ist die Praxis, Telemetriedaten zu erfassen, zu aggregieren und zu analysieren, um den internen Zustand, die Performance und die Gesundheit eines Clusters und seiner Workloads zu verstehen. Teams können so nachvollziehen, warum sich ein System fehlerhaft verhält – und nicht nur, dass es das tut.
Was ist der Unterschied zwischen Kubernetes Observability und Monitoring? Monitoring verfolgt vordefinierte Metriken und Bedingungen wie CPU-Auslastung oder Neustart-Zahlen und alarmiert, wenn sie überschritten werden. Observability ergänzt Metriken, Logs, Traces, Events und Kubernetes-Metadaten, damit Teams Probleme untersuchen können, die niemand vorhergesehen hat. Monitoring ist ein Teil von Observability.
Was sind die vier Säulen der Kubernetes Observability? Die vier Säulen sind Metriken, Logs, Traces und Profile. Metriken sind numerische Messwerte über die Zeit, Logs sind mit Zeitstempeln versehene Ereignisaufzeichnungen, Traces verfolgen einen Request über Services hinweg, und Profile zeigen, wie Anwendungscode CPU und Speicher nutzt.
Warum ist Observability in Kubernetes schwieriger? Pods sind kurzlebig, daher können Logs und Laufzeitdaten verschwinden, wenn ein Pod ersetzt wird. Große Umgebungen erzeugen zudem enorme Mengen an Telemetrie, erstrecken sich über mehrere Cluster und schicken einen einzelnen Request durch viele Services – das macht es schwer, die Signale zu verknüpfen.
Welche Kubernetes-Metriken sollte ich zuerst überwachen? Beginnen Sie mit CPU-Auslastung und Throttling, Speicherauslastung, Pod-Status und -Verfügbarkeit, Container-Neustarts und Node-Zustand. Vergleichen Sie außerdem Resource Requests und Limits mit der tatsächlichen Nutzung, denn dieser Vergleich zeigt überprovisionierte und zu knapp dimensionierte Workloads.
Volle Kubernetes Observability mit PerfectScale
Metriken, Logs, Traces und Profile zu sammeln bringt nur dann etwas, wenn Teams diese Signale in Entscheidungen über Kosten, Performance und Stabilität übersetzen können. PerfectScale liefert vollständige Kubernetes-Transparenz ohne blinde Flecken – mit KI-gestützten Insights, die Risiken, Verschwendung und Optimierungspotenziale in jedem Cluster sichtbar machen. Die Lösung kombiniert Observability, Monitoring und die kontinuierliche Analyse von Kosten, Verschwendung, Performance und weiteren Echtzeit- und historischen Metriken über Cluster, Namespaces, Workloads und Node-Gruppen hinweg. So behalten Teams Kosten und Performance im Griff und sichern zugleich betriebliche Effizienz und die Gesundheit ihrer Umgebung.
Zentrale Funktionen von PerfectScale:
- Ganzheitliche Kostensicht: Bietet eine vollständige K8s-Kostenaufschlüsselung nach Cluster, Namespace, Workload und Label und deckt Optimierungspotenziale mit granularer Transparenz über die Ausgaben der gesamten Umgebung auf.
- Präzise Analysen und Insights: Nutzt Standardpreise oder einen integrierten individuellen Report wie AWS CUR, Azure Cost Management oder GCP Cloud Billing, um Abrechnungsdaten mit Echtzeit- und historischen Nutzungsmetriken zu kombinieren und Kostentrends, Verschwendung, ungenutzte Kapazitäten sowie eine präzise Kostenzuordnung zu identifizieren.
- Richtliniengesteuerte Optimierung: Wendet anpassbare Optimierungsrichtlinien an, damit das Ressourcenmanagement SLA-/SLO-Ziele und Kosteneffizienzziele gleichermaßen erfüllt.
- KI-gestützte Automatisierung: Ermöglicht flexible, kontrollierte und vollautomatische Abläufe, damit Teams jeden Aspekt ihrer Optimierungsstrategie individuell gestalten können.
- Wirkungsbasiertes Alerting: Priorisiert Probleme automatisch, setzt Budget-Leitplanken und erkennt Kosten- und Resilienz-Anomalien, sodass Teams informiert sind, bevor es zu Ausfällen oder unerwarteten Rechnungen kommt.
- Performance- und Resilienz-Insights: Analysiert kontinuierlich Performance, Workload-Verhalten und Ressourcennutzungsmuster, um Risiken wie CPU-Throttling, OOM, falsch konfigurierte Requests und Limits oder ineffizientes Skalieren proaktiv zu erkennen – und so Pod-Neustarts, Performance-Einbußen, Latenz und Ausfallzeiten zu verhindern.
- Autonomes Workload-Right-Sizing: Beseitigt Verschwendung ohne Performance-Einbußen durch sichere, vollautomatische Optimierung – mit proaktiver Problembehebung auf Basis prädiktiver Intelligenz.
- Intelligentes Skalieren und Budgetieren: Verbessert Skalierungsstrategie und Budgetprognosen und unterstützt so den Day-2-Betrieb in großem Maßstab.
- Workflow- und Observability-Integrationen: Verbindet Entwickler, DevOps, Platform Engineers und FinOps über bestehende Kollaborations-, Ticketing- und Observability-Tools in einem einheitlichen Optimierungs-Ökosystem.
Erfahren Sie mehr über KI-gestützte Kubernetes-Transparenz und -Governance mit PerfectScale