
PerfectScale
El costo oculto de los requests sobredimensionados
Por qué los requests de Kubernetes dimensionados para el arranque de la JVM hacen perder dinero, cómo rompen el bin-packing y el autoescalado, y cómo aplicarles right-sizing sin afectar la confiabilidad.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


Muchos clústeres de Kubernetes reservan mucha más CPU y memoria de la que sus pods realmente usan. Una causa común es el arranque de un servicio Java. La JVM necesita mucha CPU en sus primeros segundos, así que los equipos configuran un request alto para proteger ese momento. Ese request se mantiene alto durante toda la vida del pod, mucho después de que termina el trabajo de arranque.
La factura de la nube se basa en la reserva, no en el uso. Un pod que reserva 2 CPUs pero usa solo una pequeña parte de ellas sigue bloqueando 2 CPUs en su nodo. Multiplicada por muchas réplicas, esta reserva sin usar se convierte en una parte importante del costo del clúster.
La solución obvia es bajar los requests, pero también es riesgosa. Si bajas un request y dejas el problema del arranque sin resolver, la JVM arranca lenta, los probes fallan y el autoescalador agrega réplicas que el servicio no necesita. El costo y la confiabilidad tiran en direcciones opuestas. Este artículo explica por qué crecen los requests, cuánto cuestan y cómo afectan el scheduling y el escalado de nodos. Luego muestra cómo encontrarlos y cómo corregirlos sin afectar la confiabilidad.
¿Qué son los resource requests sobredimensionados?
Un resource request es la cantidad de CPU o memoria que Kubernetes reserva para un contenedor. El scheduler suma los requests de cada nodo y mantiene el total por debajo de los recursos asignables del nodo.
Un request está sobredimensionado cuando es mucho mayor de lo que el contenedor necesita en operación normal. A la diferencia la llamamos request gap: el request menos el uso en estado estable del contenedor.
resources: requests: cpu: "2" # dimensionado para los primeros segundos del arranque memory: 4Gi limits: cpu: "2" memory: 4GiEn este ejemplo, el request coincide con el pico de arranque. Si el contenedor solo necesita una pequeña parte de esta CPU después del arranque, el resto de la reserva es el request gap.
La CPU y la memoria se comportan de forma distinta. El kernel puede frenar a un contenedor que quiere más CPU, pero no puede frenar a uno que quiere más memoria. Cuando un contenedor usa más memoria que su límite, el kernel lo detiene con un out-of-memory (OOM) kill. Por esta razón, un request de CPU deja más margen para un ajuste fino que un request de memoria.
¿Por qué se inflan los requests?
Los requests crecen por tres razones:
a. Dimensionar para el pico de arranque: La JVM carga clases, compila los métodos más usados con los compiladores JIT, hace crecer su heap y construye la aplicación, todo en los primeros segundos. Este trabajo necesita mucha más CPU de la que el servicio necesita después. Si el límite de CPU es bajo, el kernel aplica throttling a la JVM y el arranque se vuelve lento. Un equipo que ya vivió este problema sube el request y el límite hasta que el arranque funciona. El nuevo valor se ajusta al pico de arranque, pero no al resto de la vida del pod. Para ver cómo el kernel aplica throttling a la JVM durante el arranque, lee CPU throttling durante el arranque de la JVM.
b. Seguridad por encima del costo: Los dos riesgos no pesan igual. Cuando un servicio sufre throttling o es terminado, se dispara una alerta y alguien tiene que arreglarlo. Cuando un servicio desaprovecha CPU, no se dispara nada, porque Kubernetes no reporta los requests sin usar como un error. Por eso los Engineers eligen el valor que los protege de las alertas, y un request alto es la opción más segura.
c. Valores por defecto copiados: Muchos requests nunca se eligieron. Un chart de Helm viene con valores por defecto, un equipo copia el manifiesto de otro servicio y una plantilla vieja arrastra los números de un servicio pesado a uno liviano. Un LimitRange también puede establecer un request por defecto para cada contenedor que no lo define:
apiVersion: v1kind: LimitRangemetadata: name: default-requests namespace: examplespec: limits: - type: Container defaultRequest: cpu: "1" memory: 2GiEste LimitRange asigna un request de 1 CPU y 2Gi de memoria a todos los contenedores del namespace que no definen un request. Estos valores se propagan entre equipos y entornos, y nadie los vuelve a revisar.

El costo de los requests sobredimensionados
Hay tres pasos que muestran el costo:
a. La fórmula del request gap: La pérdida de un contenedor tiene una fórmula simple:
pérdida (vCPU-horas): (request - uso en estado estable) x réplicas x horascosto: pérdida x precio por vCPU-horaUsa la misma fórmula para la memoria con GiB-horas. Para el uso en estado estable, elige un percentil alto del uso después del arranque, como el 95. Un percentil es más seguro que el promedio, porque cubre los picos normales.
La forma en que el gap se convierte en dinero depende de tu plataforma. En nodos estándar pagas por las máquinas virtuales, así que el request gap aumenta la cantidad de nodos que el clúster necesita. En GKE Autopilot, Google factura por la CPU y la memoria que tus pods solicitan, por lo que cada unidad de request gap es un costo directo.
b. Ejemplo práctico: Supón que un servicio Java corre 100 réplicas. Cada réplica solicita 2 CPUs para que el arranque funcione. Después del arranque, una réplica necesita cerca de 0.3 CPUs en el percentil 95. Estos números son un ejemplo; tu servicio tiene los suyos.
- El request gap es 2 - 0.3 = 1.7 CPUs por réplica.
- Con 100 réplicas, el gap es de 170 CPUs reservadas y sin usar.
- Un mes tiene unas 730 horas, así que la pérdida es 170 x 730 = 124,100 vCPU-horas al mes.
- Multiplica este número por el precio de una vCPU-hora en tu plataforma para obtener el costo mensual.
Para la memoria, un contenedor que solicita 4 GiB pero necesita 2 GiB en estado estable pierde 2 GiB por cada réplica.
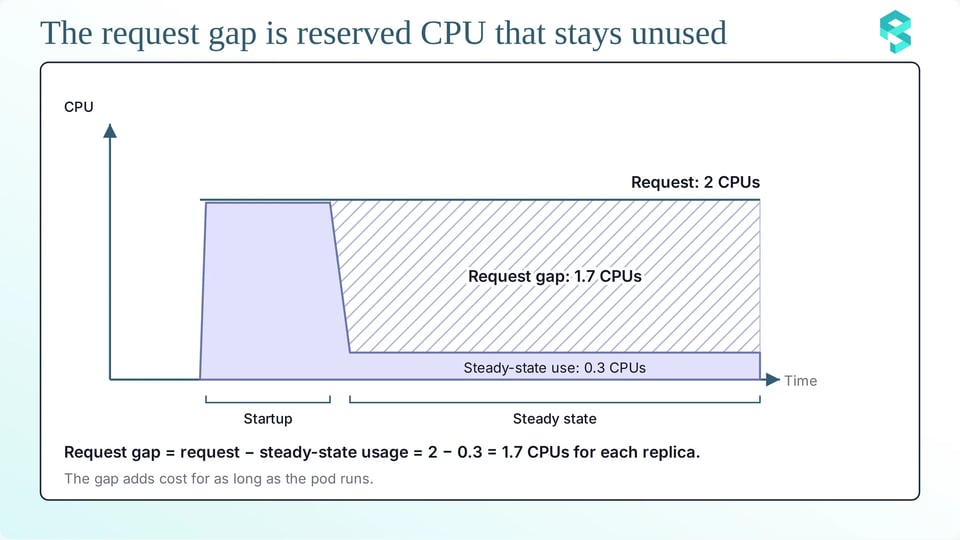
c. El costo acumulado entre servicios: Un servicio es fácil de corregir, pero muchos servicios son más difíciles. El mismo valor inflado se repite en réplicas, servicios, clústeres y entornos. Los clústeres de staging y desarrollo suelen copiar los requests de producción, así que arrastran la misma pérdida.
Los requests también consumen cuota. Un ResourceQuota limita la suma de requests en un namespace:
apiVersion: v1kind: ResourceQuotametadata: name: team-quota namespace: examplespec: hard: requests.cpu: "40" requests.memory: 80GiCon esta cuota, todos los pods del namespace en conjunto pueden solicitar 40 CPUs y 80Gi de memoria. Los requests inflados agotan este presupuesto mucho antes que el uso real. Entonces el equipo pide una cuota más grande, y el problema crece.
¿Cómo rompen el bin-packing los requests sobredimensionados?
Los requests afectan el scheduling y el escalado de nodos de tres maneras:
a. El scheduling usa requests, no uso real: El scheduler no mira lo que un pod usa. Mira lo que el pod solicita.
Por defecto, el scheduler puntúa los nodos con la estrategia LeastAllocated. Esta estrategia prefiere los nodos con menos recursos solicitados, así que distribuye los pods entre los nodos. Las estrategias MostAllocated y RequestedToCapacityRatio empaquetan los pods de forma más compacta. Las tres estrategias trabajan sobre requests. Por eso, una estrategia más compacta no puede corregir requests inflados: empaqueta las reservas y no el uso real.
b. CPU inutilizada y nodos extra: La CPU reservada que ningún contenedor usa queda inutilizada. Otros pods no pueden usarla porque el scheduler la cuenta como ocupada. El clúster necesita entonces más nodos para colocar los mismos pods. Los desbalances empeoran esto. Si los requests son altos en CPU y bajos en memoria, el nodo se queda sin CPU primero y su memoria queda sin usar. También ocurre lo contrario.
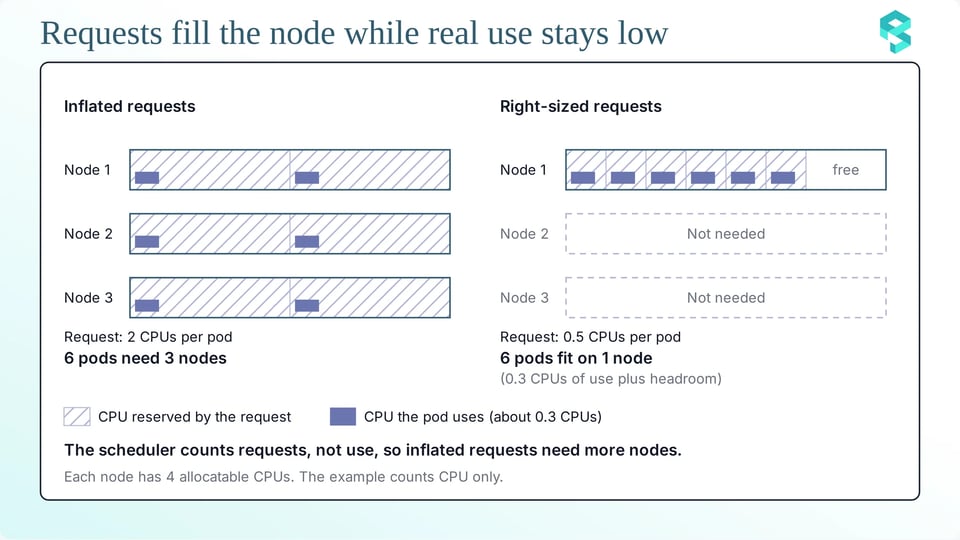
c. Efecto en el autoescalado de nodos: Los autoescaladores de nodos también trabajan sobre requests. Cluster Autoscaler agrega un nodo cuando un pod no se puede programar por falta de recursos. Para eliminar un nodo, calcula la utilización del nodo como la suma de los recursos solicitados dividida entre los recursos asignables. Por defecto, un nodo solo se vuelve candidato a eliminación cuando este valor está por debajo de 0.5 (--scale-down-utilization-threshold). Los requests inflados mantienen el valor alto, así que los nodos con bajo uso real permanecen en el clúster.
Karpenter sigue la misma idea. Lee los resource requests de los pods pendientes para elegir y lanzar nodos, y su consolidación empaqueta los pods según los requests, no según el uso. Con requests más bajos y precisos, ambas herramientas pueden operar con menos nodos.
¿Por qué fallan las recomendaciones basadas en promedios con workloads de arranque intensivo?
Muchas herramientas recomiendan un request a partir del historial de uso de un contenedor. Eligen una estadística sobre una ventana de tiempo: el promedio, un percentil o el pico. Para un servicio con pico de arranque, cada opción falla de una manera distinta:
a. Una estadística baja oculta el pico: El promedio se ajusta al estado estable, así que el request recomendado es bajo. La JVM recibe entonces muy poca CPU en el arranque y el kernel le aplica throttling.
b. Una estadística alta incluye el pico: El máximo, o un percentil muy alto, incluye las muestras del arranque, así que el request recomendado se ajusta al arranque. El pod reserva entonces CPU de nivel de arranque durante toda su vida, y la pérdida se mantiene.
Ambos resultados son incorrectos para una de las fases. El tamaño del error también depende de la frecuencia con la que arrancan los pods. Los despliegues frecuentes, el autoescalado y los reemplazos de nodos agregan más muestras de arranque a la ventana, así que la estadística se mueve hacia el pico. Un solo número no puede describir un workload con dos fases. La solución requiere una recomendación o un mecanismo que trate el arranque y el estado estable por separado.
Los riesgos de recortar requests sin resolver el arranque
Un request más bajo sin corregir el arranque causa tres problemas:
a. Throttling y readiness lento: Si bajas el límite de CPU junto con el request, el kernel aplica throttling a la JVM en el arranque. El pod llega tarde al estado Ready, los despliegues tardan más y el startup probe puede fallar. Si la falla se repite, el kubelet reinicia el contenedor, y el nuevo contenedor repite el mismo trabajo. Si bajas solo el request y mantienes un límite alto o sin límite, el pod recibe una porción menor de CPU cuando el nodo está ocupado, así que el arranque es lento en nodos ocupados.
b. Scale-out del HPA por la CPU de arranque: El Horizontal Pod Autoscaler (HPA) mide el uso de CPU como porcentaje del request. Usa esta fórmula:
desiredReplicas = ceil[ currentReplicas x ( currentMetricValue / desiredMetricValue ) ]Un request más pequeño hace que el mismo uso de CPU parezca mayor en porcentaje. Un pico de arranque puede verse entonces como carga pesada, y el HPA agrega réplicas. Las nuevas réplicas arrancan, y cada arranque crea otro pico. Por defecto, el retraso inicial de readiness es de 30 segundos (--horizontal-pod-autoscaler-initial-readiness-delay), y el HPA puede omitir muestras de CPU durante el período de inicialización de CPU de 5 minutos (--horizontal-pod-autoscaler-cpu-initialization-period). Estos valores por defecto reducen el riesgo, pero no pueden eliminarlo cuando el arranque es largo.
c. Contenedores Java con OOMKilled: Por defecto, la JVM fija su heap máximo en el 25% de la memoria del contenedor (-XX:MaxRAMPercentage). La JVM también usa memoria fuera del heap, como el metaspace, los stacks de los hilos y la caché de código. Si bajas el límite de memoria sin revisar estas partes, el contenedor puede excederlo y recibir un OOM kill.
Si el request de memoria es menor que el límite, el nodo también puede alojar demasiados pods, y el kubelet puede desalojar pods cuando el nodo se queda corto de memoria. Para contenedores JVM, configura el request de memoria igual al límite de memoria:
resources: requests: memory: 2Gi limits: memory: 2Gi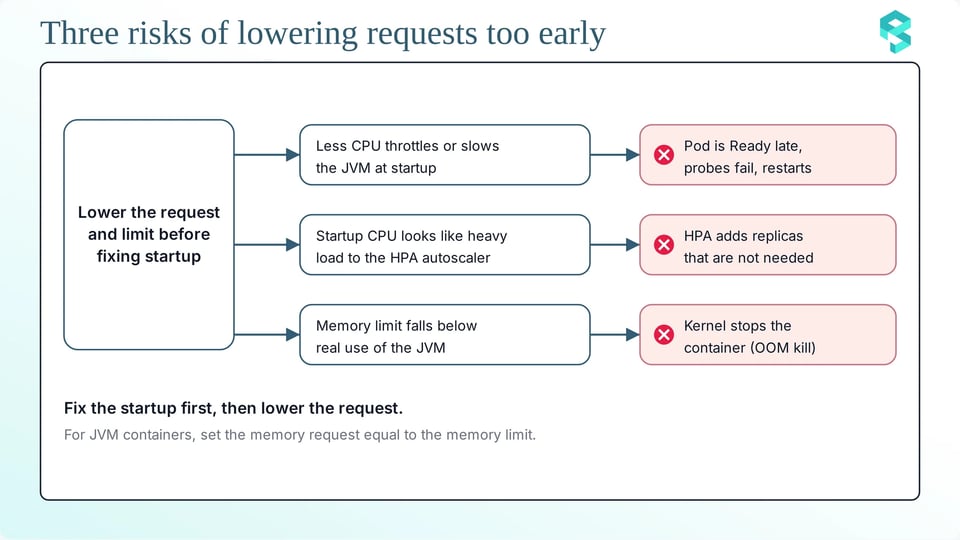
Cómo encontrar requests sobredimensionados
Hay tres verificaciones que te ayudarán a encontrar el problema:
a. Requests vs. uso: Para un primer vistazo, usa kubectl top. Necesita el Metrics Server y muestra el uso actual de cada contenedor:
kubectl top pod --containers -n <namespace>Compara el resultado con los requests en la especificación del pod. Para un panorama completo, usa Prometheus. La métrica kube_pod_container_resource_requests de kube-state-metrics contiene los requests. La métrica de cAdvisor container_cpu_usage_seconds_total contiene el uso de CPU. Esta consulta muestra el request gap de CPU por contenedor, usando el percentil 95 del uso durante 7 días:
expr: | sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) )b. Ventana de arranque vs. estado estable: La consulta del request gap mezcla ambas fases, y las muestras del arranque elevan el percentil 95, así que el gap parece menor que el gap real del estado estable. Para separarlas, usa la métrica kube_pod_start_time, que contiene la hora de inicio de cada pod. Esta consulta conserva solo las muestras de los primeros 10 minutos de un pod y devuelve el pico:
max by (namespace, pod, container) ( max_over_time( ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[1m]) and on (namespace, pod) (time() - kube_pod_start_time < 600) )[7d:1m] ))Esta consulta conserva solo las muestras posteriores a los primeros 10 minutos y devuelve el percentil 95. Muestra el estado estable:
max by (namespace, pod, container) ( quantile_over_time(0.95, ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m]) and on (namespace, pod) (time() - kube_pod_start_time > 600) )[7d:5m] ))Estas consultas asumen que el arranque termina en 10 minutos. Cambia 600 por el tiempo de arranque de tu servicio. La hora de inicio del pod no cambia cuando un contenedor se reinicia dentro del mismo pod, así que ese reinicio cuenta como estado estable. La consulta de arranque también usa un paso de 1 minuto, por lo que puede leer un valor algo menor que el pico real cuando el pico es corto.
Compara tres valores para un contenedor: el request, el pico de arranque y el uso en estado estable. Un contenedor con una gran brecha entre el request y el uso en estado estable, y con un pico de arranque cercano al request, es el clásico servicio JVM sobredimensionado.
c. Ordenar los workloads por request gap: Corrige primero los gaps más grandes. Ordena por el gap absoluto en CPUs, sumado sobre todas las réplicas, y no por la proporción. Una proporción de diez en un contenedor diminuto ahorra poco. Estas consultas son pesadas, así que guarda el gap en una recording rule y ordena el resultado:
groups: - name: request-gap rules: - record: container:cpu_request_gap:cores expr: | clamp_min( sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) ), 0)Si usas el Prometheus Operator, coloca el mismo grupo de reglas bajo spec.groups de un objeto PrometheusRule, con la etiqueta que tu Prometheus usa para seleccionar reglas.
topk(20, sum by (namespace, container) (container:cpu_request_gap:cores))Haz la misma verificación para la memoria con la métrica container_memory_working_set_bytes.
¿Cómo dejar de pagar el arranque durante toda la vida del pod?
El objetivo es darle al pod recursos de nivel de arranque durante el arranque y recursos de estado estable después. Estas opciones funcionan en conjunto:
a. Reducir el costo del arranque: Menos trabajo de arranque necesita menos CPU al arrancar, y esto baja el pico que define el request. Spring Boot puede crear los beans en el primer uso con spring.main.lazy-initialization=true. Class Data Sharing y la caché AOT pueden eliminar parte del trabajo de carga de clases. La caché AOT llegó en JDK 24 (JEP 483). Spring Framework soporta tanto CDS como la caché AOT. El profiling muestra en qué se va tu tiempo de arranque.
b. Startup boost y VPA: El Vertical Pod Autoscaler (VPA) tiene un modo de actualización InPlaceOrRecreate. Este modo intenta primero un redimensionamiento in-place y recrea el pod cuando un redimensionamiento in-place no es posible. En GKE, el CPU startup boost funciona con el VPA. Eleva el request de CPU cuando se crea el pod y mantiene el request más alto durante durationSeconds después de que el pod pasa a Ready. Luego GKE devuelve el request a su valor base in-place. El boost se aplica solo cuando se crea el pod, así que un reinicio de contenedor dentro del mismo pod no recibe boost. La función está en Preview al momento de escribir esto y requiere GKE 1.36.0-gke.4447000 o posterior.
apiVersion: autoscaling.k8s.io/v1kind: VerticalPodAutoscalermetadata: name: example-vpaspec: targetRef: apiVersion: apps/v1 kind: Deployment name: example updatePolicy: updateMode: "Off" startupBoost: cpu: type: "Factor" factor: 2 durationSeconds: 10En este ejemplo, el boost duplica el request de CPU (factor: 2) y lo mantiene durante 10 segundos después de que el pod pasa a Ready. Con updateMode en Off, el VPA aplica solo el boost y no hace ningún otro cambio. Si usas un HPA junto con el boost, define un readiness probe y configura durationSeconds en 0. Esto evita que el HPA agregue réplicas por el pico de CPU del arranque.
c. Redimensionamiento in-place en dos fases: El redimensionamiento in-place de pods cambia la CPU y la memoria de un pod en ejecución sin reiniciarlo. La función alcanzó la fase beta en Kubernetes 1.33 y se volvió estable en Kubernetes 1.35. Un pod puede arrancar con un request y un límite de CPU altos, y un controlador puede bajarlos después del arranque. La política de redimensionamiento por defecto para la CPU es NotRequired, y puedes declararla en el manifiesto:
containers: - name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequiredLos recursos se cambian a través del subrecurso resize. Este comando necesita kubectl 1.32 o posterior:
kubectl patch pod <pod-name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"requests":{"cpu":"300m"},"limits":{"cpu":"500m"}}}]}}'Este ejemplo asume un pod Burstable, donde el request es menor que el límite. Un pod Guaranteed debe mantener el request igual al límite, porque un redimensionamiento no puede cambiar la clase QoS. Los pods de Windows y los pods bajo la política estática del CPU Manager o del Memory Manager no pueden usar el redimensionamiento in-place. Alguien debe además activar el redimensionamiento. Una persona puede ejecutar el patch a mano, pero para muchos pods debe hacerlo un controlador.
Para contenedores JVM, redimensiona solo la CPU y deja el límite de memoria como está, porque un límite de memoria más bajo puede causar un OOM kill.
d. startupProbe y ajuste del HPA: Un startup probe detiene los probes de liveness y readiness hasta que la aplicación haya arrancado. Evita los bucles de reinicio durante un arranque lento. Apúntalo al mismo endpoint que el liveness probe. El tiempo total que permite el probe es failureThreshold x periodSeconds.
startupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24 # espera hasta 24 x 5 = 120 segundosEsta ruta necesita la dependencia de Spring Boot Actuator. Spring Boot habilita los endpoints de liveness y readiness automáticamente cuando la aplicación corre en Kubernetes. Un startup probe no hace el arranque más rápido, pero hace que un request más bajo sea más seguro.
El HPA también requiere cuidado. El campo behavior de la API autoscaling/v2 limita la velocidad con la que el HPA agrega réplicas, para que un pico corto de arranque no provoque una ráfaga de pods nuevos:
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: example-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: example minReplicas: 2 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70 behavior: scaleUp: stabilizationWindowSeconds: 60 policies: - type: Pods value: 2 periodSeconds: 60En este ejemplo, el HPA apunta a un uso de CPU del 70%. La ventana de scale-up de 60 segundos retrasa las decisiones de escalado, así que un pico corto de arranque no agrega réplicas. El HPA agrega como máximo 2 pods en cada período de 60 segundos.
e. Automatización con PerfectScale: PerfectScale corrige la pérdida del arranque de forma automática. Una JVM necesita mucha CPU solo en el arranque. Una sola recomendación promedio no funciona para ambas fases. PerfectScale detecta automáticamente los servicios con altos requerimientos de recursos en el arranque y ofrece dos recomendaciones por cada workload: una para el arranque y otra para el estado estable en ejecución.
PerfectScale aplica la recomendación de arranque cuando se crea el pod y luego ajusta los recursos in-place para que coincidan con la recomendación de ejecución una vez que el pod alcanza el estado estable, ayudándote a optimizar la asignación de recursos en ambas fases sin comprometer el rendimiento de la aplicación. Además, no se necesita reiniciar el pod ni intervenir manualmente. El pod ya no carga con requests de nivel de arranque durante toda su vida. PerfectScale dimensiona la recomendación de arranque según la necesidad más alta de las dos fases, para que el nodo tenga capacidad suficiente durante el arranque. PerfectScale muestra los recursos de arranque y de estado estable por separado, así que las cifras de costo y pérdida reflejan lo que el workload necesitó en cada fase. PerfectScale usa el redimensionamiento in-place cuando el clúster lo soporta. Soporta Deployments, StatefulSets, DaemonSets y Argo Rollouts. Cuando el clúster no soporta el redimensionamiento in-place, PerfectScale recurre a su enfoque seguro estándar.
PerfectScale también respeta tus límites de tamaño de heap de la JVM, así que las recomendaciones nunca superan tu heap máximo configurado ni caen por debajo de tu mínimo configurado. Para los contenedores Java recopila el uso de memoria heap y no heap, junto con métricas de recolección de basura (GC), incluidos el tiempo de GC, el número de procesadores activos y el tipo de GC. La recopilación de métricas de la JVM se puede habilitar durante la instalación del agente de PerfectScale, sin configuración adicional. Esta función solo está disponible en nodos Linux.
Los autoescaladores de nodos también se benefician. PerfectScale compara tu configuración de Karpenter con los requests de los workloads en ejecución y recomienda aplicar right-sizing a los workloads primero. Así, las recomendaciones de Karpenter se ajustan al uso real y no a requests inflados.
Un antes y un después para un servicio. Este ejemplo usa los números del ejemplo práctico anterior. Antes, el request se ajusta al pico de arranque:
resources: requests: cpu: "2" memory: 2Gi limits: cpu: "2" memory: 2GiDespués, el request se ajusta al estado estable, el límite conserva margen para el arranque y un startup probe protege el arranque lento:
resources: requests: cpu: 300m memory: 2Gi limits: cpu: "2" memory: 2GistartupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24El riesgo de confiabilidad es que el nodo necesita CPU libre durante el arranque, porque el request es de solo 300m. Aplica un boost o redimensiona el pod cuando el nodo pueda estar ocupado.
Conclusión
Los requests sobredimensionados son fáciles de crear y costosos de mantener. El scheduler, los autoescaladores de nodos y algunas facturas de la nube siguen los requests y no el uso, así que cada CPU sin usar dentro de un request sigue costando dinero.
El arranque de la JVM es una causa común. El request se ajusta a los primeros segundos y se queda durante toda la vida del pod. Recortar el request por sí solo no lo resuelve, porque causa throttling, réplicas extra del HPA y OOM kills. Reduce primero el trabajo de arranque, o dimensiona el arranque y el estado estable por separado. PerfectScale lo hace automáticamente, in-place y sin reinicios.
Súmate al workshop. Vikram Seshadri, de DoiT, muestra cómo dimensionar un pod de JVM para su arranque y cómo redimensionarlo al estado estable sin reinicio, en el workshop práctico "Java on K8s: The Startup vs. Steady-State Sizing Dilemma" el 28 de octubre de 2026 a las 11 AM (hora del Este). Reserva tu lugar.
¿Quieres ver cómo PerfectScale aplica right-sizing a tus workloads de Java? Empieza gratis o agenda una demo.