
PerfectScale
Request sovradimensionate: un problema di costi
Perché le request Kubernetes dimensionate per l'avvio della JVM sprecano denaro, come compromettono bin-packing e autoscaling e come fare right-sizing senza penalizzare l'affidabilità.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


Molti cluster Kubernetes riservano molta più CPU e memoria di quanta i loro pod ne utilizzino. Una causa comune è l'avvio di un servizio Java. Una JVM ha bisogno di molta CPU nei suoi primi secondi, quindi i team impostano una request elevata per proteggere quel momento. La request resta poi elevata per tutta la vita del pod, ben oltre la fine del lavoro di avvio.
La bolletta cloud segue le risorse riservate, non l'utilizzo. Un pod che riserva 2 CPU ma ne usa solo una piccola parte blocca comunque 2 CPU sul suo nodo. Ripetuta su molte repliche, questa riserva inutilizzata diventa una parte consistente del costo di un cluster.
La soluzione ovvia è abbassare le request, ma è anche rischiosa. Se si abbassa una request lasciando irrisolto il problema dell'avvio, la JVM parte lentamente, le probe falliscono e l'autoscaler aggiunge repliche di cui il servizio non ha bisogno. Costi e affidabilità tirano in direzioni opposte. Questo articolo spiega perché le request crescono, quanto costano e come influenzano lo scheduling e lo scaling dei nodi. Mostra poi come individuarle e come correggerle senza compromettere l'affidabilità.
Cosa sono le resource request sovradimensionate?
Una resource request è la quantità di CPU o memoria che Kubernetes riserva per un container. Lo scheduler somma le request su ogni nodo e mantiene il totale al di sotto delle risorse allocabili del nodo.
Una request è sovradimensionata quando è molto più grande di ciò che serve al container in condizioni normali di esercizio. Chiamiamo questa differenza request gap: la request meno l'utilizzo a regime del container.
resources: requests: cpu: "2" # sized for the first seconds of startup memory: 4Gi limits: cpu: "2" memory: 4GiIn questo esempio, la request corrisponde al picco di avvio. Se dopo l'avvio il container ha bisogno solo di una piccola parte di questa CPU, il resto della riserva è il request gap.
CPU e memoria si comportano in modo diverso. Il kernel può rallentare un container che vuole più CPU, ma non può rallentare un container che vuole più memoria. Quando un container usa più memoria del suo limit, il kernel lo termina con un kill out-of-memory (OOM). Per questo motivo, una request di CPU offre più margine per un tuning accurato rispetto a una request di memoria.
Perché le request vengono gonfiate?
Le request crescono per tre motivi:
a. Dimensionamento sul picco di avvio: Una JVM carica le classi, compila i metodi più usati con i compilatori JIT, espande il suo heap e inizializza l'applicazione, tutto nei primi secondi. Questo lavoro richiede molta più CPU di quanta ne serva al servizio in seguito. Se il limit di CPU è basso, il kernel applica il throttling alla JVM e l'avvio diventa lento. Un team che si è scontrato con questo problema alza request e limit finché l'avvio non funziona. Il nuovo valore è adatto al picco di avvio, ma non al resto della vita del pod. Per capire come il kernel limita una JVM all'avvio, si veda CPU throttling during JVM startup.
b. La sicurezza prima del costo: I due rischi non sono equivalenti. Quando un servizio subisce throttling o viene terminato, scatta un alert e qualcuno deve intervenire. Quando un servizio spreca CPU, non scatta nulla, perché Kubernetes non segnala le request inutilizzate come errore. Gli Engineers scelgono quindi il valore che li protegge dalle chiamate di reperibilità, e una request elevata è la scelta più sicura.
c. Valori di default copiati: Molte request non vengono scelte affatto. Un Helm chart arriva con valori predefiniti, un team copia il manifest di un altro servizio e un vecchio template trasferisce i numeri di un servizio pesante in uno leggero. Anche un LimitRange può impostare una request di default per ogni container che non ne ha una:
apiVersion: v1kind: LimitRangemetadata: name: default-requests namespace: examplespec: limits: - type: Container defaultRequest: cpu: "1" memory: 2GiQuesto LimitRange assegna una request di 1 CPU e 2Gi di memoria a ogni container del namespace che non imposta alcuna request. Questi valori si diffondono tra team e ambienti, e nessuno li verifica più.

Il costo delle request sovradimensionate
Tre passaggi mostrano il costo:
a. La formula del request gap: Lo spreco di un container ha una formula semplice:
waste (vCPU-hours): (request - steady-state usage) x replicas x hourscost: waste x price per vCPU-hourUsare la stessa formula per la memoria con i GiB-ora. Per l'utilizzo a regime, scegliere un percentile alto dell'utilizzo dopo l'avvio, come il 95°. Un percentile è più sicuro della media, perché copre i picchi normali.
Il modo in cui il gap si trasforma in denaro dipende dalla piattaforma. Sui nodi standard si pagano le macchine virtuali, quindi il request gap aumenta il numero di nodi di cui il cluster ha bisogno. Su GKE Autopilot, Google fattura la CPU e la memoria richieste dai pod, quindi ogni unità di request gap è un costo diretto.
b. Esempio pratico: Supponiamo che un servizio Java esegua 100 repliche. Ogni replica richiede 2 CPU perché l'avvio funzioni. Dopo l'avvio, una replica ha bisogno di circa 0,3 CPU al 95° percentile. Questi numeri sono solo un esempio: ogni servizio ha i suoi.
- Il request gap è 2 - 0,3 = 1,7 CPU per ogni replica.
- Per 100 repliche, il gap è di 170 CPU riservate e non utilizzate.
- Un mese ha circa 730 ore, quindi lo spreco è 170 x 730 = 124.100 vCPU-ora al mese.
- Moltiplicare questo numero per il prezzo di una vCPU-ora sulla propria piattaforma per ottenere il costo mensile.
Per la memoria, un container che richiede 4 GiB ma a regime ne necessita 2 spreca 2 GiB per ogni replica.
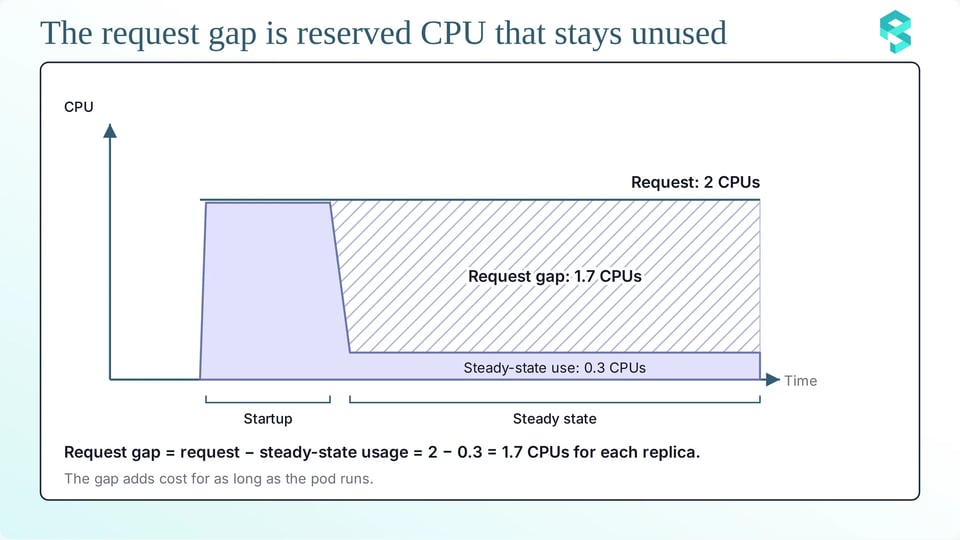
c. Il costo su più servizi: Correggere un servizio è facile, correggerne molti lo è meno. Lo stesso valore gonfiato si ripete su repliche, servizi, cluster e ambienti. I cluster di staging e di sviluppo copiano spesso le request di produzione, quindi si portano dietro lo stesso spreco.
Le request consumano anche la quota. Una ResourceQuota limita la somma delle request in un namespace:
apiVersion: v1kind: ResourceQuotametadata: name: team-quota namespace: examplespec: hard: requests.cpu: "40" requests.memory: 80GiCon questa quota, tutti i pod del namespace insieme possono richiedere 40 CPU e 80Gi di memoria. Le request gonfiate esauriscono questo budget molto prima dell'utilizzo reale. Il team chiede quindi una quota più grande, e il problema cresce.
In che modo le request sovradimensionate compromettono il bin-packing?
Le request influenzano lo scheduling e lo scaling dei nodi in tre modi:
a. Lo scheduling usa le request, non l'utilizzo: Lo scheduler non guarda cosa usa un pod. Guarda cosa richiede il pod.
Per impostazione predefinita, lo scheduler assegna un punteggio ai nodi con la strategia LeastAllocated. Questa strategia preferisce i nodi con meno risorse richieste, quindi distribuisce i pod tra i nodi. Le strategie MostAllocated e RequestedToCapacityRatio impacchettano i pod in modo più compatto. Tutte e tre le strategie lavorano sulle request. Una strategia più compatta non può quindi correggere le request gonfiate, perché impacchetta le risorse riservate e non l'uso reale.
b. CPU bloccata e nodi extra: La CPU riservata che nessun container usa resta bloccata. Gli altri pod non possono utilizzarla, perché lo scheduler la conta come occupata. Il cluster ha quindi bisogno di più nodi per collocare gli stessi pod. Gli squilibri peggiorano la situazione. Se le request sono alte per la CPU e basse per la memoria, un nodo esaurisce prima la CPU e la sua memoria resta inutilizzata. Accade anche il contrario.
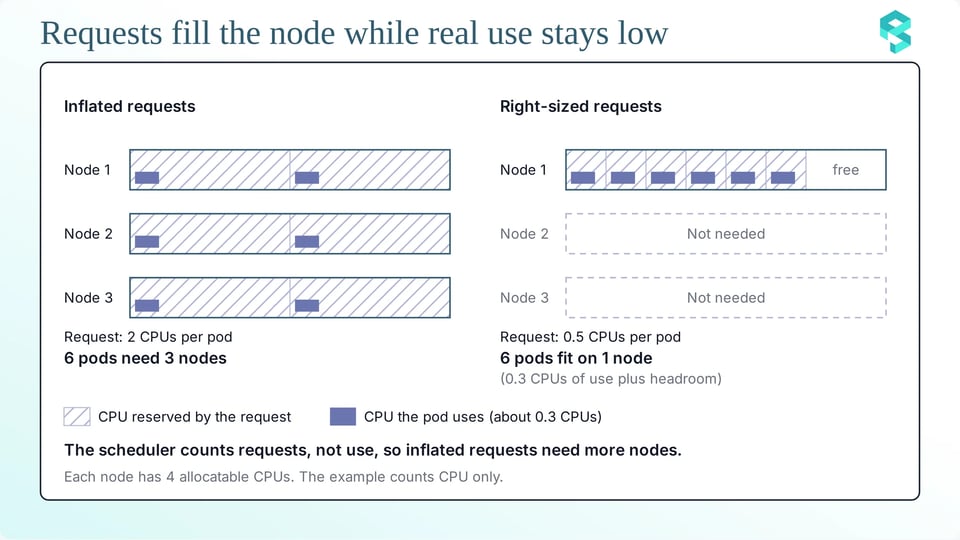
c. Effetto sull'autoscaling dei nodi: Anche gli autoscaler dei nodi lavorano sulle request. Cluster Autoscaler aggiunge un nodo quando un pod non può essere schedulato per risorse insufficienti. Per rimuovere un nodo, calcola l'utilizzo del nodo come somma delle risorse richieste divisa per le risorse allocabili. Per impostazione predefinita, un nodo diventa candidato alla rimozione solo quando questo valore è inferiore a 0,5 (--scale-down-utilization-threshold). Le request gonfiate mantengono alto questo valore, quindi i nodi con un utilizzo reale basso restano nel cluster.
Karpenter segue la stessa logica. Legge le resource requests dei pod in pending per scegliere e avviare i nodi, e la sua consolidation impacchetta i pod in base alle request, non all'utilizzo. Request più basse e più accurate permettono a entrambi gli strumenti di usare meno nodi.
Perché le raccomandazioni basate sulla media falliscono con i workloads ad avvio intensivo?
Molti strumenti raccomandano una request a partire dallo storico di utilizzo di un container. Scelgono una statistica su una finestra temporale: la media, un percentile o il picco. Per un servizio con un picco di avvio, ogni scelta fallisce in modo diverso:
a. Una statistica bassa nasconde il picco: La media rispecchia il regime, quindi la request raccomandata è bassa. La JVM riceve così troppo poca CPU all'avvio e il kernel le applica il throttling.
b. Una statistica alta include il picco: Il massimo, o un percentile molto alto, include i campioni dell'avvio, quindi la request raccomandata è adatta all'avvio. Il pod riserva allora CPU a livello di avvio per tutta la sua vita, e lo spreco rimane.
Entrambi i risultati sono sbagliati per una delle due fasi. L'entità dell'errore dipende anche dalla frequenza con cui i pod si avviano. Deployment frequenti, autoscaling e sostituzioni dei nodi aggiungono più campioni di avvio alla finestra, quindi la statistica si sposta verso il picco. Un singolo numero non può descrivere un workload con due fasi. La soluzione richiede una raccomandazione o un meccanismo che tratti separatamente l'avvio e il regime.
I rischi di tagliare le request senza risolvere l'avvio
Una request più bassa senza correggere l'avvio causa tre problemi:
a. Throttling e readiness lenta: Se si abbassa il CPU limit insieme alla request, il kernel applica il throttling alla JVM all'avvio. Il pod diventa Ready in ritardo, i rollout richiedono più tempo e la startup probe può fallire. Se il fallimento si ripete, il kubelet riavvia il container e il nuovo container ripete lo stesso lavoro. Se si abbassa solo la request mantenendo un limit alto o nessun limit, il pod riceve una quota di CPU più piccola quando il nodo è occupato, quindi l'avvio è lento sui nodi carichi.
b. Scale-out dell'HPA causato dalla CPU di avvio: L'Horizontal Pod Autoscaler (HPA) misura l'uso di CPU come percentuale della request. Usa questa formula:
desiredReplicas = ceil[ currentReplicas x ( currentMetricValue / desiredMetricValue ) ]Una request più piccola fa sembrare più grande, in percentuale, lo stesso uso di CPU. Un picco di avvio può quindi sembrare un carico elevato, e l'HPA aggiunge repliche. Le nuove repliche si avviano, e ogni avvio crea un altro picco. Per impostazione predefinita, il ritardo iniziale di readiness è di 30 secondi (--horizontal-pod-autoscaler-initial-readiness-delay) e l'HPA può ignorare i campioni di CPU durante il periodo di inizializzazione della CPU di 5 minuti (--horizontal-pod-autoscaler-cpu-initialization-period). Questi valori predefiniti riducono il rischio, ma non possono eliminarlo quando l'avvio è lungo.
c. Container Java terminati con OOMKilled: Per impostazione predefinita, la JVM imposta il suo heap massimo al 25% della memoria del container (-XX:MaxRAMPercentage). Una JVM usa anche memoria al di fuori dell'heap, come metaspace, stack dei thread e code cache. Se si abbassa il limit di memoria senza verificare queste componenti, il container può superarlo e subire un OOM kill.
Se la request di memoria è inferiore al limit, il nodo può anche ospitare troppi pod e il kubelet può eseguire l'eviction dei pod quando la memoria del nodo scarseggia. Per i container JVM, impostare la request di memoria uguale al limit di memoria:
resources: requests: memory: 2Gi limits: memory: 2Gi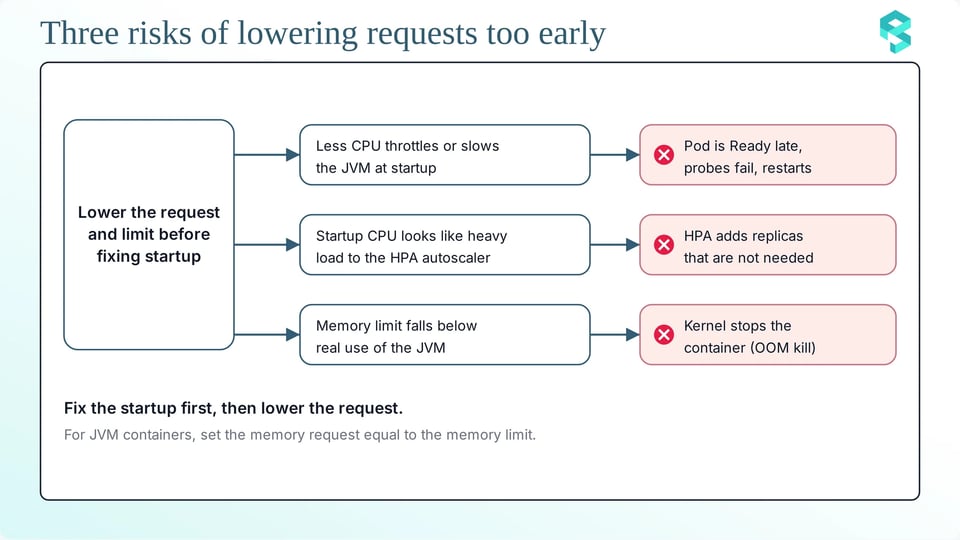
Come individuare le request sovradimensionate
Tre verifiche aiutano a individuare il problema:
a. Request vs. utilizzo: Per un primo sguardo, usare kubectl top. Richiede il Metrics Server e mostra l'utilizzo corrente di ogni container:
kubectl top pod --containers -n <namespace>Confrontare il risultato con le request nella spec del pod. Per un quadro completo, usare Prometheus. La metrica kube_pod_container_resource_requests di kube-state-metrics contiene le request. La metrica cAdvisor container_cpu_usage_seconds_total contiene l'uso di CPU. Questa query mostra il request gap di CPU per ogni container, usando il 95° percentile dell'utilizzo su 7 giorni:
expr: | sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) )b. Finestra di avvio vs. regime: La query del request gap mescola le due fasi, e i campioni di avvio alzano il 95° percentile, quindi il gap sembra più piccolo del vero gap a regime. Per separarle, usare la metrica kube_pod_start_time, che contiene l'orario di avvio di ogni pod. Questa query mantiene solo i campioni dei primi 10 minuti di un pod e restituisce il picco:
max by (namespace, pod, container) ( max_over_time( ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[1m]) and on (namespace, pod) (time() - kube_pod_start_time < 600) )[7d:1m] ))Questa query mantiene solo i campioni successivi ai primi 10 minuti e restituisce il 95° percentile. Mostra il regime:
max by (namespace, pod, container) ( quantile_over_time(0.95, ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m]) and on (namespace, pod) (time() - kube_pod_start_time > 600) )[7d:5m] ))Queste query presuppongono che l'avvio termini entro 10 minuti. Sostituire 600 con il tempo di avvio del proprio servizio. L'orario di avvio del pod non cambia quando un container si riavvia all'interno dello stesso pod, quindi un riavvio di questo tipo viene conteggiato come regime. La query di avvio usa inoltre un passo di 1 minuto, quindi può restituire un valore leggermente inferiore al picco reale quando il picco è breve.
Confrontare tre valori per un container: la request, il picco di avvio e l'utilizzo a regime. Un container con un grande divario tra request e utilizzo a regime, e un picco di avvio vicino alla request, è un classico servizio JVM sovradimensionato.
c. Classificare i workloads per request gap: Correggere prima i gap più grandi. Ordinare per gap assoluto in CPU, sommato su tutte le repliche, e non per rapporto. Un rapporto di dieci su un container minuscolo fa risparmiare poco. Queste query sono pesanti, quindi conviene memorizzare il gap in una recording rule e ordinare il risultato:
groups: - name: request-gap rules: - record: container:cpu_request_gap:cores expr: | clamp_min( sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) ), 0)Se si usa il Prometheus Operator, inserire lo stesso gruppo di regole sotto spec.groups di un oggetto PrometheusRule, con la label che il proprio Prometheus usa per selezionare le regole.
topk(20, sum by (namespace, container) (container:cpu_request_gap:cores))Eseguire la stessa verifica per la memoria con la metrica container_memory_working_set_bytes.
Come smettere di pagare l'avvio per tutta la vita del pod?
L'obiettivo è dare al pod risorse a livello di avvio durante l'avvio e risorse a regime dopo. Queste opzioni funzionano insieme:
a. Ridurre il costo dell'avvio: Meno lavoro all'avvio richiede meno CPU all'avvio, e questo abbassa il picco che determina la request. Spring Boot può creare i bean al primo utilizzo con spring.main.lazy-initialization=true. Il Class Data Sharing e la cache AOT possono eliminare parte del lavoro di caricamento delle classi. La cache AOT è arrivata con JDK 24 (JEP 483). Spring Framework supporta sia CDS sia la cache AOT. Il profiling mostra dove va a finire il tempo di avvio della propria applicazione.
b. Startup boost e VPA: Il Vertical Pod Autoscaler (VPA) ha una modalità di aggiornamento InPlaceOrRecreate. Questa modalità prova prima un resize in-place e ricrea il pod quando il resize in-place non è possibile. Su GKE, il CPU startup boost funziona insieme al VPA. Aumenta la request di CPU alla creazione del pod e mantiene la request più alta per durationSeconds dopo che il pod diventa Ready. Poi GKE riporta la request al valore di base con un resize in-place. Il boost si applica solo alla creazione del pod, quindi un riavvio del container all'interno dello stesso pod non riceve alcun boost. Al momento della stesura di questo articolo la funzionalità è in Preview e richiede GKE 1.36.0-gke.4447000 o successivo.
apiVersion: autoscaling.k8s.io/v1kind: VerticalPodAutoscalermetadata: name: example-vpaspec: targetRef: apiVersion: apps/v1 kind: Deployment name: example updatePolicy: updateMode: "Off" startupBoost: cpu: type: "Factor" factor: 2 durationSeconds: 10In questo esempio, il boost raddoppia la request di CPU (factor: 2) e la mantiene per 10 secondi dopo che il pod diventa Ready. Con updateMode impostato su Off, il VPA applica solo il boost e non apporta altre modifiche. Se si usa un HPA insieme al boost, definire una readiness probe e impostare durationSeconds su 0. Questo impedisce all'HPA di aggiungere repliche a causa del picco di CPU all'avvio.
c. Resize in-place in due fasi: Il resize in-place dei pod modifica la CPU e la memoria di un pod in esecuzione senza riavvio. La funzionalità ha raggiunto la beta in Kubernetes 1.33 ed è diventata stabile in Kubernetes 1.35. Un pod può partire con request e limit di CPU alti, e un controller può abbassarli dopo l'avvio. La resize policy predefinita per la CPU è NotRequired, e la si può dichiarare nel manifest:
containers: - name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequiredLe risorse si modificano tramite la subresource resize. Questo comando richiede kubectl 1.32 o successivo:
kubectl patch pod <pod-name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"requests":{"cpu":"300m"},"limits":{"cpu":"500m"}}}]}}'Questo esempio presuppone un pod Burstable, in cui la request è inferiore al limit. Un pod Guaranteed deve mantenere la request uguale al limit, perché un resize non può cambiare la classe QoS. I pod Windows e i pod soggetti alle policy statiche del CPU Manager o del Memory Manager non possono usare il resize in-place. Qualcuno deve inoltre attivare il resize. Una persona può eseguire la patch a mano, ma per molti pod serve un controller.
Per i container JVM, ridimensionare solo la CPU e lasciare invariato il limit di memoria, perché un limit di memoria più basso può causare un OOM kill.
d. startupProbe e tuning dell'HPA: Una startup probe sospende le probe di liveness e readiness finché l'applicazione non si è avviata. Previene i loop di riavvio durante un avvio lento. Puntarla allo stesso endpoint della liveness probe. Il tempo totale concesso dalla probe è failureThreshold x periodSeconds.
startupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24 # waits up to 24 x 5 = 120 secondsQuesto percorso richiede la dipendenza Spring Boot Actuator. Spring Boot abilita automaticamente gli endpoint di liveness e readiness quando l'applicazione gira su Kubernetes. Una startup probe non rende l'avvio più veloce, ma rende più sicura una request più bassa.
Anche l'HPA richiede attenzione. Il campo behavior dell'API autoscaling/v2 limita la velocità con cui l'HPA aggiunge repliche, così un breve picco di avvio non provoca una raffica di nuovi pod:
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: example-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: example minReplicas: 2 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70 behavior: scaleUp: stabilizationWindowSeconds: 60 policies: - type: Pods value: 2 periodSeconds: 60In questo esempio, l'HPA punta a un utilizzo di CPU del 70%. La finestra di scale-up di 60 secondi ritarda le decisioni di scale-up, così un breve picco di avvio non aggiunge repliche. L'HPA aggiunge al massimo 2 pod in ogni periodo di 60 secondi.
e. L'automazione di PerfectScale: PerfectScale corregge automaticamente lo spreco legato all'avvio. Una JVM ha bisogno di molta CPU solo all'avvio. Una singola raccomandazione media non funziona per entrambe le fasi. PerfectScale rileva automaticamente i servizi con requisiti di risorse elevati all'avvio e fornisce due raccomandazioni per ogni workload: una per l'avvio e una per il runtime a regime.
PerfectScale applica la raccomandazione di avvio alla creazione del pod, quindi adatta le risorse in-place in base alla raccomandazione di runtime una volta che il pod raggiunge il regime, aiutando a ottimizzare l'allocazione delle risorse in entrambe le fasi senza compromettere le prestazioni dell'applicazione. E non serve alcun riavvio del pod né alcun intervento manuale. Il pod non si porta più dietro request a livello di avvio per tutta la sua vita. PerfectScale dimensiona la raccomandazione di avvio sul fabbisogno più alto delle due fasi, così il nodo ha capacità sufficiente durante l'avvio. PerfectScale mostra separatamente le risorse di avvio e quelle a regime, così i numeri di costo e di spreco riflettono ciò di cui il workload aveva bisogno in ciascuna fase. PerfectScale usa il resize in-place quando il cluster lo supporta. Supporta Deployment, StatefulSet, DaemonSet e Argo Rollouts. Quando il cluster non supporta il resize in-place, PerfectScale usa invece il suo approccio sicuro standard.
PerfectScale rispetta inoltre i limiti di dimensione dell'heap JVM configurati: le raccomandazioni non superano mai l'heap massimo configurato né scendono sotto il minimo configurato. Per i container Java raccoglie l'utilizzo di memoria heap e non-heap, insieme alle metriche di garbage collection (GC), tra cui tempo di GC, numero di processori attivi e tipo di GC. La raccolta delle metriche JVM può essere abilitata durante l'installazione dell'agent PerfectScale, senza alcuna configurazione aggiuntiva. Questa funzionalità è supportata solo sui nodi Linux.
Ne beneficiano anche gli autoscaler dei nodi. PerfectScale confronta le impostazioni di Karpenter con le request dei workloads in esecuzione e raccomanda di fare prima il right-sizing dei workloads. Le raccomandazioni di Karpenter corrispondono così all'utilizzo reale e non a request gonfiate.
Un prima e dopo per un servizio. Questo esempio usa i numeri dell'esempio pratico qui sopra. Prima, la request corrisponde al picco di avvio:
resources: requests: cpu: "2" memory: 2Gi limits: cpu: "2" memory: 2GiDopo, la request corrisponde al regime, il limit mantiene margine per l'avvio e una startup probe protegge l'avvio lento:
resources: requests: cpu: 300m memory: 2Gi limits: cpu: "2" memory: 2GistartupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24Il rischio per l'affidabilità: il nodo deve avere CPU libera all'avvio, perché la request è di soli 300m. Applicare il boost o il resize al pod quando il nodo potrebbe essere occupato.
Conclusione
Le request sovradimensionate sono facili da creare e costose da mantenere. Lo scheduler, gli autoscaler dei nodi e alcune bollette cloud seguono le request e non l'utilizzo, quindi ogni CPU inutilizzata in una request costa comunque denaro.
L'avvio della JVM è una causa comune. La request è dimensionata per i primi secondi e resta per tutta la vita del pod. Ridurre soltanto la request non risolve il problema, perché causa throttling, repliche HPA extra e OOM kill. Ridurre prima il lavoro di avvio, oppure dimensionare separatamente l'avvio e il regime. PerfectScale lo fa automaticamente, in-place e senza riavvio.
Partecipi al workshop. Vikram Seshadri di DoiT mostra come dimensionare un pod JVM per il suo avvio e come ridimensionarlo al regime senza riavvio, nel workshop pratico "Java on K8s: The Startup vs. Steady-State Sizing Dilemma" il 28 ottobre 2026 alle 11:00 ET. Prenoti il suo posto.
Vuole vedere come PerfectScale esegue il right-sizing dei suoi workloads Java? Inizi gratuitamente o prenoti una demo.