


多くのKubernetesクラスタでは、Podが実際に使用する量をはるかに上回るCPUとメモリが予約されています。よくある原因が、Javaサービスの起動です。JVMは起動直後の数秒間に大量のCPUを必要とするため、チームはその瞬間を守るために高いリクエストを設定します。しかしそのリクエストは、起動処理が終わった後も、Podの生存期間全体にわたって高いまま残り続けます。
クラウドの請求額は、使用量ではなく予約量に従います。2 CPUをリクエストして、そのごく一部しか使わないPodでも、ノード上では2 CPUを占有し続けます。多数のレプリカにまたがると、この未使用の予約がクラスタコストの大きな部分を占めるようになります。
すぐに思いつく解決策はリクエストを下げることですが、これにはリスクも伴います。起動時の問題を放置したままリクエストを下げると、JVMの起動が遅くなり、プローブが失敗し、オートスケーラーがサービスに不要なレプリカを追加してしまいます。コストと信頼性は互いに逆方向へ引っ張り合うのです。本記事では、リクエストが肥大化する理由、そのコスト、そしてスケジューリングやノードスケーリングへの影響を解説します。さらに、過剰なリクエストの見つけ方と、信頼性を損なわずに修正する方法を紹介します。
過剰なリソースリクエストとは
リソースリクエストとは、Kubernetesがコンテナのために予約するCPUまたはメモリの量です。スケジューラーは各ノード上のリクエストを合計し、その合計がノードの割り当て可能なリソースを超えないようにします。
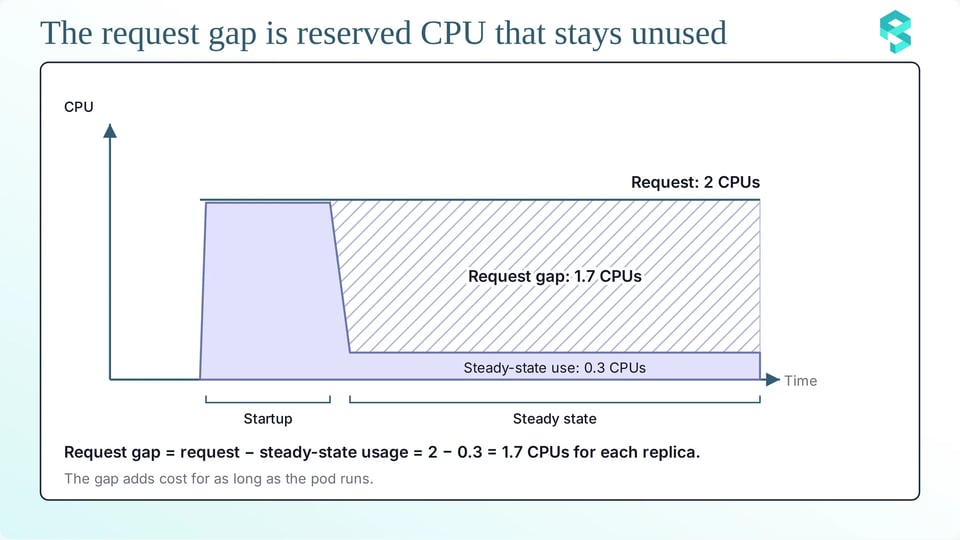
通常運用時にコンテナが必要とする量を大きく上回るリクエストは、過剰(overinflated)な状態です。この差分をリクエストギャップと呼びます。つまり、リクエストからコンテナの定常時使用量を引いた値です。
resources: requests: cpu: "2" # 起動直後の数秒間に合わせたサイズ memory: 4Gi limits: cpu: "2" memory: 4Giこの例では、リクエストは起動時のピークに合わせています。起動後にこのCPUのごく一部しか必要としない場合、予約の残りの部分がリクエストギャップになります。
CPUとメモリでは挙動が異なります。カーネルは、CPUを多く要求するコンテナの処理速度を抑えることはできますが、メモリを多く要求するコンテナを抑えることはできません。コンテナがリミットを超えるメモリを使用すると、カーネルはout-of-memory(OOM) killでコンテナを停止します。このため、CPUリクエストのほうがメモリリクエストよりも慎重なチューニングの余地があります。
リクエストが肥大化する理由
リクエストが肥大化する理由は3つあります。
a. 起動ピークに合わせたサイジング: JVMは起動直後の数秒間に、クラスのロード、JITコンパイラによるホットメソッドのコンパイル、ヒープの拡張、アプリケーションの構築をすべて行います。この処理には、その後のサービス運用よりもはるかに多くのCPUが必要です。CPUリミットが低いと、カーネルがJVMをスロットリングし、起動が遅くなります。この問題を経験したチームは、起動がうまくいくまでリクエストとリミットを引き上げます。新しい値は起動ピークには合いますが、Podの残りの生存期間には合いません。起動時にカーネルがJVMをスロットリングする仕組みについては、JVM起動時のCPUスロットリングをご覧ください。
b. コストより安全性: 2つのリスクは対等ではありません。サービスがスロットリングされたり強制終了されたりすると、アラートが発報し、誰かが対応しなければなりません。一方、サービスがCPUを無駄にしても何も発報されません。Kubernetesは未使用のリクエストをエラーとして報告しないからです。そのためエンジニアは、オンコールの呼び出しを避けられる値を選びます。高いリクエストこそが最も安全な選択なのです。
c. コピーされたデフォルト値: 多くのリクエストは、そもそも意図的に選ばれた値ですらありません。Helmチャートにはデフォルト値が付属し、チームは別のサービスのマニフェストをコピーし、古いテンプレートが重いサービスの数値を軽いサービスに持ち込みます。LimitRangeも、リクエストを持たないすべてのコンテナにデフォルトのリクエストを設定できます:
apiVersion: v1kind: LimitRangemetadata: name: default-requests namespace: examplespec: limits: - type: Container defaultRequest: cpu: "1" memory: 2GiこのLimitRangeは、リクエストを設定していないネームスペース内のすべてのコンテナに、1 CPUと2Giのメモリのリクエストを付与します。こうした値はチームや環境を越えて広がり、誰も見直すことはありません。

過剰なリクエストのコスト
コストは3つのステップで把握できます。
a. リクエストギャップの計算式: コンテナの無駄は、シンプルな式で求められます:
無駄 (vCPU時間): (リクエスト - 定常時使用量) x レプリカ数 x 時間コスト: 無駄 x vCPU時間あたりの単価メモリについても、GiB時間を使って同じ式を適用してください。定常時使用量には、起動後の使用量の高いパーセンタイル(95パーセンタイルなど)を選びます。パーセンタイルは通常のピークをカバーできるため、平均よりも安全です。
このギャップがどう金額に反映されるかは、プラットフォームによって異なります。標準のノードでは仮想マシンに対して課金されるため、リクエストギャップはクラスタに必要なノード数を押し上げます。GKE Autopilotでは、GoogleはPodがリクエストしたCPUとメモリに対して課金するため、リクエストギャップの1単位がそのまま直接コストになります。
b. 計算例: あるJavaサービスが100レプリカで稼働しているとします。起動を成功させるため、各レプリカは2 CPUをリクエストしています。起動後に1レプリカが必要とするのは、95パーセンタイルで約0.3 CPUです。これらの数値は一例であり、実際のサービスには固有の値があります。
- リクエストギャップは、レプリカあたり2 - 0.3 = 1.7 CPUです。
- 100レプリカでは、予約されながら使われていないCPUが170 CPUになります。
- 1か月は約730時間なので、無駄は毎月170 x 730 = 124,100 vCPU時間になります。
- この数値に、お使いのプラットフォームのvCPU時間あたりの単価を掛けると、月額コストが得られます。
メモリの場合、4 GiBをリクエストして定常時に2 GiBしか必要としないコンテナは、レプリカごとに2 GiBを無駄にします。
c. サービス横断のコスト: 1つのサービスなら修正は簡単ですが、多数のサービスとなると難しくなります。同じ肥大化した値が、レプリカ、サービス、クラスタ、環境を越えて繰り返されます。ステージングや開発クラスタは本番のリクエストをコピーしていることが多く、同じ無駄を抱え込みます。
リクエストはクォータも消費します。ResourceQuotaは、ネームスペース内のリクエストの合計を制限します:
apiVersion: v1kind: ResourceQuotametadata: name: team-quota namespace: examplespec: hard: requests.cpu: "40" requests.memory: 80Giこのクォータでは、ネームスペース内のすべてのPodが合計でリクエストできるのは40 CPUと80Giのメモリまでです。肥大化したリクエストは、実際の使用量よりはるかに先にこの予算を使い果たします。するとチームはより大きなクォータを要求し、問題はさらに拡大します。
過剰なリクエストがビンパッキングを壊す仕組み
リクエストは、3つの形でスケジューリングとノードスケーリングに影響します。
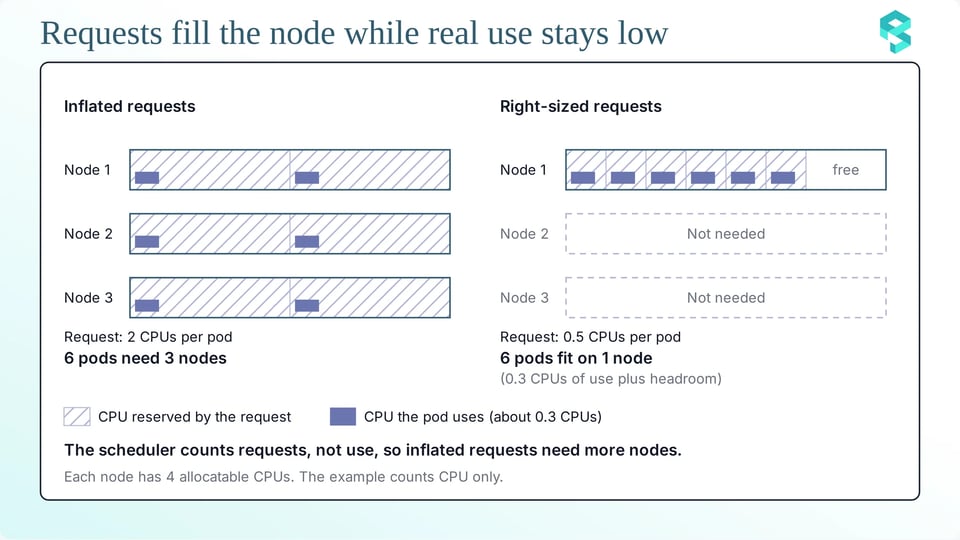
a. スケジューリングは使用量ではなくリクエストを見る: スケジューラーは、Podが何を使っているかを見ません。Podが何をリクエストしているかを見ます。
デフォルトでは、スケジューラーはLeastAllocated戦略でノードをスコアリングします。この戦略はリクエスト済みリソースが少ないノードを優先するため、Podをノード間に分散させます。MostAllocated戦略とRequestedToCapacityRatio戦略は、Podをより密に詰め込みます。3つの戦略はいずれもリクエストに基づいて動作します。したがって、より密な戦略を選んでも肥大化したリクエストは解消できません。詰め込まれるのは予約であって、実際の使用量ではないからです。
b. 取り残されるCPUと余分なノード: どのコンテナも使っていない予約済みCPUは、取り残された(stranded)状態になります。スケジューラーが使用済みとしてカウントするため、他のPodは使えません。その結果、同じPodを配置するためにより多くのノードが必要になります。ミスマッチはこれを悪化させます。CPUのリクエストが高くメモリのリクエストが低い場合、ノードはCPUが先に枯渇し、メモリは未使用のまま残ります。その逆も起こります。
c. ノードオートスケーリングへの影響: ノードオートスケーラーもリクエストに基づいて動作します。Cluster Autoscalerは、リソース不足でPodをスケジュールできないときにノードを追加します。ノードを削除する際は、リクエスト済みリソースの合計を割り当て可能リソースで割った値を、そのノードの使用率として計算します。デフォルトでは、この値が0.5(--scale-down-utilization-threshold)を下回って初めて、ノードは削除候補になります。肥大化したリクエストはこの値を高く保つため、実際の使用率が低いノードがクラスタに残り続けます。
Karpenterも同じ考え方に従います。保留中のPodのリソースリクエストを読み取ってノードを選択・起動し、そのコンソリデーションは使用量ではなくリクエストに基づいてPodを詰め込みます。リクエストを低く正確な値にすれば、どちらのツールもより少ないノードで運用できます。
平均ベースの推奨値が起動負荷の高いワークロードに通用しない理由
多くのツールは、コンテナの使用履歴からリクエストを推奨します。時間ウィンドウに対して、平均、パーセンタイル、ピークのいずれか1つの統計値を選びます。起動ピークのあるサービスでは、どの選択も異なる形で失敗します:
a. 低い統計値はピークを隠す: 平均は定常状態に合うため、推奨されるリクエストは低くなります。するとJVMは起動時に十分なCPUを得られず、カーネルにスロットリングされます。
b. 高い統計値はピークを含む: 最大値や非常に高いパーセンタイルは起動時のサンプルを含むため、推奨されるリクエストは起動に合わせた値になります。するとPodは生存期間全体にわたって起動レベルのCPUを予約し続け、無駄が残ります。
どちらの結果も、いずれか一方のフェーズにとって誤りです。誤差の大きさは、Podの起動頻度にも左右されます。頻繁なデプロイ、オートスケーリング、ノードの入れ替えはウィンドウ内の起動サンプルを増やすため、統計値はピーク寄りに動きます。単一の数値では、2つのフェーズを持つワークロードを表現できません。解決には、起動と定常状態を別々に扱う推奨値または仕組みが必要です。
起動問題を解決せずにリクエストを削減するリスク
起動の問題を解決せずにリクエストだけを下げると、3つの問題が発生します。
a. スロットリングとReadiness遅延: CPUリミットをリクエストと一緒に下げると、カーネルは起動時にJVMをスロットリングします。PodがReadyになるのが遅れ、ロールアウトに時間がかかり、startupプローブが失敗することもあります。失敗が繰り返されると、kubeletがコンテナを再起動し、新しいコンテナが同じ処理を繰り返します。リクエストだけを下げて高いリミットを維持する、またはリミットを設定しない場合は、ノードが混雑しているときにPodが得られるCPUシェアが小さくなるため、混雑したノードでは起動が遅くなります。
b. 起動時CPUによるHPAのスケールアウト: Horizontal Pod Autoscaler(HPA)は、CPU使用量をリクエストに対するパーセンテージとして測定します。次の式を使います:
desiredReplicas = ceil[ currentReplicas x ( currentMetricValue / desiredMetricValue ) ]リクエストが小さくなると、同じCPU使用量がパーセンテージとしては大きく見えます。そのため起動ピークが高負荷に見え、HPAがレプリカを追加します。新しいレプリカが起動し、それぞれの起動がまた別のピークを生みます。デフォルトでは、初期Readiness遅延は30秒(--horizontal-pod-autoscaler-initial-readiness-delay)で、HPAはCPU初期化期間の5分間(--horizontal-pod-autoscaler-cpu-initialization-period)はCPUサンプルをスキップする場合があります。これらのデフォルト値はリスクを軽減しますが、起動時間が長い場合には完全には取り除けません。
c. OOMKilledされるJavaコンテナ: デフォルトでは、JVMは最大ヒープをコンテナメモリの25%(-XX:MaxRAMPercentage)に設定します。JVMはヒープ以外のメモリも使用します。メタスペース、スレッドスタック、コードキャッシュなどです。これらを確認せずにメモリリミットを下げると、コンテナがリミットを超過し、OOM killされる可能性があります。
メモリリクエストがリミットより低い場合、ノードに過剰な数のPodが配置され、ノードのメモリが不足するとkubeletがPodを退避(evict)させることがあります。JVMコンテナでは、メモリリクエストをメモリリミットと同じ値に設定してください:
resources: requests: memory: 2Gi limits: memory: 2Gi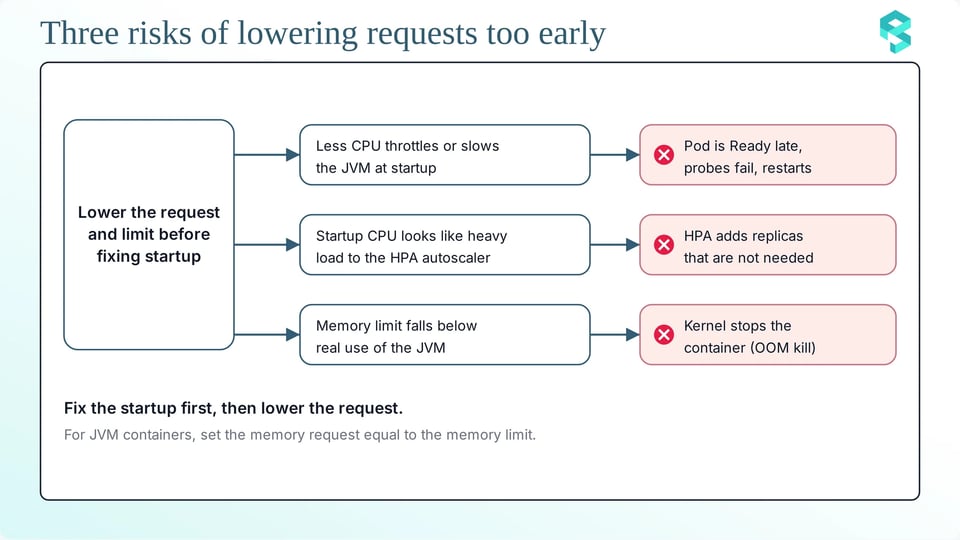
過剰なリクエストの見つけ方
問題の発見に役立つチェックは3つあります。
a. リクエストと使用量の比較: まずはkubectl topを使います。Metrics Serverが必要で、各コンテナの現在の使用量が表示されます:
kubectl top pod --containers -n <namespace>結果をPodスペックのリクエストと比較します。全体像を把握するにはPrometheusを使います。kube-state-metricsのメトリクスkube_pod_container_resource_requestsにはリクエストが入っています。cAdvisorのメトリクスcontainer_cpu_usage_seconds_totalにはCPU使用量が入っています。次のクエリは、7日間の使用量の95パーセンタイルを使って、各コンテナのCPUリクエストギャップを表示します:
expr: | sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) )b. 起動ウィンドウと定常状態の分離: リクエストギャップのクエリは両方のフェーズを混在させており、起動時のサンプルが95パーセンタイルを押し上げるため、ギャップは真の定常時ギャップより小さく見えます。両者を分離するには、各Podの起動時刻を保持するメトリクスkube_pod_start_timeを使います。次のクエリはPodの最初の10分間のサンプルだけを残し、ピークを返します:
max by (namespace, pod, container) ( max_over_time( ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[1m]) and on (namespace, pod) (time() - kube_pod_start_time < 600) )[7d:1m] ))次のクエリは最初の10分間を過ぎた後のサンプルだけを残し、95パーセンタイルを返します。これが定常状態を示します:
max by (namespace, pod, container) ( quantile_over_time(0.95, ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m]) and on (namespace, pod) (time() - kube_pod_start_time > 600) )[7d:5m] ))これらのクエリは、起動が10分以内に終わることを前提としています。600は、サービスの起動時間に合わせて変更してください。同じPod内でコンテナが再起動してもPodの起動時刻は変わらないため、そのような再起動は定常状態としてカウントされます。また、起動クエリは1分のステップを使うため、ピークが短い場合は真のピークよりやや低い値になることがあります。
1つのコンテナについて、リクエスト、起動ピーク、定常時使用量の3つの値を比較します。リクエストと定常時使用量の間に大きなギャップがあり、かつ起動ピークがリクエストに近いコンテナは、過剰リクエストの典型的なJVMサービスです。
c. リクエストギャップによるワークロードのランク付け: まず最大のギャップから修正します。比率ではなく、全レプリカで合計したCPUの絶対ギャップでランク付けします。小さなコンテナで比率が10倍でも、節約効果はわずかだからです。これらのクエリは重いため、ギャップをレコーディングルールに保存して結果をランク付けします:
groups: - name: request-gap rules: - record: container:cpu_request_gap:cores expr: | clamp_min( sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) ), 0)Prometheus Operatorを使っている場合は、同じルールグループをPrometheusRuleオブジェクトのspec.groups配下に置き、Prometheusがルールの選択に使うラベルを付けてください。
topk(20, sum by (namespace, container) (container:cpu_request_gap:cores))メモリについても、メトリクスcontainer_memory_working_set_bytesを使って同じチェックを行ってください。
起動用リソースのコストを払い続けないために
目標は、起動時には起動レベルのリソースを、その後は定常レベルのリソースをPodに与えることです。以下の選択肢は組み合わせて使えます。
a. 起動コストの削減: 起動時の処理が少なければ、起動時に必要なCPUも減り、リクエストを決めるピークが下がります。Spring Bootはspring.main.lazy-initialization=trueで、初回使用時にBeanを生成できます。Class Data Sharing(CDS)とAOTキャッシュは、クラスロード処理の一部を削減できます。AOTキャッシュはJDK 24(JEP 483)で導入されました。Spring FrameworkはCDSとAOTキャッシュの両方をサポートしています。プロファイリングを行えば、自分のサービスの起動時間がどこに費やされているかがわかります。
b. 起動ブーストとVPA: Vertical Pod Autoscaler(VPA)にはInPlaceOrRecreate更新モードがあります。このモードはまずインプレースリサイズを試み、インプレースリサイズができない場合にPodを再作成します。GKEでは、CPU startup boostがVPAと連携して動作します。Pod作成時にCPUリクエストを引き上げ、PodがReadyになってからdurationSecondsの間、高いリクエストを維持します。その後、GKEはリクエストをインプレースでベースライン値に戻します。ブーストはPod作成時にのみ適用されるため、同じPod内でのコンテナ再起動にはブーストは適用されません。執筆時点でこの機能はプレビュー版で、GKE 1.36.0-gke.4447000以降が必要です。
apiVersion: autoscaling.k8s.io/v1kind: VerticalPodAutoscalermetadata: name: example-vpaspec: targetRef: apiVersion: apps/v1 kind: Deployment name: example updatePolicy: updateMode: "Off" startupBoost: cpu: type: "Factor" factor: 2 durationSeconds: 10この例では、ブーストがCPUリクエストを2倍にし(factor: 2)、PodがReadyになってから10秒間それを維持します。updateModeをOffに設定すると、VPAはブーストのみを適用し、それ以外の変更は行いません。ブーストと併せてHPAを使う場合は、readinessプローブを定義し、durationSecondsを0に設定してください。これにより、起動時のCPUピークを理由にHPAがレプリカを追加するのを防げます。
c. 2フェーズのインプレースリサイズ: インプレースPodリサイズは、再起動なしで実行中のPodのCPUとメモリを変更します。この機能はKubernetes 1.33でベータに到達し、Kubernetes 1.35で安定版になりました。Podを高いCPUリクエストとリミットで起動し、起動後にコントローラーがそれらを下げることができます。CPUのデフォルトのリサイズポリシーはNotRequiredで、マニフェストに明示することもできます:
containers: - name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequiredリソースの変更はresizeサブリソースを通じて行います。このコマンドにはkubectl 1.32以降が必要です:
kubectl patch pod <pod-name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"requests":{"cpu":"300m"},"limits":{"cpu":"500m"}}}]}}'この例は、リクエストがリミットより低いBurstable Podを想定しています。Guaranteed Podでは、リサイズでQoSクラスを変更できないため、リクエストをリミットと同じ値に保つ必要があります。WindowsのPodや、staticなCPU/Memoryマネージャーポリシー下のPodは、インプレースリサイズを使用できません。また、誰かがリサイズをトリガーする必要があります。手動でパッチを実行することもできますが、多数のPodに対してはコントローラーが実行しなければなりません。
JVMコンテナでは、CPUのみをリサイズし、メモリリミットはそのままにしてください。メモリリミットを下げるとOOM killが発生する可能性があるからです。
d. startupProbeとHPAのチューニング: startupプローブは、アプリケーションが起動を終えるまでlivenessプローブとreadinessプローブを停止させます。起動に時間がかかる間の再起動ループを防ぎます。livenessプローブと同じエンドポイントを指定してください。プローブが許容する合計時間はfailureThreshold x periodSecondsです。
startupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24 # 最大 24 x 5 = 120 秒まで待機このパスにはSpring Boot Actuatorの依存関係が必要です。Spring Bootは、アプリケーションがKubernetes上で動作している場合、livenessとreadinessのエンドポイントを自動的に有効化します。startupプローブは起動を速くはしませんが、低いリクエストをより安全なものにします。
HPAにも配慮が必要です。autoscaling/v2 APIのbehaviorフィールドはHPAがレプリカを追加する速度を制限するため、短い起動ピークで新しいPodが一気に増えることはありません:
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: example-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: example minReplicas: 2 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70 behavior: scaleUp: stabilizationWindowSeconds: 60 policies: - type: Pods value: 2 periodSeconds: 60この例では、HPAはCPU使用率70%を目標とします。60秒のスケールアップウィンドウがスケールアップの判断を遅らせるため、短い起動ピークではレプリカが追加されません。HPAは60秒ごとに最大2つのPodを追加します。
e. PerfectScaleによる自動化: PerfectScaleは、起動時の無駄を自動的に解消します。JVMが大量のCPUを必要とするのは起動時だけです。平均に基づく単一の推奨値では、両方のフェーズに対応できません。PerfectScaleは起動時に高いリソースを必要とするサービスを自動的に検出し、ワークロードごとに起動用と定常稼働用の2つの推奨値を提供します。
PerfectScaleはPod作成時に起動用の推奨値を適用し、Podが定常状態に達すると、リソースをインプレースで定常稼働用の推奨値に調整します。これにより、アプリケーションのパフォーマンスを損なうことなく、両方のフェーズに対してリソース割り当てを最適化できます。Podの再起動も手動の介入も不要です。Podが起動レベルのリクエストを生存期間中ずっと抱え続けることはなくなります。PerfectScaleは起動用の推奨値を2つのフェーズのうち必要量の大きいほうに合わせてサイジングするため、起動中もノードに十分な容量が確保されます。PerfectScaleは起動時と定常時のリソースを別々に表示するため、コストと無駄の数値は、各フェーズでワークロードが実際に必要とした量を反映します。 PerfectScaleは、クラスタが対応している場合はインプレースリサイズを使用します。Deployment、StatefulSet、DaemonSet、Argo Rolloutsをサポートしています。クラスタがインプレースリサイズに対応していない場合、PerfectScaleは代わりに標準の安全なアプローチを使用します。
PerfectScaleはJVMのヒープサイズ制限も尊重するため、推奨値が設定済みの最大ヒープサイズを超えたり、設定済みの最小値を下回ったりすることはありません。Javaコンテナについては、ヒープおよび非ヒープのメモリ使用量に加え、GC時間、アクティブプロセッサ数、GCタイプを含むガベージコレクション(GC)メトリクスを収集します。JVMメトリクスの収集はPerfectScaleエージェントのインストール時に有効化でき、追加のセットアップは不要です。この機能はLinuxノードでのみサポートされています。
ノードオートスケーラーにもメリットがあります。PerfectScaleはKarpenterの設定を稼働中のワークロードのリクエストと照合し、まずワークロードのライトサイジングを推奨します。これにより、Karpenterの推奨値は肥大化したリクエストではなく、実際の使用量に合致するようになります。
1つのサービスのビフォーアフターを見てみましょう。この例では、前述の計算例の数値を使います。修正前は、リクエストが起動ピークに合わせられています:
resources: requests: cpu: "2" memory: 2Gi limits: cpu: "2" memory: 2Gi修正後は、リクエストは定常状態に合わせ、リミットは起動のための余裕を残し、startupプローブが遅い起動を保護します:
resources: requests: cpu: 300m memory: 2Gi limits: cpu: "2" memory: 2GistartupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24信頼性上のリスクは、リクエストが300mしかないため、起動時にノードに空きCPUが必要になることです。ノードが混雑する可能性がある場合は、Podをブーストまたはリサイズしてください。
まとめ
過剰なリクエストは簡単に生まれ、放置すると高くつきます。スケジューラー、ノードオートスケーラー、そして一部のクラウド請求は、使用量ではなくリクエストに従います。つまり、リクエスト内の未使用CPUはすべてコストになり続けるのです。
JVMの起動はよくある原因です。リクエストは最初の数秒間に合わせられ、Podの生存期間全体にわたって残り続けます。リクエストを下げるだけでは解決しません。スロットリング、HPAによる余分なレプリカ、OOM killを引き起こすからです。まず起動時の処理を減らすか、起動と定常状態を別々にサイジングしてください。PerfectScaleはこれを自動で、インプレースかつ再起動なしで実行します。
ワークショップにぜひご参加ください。2026年10月28日 午前11時(米国東部時間)開催のハンズオンワークショップ「Java on K8s: The Startup vs. Steady-State Sizing Dilemma」では、DoiTのVikram Seshadriが、起動に合わせたJVM Podのサイジングと、再起動なしで定常状態にリサイズする方法を解説します。今すぐ席を確保する。
PerfectScaleがJavaワークロードをどのようにライトサイジングするか、実際に確かめてみませんか?無料で始める、またはデモを予約する。