
PerfectScale
Requests surdimensionnées : un problème de coût
Pourquoi les requests Kubernetes dimensionnées pour le démarrage de la JVM gaspillent de l'argent, comment elles cassent le bin-packing et l'autoscaling, et comment les ajuster sans nuire à la fiabilité.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


De nombreux clusters Kubernetes réservent bien plus de CPU et de mémoire que leurs pods n'en consomment. Une cause fréquente : le démarrage d'un service Java. Une JVM a besoin de beaucoup de CPU pendant ses premières secondes, alors les équipes définissent une request élevée pour protéger ce moment. Cette request reste ensuite élevée pendant toute la vie du pod, bien après la fin du travail de démarrage.
La facture cloud suit la réservation, pas l'utilisation. Un pod qui réserve 2 CPU mais n'en utilise qu'une petite partie bloque quand même 2 CPU sur son nœud. Multipliée par de nombreux replicas, cette réservation inutilisée devient une part importante du coût d'un cluster.
La solution évidente consiste à baisser les requests, mais elle comporte aussi un risque. Si vous baissez une request sans régler le problème de démarrage, la JVM démarre lentement, les probes échouent et l'autoscaler ajoute des replicas dont le service n'a pas besoin. Coût et fiabilité tirent dans des directions opposées. Cet article explique pourquoi les requests gonflent, ce qu'elles coûtent et comment elles affectent le scheduling et le scaling des nœuds. Il montre ensuite comment les identifier et comment les corriger sans nuire à la fiabilité.
Qu'est-ce qu'une request de ressources surdimensionnée ?
Une request de ressources correspond à la quantité de CPU ou de mémoire que Kubernetes réserve pour un conteneur. Le scheduler additionne les requests sur chaque nœud et maintient le total en dessous des ressources allouables du nœud.
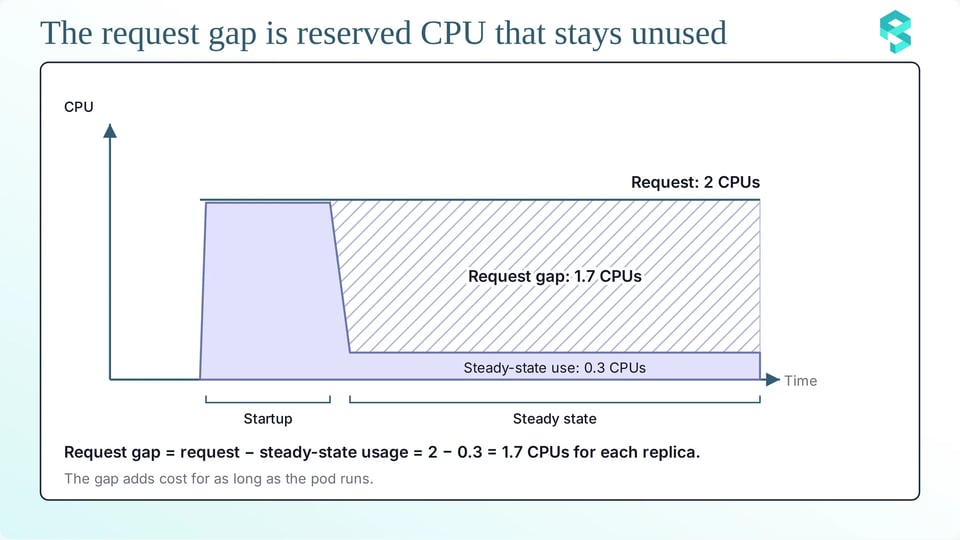
Une request est surdimensionnée lorsqu'elle dépasse largement ce dont le conteneur a besoin en fonctionnement normal. Nous appelons cette différence l'écart de request (request gap) : la request moins l'utilisation en régime stable du conteneur.
resources: requests: cpu: "2" # sized for the first seconds of startup memory: 4Gi limits: cpu: "2" memory: 4GiDans cet exemple, la request correspond au pic de démarrage. Si le conteneur n'a besoin que d'une petite partie de ce CPU après le démarrage, le reste de la réservation constitue l'écart de request.
CPU et mémoire se comportent différemment. Le noyau peut ralentir un conteneur qui demande plus de CPU, mais pas un conteneur qui demande plus de mémoire. Lorsqu'un conteneur utilise plus de mémoire que sa limit, le noyau l'arrête avec un kill out-of-memory (OOM). C'est pourquoi une request CPU offre plus de marge d'ajustement fin qu'une request mémoire.
Pourquoi les requests gonflent-elles ?
Les requests gonflent pour trois raisons :
a. Un dimensionnement calé sur le pic de démarrage : une JVM charge les classes, compile les méthodes chaudes avec les compilateurs JIT, agrandit son heap et construit l'application, tout cela dans les premières secondes. Ce travail nécessite beaucoup plus de CPU que ce dont le service a besoin ensuite. Si la limit CPU est basse, le noyau throttle la JVM et le démarrage devient lent. Une équipe qui a connu ce problème augmente la request et la limit jusqu'à ce que le démarrage fonctionne. La nouvelle valeur correspond au pic de démarrage, mais pas au reste de la vie du pod. Pour comprendre comment le noyau throttle une JVM au démarrage, lisez CPU throttling during JVM startup.
b. La sécurité avant le coût : les deux risques ne se valent pas. Lorsqu'un service est throttlé ou tué, une alerte se déclenche et quelqu'un doit intervenir. Lorsqu'un service gaspille du CPU, rien ne se déclenche, car Kubernetes ne signale pas les requests inutilisées comme une erreur. Les ingénieurs choisissent donc la valeur qui les protège des alertes, et une request élevée est le choix le plus sûr.
c. Des valeurs par défaut copiées : beaucoup de requests ne sont jamais vraiment choisies. Un chart Helm est livré avec des valeurs par défaut, une équipe copie le manifeste d'un autre service, et un vieux template transporte les chiffres d'un service lourd vers un service léger. Un LimitRange peut aussi définir une request par défaut pour chaque conteneur qui n'en a pas :
apiVersion: v1kind: LimitRangemetadata: name: default-requests namespace: examplespec: limits: - type: Container defaultRequest: cpu: "1" memory: 2GiCe LimitRange attribue une request de 1 CPU et 2 Gi de mémoire à chaque conteneur du namespace qui n'en définit aucune. Ces valeurs se propagent entre équipes et environnements, et personne ne les revérifie.

Le coût des requests surdimensionnées
Trois étapes permettent de mesurer le coût :
a. La formule de l'écart de request : le gaspillage d'un conteneur suit une formule simple :
waste (vCPU-hours): (request - steady-state usage) x replicas x hourscost: waste x price per vCPU-hourUtilisez la même formule pour la mémoire avec des GiB-heures. Pour l'utilisation en régime stable, choisissez un percentile élevé de l'utilisation après le démarrage, comme le 95e. Un percentile est plus sûr que la moyenne, car il couvre les pics normaux.
La façon dont l'écart se transforme en argent dépend de votre plateforme. Sur des nœuds standards, vous payez les machines virtuelles : l'écart de request augmente donc le nombre de nœuds dont le cluster a besoin. Sur GKE Autopilot, Google facture le CPU et la mémoire que vos pods demandent, chaque unité d'écart de request est donc un coût direct.
b. Exemple chiffré : supposons qu'un service Java fasse tourner 100 replicas. Chaque replica demande 2 CPU pour que le démarrage fonctionne. Après le démarrage, un replica a besoin d'environ 0,3 CPU au 95e percentile. Ces chiffres sont un exemple ; votre service a les siens.
- L'écart de request est de 2 - 0,3 = 1,7 CPU par replica.
- Pour 100 replicas, l'écart représente 170 CPU réservés et non utilisés.
- Un mois compte environ 730 heures, le gaspillage est donc de 170 x 730 = 124 100 vCPU-heures par mois.
- Multipliez ce chiffre par le prix d'un vCPU-heure sur votre plateforme pour obtenir le coût mensuel.
Côté mémoire, un conteneur qui demande 4 GiB mais n'a besoin que de 2 GiB en régime stable gaspille 2 GiB par replica.
c. Le coût à l'échelle des services : corriger un service est facile ; en corriger beaucoup l'est moins. La même valeur gonflée se répète à travers les replicas, les services, les clusters et les environnements. Les clusters de staging et de développement copient souvent les requests de production et transportent donc le même gaspillage.
Les requests consomment aussi du quota. Un ResourceQuota limite la somme des requests dans un namespace :
apiVersion: v1kind: ResourceQuotametadata: name: team-quota namespace: examplespec: hard: requests.cpu: "40" requests.memory: 80GiAvec ce quota, l'ensemble des pods du namespace peut demander 40 CPU et 80 Gi de mémoire. Les requests gonflées épuisent ce budget bien avant l'utilisation réelle. L'équipe demande alors un quota plus grand, et le problème s'amplifie.
Comment les requests surdimensionnées cassent-elles le bin-packing ?
Les requests affectent le scheduling et le scaling des nœuds de trois façons :
a. Le scheduling s'appuie sur les requests, pas sur l'utilisation : le scheduler ne regarde pas ce qu'un pod utilise. Il regarde ce que le pod demande.
Par défaut, le scheduler note les nœuds avec la stratégie LeastAllocated. Cette stratégie privilégie les nœuds avec moins de ressources demandées et répartit donc les pods entre les nœuds. Les stratégies MostAllocated et RequestedToCapacityRatio placent les pods de façon plus dense. Les trois stratégies travaillent sur les requests. Une stratégie plus dense ne peut donc pas corriger des requests gonflées : elle regroupe les réservations, pas l'utilisation réelle.
b. CPU immobilisé et nœuds supplémentaires : le CPU réservé qu'aucun conteneur n'utilise est immobilisé. Les autres pods ne peuvent pas s'en servir, car le scheduler le compte comme occupé. Le cluster a alors besoin de plus de nœuds pour placer les mêmes pods. Les déséquilibres aggravent la situation. Si les requests sont élevées en CPU et faibles en mémoire, un nœud manque de CPU en premier et sa mémoire reste inutilisée. L'inverse se produit aussi.
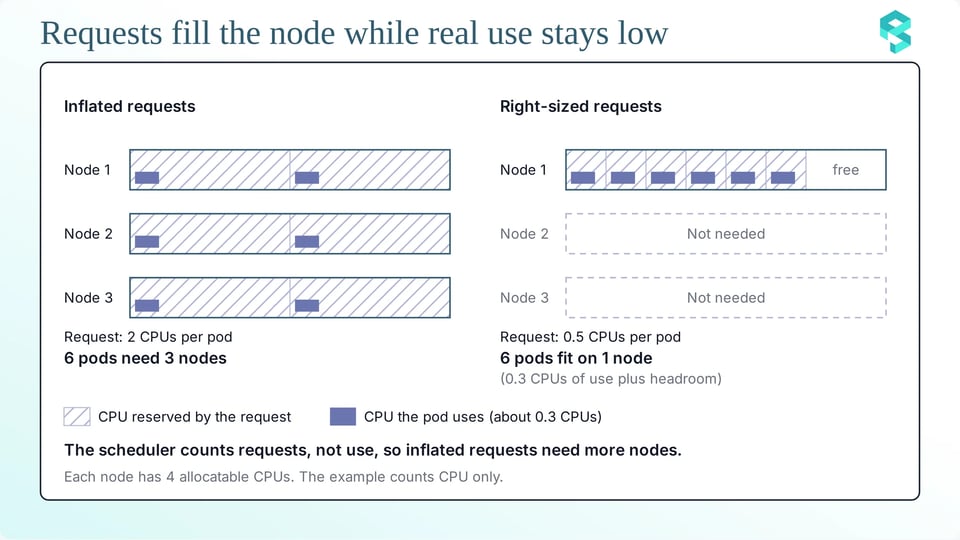
c. Effet sur l'autoscaling des nœuds : les autoscalers de nœuds travaillent eux aussi sur les requests. Cluster Autoscaler ajoute un nœud lorsqu'un pod ne peut pas être schedulé faute de ressources suffisantes. Pour supprimer un nœud, il calcule le taux d'utilisation du nœud comme la somme des ressources demandées divisée par les ressources allouables. Par défaut, un nœud ne devient candidat à la suppression que lorsque cette valeur passe sous 0,5 (--scale-down-utilization-threshold). Des requests gonflées maintiennent cette valeur élevée, si bien que des nœuds peu utilisés en réalité restent dans le cluster.
Karpenter suit la même logique. Il lit les requests de ressources des pods en attente pour choisir et lancer des nœuds, et sa consolidation regroupe les pods d'après les requests, pas d'après l'utilisation. Des requests plus basses et plus précises permettent aux deux outils de fonctionner avec moins de nœuds.
Pourquoi les recommandations basées sur la moyenne échouent-elles pour les workloads à démarrage intensif ?
De nombreux outils recommandent une request à partir de l'historique d'utilisation d'un conteneur. Ils choisissent une statistique sur une fenêtre de temps : la moyenne, un percentile ou le pic. Pour un service avec un pic de démarrage, chaque choix échoue d'une manière différente :
a. Une statistique basse masque le pic : la moyenne correspond au régime stable, donc la request recommandée est basse. La JVM reçoit alors trop peu de CPU au démarrage et le noyau la throttle.
b. Une statistique haute inclut le pic : le maximum, ou un percentile très élevé, inclut les échantillons de démarrage, donc la request recommandée correspond au démarrage. Le pod réserve alors un niveau de CPU de démarrage pendant toute sa vie, et le gaspillage demeure.
Les deux résultats sont faux pour l'une des deux phases. L'ampleur de l'erreur dépend aussi de la fréquence de démarrage des pods. Les déploiements fréquents, l'autoscaling et les remplacements de nœuds ajoutent plus d'échantillons de démarrage à la fenêtre, et la statistique se rapproche du pic. Un seul chiffre ne peut pas décrire un workload à deux phases. La solution passe par une recommandation ou un mécanisme qui traite séparément le démarrage et le régime stable.
Les risques de réduire les requests sans corriger le démarrage
Baisser une request sans corriger le démarrage pose trois problèmes :
a. Throttling et readiness tardive : si vous baissez la limit CPU en même temps que la request, le noyau throttle la JVM au démarrage. Le pod passe Ready tardivement, les rollouts durent plus longtemps et la startup probe peut échouer. Si l'échec se répète, le kubelet redémarre le conteneur, et le nouveau conteneur refait le même travail. Si vous baissez seulement la request en gardant une limit élevée ou aucune limit, le pod obtient une plus petite part de CPU lorsque le nœud est chargé, et le démarrage est lent sur les nœuds chargés.
b. Scale-out du HPA à cause du CPU de démarrage : le Horizontal Pod Autoscaler (HPA) mesure l'utilisation CPU en pourcentage de la request. Il utilise cette formule :
desiredReplicas = ceil[ currentReplicas x ( currentMetricValue / desiredMetricValue ) ]Une request plus petite fait paraître la même utilisation CPU plus grande en pourcentage. Un pic de démarrage peut donc ressembler à une forte charge, et le HPA ajoute des replicas. Les nouveaux replicas démarrent, et chaque démarrage crée un nouveau pic. Par défaut, le délai initial de readiness est de 30 secondes (--horizontal-pod-autoscaler-initial-readiness-delay), et le HPA peut ignorer les échantillons CPU pendant la période d'initialisation CPU de 5 minutes (--horizontal-pod-autoscaler-cpu-initialization-period). Ces valeurs par défaut réduisent le risque, mais ne l'éliminent pas quand le démarrage est long.
c. Conteneurs Java tués par OOM : par défaut, la JVM fixe son heap maximal à 25 % de la mémoire du conteneur (-XX:MaxRAMPercentage). Une JVM utilise aussi de la mémoire en dehors du heap, comme le metaspace, les piles de threads et le cache de code. Si vous baissez la limit mémoire sans vérifier ces composants, le conteneur peut la dépasser et subir un kill OOM.
Si la request mémoire est inférieure à la limit, le nœud peut aussi accueillir trop de pods, et le kubelet peut évincer des pods lorsque le nœud manque de mémoire. Pour les conteneurs JVM, définissez la request mémoire égale à la limit mémoire :
resources: requests: memory: 2Gi limits: memory: 2Gi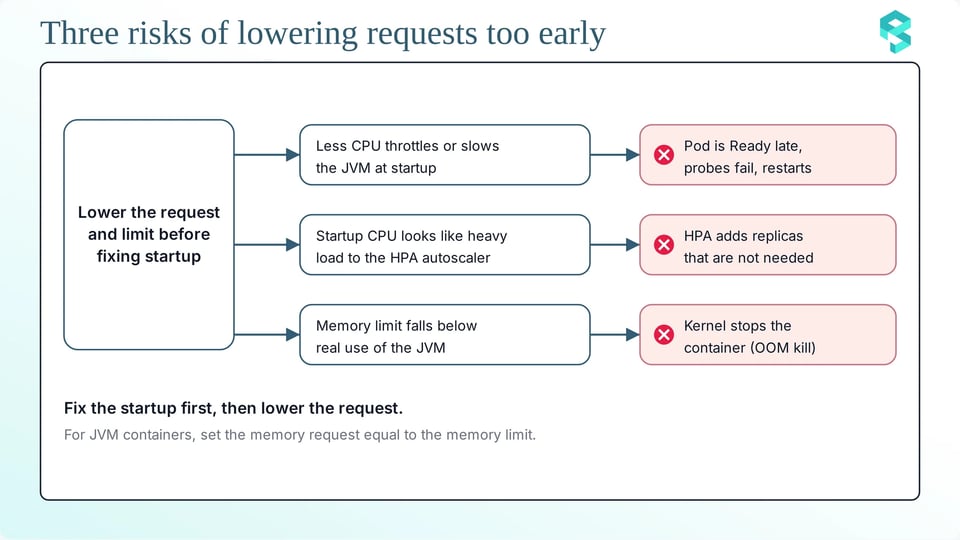
Comment identifier les requests surdimensionnées
Trois vérifications vous aideront à repérer le problème :
a. Requests face à l'utilisation : pour un premier aperçu, utilisez kubectl top. Cette commande nécessite le Metrics Server et affiche l'utilisation actuelle de chaque conteneur :
kubectl top pod --containers -n <namespace>Comparez le résultat avec les requests de la spec du pod. Pour une vue complète, utilisez Prometheus. La métrique kube_pod_container_resource_requests de kube-state-metrics contient les requests. La métrique cAdvisor container_cpu_usage_seconds_total contient l'utilisation CPU. Cette requête affiche l'écart de request CPU pour chaque conteneur, en utilisant le 95e percentile de l'utilisation sur 7 jours :
expr: | sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) )b. Fenêtre de démarrage face au régime stable : la requête d'écart de request mélange les deux phases, et les échantillons de démarrage relèvent le 95e percentile, si bien que l'écart paraît plus petit que le véritable écart en régime stable. Pour les séparer, utilisez la métrique kube_pod_start_time, qui contient l'heure de démarrage de chaque pod. Cette requête ne conserve que les échantillons des 10 premières minutes d'un pod et renvoie le pic :
max by (namespace, pod, container) ( max_over_time( ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[1m]) and on (namespace, pod) (time() - kube_pod_start_time < 600) )[7d:1m] ))Cette requête ne conserve que les échantillons après les 10 premières minutes et renvoie le 95e percentile. Elle montre le régime stable :
max by (namespace, pod, container) ( quantile_over_time(0.95, ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m]) and on (namespace, pod) (time() - kube_pod_start_time > 600) )[7d:5m] ))Ces requêtes supposent que le démarrage se termine en moins de 10 minutes. Remplacez 600 par le temps de démarrage de votre service. L'heure de démarrage du pod ne change pas lorsqu'un conteneur redémarre dans le même pod : un tel redémarrage compte donc comme du régime stable. La requête de démarrage utilise aussi un pas d'une minute, elle peut donc afficher une valeur légèrement inférieure au vrai pic lorsque celui-ci est court.
Comparez trois valeurs pour un conteneur : la request, le pic de démarrage et l'utilisation en régime stable. Un conteneur avec un grand écart entre la request et l'utilisation en régime stable, et un pic de démarrage proche de la request, est le cas classique d'un service JVM surdimensionné.
c. Classer les workloads par écart de request : corrigez d'abord les plus grands écarts. Classez selon l'écart absolu en CPU, additionné sur tous les replicas, et non selon le ratio. Un ratio de dix sur un conteneur minuscule rapporte peu. Ces requêtes sont lourdes : stockez l'écart dans une recording rule et classez le résultat :
groups: - name: request-gap rules: - record: container:cpu_request_gap:cores expr: | clamp_min( sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) ), 0)Si vous utilisez le Prometheus Operator, placez le même groupe de règles sous spec.groups d'un objet PrometheusRule, avec le label que votre Prometheus utilise pour sélectionner les règles.
topk(20, sum by (namespace, container) (container:cpu_request_gap:cores))Faites la même vérification pour la mémoire avec la métrique container_memory_working_set_bytes.
Comment ne plus payer le démarrage pendant toute la vie du pod ?
L'objectif est de donner au pod des ressources de niveau démarrage au démarrage, puis des ressources de régime stable ensuite. Ces options se combinent :
a. Réduire le coût du démarrage : moins de travail au démarrage demande moins de CPU au démarrage, ce qui abaisse le pic qui détermine la request. Spring Boot peut créer les beans à la première utilisation avec spring.main.lazy-initialization=true. Le Class Data Sharing et le cache AOT peuvent éliminer une partie du travail de chargement des classes. Le cache AOT est arrivé dans JDK 24 (JEP 483). Spring Framework prend en charge à la fois CDS et le cache AOT. Le profiling révèle où passe votre temps de démarrage.
b. Startup boost et VPA : le Vertical Pod Autoscaler (VPA) dispose d'un mode de mise à jour InPlaceOrRecreate. Ce mode tente d'abord un redimensionnement in-place et recrée le pod lorsque ce n'est pas possible. Sur GKE, le CPU startup boost fonctionne avec le VPA. Il augmente la request CPU à la création du pod et conserve la request plus élevée pendant durationSeconds après que le pod passe Ready. GKE ramène ensuite la request à sa valeur de base, in place. Le boost ne s'applique qu'à la création du pod : un redémarrage de conteneur dans le même pod n'en bénéficie pas. La fonctionnalité est en Preview au moment de la rédaction et nécessite GKE 1.36.0-gke.4447000 ou une version ultérieure.
apiVersion: autoscaling.k8s.io/v1kind: VerticalPodAutoscalermetadata: name: example-vpaspec: targetRef: apiVersion: apps/v1 kind: Deployment name: example updatePolicy: updateMode: "Off" startupBoost: cpu: type: "Factor" factor: 2 durationSeconds: 10Dans cet exemple, le boost double la request CPU (factor: 2) et la conserve pendant 10 secondes après que le pod passe Ready. Avec updateMode réglé sur Off, le VPA n'applique que le boost et ne fait aucun autre changement. Si vous utilisez un HPA avec le boost, définissez une readiness probe et réglez durationSeconds sur 0. Cela empêche le HPA d'ajouter des replicas à cause du pic CPU au démarrage.
c. Redimensionnement in-place en deux phases : le redimensionnement in-place modifie le CPU et la mémoire d'un pod en cours d'exécution sans redémarrage. La fonctionnalité est passée en bêta dans Kubernetes 1.33 et est devenue stable dans Kubernetes 1.35. Un pod peut démarrer avec une request et une limit CPU élevées, puis un contrôleur peut les abaisser après le démarrage. La politique de redimensionnement par défaut pour le CPU est NotRequired, et vous pouvez la déclarer dans le manifeste :
containers: - name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequiredVous modifiez les ressources via la sous-ressource resize. Cette commande nécessite kubectl 1.32 ou une version ultérieure :
kubectl patch pod <pod-name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"requests":{"cpu":"300m"},"limits":{"cpu":"500m"}}}]}}'Cet exemple suppose un pod Burstable, où la request est inférieure à la limit. Un pod Guaranteed doit garder la request égale à la limit, car un redimensionnement ne peut pas changer la classe QoS. Les pods Windows et les pods soumis à une politique static du CPU Manager ou du Memory Manager ne peuvent pas utiliser le redimensionnement in-place. Quelqu'un doit aussi déclencher le redimensionnement. Une personne peut lancer le patch à la main, mais pour de nombreux pods, un contrôleur doit s'en charger.
Pour les conteneurs JVM, ne redimensionnez que le CPU et laissez la limit mémoire telle quelle, car une limit mémoire plus basse peut provoquer un kill OOM.
d. startupProbe et réglage du HPA : une startup probe suspend les probes de liveness et de readiness jusqu'au démarrage de l'application. Elle évite les boucles de redémarrage pendant un démarrage lent. Pointez-la vers le même endpoint que la liveness probe. Le temps total autorisé par la probe est failureThreshold x periodSeconds.
startupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24 # waits up to 24 x 5 = 120 secondsCe chemin nécessite la dépendance Spring Boot Actuator. Spring Boot active automatiquement les endpoints de liveness et de readiness lorsque l'application tourne sur Kubernetes. Une startup probe n'accélère pas le démarrage, mais elle rend une request plus basse plus sûre.
Le HPA demande aussi de l'attention. Le champ behavior de l'API autoscaling/v2 limite la vitesse à laquelle le HPA ajoute des replicas, afin qu'un court pic de démarrage ne déclenche pas une rafale de nouveaux pods :
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: example-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: example minReplicas: 2 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70 behavior: scaleUp: stabilizationWindowSeconds: 60 policies: - type: Pods value: 2 periodSeconds: 60Dans cet exemple, le HPA vise 70 % d'utilisation CPU. La fenêtre de scale-up de 60 secondes retarde les décisions de scale-up, pour qu'un court pic de démarrage n'ajoute pas de replicas. Le HPA ajoute au maximum 2 pods par période de 60 secondes.
e. L'automatisation PerfectScale : PerfectScale corrige automatiquement le gaspillage lié au démarrage. Une JVM n'a besoin de beaucoup de CPU qu'au démarrage. Une seule recommandation moyenne ne convient pas aux deux phases. PerfectScale détecte automatiquement les services dont le démarrage exige beaucoup de ressources et fournit deux recommandations pour chaque workload : une pour le démarrage et une pour le régime stable.
PerfectScale applique la recommandation de démarrage à la création du pod, puis ajuste les ressources in place pour correspondre à la recommandation de runtime une fois le pod en régime stable, ce qui vous aide à optimiser l'allocation des ressources pour les deux phases sans compromettre les performances de l'application. Aucun redémarrage de pod ni intervention manuelle n'est nécessaire. Le pod ne porte plus des requests de niveau démarrage pendant toute sa vie. PerfectScale dimensionne la recommandation de démarrage sur le besoin le plus élevé des deux phases, pour que le nœud dispose d'assez de capacité pendant le démarrage. PerfectScale affiche séparément les ressources de démarrage et de régime stable, afin que les chiffres de coût et de gaspillage reflètent ce dont le workload avait besoin dans chaque phase. PerfectScale utilise le redimensionnement in-place lorsque le cluster le prend en charge. Il fonctionne avec les Deployments, StatefulSets, DaemonSets et Argo Rollouts. Lorsque le cluster ne prend pas en charge le redimensionnement in-place, PerfectScale applique son approche standard et sûre.
PerfectScale respecte aussi vos limites de taille de heap JVM : les recommandations ne dépassent jamais le heap maximal que vous avez configuré et ne descendent jamais sous le minimum configuré. Pour les conteneurs Java, il collecte l'utilisation mémoire heap et non-heap, ainsi que les métriques de garbage collection (GC), dont le temps de GC, le nombre de processeurs actifs et le type de GC. La collecte des métriques JVM peut être activée lors de l'installation de l'agent PerfectScale, sans configuration supplémentaire. Cette fonctionnalité n'est prise en charge que sur les nœuds Linux.
Les autoscalers de nœuds en profitent aussi. PerfectScale compare vos réglages Karpenter aux requests des workloads en cours d'exécution et recommande de commencer par le right-sizing des workloads. Les recommandations Karpenter correspondent alors à l'utilisation réelle et non à des requests gonflées.
Un avant/après pour un service. Cet exemple reprend les chiffres de l'exemple chiffré ci-dessus. Avant, la request correspond au pic de démarrage :
resources: requests: cpu: "2" memory: 2Gi limits: cpu: "2" memory: 2GiAprès, la request correspond au régime stable, la limit garde de la marge pour le démarrage et une startup probe protège le démarrage lent :
resources: requests: cpu: 300m memory: 2Gi limits: cpu: "2" memory: 2GistartupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24Le risque pour la fiabilité : le nœud doit disposer de CPU libre au démarrage, car la request n'est que de 300m. Boostez ou redimensionnez le pod lorsque le nœud risque d'être chargé.
Conclusion
Les requests surdimensionnées sont faciles à créer et coûteuses à conserver. Le scheduler, les autoscalers de nœuds et certaines factures cloud suivent les requests et non l'utilisation : chaque CPU inutilisé dans une request continue donc de coûter de l'argent.
Le démarrage de la JVM est une cause fréquente. La request correspond aux premières secondes, et elle reste pendant toute la vie du pod. Baisser la request ne suffit pas : cela provoque du throttling, des replicas HPA superflus et des kills OOM. Réduisez d'abord le travail de démarrage, ou dimensionnez séparément le démarrage et le régime stable. PerfectScale le fait automatiquement, in place et sans redémarrage.
Participez au workshop. Vikram Seshadri, de DoiT, montre comment dimensionner un pod JVM pour son démarrage, puis le redimensionner vers le régime stable sans redémarrage, lors du workshop pratique Java on K8s: The Startup vs. Steady-State Sizing Dilemma le 28 octobre 2026 à 11 h (heure de l'Est). Réservez votre place.
Vous voulez voir comment PerfectScale applique le right-sizing à vos workloads Java ? Commencez gratuitement ou réservez une démo.