
PerfectScale
Das Kostenproblem überhöhter Requests
Warum auf den JVM-Start dimensionierte Kubernetes Requests Geld verschwenden, wie sie Bin-Packing und Autoscaling stören – und wie Sie Right-Sizing umsetzen, ohne die Zuverlässigkeit zu gefährden.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


Viele Kubernetes-Cluster reservieren deutlich mehr CPU und Speicher, als ihre Pods tatsächlich nutzen. Eine häufige Ursache ist der Start eines Java-Services. Eine JVM braucht in den ersten Sekunden viel CPU, also setzen Teams einen hohen Request, um diesen Moment abzusichern. Der Request bleibt dann für die gesamte Lebensdauer des Pods hoch – lange nachdem die Startarbeit abgeschlossen ist.
Die Cloud-Rechnung richtet sich nach der Reservierung, nicht nach der Nutzung. Ein Pod, der 2 CPUs reserviert, aber nur einen kleinen Teil davon nutzt, blockiert trotzdem 2 CPUs auf seinem Node. Über viele Replicas hinweg wird diese ungenutzte Reservierung zu einem erheblichen Teil der Clusterkosten.
Die naheliegende Lösung ist, die Requests zu senken – doch genau das ist riskant. Senken Sie einen Request, ohne das Startproblem zu lösen, startet die JVM langsam, Probes schlagen fehl, und der Autoscaler fügt Replicas hinzu, die der Service gar nicht braucht. Kosten und Zuverlässigkeit ziehen in entgegengesetzte Richtungen. Dieser Artikel erklärt, warum Requests wachsen, was sie kosten und wie sie Scheduling und Node-Skalierung beeinflussen. Anschließend zeigt er, wie Sie überhöhte Requests aufspüren und beheben, ohne die Zuverlässigkeit zu gefährden.
Was sind überhöhte Resource Requests?
Ein Resource Request ist die Menge an CPU oder Speicher, die Kubernetes für einen Container reserviert. Der Scheduler summiert die Requests auf jedem Node und hält die Gesamtsumme unterhalb der allokierbaren Ressourcen des Nodes.
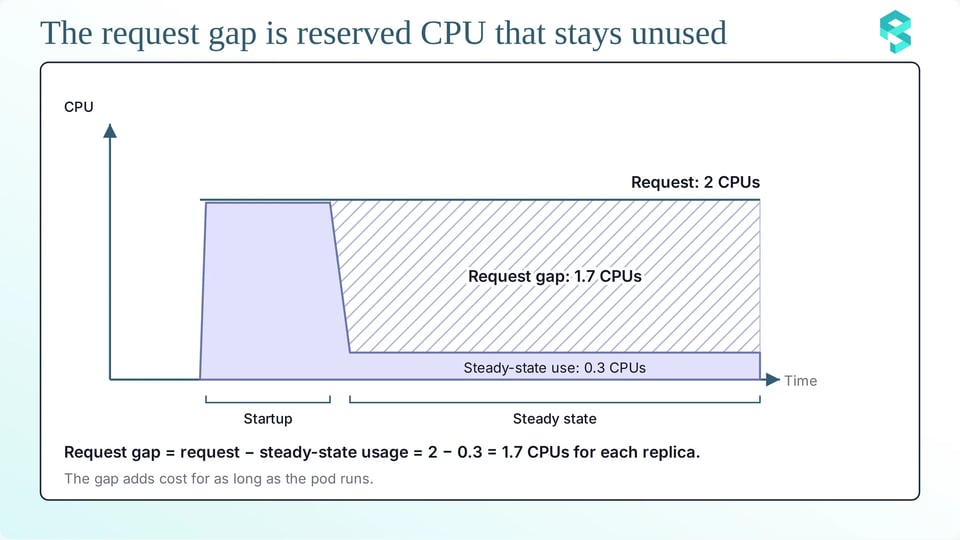
Ein Request ist überhöht, wenn er deutlich größer ist als das, was der Container im Normalbetrieb braucht. Die Differenz nennen wir das Request-Gap: der Request minus die Steady-State-Nutzung des Containers.
resources: requests: cpu: "2" # dimensioniert für die ersten Sekunden des Starts memory: 4Gi limits: cpu: "2" memory: 4GiIn diesem Beispiel entspricht der Request dem Start-Peak. Braucht der Container nach dem Start nur einen kleinen Teil dieser CPU, ist der Rest der Reservierung das Request-Gap.
CPU und Speicher verhalten sich unterschiedlich. Der Kernel kann einen Container drosseln, der mehr CPU will, aber er kann keinen Container drosseln, der mehr Speicher will. Nutzt ein Container mehr Speicher als sein Limit, stoppt ihn der Kernel mit einem Out-of-Memory-Kill (OOM). Deshalb bietet ein CPU-Request mehr Spielraum für vorsichtiges Tuning als ein Memory-Request.
Warum werden Requests zu hoch angesetzt?
Requests wachsen aus drei Gründen:
a. Dimensionierung auf den Start-Peak: Eine JVM lädt Klassen, kompiliert häufig genutzte Methoden mit den JIT-Compilern, vergrößert ihren Heap und baut die Anwendung auf – alles in den ersten Sekunden. Diese Arbeit braucht weit mehr CPU, als der Service später benötigt. Ist das CPU-Limit niedrig, drosselt der Kernel die JVM, und der Start wird langsam. Ein Team, das dieses Problem erlebt hat, erhöht Request und Limit, bis der Start funktioniert. Der neue Wert passt zum Start-Peak, aber nicht zum Rest der Pod-Lebensdauer. Wie der Kernel eine JVM beim Start drosselt, lesen Sie unter CPU throttling during JVM startup.
b. Sicherheit vor Kosten: Die beiden Risiken sind nicht gleich groß. Wird ein Service gedrosselt oder beendet, löst das einen Alert aus, und jemand muss das Problem beheben. Verschwendet ein Service CPU, löst das gar nichts aus, weil Kubernetes ungenutzte Requests nicht als Fehler meldet. Engineers wählen daher den Wert, der sie vor Alerts schützt – und ein hoher Request ist die sicherste Wahl.
c. Kopierte Standardwerte: Viele Requests werden gar nicht bewusst gewählt. Ein Helm-Chart kommt mit Default-Werten, ein Team kopiert das Manifest eines anderen Services, und ein altes Template trägt die Zahlen eines schweren Services in einen leichten. Auch eine LimitRange kann einen Default-Request für jeden Container setzen, der keinen hat:
apiVersion: v1kind: LimitRangemetadata: name: default-requests namespace: examplespec: limits: - type: Container defaultRequest: cpu: "1" memory: 2GiDiese LimitRange weist jedem Container im Namespace, der keinen Request setzt, 1 CPU und 2Gi Speicher zu. Diese Werte verbreiten sich über Teams und Umgebungen hinweg, und niemand prüft sie erneut.

Was überhöhte Requests kosten
Drei Schritte machen die Kosten sichtbar:
a. Die Request-Gap-Formel: Die Verschwendung eines Containers folgt einer einfachen Formel:
waste (vCPU-hours): (request - steady-state usage) x replicas x hourscost: waste x price per vCPU-hourFür Speicher nutzen Sie dieselbe Formel mit GiB-Stunden. Wählen Sie für die Steady-State-Nutzung ein hohes Perzentil der Nutzung nach dem Start, etwa das 95. Ein Perzentil ist sicherer als der Durchschnitt, weil es normale Lastspitzen abdeckt.
Wie das Gap zu Geld wird, hängt von Ihrer Plattform ab. Auf Standard-Nodes zahlen Sie für die virtuellen Maschinen, sodass das Request-Gap die Anzahl der benötigten Nodes erhöht. Auf GKE Autopilot berechnet Google die CPU und den Speicher, die Ihre Pods anfordern – jede Einheit Request-Gap ist dort ein direkter Kostenpunkt.
b. Rechenbeispiel: Angenommen, ein Java-Service läuft mit 100 Replicas. Jede Replica fordert 2 CPUs an, damit der Start funktioniert. Nach dem Start braucht eine Replica am 95. Perzentil etwa 0,3 CPUs. Diese Zahlen sind ein Beispiel – Ihr Service hat seine eigenen.
- Das Request-Gap beträgt 2 - 0,3 = 1,7 CPUs pro Replica.
- Bei 100 Replicas sind das 170 CPUs, die reserviert, aber ungenutzt sind.
- Ein Monat hat etwa 730 Stunden, also beträgt die Verschwendung 170 x 730 = 124.100 vCPU-Stunden pro Monat.
- Multiplizieren Sie diese Zahl mit dem Preis einer vCPU-Stunde auf Ihrer Plattform, um die monatlichen Kosten zu erhalten.
Beim Speicher verschwendet ein Container, der 4 GiB anfordert, aber im Steady State nur 2 GiB braucht, 2 GiB pro Replica.
c. Kosten über Services hinweg: Ein einzelner Service ist schnell korrigiert, viele Services sind schwieriger. Derselbe überhöhte Wert wiederholt sich über Replicas, Services, Cluster und Umgebungen. Staging- und Entwicklungscluster übernehmen oft die Produktions-Requests und tragen dieselbe Verschwendung mit sich.
Requests verbrauchen außerdem Quota. Eine ResourceQuota begrenzt die Summe der Requests in einem Namespace:
apiVersion: v1kind: ResourceQuotametadata: name: team-quota namespace: examplespec: hard: requests.cpu: "40" requests.memory: 80GiMit dieser Quota können alle Pods im Namespace zusammen 40 CPUs und 80Gi Speicher anfordern. Überhöhte Requests verbrauchen dieses Budget, lange bevor die echte Nutzung es tut. Dann beantragt das Team eine größere Quota, und das Problem wächst weiter.
Wie überhöhte Requests das Bin-Packing stören
Requests beeinflussen Scheduling und Node-Skalierung auf drei Arten:
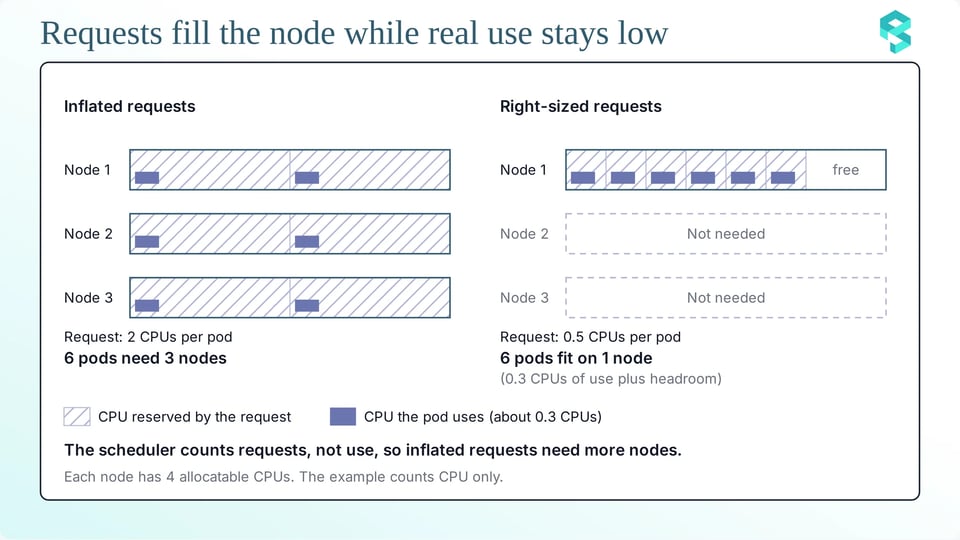
a. Scheduling nutzt Requests, nicht die Nutzung: Der Scheduler schaut nicht darauf, was ein Pod nutzt. Er schaut darauf, was der Pod anfordert.
Standardmäßig bewertet der Scheduler Nodes mit der LeastAllocated-Strategie. Diese Strategie bevorzugt Nodes mit weniger angeforderten Ressourcen und verteilt Pods daher über die Nodes. Die Strategien MostAllocated und RequestedToCapacityRatio packen Pods dichter. Alle drei Strategien arbeiten mit Requests. Eine dichtere Strategie kann überhöhte Requests daher nicht beheben, denn sie packt die Reservierungen und nicht die reale Nutzung.
b. Brachliegende CPU und zusätzliche Nodes: Reservierte CPU, die kein Container nutzt, liegt brach. Andere Pods können sie nicht nutzen, weil der Scheduler sie als belegt zählt. Der Cluster braucht dann mehr Nodes, um dieselben Pods zu platzieren. Ungleichgewichte verschärfen das Problem: Sind die Requests bei CPU hoch und bei Speicher niedrig, geht einem Node zuerst die CPU aus, und sein Speicher bleibt ungenutzt. Der umgekehrte Fall kommt ebenfalls vor.
c. Auswirkung auf das Node-Autoscaling: Auch Node-Autoscaler arbeiten mit Requests. Der Cluster Autoscaler fügt einen Node hinzu, wenn ein Pod wegen unzureichender Ressourcen nicht eingeplant werden kann. Um einen Node zu entfernen, berechnet er dessen Auslastung als Summe der angeforderten Ressourcen geteilt durch die allokierbaren Ressourcen. Standardmäßig wird ein Node erst dann zum Kandidaten für die Entfernung, wenn dieser Wert unter 0,5 liegt (--scale-down-utilization-threshold). Überhöhte Requests halten den Wert hoch, sodass Nodes mit geringer realer Nutzung im Cluster verbleiben.
Karpenter folgt demselben Prinzip. Es liest die Resource Requests wartender Pods, um Nodes auszuwählen und zu starten, und seine Consolidation packt Pods anhand der Requests, nicht anhand der Nutzung. Niedrigere und genauere Requests ermöglichen beiden Tools den Betrieb mit weniger Nodes.
Warum durchschnittsbasierte Empfehlungen bei startintensiven Workloads scheitern
Viele Tools leiten eine Request-Empfehlung aus dem Nutzungsverlauf eines Containers ab. Sie wählen eine Kennzahl über ein Zeitfenster: den Durchschnitt, ein Perzentil oder den Spitzenwert. Bei einem Service mit Start-Peak scheitert jede dieser Varianten auf andere Weise:
a. Eine niedrige Kennzahl verdeckt den Peak: Der Durchschnitt passt zum Steady State, der empfohlene Request ist also niedrig. Die JVM bekommt beim Start zu wenig CPU, und der Kernel drosselt sie.
b. Eine hohe Kennzahl schließt den Peak ein: Das Maximum oder ein sehr hohes Perzentil enthält die Start-Samples, der empfohlene Request passt also zum Start. Der Pod reserviert dann für seine gesamte Lebensdauer CPU auf Start-Niveau, und die Verschwendung bleibt.
Beide Ergebnisse sind für jeweils eine der Phasen falsch. Die Größe des Fehlers hängt auch davon ab, wie oft Pods starten. Häufige Deployments, Autoscaling und Node-Austausch fügen dem Zeitfenster mehr Start-Samples hinzu, sodass die Kennzahl Richtung Peak wandert. Eine einzelne Zahl kann einen Workload mit zwei Phasen nicht beschreiben. Die Lösung braucht eine Empfehlung oder einen Mechanismus, der Start und Steady State getrennt behandelt.
Risiken, wenn Sie Requests senken, ohne das Startproblem zu lösen
Ein niedrigerer Request ohne Startkorrektur verursacht drei Probleme:
a. Throttling und verzögerte Readiness: Senken Sie das CPU-Limit zusammen mit dem Request, drosselt der Kernel die JVM beim Start. Der Pod wird spät Ready, Rollouts dauern länger, und die Startup Probe kann fehlschlagen. Wiederholt sich der Fehler, startet das Kubelet den Container neu, und der neue Container wiederholt dieselbe Arbeit. Senken Sie nur den Request und behalten ein hohes oder gar kein Limit, bekommt der Pod auf einem ausgelasteten Node einen kleineren CPU-Anteil – der Start ist auf stark genutzten Nodes also langsam.
b. HPA-Scale-out durch Start-CPU: Der Horizontal Pod Autoscaler (HPA) misst die CPU-Nutzung als Prozentsatz des Requests. Er verwendet diese Formel:
desiredReplicas = ceil[ currentReplicas x ( currentMetricValue / desiredMetricValue ) ]Ein kleinerer Request lässt dieselbe CPU-Nutzung prozentual größer wirken. Ein Start-Peak kann daher wie hohe Last aussehen, und der HPA fügt Replicas hinzu. Neue Replicas starten, und jeder Start erzeugt einen weiteren Peak. Standardmäßig beträgt die initiale Readiness-Verzögerung 30 Sekunden (--horizontal-pod-autoscaler-initial-readiness-delay), und der HPA kann CPU-Samples während der CPU-Initialisierungsphase von 5 Minuten überspringen (--horizontal-pod-autoscaler-cpu-initialization-period). Diese Defaults reduzieren das Risiko, können es aber nicht beseitigen, wenn der Start lange dauert.
c. OOMKilled Java-Container: Standardmäßig setzt die JVM ihren maximalen Heap auf 25 % des Container-Speichers (-XX:MaxRAMPercentage). Eine JVM nutzt außerdem Speicher außerhalb des Heaps, etwa Metaspace, Thread-Stacks und den Code-Cache. Senken Sie das Memory-Limit, ohne diese Anteile zu prüfen, kann der Container es überschreiten und einen OOM-Kill erhalten.
Ist der Memory-Request niedriger als das Limit, kann der Node außerdem zu viele Pods aufnehmen, und das Kubelet kann Pods verdrängen, wenn dem Node der Speicher knapp wird. Setzen Sie für JVM-Container den Memory-Request gleich dem Memory-Limit:
resources: requests: memory: 2Gi limits: memory: 2Gi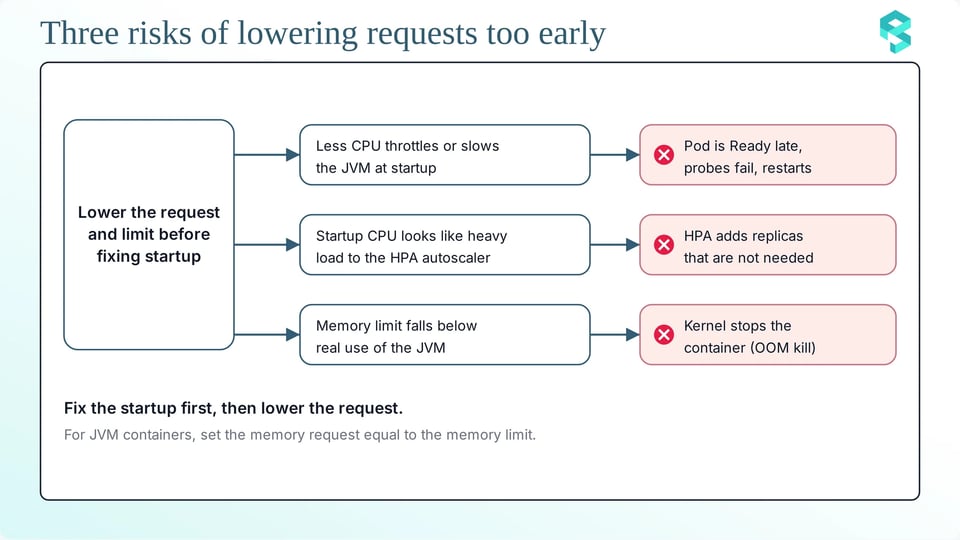
So finden Sie überhöhte Requests
Drei Prüfungen helfen Ihnen, das Problem zu finden:
a. Requests vs. Nutzung: Für einen ersten Blick nutzen Sie kubectl top. Der Befehl benötigt den Metrics Server und zeigt die aktuelle Nutzung pro Container:
kubectl top pod --containers -n <namespace>Vergleichen Sie das Ergebnis mit den Requests in der Pod-Spezifikation. Für ein vollständiges Bild nutzen Sie Prometheus. Die Metrik kube_pod_container_resource_requests aus kube-state-metrics enthält die Requests. Die cAdvisor-Metrik container_cpu_usage_seconds_total enthält die CPU-Nutzung. Diese Query zeigt das CPU-Request-Gap pro Container, basierend auf dem 95. Perzentil der Nutzung über 7 Tage:
expr: | sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) )b. Startfenster vs. Steady State: Die Request-Gap-Query mischt beide Phasen, und die Start-Samples heben das 95. Perzentil an, sodass das Gap kleiner aussieht als das wahre Steady-State-Gap. Um die Phasen zu trennen, nutzen Sie die Metrik kube_pod_start_time, die die Startzeit jedes Pods enthält. Diese Query behält nur die Samples aus den ersten 10 Minuten eines Pods und liefert den Spitzenwert:
max by (namespace, pod, container) ( max_over_time( ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[1m]) and on (namespace, pod) (time() - kube_pod_start_time < 600) )[7d:1m] ))Diese Query behält nur die Samples nach den ersten 10 Minuten und liefert das 95. Perzentil. Sie zeigt den Steady State:
max by (namespace, pod, container) ( quantile_over_time(0.95, ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m]) and on (namespace, pod) (time() - kube_pod_start_time > 600) )[7d:5m] ))Diese Queries gehen davon aus, dass der Start innerhalb von 10 Minuten endet. Ersetzen Sie 600 durch die Startzeit Ihres Services. Die Pod-Startzeit ändert sich nicht, wenn ein Container innerhalb desselben Pods neu startet – ein solcher Neustart zählt also als Steady State. Die Start-Query nutzt außerdem einen Schritt von 1 Minute und kann daher etwas unter dem wahren Peak liegen, wenn der Peak kurz ist.
Vergleichen Sie drei Werte pro Container: den Request, den Start-Peak und die Steady-State-Nutzung. Ein Container mit großem Abstand zwischen Request und Steady-State-Nutzung und einem Start-Peak nahe am Request ist der klassische überdimensionierte JVM-Service.
c. Workloads nach Request-Gap priorisieren: Beheben Sie die größten Gaps zuerst. Sortieren Sie nach dem absoluten Gap in CPUs, summiert über alle Replicas, nicht nach dem Verhältnis. Ein Faktor zehn bei einem winzigen Container spart wenig. Diese Queries sind rechenintensiv – speichern Sie das Gap deshalb in einer Recording Rule und sortieren Sie das Ergebnis:
groups: - name: request-gap rules: - record: container:cpu_request_gap:cores expr: | clamp_min( sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) ), 0)Wenn Sie den Prometheus Operator verwenden, legen Sie dieselbe Rule Group unter spec.groups eines PrometheusRule-Objekts an – mit dem Label, über das Ihr Prometheus Rules auswählt.
topk(20, sum by (namespace, container) (container:cpu_request_gap:cores))Führen Sie dieselbe Prüfung für Speicher mit der Metrik container_memory_working_set_bytes durch.
So zahlen Sie nicht ein Pod-Leben lang für den Start
Das Ziel: Der Pod bekommt beim Start Ressourcen auf Start-Niveau und danach Ressourcen auf Steady-State-Niveau. Diese Optionen wirken zusammen:
a. Startkosten reduzieren: Weniger Startarbeit braucht weniger CPU beim Start, und das senkt den Peak, der den Request bestimmt. Spring Boot kann Beans mit spring.main.lazy-initialization=true erst bei der ersten Nutzung erzeugen. Class Data Sharing und der AOT-Cache können einen Teil des Class-Loadings einsparen. Der AOT-Cache kam mit JDK 24 (JEP 483). Das Spring Framework unterstützt sowohl CDS als auch den AOT-Cache. Profiling zeigt, wohin Ihre eigene Startzeit fließt.
b. Startup-Boost und VPA: Der Vertical Pod Autoscaler (VPA) hat einen InPlaceOrRecreate-Update-Modus. Dieser Modus versucht zuerst einen In-Place-Resize und erstellt den Pod neu, wenn ein In-Place-Resize nicht möglich ist. Auf GKE arbeitet der CPU Startup Boost mit dem VPA zusammen. Er erhöht den CPU-Request beim Erstellen des Pods und behält den höheren Request für durationSeconds, nachdem der Pod Ready wird. Danach setzt GKE den Request in place auf den Basiswert zurück. Der Boost greift nur beim Erstellen des Pods – ein Container-Neustart innerhalb desselben Pods bekommt keinen Boost. Das Feature ist zum Zeitpunkt des Verfassens dieses Artikels im Preview-Status und benötigt GKE 1.36.0-gke.4447000 oder neuer.
apiVersion: autoscaling.k8s.io/v1kind: VerticalPodAutoscalermetadata: name: example-vpaspec: targetRef: apiVersion: apps/v1 kind: Deployment name: example updatePolicy: updateMode: "Off" startupBoost: cpu: type: "Factor" factor: 2 durationSeconds: 10In diesem Beispiel verdoppelt der Boost den CPU-Request (factor: 2) und behält ihn für 10 Sekunden, nachdem der Pod Ready wird. Mit updateMode auf Off wendet der VPA nur den Boost an und nimmt keine weiteren Änderungen vor. Wenn Sie einen HPA zusammen mit dem Boost nutzen, definieren Sie eine Readiness Probe und setzen Sie durationSeconds auf 0. So verhindern Sie, dass der HPA wegen des CPU-Peaks beim Start Replicas hinzufügt.
c. Zweiphasiger In-Place-Resize: Der In-Place Pod Resize ändert CPU und Speicher eines laufenden Pods ohne Neustart. Das Feature erreichte in Kubernetes 1.33 den Beta-Status und wurde in Kubernetes 1.35 stabil. Ein Pod kann mit hohem CPU-Request und -Limit starten, und ein Controller kann beide nach dem Start absenken. Die Standard-Resize-Policy für CPU ist NotRequired, und Sie können sie im Manifest explizit angeben:
containers: - name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequiredSie ändern die Ressourcen über die resize-Subresource. Dieser Befehl benötigt kubectl 1.32 oder neuer:
kubectl patch pod <pod-name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"requests":{"cpu":"300m"},"limits":{"cpu":"500m"}}}]}}'Dieses Beispiel geht von einem Burstable-Pod aus, bei dem der Request niedriger ist als das Limit. Ein Guaranteed-Pod muss den Request gleich dem Limit halten, weil ein Resize die QoS-Klasse nicht ändern kann. Windows-Pods und Pods unter der statischen CPU- oder Memory-Manager-Policy können den In-Place-Resize nicht nutzen. Außerdem muss jemand den Resize auslösen. Eine Person kann den Patch manuell ausführen, aber bei vielen Pods muss ein Controller das übernehmen.
Ändern Sie bei JVM-Containern nur die CPU und lassen Sie das Memory-Limit unverändert, denn ein niedrigeres Memory-Limit kann einen OOM-Kill verursachen.
d. startupProbe und HPA-Tuning: Eine Startup Probe setzt die Liveness- und Readiness-Probes aus, bis die Anwendung gestartet ist. Sie verhindert Neustart-Schleifen bei einem langsamen Start. Richten Sie sie auf denselben Endpoint wie die Liveness Probe. Die Gesamtzeit, die die Probe erlaubt, ist failureThreshold x periodSeconds.
startupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24 # wartet bis zu 24 x 5 = 120 SekundenDieser Pfad benötigt die Spring-Boot-Actuator-Dependency. Spring Boot aktiviert die Liveness- und Readiness-Endpoints automatisch, wenn die Anwendung auf Kubernetes läuft. Eine Startup Probe macht den Start nicht schneller, aber sie macht einen niedrigeren Request sicherer.
Auch der HPA braucht Aufmerksamkeit. Das behavior-Feld der autoscaling/v2-API begrenzt, wie schnell der HPA Replicas hinzufügt, sodass ein kurzer Start-Peak keinen Schwall neuer Pods auslöst:
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: example-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: example minReplicas: 2 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70 behavior: scaleUp: stabilizationWindowSeconds: 60 policies: - type: Pods value: 2 periodSeconds: 60In diesem Beispiel zielt der HPA auf 70 Prozent CPU-Auslastung. Das Scale-up-Fenster von 60 Sekunden verzögert Scale-up-Entscheidungen, sodass ein kurzer Start-Peak keine Replicas hinzufügt. Der HPA fügt höchstens 2 Pods pro 60-Sekunden-Intervall hinzu.
e. Automatisierung mit PerfectScale: PerfectScale behebt Start-Verschwendung automatisch. Eine JVM braucht nur beim Start viel CPU. Eine einzige durchschnittsbasierte Empfehlung funktioniert nicht für beide Phasen. PerfectScale erkennt Services mit hohem Ressourcenbedarf beim Start automatisch und liefert zwei Empfehlungen pro Workload: eine für den Start und eine für den Steady-State-Betrieb.
PerfectScale wendet die Start-Empfehlung beim Erstellen eines Pods an und passt die Ressourcen anschließend in place an die Laufzeit-Empfehlung an, sobald der Pod den Steady State erreicht. So optimieren Sie die Ressourcenzuteilung für beide Phasen, ohne die Anwendungsleistung zu beeinträchtigen – und das ganz ohne Pod-Neustart oder manuellen Eingriff. Der Pod behält die Requests auf Start-Niveau nicht mehr für seine gesamte Lebensdauer. PerfectScale dimensioniert die Start-Empfehlung auf den höheren Bedarf der beiden Phasen, sodass der Node während des Starts genug Kapazität hat. PerfectScale weist Start- und Steady-State-Ressourcen getrennt aus, sodass die Kosten- und Verschwendungszahlen widerspiegeln, was der Workload in jeder Phase tatsächlich brauchte. PerfectScale nutzt In-Place-Resize, wenn der Cluster es unterstützt. Unterstützt werden Deployments, StatefulSets, DaemonSets und Argo Rollouts. Unterstützt der Cluster keinen In-Place-Resize, nutzt PerfectScale stattdessen seinen sicheren Standardansatz.
PerfectScale respektiert außerdem Ihre JVM-Heap-Grenzen: Empfehlungen überschreiten nie Ihre konfigurierte maximale Heap-Größe und unterschreiten nie Ihr konfiguriertes Minimum. Für Java-Container erfasst es die Heap- und Non-Heap-Speichernutzung sowie Garbage-Collection-(GC)-Metriken, darunter GC-Zeit, Anzahl aktiver Prozessoren und GC-Typ. Die Erfassung der JVM-Metriken lässt sich bei der Installation des PerfectScale-Agents aktivieren – ohne zusätzlichen Einrichtungsaufwand. Dieses Feature wird nur auf Linux-Nodes unterstützt.
Auch Node-Autoscaler profitieren. PerfectScale gleicht Ihre Karpenter-Einstellungen mit den Requests der laufenden Workloads ab und empfiehlt, zuerst das Right-Sizing der Workloads durchzuführen. Danach passen die Karpenter-Empfehlungen zur realen Nutzung statt zu überhöhten Requests.
Ein Vorher-Nachher für einen Service. Dieses Beispiel nutzt die Zahlen aus dem Rechenbeispiel oben. Vorher passt der Request zum Start-Peak:
resources: requests: cpu: "2" memory: 2Gi limits: cpu: "2" memory: 2GiNachher passt der Request zum Steady State, das Limit lässt Spielraum für den Start, und eine Startup Probe sichert den langsamen Start ab:
resources: requests: cpu: 300m memory: 2Gi limits: cpu: "2" memory: 2GistartupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24Das Zuverlässigkeitsrisiko: Der Node braucht beim Start freie CPU, weil der Request nur 300m beträgt. Boosten oder resizen Sie den Pod, wenn der Node ausgelastet sein könnte.
Fazit
Überhöhte Requests entstehen schnell und werden teuer, wenn sie bestehen bleiben. Der Scheduler, die Node-Autoscaler und manche Cloud-Rechnungen richten sich nach Requests und nicht nach der Nutzung – jede ungenutzte CPU in einem Request kostet also weiterhin Geld.
Der JVM-Start ist eine häufige Ursache. Der Request passt zu den ersten Sekunden und bleibt die gesamte Lebensdauer des Pods bestehen. Den Request allein zu senken löst das Problem nicht, denn das führt zu Throttling, zusätzlichen HPA-Replicas und OOM-Kills. Reduzieren Sie zuerst die Startarbeit, oder dimensionieren Sie Start und Steady State getrennt. PerfectScale erledigt das automatisch, in place und ohne Neustart.
Seien Sie beim Workshop dabei. Vikram Seshadri von DoiT zeigt im Hands-on-Workshop "Java on K8s: The Startup vs. Steady-State Sizing Dilemma" am 28. Oktober 2026 um 11 Uhr ET, wie Sie einen JVM-Pod für den Start dimensionieren und ihn ohne Neustart auf den Steady State umstellen. Jetzt Platz sichern.
Möchten Sie sehen, wie PerfectScale das Right-Sizing Ihrer Java-Workloads übernimmt? Kostenlos starten oder Demo buchen.