
PerfectScale
O problema de custo dos requests superdimensionados
Por que requests do Kubernetes dimensionados para o startup da JVM desperdiçam dinheiro, como quebram o bin-packing e o autoscaling, e como fazer right-sizing sem prejudicar a confiabilidade.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


Muitos clusters Kubernetes reservam muito mais CPU e memória do que seus pods realmente usam. Uma causa comum é a inicialização de um serviço Java. A JVM precisa de muita CPU nos primeiros segundos, então os times definem um request alto para proteger esse momento. O request, porém, permanece alto durante toda a vida do pod, muito depois de o trabalho de startup terminar.
A fatura da nuvem segue a reserva, não o uso. Um pod que reserva 2 CPUs mas usa apenas uma pequena parte delas ainda bloqueia 2 CPUs no node. Com muitas réplicas, essa reserva não utilizada vira uma parte significativa do custo do cluster.
A correção óbvia é reduzir os requests, mas ela também traz riscos. Se você reduz um request e mantém o problema de startup, a JVM inicia devagar, as probes falham e o autoscaler adiciona réplicas de que o serviço não precisa. Custo e confiabilidade puxam para lados opostos. Este artigo explica por que os requests crescem, quanto custam e como afetam o scheduling e o escalonamento de nodes. Depois, mostra como encontrá-los e como corrigi-los sem prejudicar a confiabilidade.
O que são resource requests superdimensionados?
Um resource request é a quantidade de CPU ou memória que o Kubernetes reserva para um contêiner. O scheduler soma os requests em cada node e mantém o total abaixo dos recursos alocáveis do node.
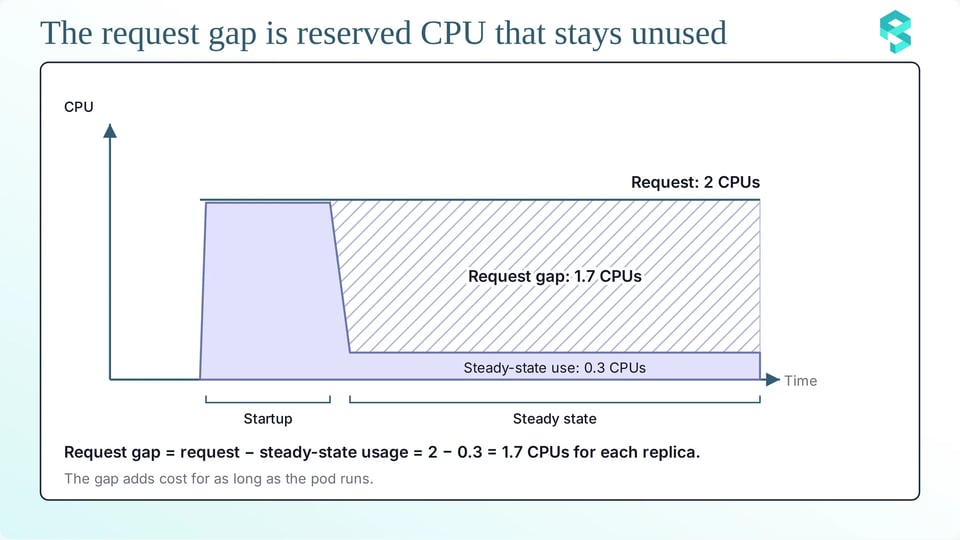
Um request está superdimensionado quando é muito maior do que o contêiner precisa em operação normal. Chamamos essa diferença de request gap: o request menos o uso em estado estável do contêiner.
resources: requests: cpu: "2" # dimensionado para os primeiros segundos do startup memory: 4Gi limits: cpu: "2" memory: 4GiNeste exemplo, o request corresponde ao pico de startup. Se o contêiner precisa apenas de uma pequena parte dessa CPU depois do startup, o resto da reserva é o request gap.
CPU e memória se comportam de formas diferentes. O kernel pode desacelerar um contêiner que quer mais CPU, mas não pode desacelerar um contêiner que quer mais memória. Quando um contêiner usa mais memória do que seu limit, o kernel o encerra com um kill de out-of-memory (OOM). Por isso, um request de CPU tem mais margem para ajuste fino do que um request de memória.
Por que os requests ficam inflados?
Os requests crescem por três motivos:
a. Dimensionamento para o pico de startup: A JVM carrega classes, compila métodos quentes com os compiladores JIT, expande o heap e monta a aplicação, tudo nos primeiros segundos. Esse trabalho exige muito mais CPU do que o serviço precisa depois. Se o limit de CPU é baixo, o kernel aplica throttling à JVM e o startup fica lento. Um time que já viu esse problema aumenta o request e o limit até o startup funcionar. O novo valor é adequado ao pico de startup, mas não ao resto da vida do pod. Para ver como o kernel aplica throttling à JVM no startup, leia CPU throttling during JVM startup.
b. Segurança acima do custo: Os dois riscos não são iguais. Quando um serviço sofre throttling ou é encerrado, um alerta dispara e alguém precisa corrigir. Quando um serviço desperdiça CPU, nada dispara, porque o Kubernetes não reporta requests não utilizados como erro. Por isso, os engenheiros escolhem o valor que os protege de chamados de plantão, e um request alto é a escolha mais segura.
c. Defaults copiados: Muitos requests nem sequer são escolhidos. Um Helm chart vem com valores padrão, um time copia o manifesto de outro serviço e um template antigo leva os números de um serviço pesado para um serviço leve. Um LimitRange também pode definir um request padrão para todo contêiner que não tenha um:
apiVersion: v1kind: LimitRangemetadata: name: default-requests namespace: examplespec: limits: - type: Container defaultRequest: cpu: "1" memory: 2GiEste LimitRange atribui um request de 1 CPU e 2Gi de memória a todo contêiner do namespace que não define request. Esses valores se espalham entre times e ambientes, e ninguém volta a verificá-los.

O custo dos requests superdimensionados
Três passos mostram o custo:
a. A fórmula do request gap: O desperdício de um contêiner tem uma fórmula simples:
desperdício (vCPU-horas): (request - uso em estado estável) x réplicas x horascusto: desperdício x preço por vCPU-horaUse a mesma fórmula para memória com GiB-horas. Para o uso em estado estável, escolha um percentil alto do uso depois do startup, como o 95º. Um percentil é mais seguro que a média, porque cobre os picos normais.
A forma como o gap vira dinheiro depende da sua plataforma. Em nodes padrão, você paga pelas máquinas virtuais, então o request gap aumenta o número de nodes de que o cluster precisa. No GKE Autopilot, o Google cobra pela CPU e memória que seus pods solicitam, então cada unidade de request gap é um custo direto.
b. Exemplo prático: Suponha que um serviço Java rode 100 réplicas. Cada réplica solicita 2 CPUs para que o startup funcione. Depois do startup, uma réplica precisa de cerca de 0,3 CPU no 95º percentil. Esses números são um exemplo, e seu serviço tem os seus próprios.
- O request gap é 2 - 0,3 = 1,7 CPU por réplica.
- Para 100 réplicas, o gap é de 170 CPUs reservadas e não utilizadas.
- Um mês tem cerca de 730 horas, então o desperdício é 170 x 730 = 124.100 vCPU-horas por mês.
- Multiplique esse número pelo preço de uma vCPU-hora na sua plataforma para obter o custo mensal.
Para memória, um contêiner que solicita 4 GiB mas precisa de 2 GiB em estado estável desperdiça 2 GiB por réplica.
c. Custo entre serviços: Um serviço é fácil de corrigir, mas muitos serviços são mais difíceis. O mesmo valor inflado se repete entre réplicas, serviços, clusters e ambientes. Clusters de staging e desenvolvimento muitas vezes copiam os requests de produção, então carregam o mesmo desperdício.
Os requests também consomem quota. Um ResourceQuota limita a soma dos requests em um namespace:
apiVersion: v1kind: ResourceQuotametadata: name: team-quota namespace: examplespec: hard: requests.cpu: "40" requests.memory: 80GiCom essa quota, todos os pods do namespace juntos podem solicitar 40 CPUs e 80Gi de memória. Requests inflados consomem esse orçamento muito antes do uso real. O time então pede uma quota maior, e o problema cresce.
Como os requests superdimensionados quebram o bin-packing?
Os requests afetam o scheduling e o escalonamento de nodes de três formas:
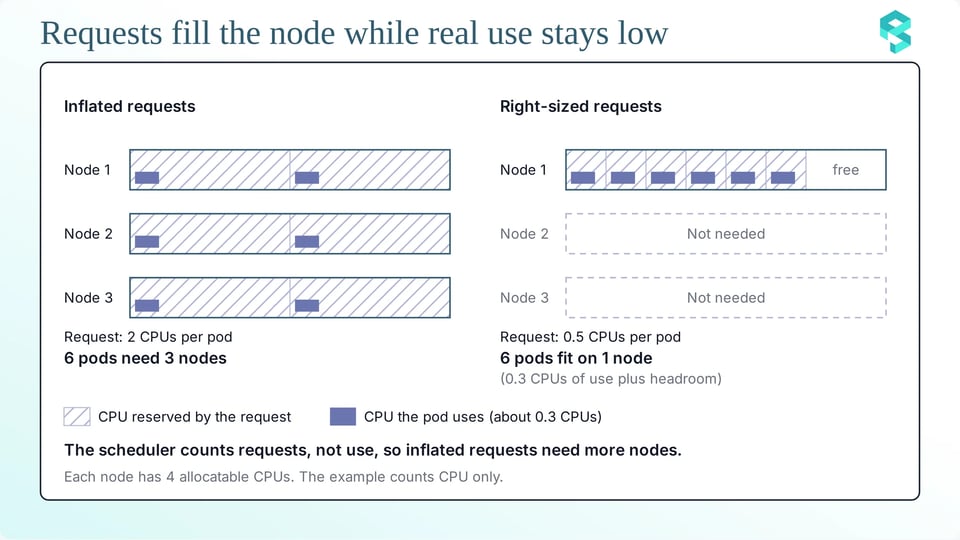
a. O scheduling usa requests, não uso: O scheduler não olha para o que um pod usa. Ele olha para o que o pod solicita.
Por padrão, o scheduler pontua os nodes com a estratégia LeastAllocated. Essa estratégia prefere nodes com menos recursos solicitados, então espalha os pods entre os nodes. As estratégias MostAllocated e RequestedToCapacityRatio empacotam os pods de forma mais densa. As três estratégias trabalham sobre requests. Uma estratégia mais densa, portanto, não consegue corrigir requests inflados, porque ela empacota as reservas, e não o uso real.
b. CPU encalhada e nodes extras: CPU reservada que nenhum contêiner usa fica encalhada. Outros pods não podem usá-la porque o scheduler a conta como ocupada. O cluster então precisa de mais nodes para alocar os mesmos pods. Desequilíbrios pioram a situação. Se os requests são altos para CPU e baixos para memória, o node esgota a CPU primeiro e a memória fica sem uso. O inverso também acontece.
c. Efeito no autoscaling de nodes: Autoscalers de nodes também trabalham sobre requests. O Cluster Autoscaler adiciona um node quando um pod não pode ser agendado por falta de recursos. Para remover um node, ele calcula a utilização do node como a soma dos recursos solicitados dividida pelos recursos alocáveis. Por padrão, um node só se torna candidato à remoção quando esse valor fica abaixo de 0,5 (--scale-down-utilization-threshold). Requests inflados mantêm esse valor alto, então nodes com baixo uso real permanecem no cluster.
O Karpenter segue a mesma lógica. Ele lê os resource requests dos pods pendentes para escolher e lançar nodes, e sua consolidação empacota os pods com base nos requests, não no uso. Requests menores e mais precisos permitem que as duas ferramentas rodem com menos nodes.
Por que recomendações baseadas em média falham com workloads de startup pesado?
Muitas ferramentas recomendam um request a partir do histórico de uso de um contêiner. Elas escolhem uma estatística sobre uma janela de tempo: a média, um percentil ou o pico. Para um serviço com pico de startup, cada escolha falha de um jeito diferente:
a. Uma estatística baixa esconde o pico: A média se ajusta ao estado estável, então o request recomendado fica baixo. A JVM então recebe pouca CPU no startup, e o kernel aplica throttling.
b. Uma estatística alta inclui o pico: O máximo, ou um percentil muito alto, inclui as amostras de startup, então o request recomendado atende ao startup. O pod então reserva CPU em nível de startup por toda a vida, e o desperdício permanece.
Os dois resultados estão errados para uma das fases. O tamanho do erro também depende da frequência com que os pods iniciam. Deploys frequentes, autoscaling e substituições de nodes adicionam mais amostras de startup à janela, então a estatística se desloca em direção ao pico. Um único número não consegue descrever um workload com duas fases. A correção exige uma recomendação ou um mecanismo que trate startup e estado estável separadamente.
Riscos de cortar requests sem corrigir o startup
Um request menor sem uma correção do startup causa três problemas:
a. Throttling e readiness lenta: Se você reduz o limit de CPU junto com o request, o kernel aplica throttling à JVM no startup. O pod fica Ready mais tarde, os rollouts demoram mais e a startup probe pode falhar. Se a falha se repete, o kubelet reinicia o contêiner, e o novo contêiner repete o mesmo trabalho. Se você reduz apenas o request e mantém um limit alto ou nenhum limit, o pod recebe uma fatia menor de CPU quando o node está ocupado, então o startup fica lento em nodes ocupados.
b. Scale-out do HPA causado pela CPU de startup: O Horizontal Pod Autoscaler (HPA) mede o uso de CPU como porcentagem do request. Ele usa esta fórmula:
desiredReplicas = ceil[ currentReplicas x ( currentMetricValue / desiredMetricValue ) ]Um request menor faz o mesmo uso de CPU parecer maior em porcentagem. Um pico de startup pode, portanto, parecer carga pesada, e o HPA adiciona réplicas. Novas réplicas iniciam, e cada início cria outro pico. Por padrão, o atraso inicial de readiness é de 30 segundos (--horizontal-pod-autoscaler-initial-readiness-delay), e o HPA pode ignorar amostras de CPU durante o período de inicialização de CPU de 5 minutos (--horizontal-pod-autoscaler-cpu-initialization-period). Esses padrões reduzem o risco, mas não conseguem eliminá-lo quando o startup é longo.
c. Contêineres Java com OOMKilled: Por padrão, a JVM define seu heap máximo em 25% da memória do contêiner (-XX:MaxRAMPercentage). A JVM também usa memória fora do heap, como metaspace, stacks de threads e o code cache. Se você reduz o limit de memória sem verificar essas partes, o contêiner pode ultrapassá-lo e sofrer um OOM kill.
Se o request de memória é menor que o limit, o node também pode receber pods demais, e o kubelet pode despejar pods quando o node fica com pouca memória. Para contêineres JVM, defina o request de memória igual ao limit de memória:
resources: requests: memory: 2Gi limits: memory: 2Gi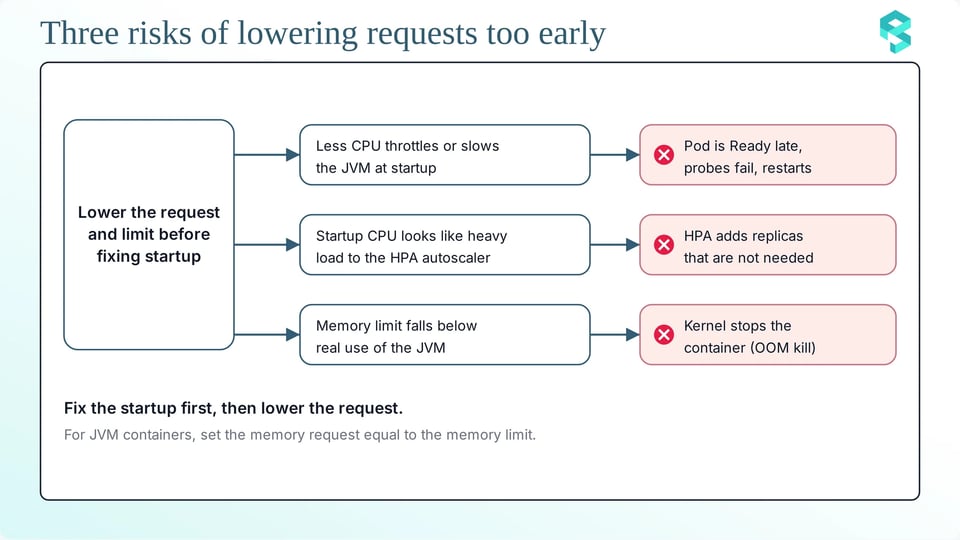
Como encontrar requests superdimensionados
Três verificações vão ajudar você a encontrar o problema:
a. Requests vs. uso: Para uma primeira olhada, use kubectl top. Ele precisa do Metrics Server e mostra o uso atual de cada contêiner:
kubectl top pod --containers -n <namespace>Compare o resultado com os requests na spec do pod. Para uma visão completa, use o Prometheus. A métrica kube_pod_container_resource_requests do kube-state-metrics guarda os requests. A métrica do cAdvisor container_cpu_usage_seconds_total guarda o uso de CPU. Esta consulta mostra o request gap de CPU de cada contêiner, usando o 95º percentil de uso em 7 dias:
expr: | sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) )b. Janela de startup vs. estado estável: A consulta do request gap mistura as duas fases, e as amostras de startup elevam o 95º percentil, então o gap parece menor do que o verdadeiro gap de estado estável. Para separá-los, use a métrica kube_pod_start_time, que guarda o horário de início de cada pod. Esta consulta mantém apenas as amostras dos primeiros 10 minutos de um pod e retorna o pico:
max by (namespace, pod, container) ( max_over_time( ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[1m]) and on (namespace, pod) (time() - kube_pod_start_time < 600) )[7d:1m] ))Esta consulta mantém apenas as amostras depois dos primeiros 10 minutos e retorna o 95º percentil. Ela mostra o estado estável:
max by (namespace, pod, container) ( quantile_over_time(0.95, ( rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m]) and on (namespace, pod) (time() - kube_pod_start_time > 600) )[7d:5m] ))Essas consultas assumem que o startup termina em até 10 minutos. Troque 600 pelo tempo de startup do seu serviço. O horário de início do pod não muda quando um contêiner reinicia dentro do mesmo pod, então esse reinício conta como estado estável. A consulta de startup também usa um step de 1 minuto, então pode retornar um valor um pouco abaixo do pico real quando o pico é curto.
Compare três valores para um contêiner: o request, o pico de startup e o uso em estado estável. Um contêiner com um gap grande entre o request e o uso em estado estável, e com um pico de startup próximo do request, é o clássico serviço JVM superdimensionado.
c. Classificando workloads por request gap: Corrija os maiores gaps primeiro. Classifique pelo gap absoluto em CPUs, somado em todas as réplicas, e não pela proporção. Uma proporção de dez vezes em um contêiner minúsculo economiza pouco. Essas consultas são pesadas, então armazene o gap em uma recording rule e classifique o resultado:
groups: - name: request-gap rules: - record: container:cpu_request_gap:cores expr: | clamp_min( sum by (namespace, pod, container) ( kube_pod_container_resource_requests{resource="cpu", container!=""} ) - max by (namespace, pod, container) ( quantile_over_time(0.95, rate(container_cpu_usage_seconds_total{container!~"POD|"}[5m])[7d:5m] ) ), 0)Se você usa o Prometheus Operator, coloque o mesmo grupo de regras em spec.groups de um objeto PrometheusRule, com o label que seu Prometheus usa para selecionar regras.
topk(20, sum by (namespace, container) (container:cpu_request_gap:cores))Faça a mesma verificação para memória com a métrica container_memory_working_set_bytes.
Como parar de pagar pelo startup durante toda a vida do pod?
O objetivo é dar ao pod recursos em nível de startup durante o startup e recursos de estado estável depois disso. Estas opções funcionam em conjunto:
a. Reduza o custo do startup: Menos trabalho de startup exige menos CPU no startup, e isso reduz o pico que define o request. O Spring Boot pode criar beans no primeiro uso com spring.main.lazy-initialization=true. Class Data Sharing e o cache AOT podem eliminar parte do trabalho de carregamento de classes. O cache AOT chegou no JDK 24 (JEP 483). O Spring Framework suporta tanto o CDS quanto o cache AOT. O profiling mostra para onde vai o seu tempo de startup.
b. Startup boost e VPA: O Vertical Pod Autoscaler (VPA) tem um modo de atualização InPlaceOrRecreate. Esse modo tenta primeiro um resize in-place e recria o pod quando um resize in-place não é possível. No GKE, o CPU startup boost funciona com o VPA. Ele eleva o request de CPU quando o pod é criado e mantém o request mais alto por durationSeconds depois que o pod fica Ready. Em seguida, o GKE retorna o request ao valor base in-place. O boost se aplica apenas quando o pod é criado, então um reinício de contêiner dentro do mesmo pod não recebe boost. No momento da escrita, o recurso está em Preview e exige o GKE 1.36.0-gke.4447000 ou posterior.
apiVersion: autoscaling.k8s.io/v1kind: VerticalPodAutoscalermetadata: name: example-vpaspec: targetRef: apiVersion: apps/v1 kind: Deployment name: example updatePolicy: updateMode: "Off" startupBoost: cpu: type: "Factor" factor: 2 durationSeconds: 10Neste exemplo, o boost dobra o request de CPU (factor: 2) e o mantém por 10 segundos depois que o pod fica Ready. Com updateMode definido como Off, o VPA aplica apenas o boost e não faz outras alterações. Se você usa um HPA com o boost, defina uma readiness probe e configure durationSeconds como 0. Isso impede que o HPA adicione réplicas por causa do pico de CPU no startup.
c. Resize in-place em duas fases: O resize in-place de pods altera a CPU e a memória de um pod em execução sem reinício. O recurso chegou a beta no Kubernetes 1.33 e se tornou estável no Kubernetes 1.35. Um pod pode iniciar com request e limit de CPU altos, e um controller pode reduzi-los depois do startup. A política de resize padrão para CPU é NotRequired, e você pode declará-la no manifesto:
containers: - name: app resizePolicy: - resourceName: cpu restartPolicy: NotRequiredVocê altera os recursos pelo subresource resize. Este comando exige o kubectl 1.32 ou posterior:
kubectl patch pod <pod-name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"requests":{"cpu":"300m"},"limits":{"cpu":"500m"}}}]}}'Este exemplo assume um pod Burstable, em que o request é menor que o limit. Um pod Guaranteed precisa manter o request igual ao limit, porque um resize não pode mudar a classe de QoS. Pods Windows e pods sob a política estática do CPU ou Memory manager não podem usar resize in-place. Alguém também precisa acionar o resize. Uma pessoa pode rodar o patch manualmente, mas, para muitos pods, um controller precisa executá-lo.
Para contêineres JVM, redimensione apenas a CPU e deixe o limit de memória como está, porque um limit de memória menor pode causar um OOM kill.
d. startupProbe e ajuste do HPA: Uma startup probe suspende as probes de liveness e readiness até a aplicação ter iniciado. Ela evita loops de reinício durante um início lento. Aponte-a para o mesmo endpoint da liveness probe. O tempo total que a probe permite é failureThreshold x periodSeconds.
startupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24 # espera até 24 x 5 = 120 segundosEsse caminho exige a dependência do Spring Boot Actuator. O Spring Boot habilita os endpoints de liveness e readiness automaticamente quando a aplicação roda no Kubernetes. Uma startup probe não torna o startup mais rápido, mas torna um request menor mais seguro.
O HPA também exige cuidado. O campo behavior da API autoscaling/v2 limita a velocidade com que o HPA adiciona réplicas, então um pico curto de startup não causa uma enxurrada de novos pods:
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: example-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: example minReplicas: 2 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70 behavior: scaleUp: stabilizationWindowSeconds: 60 policies: - type: Pods value: 2 periodSeconds: 60Neste exemplo, o HPA mira em 70% de uso de CPU. A janela de scale-up de 60 segundos atrasa as decisões de scale-up, então um pico curto de startup não adiciona réplicas. O HPA adiciona no máximo 2 pods a cada período de 60 segundos.
e. Automação com o PerfectScale: O PerfectScale corrige o desperdício de startup automaticamente. A JVM precisa de muita CPU apenas no startup. Uma única recomendação baseada em média não funciona para as duas fases. O PerfectScale detecta automaticamente serviços com altos requisitos de recursos no startup e fornece duas recomendações para cada workload: uma para o startup e outra para o runtime em estado estável.
O PerfectScale aplica a recomendação de startup quando o pod é criado e, depois, ajusta os recursos in-place para corresponder à recomendação de runtime assim que o pod atinge o estado estável, ajudando você a otimizar a alocação de recursos nas duas fases sem comprometer o desempenho da aplicação. E nenhum reinício de pod ou intervenção manual é necessário. O pod não carrega mais requests em nível de startup por toda a vida. O PerfectScale dimensiona a recomendação de startup para a maior necessidade entre as duas fases, então o node tem capacidade suficiente durante o startup. O PerfectScale mostra os recursos de startup e de estado estável separadamente, então os números de custo e desperdício refletem o que o workload precisou em cada fase. O PerfectScale usa resize in-place quando o cluster oferece suporte. Ele suporta Deployments, StatefulSets, DaemonSets e Argo Rollouts. Quando o cluster não suporta resize in-place, o PerfectScale usa sua abordagem padrão segura.
O PerfectScale também respeita os limites de tamanho de heap da sua JVM, então as recomendações nunca ultrapassam o heap máximo configurado nem ficam abaixo do mínimo configurado. Para contêineres Java, ele coleta o uso de memória heap e non-heap, junto com métricas de garbage collection (GC), incluindo tempo de GC, contagem de processadores ativos e tipo de GC. A coleta de métricas da JVM pode ser habilitada durante a instalação do agente do PerfectScale, sem configuração adicional. Esse recurso é suportado apenas em nodes Linux.
Autoscalers de nodes também se beneficiam. O PerfectScale verifica suas configurações do Karpenter em relação aos requests dos workloads em execução e recomenda fazer o right-sizing dos workloads primeiro. Assim, as recomendações do Karpenter correspondem ao uso real, e não a requests inflados.
Um antes e depois para um serviço. Este exemplo usa os números do exemplo prático acima. Antes, o request é dimensionado para o pico de startup:
resources: requests: cpu: "2" memory: 2Gi limits: cpu: "2" memory: 2GiDepois, o request atende ao estado estável, o limit mantém folga para o startup e uma startup probe protege o início lento:
resources: requests: cpu: 300m memory: 2Gi limits: cpu: "2" memory: 2GistartupProbe: httpGet: path: /actuator/health/liveness port: 8080 periodSeconds: 5 failureThreshold: 24O risco de confiabilidade é que o node precisa de CPU livre no startup, porque o request é de apenas 300m. Aplique boost ou resize no pod quando o node puder estar ocupado.
Conclusão
Requests superdimensionados são fáceis de criar e caros de manter. O scheduler, os autoscalers de nodes e algumas faturas de nuvem seguem os requests, e não o uso, então cada CPU não utilizada em um request continua custando dinheiro.
O startup da JVM é uma causa comum. O request é dimensionado para os primeiros segundos e permanece por toda a vida do pod. Cortar o request sozinho não resolve, porque causa throttling, réplicas extras do HPA e OOM kills. Reduza primeiro o trabalho de startup, ou dimensione o startup e o estado estável separadamente. O PerfectScale faz isso automaticamente, in-place e sem reinício.
Participe do workshop. Vikram Seshadri, da DoiT, mostra como dimensionar um pod JVM para o startup e como redimensioná-lo para o estado estável sem reinício, no workshop prático "Java on K8s: The Startup vs. Steady-State Sizing Dilemma", em 28/10/2026, às 11h (horário do leste dos EUA). Garanta sua vaga.
Quer ver como o PerfectScale faz right-sizing dos seus workloads Java? Comece grátis ou agende uma demo.