
PerfectScale
Multi-tenancy en Kubernetes: modelos, capas de aislamiento y buenas prácticas
Cómo funciona realmente la multi-tenancy en Kubernetes: modelos de aislamiento soft y hard, las capas (RBAC, NetworkPolicy, ResourceQuotas) que la sostienen y dónde falla en la práctica.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Multi-tenancy en Kubernetes significa ejecutar varios equipos, proyectos o clientes en un solo clúster compartido en lugar de un clúster dedicado para cada uno, y nada del aislamiento ocurre de forma automática.
- Cuatro capas fundamentales la sostienen: namespaces, RBAC, políticas de red y cuotas de recursos (incluidos los LimitRanges), además de los Pod Security Standards que protegen a nivel de workload. Si omites una, un tenant que debería permanecer aislado empieza a afectar a todos los demás.
- Existen tres modelos de aislamiento: soft (basado en namespaces, el más económico, solo aislamiento lógico), hard (clústeres virtuales como vCluster o Capsule) y físico (node pools o clústeres dedicados, el aislamiento más fuerte y el costo más alto). La mayoría de las organizaciones combina los tres en lugar de estandarizar uno solo.
- La mayoría de las fallas se debe al drift, no a una mala configuración inicial: los equipos configuran las cuotas y el RBAC correctamente una vez y nunca los vuelven a revisar cuando los workloads cambian.
Pon diez equipos en un clúster de Kubernetes y, por defecto, nada impide que el equipo A lea los secretos del equipo B, se coma su CPU o tumbe un control plane del que el equipo B también depende. La multi-tenancy en Kubernetes cierra esa brecha con cuatro capas configurables: namespaces, RBAC, políticas de red y cuotas de recursos.
La multi-tenancy permite a las organizaciones dejar de pagar por decenas de control planes ociosos y empezar a compartir infraestructura entre equipos, proyectos o clientes ("tenants"). Solo funciona si cada una de esas capas realmente se configura y se mantiene configurada. Kubernetes no viene multi-tenant de fábrica. Los namespaces trazan una frontera lógica, no una de seguridad. Si omites una capa, un tenant que debería haber permanecido aislado empieza a afectar a todos los demás en el clúster, ya se trate de una frontera de seguridad o simplemente de un workload comiéndose la CPU de otro.
Por qué los equipos comparten un clúster
Hay tres razones que aparecen en casi todos los casos: el costo, la carga operativa y la velocidad de desarrollo.
Operar diez clústeres significa diez control planes, diez conjuntos de node pools sobredimensionados y diez balanceadores de carga ociosos la mayor parte del día. Consolidar en dos o tres clústeres compartidos reduce ese overhead de forma directa. También se reduce la carga operativa: un solo clúster que parchar, un solo lugar donde vigilar la salud de etcd, un solo conjunto de políticas que mantener consistente, en lugar de repetir la misma tarea en cada clúster que operas.
La velocidad de los desarrolladores importa igual, aunque se note menos. Los equipos que esperan a que un equipo de plataforma aprovisione un clúster nuevo esperan días. Los que solicitan un namespace en un clúster multi-tenant existente pueden obtenerlo en minutos, en modo autoservicio, con cuotas y políticas de red ya aplicadas. Los equipos de plataforma lo llaman "namespace-as-a-service", y suele ser la razón principal por la que deciden construir multi-tenancy.
Los tres modelos de multi-tenancy
No todos los tenants necesitan el mismo aislamiento. El modelo que elijas es un equilibrio entre el radio de impacto, el costo y la complejidad operativa que decides asumir.
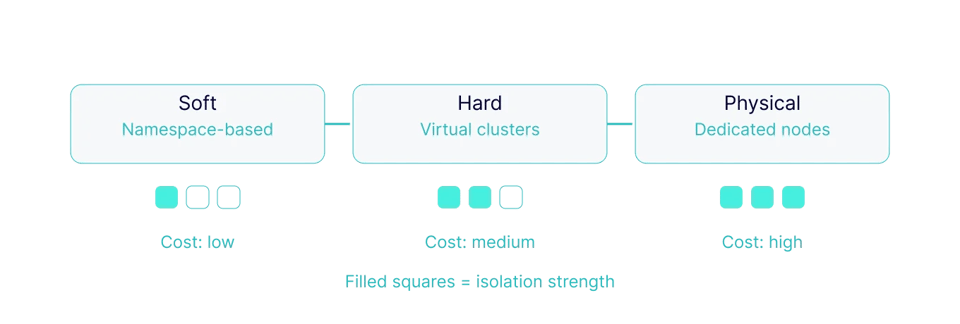
| Modelo | Cómo aísla | Nivel de aislamiento | Overhead | Ideal para |
|---|---|---|---|---|
| Soft (basado en namespaces) | Namespaces + RBAC + NetworkPolicy + ResourceQuota, con control plane y kernel compartidos | Solo lógico. Un exploit del kernel o del API server aún puede cruzar entre tenants | El costo más bajo, el más fácil de operar | Equipos internos que ya confían entre sí |
| Hard (clústeres virtuales) | Cada tenant obtiene su propio API server virtual (vcluster, Capsule, Kiosk) sobre un conjunto compartido de nodos | Fuerte aislamiento del control plane; los workloads aún pueden compartir kernel salvo que los combines con runtimes tipo sandbox | Moderado: más piezas móviles, pero un solo clúster físico que administrar | Equipos de plataforma que ofrecen entornos "tipo clúster" a muchos tenants internos o externos |
| Físico (nodos/clústeres dedicados) | Taints y tolerations de nodo, o clústeres completamente separados, por tenant | El más fuerte, con kernel separado y radio de impacto separado | El costo más alto, la mayor infraestructura que operar | Workloads regulados (HIPAA, PCI-DSS), tenants con GPU o cualquiera que no pueda compartir kernel por razones de cumplimiento |
La mayoría de las organizaciones no se queda con un solo modelo. Ejecutan multi-tenancy soft para los equipos internos de confianza y reservan el aislamiento hard o físico para el puñado de tenants (un cliente externo, un equipo de ML intensivo en GPU, un workload regulado) que lo necesita. Tratar la "multi-tenancy" como un simple interruptor de encendido/apagado sobredimensiona o subdimensiona muchos de estos proyectos desde el inicio.
Las capas de aislamiento que sostienen la multi-tenancy soft
La mayoría de los equipos comienza con multi-tenancy soft por defecto. Se construye con cuatro capas, y todas deben configurarse; ninguna viene activada de fábrica.
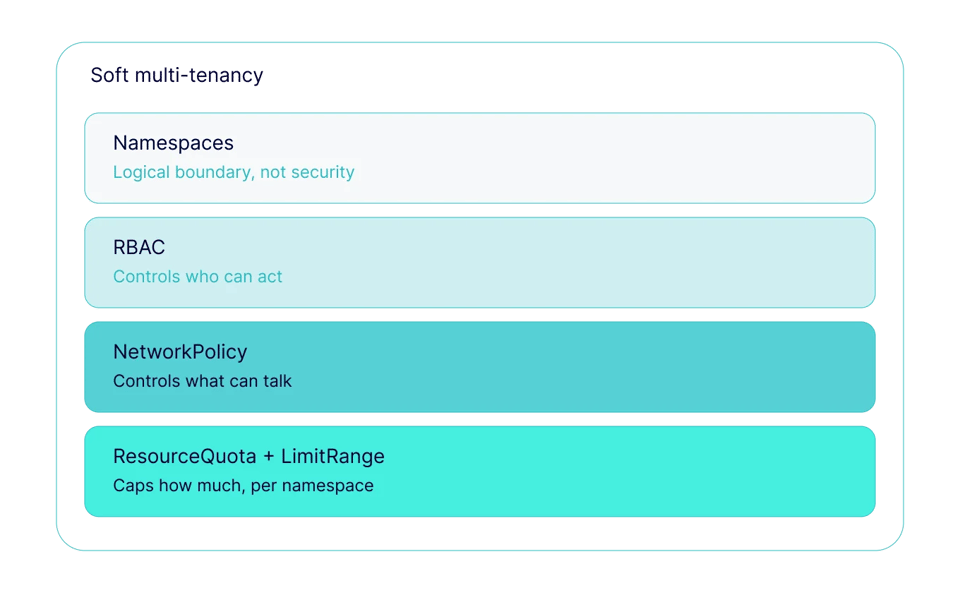
Los namespaces te dan la frontera a la que se adhiere todo lo demás: un lugar donde acotar el RBAC, las cuotas y las políticas de red. Por sí solos aíslan nombres, no comportamientos. Un pod en el namespace A todavía puede comunicarse con un pod en el namespace B, y un workload sin límites de recursos todavía puede comerse un nodo que los pods del namespace B también usan.
El RBAC decide quién puede actuar sobre qué. Comienza con denegación por defecto, otorga los roles mínimos que el equipo de cada tenant realmente necesita y vincúlalo a grupos en lugar de a usuarios individuales, para que el acceso no se degrade a medida que las personas entran y salen de los equipos. La proliferación de RBAC por tenant (decenas de Roles y RoleBindings casi duplicados que se desincronizan) figura entre las principales razones por las que los clústeres multi-tenant se vuelven más difíciles de auditar con el tiempo.
NetworkPolicy impide que los tenants se comuniquen entre sí a través de la red, algo que ni el RBAC ni los namespaces hacen por sí solos:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: deny-cross-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aLa mayoría de los equipos comienza con una política default-deny por namespace y luego agrega reglas de permiso explícitas para lo que realmente necesita comunicarse entre namespaces. Sin ella, cualquier pod del clúster puede conectarse a cualquier otro pod por defecto. Los namespaces no imponen fronteras de red por sí solos.
ResourceQuotas y LimitRanges evitan que un tenant deje sin CPU, memoria o cupo de objetos al resto del clúster. Una ResourceQuota limita lo que un namespace puede consumir en total; un LimitRange establece valores por defecto y máximos razonables por contenedor dentro de él. La multi-tenancy y el problema del noisy neighbor se cruzan justo aquí: una cuota solo protege al clúster cuando los equipos configuran correctamente los requests y limits que la respaldan, ajustados al uso real. Las cuotas demasiado laxas no detienen a los noisy neighbors; las demasiado estrictas solo empujan a los equipos a sobredimensionar sus solicitudes y a perder los ahorros de consolidación que la multi-tenancy prometía.
Los Pod Security Standards completan el cuadro a nivel de workload, restringiendo por namespace los contenedores privilegiados, la red del host y el acceso root, de modo que un atacante que comprometa un pod en un tenant no pueda escalar hacia el nodo ni hacia el resto del clúster.
Dónde falla la multi-tenancy soft en la práctica
Dos cosas fallan más que cualquier otra.
La primera tiene nombre propio: "blast radius" o radio de impacto. La multi-tenancy aísla a los tenants entre sí, pero todos siguen compartiendo el control plane. Un namespace sin cuota de número de objetos puede inundar etcd con CRDs o solicitudes de watch y volver lento el API server para todos los tenants del clúster. Por más RBAC o NetworkPolicy por tenant que apliques, esto no se evita, porque la falla no se origina de tenant a tenant, sino de tenant a control plane.
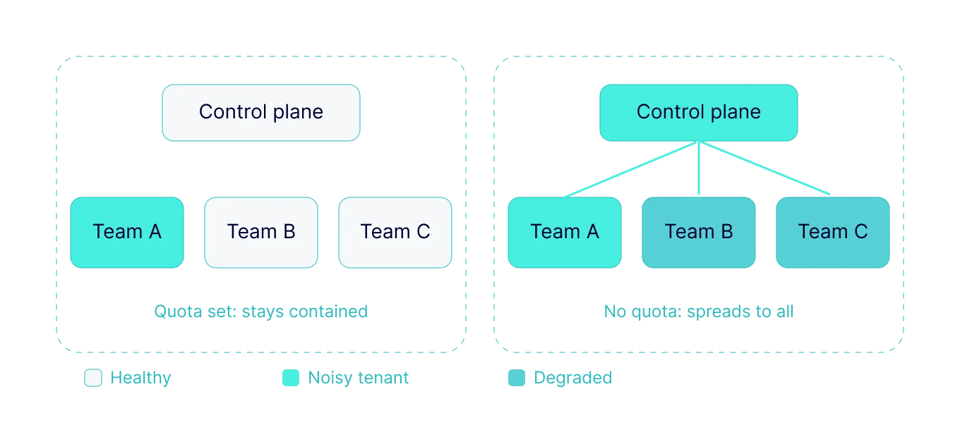
El segundo problema: el drift. Las cuotas, los LimitRanges y el RBAC se configuran correctamente una sola vez, en el despliegue inicial, y luego nadie los vuelve a revisar cuando los workloads cambian. Seis meses después, la mitad de las cuotas quedó obsoleta: o demasiado estrictas (los equipos inflan sus requests para superarlas) o demasiado laxas (ya no ofrecen protección real). El artículo sobre el noisy neighbor cubre el mismo modo de falla: el aislamiento que se sostenía el primer día deja de sostenerse sin que nadie lo note, y la primera señal suele ser una eviction o un OOM kill que cae sobre un workload que no hizo nada malo.
Buenas prácticas de multi-tenancy en Kubernetes
- Define una política de red default-deny por namespace; agrega permisos explícitos solo para lo que necesita tráfico entre namespaces
- Asigna el RBAC a grupos, no a usuarios individuales, y revísalo de forma periódica en lugar de configurarlo una vez y olvidarlo
- Asocia una ResourceQuota y un LimitRange a cada namespace de tenant, no solo a los que ya causaron un problema
- Aplica los Pod Security Standards por namespace, no como una medida tardía a nivel de clúster
- Limita el número de objetos (no solo CPU/memoria) para proteger el control plane de cualquier tenant individual
- Aísla en node pools dedicados (taints/tolerations) a cualquier tenant con requisitos de cumplimiento, GPU o rendimiento cuando la multi-tenancy soft no pueda satisfacerlos
- Monitorea el uso real frente al solicitado, por namespace y por equipo; sin esa visibilidad, los equipos terminan adivinando qué tenant causa los problemas
Preguntas frecuentes
¿Cuál es la diferencia entre multi-tenancy hard y soft en Kubernetes? La multi-tenancy soft aísla a los tenants de forma lógica: namespaces, RBAC, políticas de red y cuotas, mientras se comparte un solo control plane y kernel. La multi-tenancy hard le da a cada tenant su propio API server virtual (mediante herramientas como vCluster, Capsule o Kiosk) o nodos dedicados, de modo que un problema a nivel de control plane o de kernel en un tenant no pueda alcanzar a otro.
¿Kubernetes soporta multi-tenancy de forma nativa? No de fábrica. Kubernetes proporciona las primitivas (namespaces, RBAC, NetworkPolicy, ResourceQuota, Pod Security Standards), pero no las conecta entre sí por defecto, y ninguna de ellas por sí sola ofrece aislamiento completo. La multi-tenancy se construye a partir de esas primitivas; no se activa como un modo.
¿Necesito un clúster separado por tenant? Solo para los tenants que lo requieren específicamente: workloads regulados, workloads intensivos en GPU con necesidades estrictas de aislamiento de rendimiento, o clientes externos donde el riesgo de compartir kernel es inaceptable. La multi-tenancy soft en un clúster compartido funciona bien para la mayoría de los equipos internos; reserva los clústeres o node pools dedicados para las excepciones, no como opción por defecto.
Cómo mantener un clúster multi-tenant bajo control con el tiempo
Cada capa anterior (cuotas, LimitRanges, RBAC) solo protege en la medida en que se mantiene actualizada. PerfectScale by DoiT mantiene los requests y limits alineados con el uso real a medida que los workloads cambian, y te da visibilidad por namespace y por equipo de lo que cada equipo realmente consume, para que detectes el drift de las cuotas y a los noisy neighbors antes de que se conviertan en un incidente, no después.
¿Quieres verlo en un clúster real? Únete al workshop en vivo sobre multi-tenancy el 29 de septiembre o agenda una sesión técnica.