
PerfectScale
Multi-tenancy in Kubernetes: modelli, layer di isolamento e best practice
Come funziona davvero la multi-tenancy in Kubernetes: modelli di isolamento soft e hard, i layer (RBAC, NetworkPolicy, ResourceQuota) che la tengono insieme e dove fallisce nella pratica.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Multi-tenancy in Kubernetes significa eseguire più team, progetti o clienti su un unico cluster condiviso invece che su un cluster dedicato ciascuno — e nessun isolamento avviene in automatico.
- Quattro layer fondamentali la tengono insieme: namespace, RBAC, network policy e resource quota (LimitRange inclusi), oltre ai Pod Security Standards che proteggono il livello dei workloads. Basta trascurarne uno e un tenant che dovrebbe restare isolato inizia a interferire con tutti gli altri.
- Esistono tre modelli di isolamento: soft (basato sui namespace, il più economico, isolamento solo logico), hard (cluster virtuali come vCluster o Capsule) e fisico (node pool o cluster dedicati, isolamento più forte, costi più alti). La maggior parte delle organizzazioni li combina tutti e tre invece di standardizzarsi su uno solo.
- La maggior parte dei problemi deriva dal drift, non da una configurazione iniziale sbagliata: i team configurano correttamente quote e RBAC una volta sola e poi non le rivedono più mano a mano che i workloads cambiano.
Con dieci team su un unico cluster Kubernetes, di default nulla impedisce al team A di leggere i secret del team B, di consumare la CPU del team B o di mettere fuori uso un control plane da cui dipende anche il team B. La multi-tenancy in Kubernetes colma questa lacuna attraverso quattro layer configurabili: namespace, RBAC, network policy e resource quota.
La multi-tenancy permette alle organizzazioni di smettere di pagare decine di control plane inattivi e iniziare a condividere l'infrastruttura tra team, progetti o clienti (i "tenant"). Funziona solo se ognuno di quei layer viene effettivamente configurato e resta configurato. Kubernetes non è multi-tenant di default. I namespace tracciano un confine logico, non un confine di sicurezza. Basta saltare un layer e un tenant che avrebbe dovuto restare isolato inizia a ripercuotersi su tutti gli altri nel cluster, che si tratti di una violazione del perimetro di sicurezza o semplicemente di un workload che consuma la CPU di un altro.
Perché i team scelgono di condividere un cluster
Tre motivi ricorrono in quasi tutti i casi: costi, carico operativo e velocità di sviluppo.
Gestire dieci cluster significa dieci control plane, dieci set di node pool sovradimensionati, dieci load balancer inattivi per gran parte della giornata. Consolidare in due o tre cluster condivisi riduce direttamente questo overhead. E riduce anche il carico operativo: un solo cluster da aggiornare, un solo punto in cui monitorare lo stato di etcd, un solo set di policy da mantenere coerente, invece dello stesso lavoro ripetuto su ogni cluster in esercizio.
La velocità degli sviluppatori conta altrettanto, anche se si nota meno. I team che aspettano che un platform team esegua il provisioning di un nuovo cluster aspettano giorni. I team che richiedono un namespace su un cluster multi-tenant esistente possono ottenerlo in pochi minuti, in self-service, con quote e network policy già configurate. I platform team lo chiamano "namespace-as-a-service", ed è spesso proprio questo il motivo per cui costruiscono la multi-tenancy.
I tre modelli di multi-tenancy
Non tutti i tenant hanno bisogno dello stesso isolamento. Il modello scelto è un compromesso tra blast radius, costi e complessità operativa che si decide di gestire.
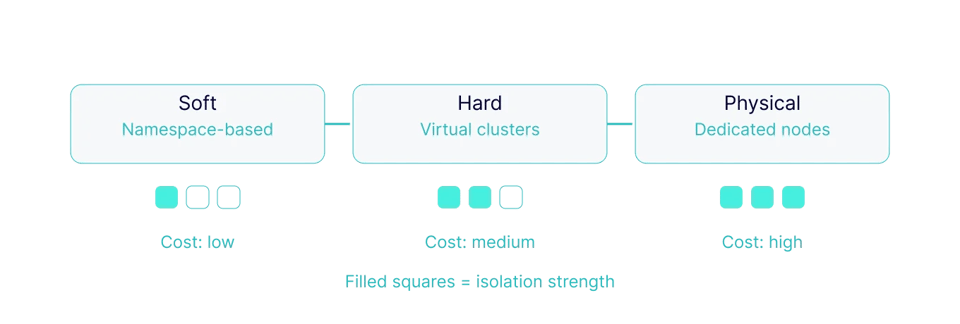
| Modello | Come isola | Livello di isolamento | Overhead | Ideale per |
|---|---|---|---|---|
| Soft (basato sui namespace) | Namespace + RBAC + NetworkPolicy + ResourceQuota, control plane e kernel condivisi | Solo logico. Un exploit del kernel o dell'API server può comunque attraversare i tenant | Costo minimo, il più semplice da gestire | Team interni che si fidano già l'uno dell'altro |
| Hard (cluster virtuali) | Ogni tenant ha il proprio API server virtuale (vcluster, Capsule, Kiosk) sopra un set condiviso di nodi | Forte isolamento del control plane; i workloads possono comunque condividere il kernel, a meno di abbinarli a runtime sandboxed | Moderato: più componenti in gioco, ma un solo cluster fisico da gestire | Platform team che offrono ambienti "simili a un cluster" a molti tenant interni o esterni |
| Fisico (nodi/cluster dedicati) | Taint e toleration sui nodi, oppure cluster completamente separati, per ogni tenant | Il più forte, con kernel separato e blast radius separato | Costo massimo, più infrastruttura da gestire | Workloads regolamentati (HIPAA, PCI-DSS), tenant GPU o chiunque non possa condividere un kernel per motivi di compliance |
La maggior parte delle organizzazioni non sceglie un solo modello e si ferma lì. Usa la multi-tenancy soft per i team interni fidati e riserva l'isolamento hard o fisico ai pochi tenant (un cliente esterno, un team ML ad alto consumo di GPU, un workload regolamentato) che ne hanno davvero bisogno. Trattare la "multi-tenancy" come un semplice interruttore on/off porta a sovradimensionare o sottodimensionare molti di questi progetti fin dall'inizio.
I layer di isolamento che sostengono la multi-tenancy soft
La maggior parte dei team parte di default dalla multi-tenancy soft. È costruita su quattro layer, e vanno configurati tutti: nessuno è attivo out of the box.
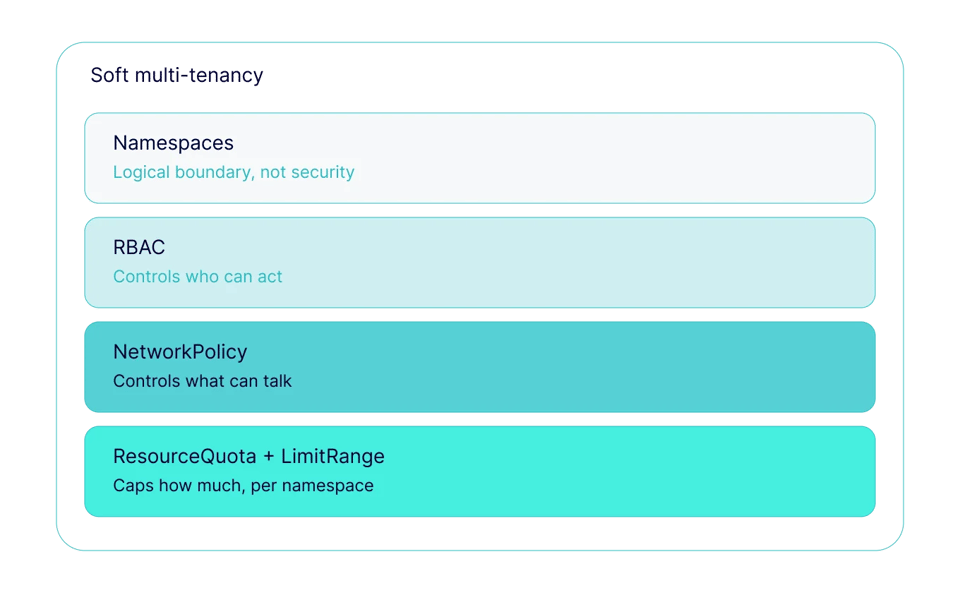
I namespace forniscono il confine a cui si aggancia tutto il resto: un punto in cui delimitare RBAC, quote e network policy. Da soli isolano i nomi, non il comportamento. Un pod nel namespace A può comunque comunicare con un pod nel namespace B, e un workload senza resource limit può comunque saturare un nodo usato anche dai pod del namespace B.
L'RBAC stabilisce chi può agire su cosa. Si parte da un approccio deny-by-default, si concedono i ruoli minimi di cui il team di ogni tenant ha realmente bisogno e si effettua il binding ai gruppi invece che ai singoli utenti, così gli accessi non si degradano quando le persone entrano ed escono dai team. Lo sprawl dell'RBAC dei tenant (decine di Role e RoleBinding quasi identici che si disallineano nel tempo) è tra le principali cause per cui i cluster multi-tenant diventano nel tempo sempre più difficili da sottoporre ad audit.
Le NetworkPolicy impediscono ai tenant di raggiungersi via rete, cosa che RBAC e namespace da soli non fanno:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: deny-cross-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aLa maggior parte dei team parte con una policy default-deny per namespace, per poi aggiungere regole di allow esplicite per ciò che deve effettivamente comunicare tra namespace. Senza, qualsiasi pod del cluster può raggiungere di default qualsiasi altro pod. I namespace da soli non impongono confini di rete.
ResourceQuota e LimitRange impediscono a un singolo tenant di monopolizzare CPU, memoria o numero di oggetti a scapito del resto del cluster. Una ResourceQuota limita il consumo totale di un namespace; un LimitRange definisce al suo interno default e massimi ragionevoli per container. È qui che la multi-tenancy e il problema dei noisy neighbor si incontrano direttamente: una quota protegge il cluster solo se i team impostano correttamente le request e i limit sottostanti, vicini all'utilizzo reale. Quote troppo larghe non fermano i noisy neighbor; quote troppo strette spingono i team a gonfiare le request, vanificando i risparmi da consolidamento che la multi-tenancy aveva promesso.
I Pod Security Standards completano il quadro a livello di workload, limitando per namespace i container privilegiati, l'host networking e l'accesso root, così un attaccante che compromette un pod di un tenant non può fare escalation verso il nodo o il resto del cluster.
Dove la multi-tenancy soft fallisce nella pratica
Due problemi si presentano più spesso di qualsiasi altro.
Il primo ha un nome: "blast radius". La multi-tenancy isola i tenant l'uno dall'altro, ma tutti condividono comunque il control plane. Un namespace senza quota sul numero di oggetti può inondare etcd di CRD o richieste watch e rallentare l'API server per ogni tenant del cluster. Nessuna configurazione di RBAC o NetworkPolicy per tenant può prevenirlo, perché il guasto non nasce da tenant a tenant: nasce da tenant a control plane.
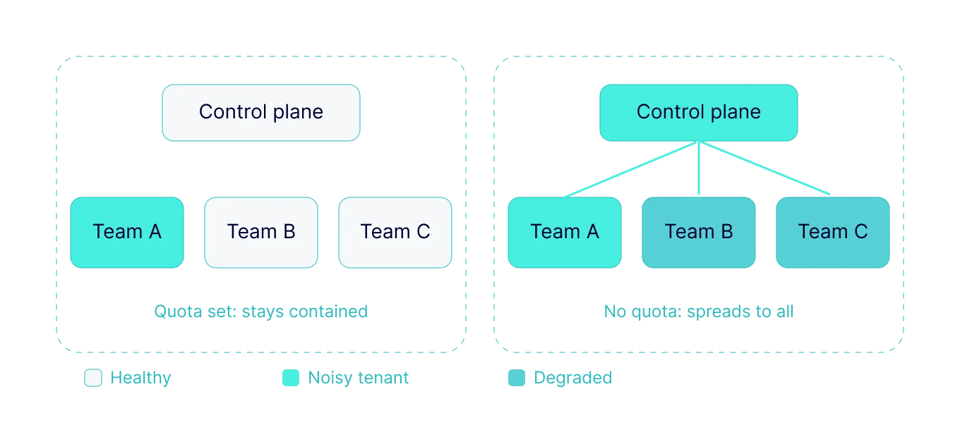
Il secondo problema: il drift. Quote, LimitRange e RBAC vengono configurati correttamente una volta sola, al rollout, e poi nessuno li rivede quando i workloads cambiano. Sei mesi dopo, metà delle quote è ormai obsoleta: o troppo strette (i team gonfiano le request per aggirarle) o troppo larghe (non offrono più una protezione reale). Il post sui noisy neighbor descrive la stessa modalità di guasto: l'isolamento che reggeva il primo giorno smette silenziosamente di reggere, e il primo segnale è di solito un'eviction o un OOM kill che colpisce un workload che non ha fatto nulla di sbagliato.
Best practice per la multi-tenancy in Kubernetes
- Impostare una network policy default-deny per namespace; aggiungere allow espliciti solo per ciò che richiede traffico cross-namespace
- Assegnare l'RBAC ai gruppi, non ai singoli utenti, e rivederlo a cadenza regolare invece di configurarlo una volta e dimenticarlo
- Associare una ResourceQuota e un LimitRange a ogni namespace tenant, non solo a quelli che hanno già causato problemi
- Applicare i Pod Security Standards per namespace, non come misura aggiunta a posteriori a livello di cluster
- Limitare il numero di oggetti (non solo CPU/memoria) per proteggere il control plane da qualsiasi singolo tenant
- Isolare su node pool dedicati (taint/toleration) qualsiasi tenant con requisiti di compliance, GPU o performance che la multi-tenancy soft non riesce a soddisfare
- Monitorare l'utilizzo effettivo rispetto a quello richiesto, per namespace e per team; senza questa visibilità, i team finiscono per tirare a indovinare quale tenant causa i problemi
FAQ
Qual è la differenza tra multi-tenancy hard e soft in Kubernetes? La multi-tenancy soft isola i tenant a livello logico: namespace, RBAC, network policy e quote, condividendo un unico control plane e un unico kernel. La multi-tenancy hard assegna a ogni tenant un proprio API server virtuale (tramite strumenti come vCluster, Capsule o Kiosk) o nodi dedicati, così un problema a livello di control plane o di kernel in un tenant non può raggiungerne un altro.
Kubernetes supporta la multi-tenancy nativamente? Non out of the box. Kubernetes fornisce le primitive (namespace, RBAC, NetworkPolicy, ResourceQuota, Pod Security Standards), ma non le collega tra loro di default, e nessuna di esse da sola garantisce l'isolamento completo. La multi-tenancy si costruisce a partire da quelle primitive; non si attiva come una modalità.
Serve un cluster separato per ogni tenant? Solo per i tenant che lo richiedono espressamente: workloads regolamentati, workloads ad alto consumo di GPU con esigenze rigide di isolamento delle performance, o clienti esterni per cui il rischio di un kernel condiviso è inaccettabile. La multi-tenancy soft su un cluster condiviso risponde bene alle esigenze della maggior parte dei team interni; cluster o node pool dedicati vanno riservati alle eccezioni, non usati come default.
Mantenere un cluster multi-tenant sotto controllo nel tempo
Ogni layer descritto sopra (quote, LimitRange, RBAC) regge solo finché rimane aggiornato. PerfectScale by DoiT mantiene request e limit allineati all'utilizzo reale mano a mano che i workloads cambiano, e offre visibilità per namespace e per team su ciò che ogni team consuma davvero, così il drift delle quote e i noisy neighbor si individuano prima che diventino un incidente, non dopo.
Vuole vederlo in azione su un cluster reale? Partecipi al workshop live sulla multi-tenancy del 29 settembre o prenoti una sessione tecnica.