
PerfectScale
Multi-tenancy Kubernetes : modèles, couches d'isolation et bonnes pratiques
Comment fonctionne réellement la multi-tenancy Kubernetes : les modèles d'isolation soft et hard, les couches (RBAC, NetworkPolicy, ResourceQuotas) qui la font tenir, et ses points de rupture en pratique.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- La multi-tenancy Kubernetes consiste à faire tourner plusieurs équipes, projets ou clients sur un même cluster partagé plutôt que sur un cluster dédié chacun — et rien dans l'isolation ne se fait automatiquement.
- Quatre couches fondamentales la font tenir : namespaces, RBAC, network policies et resource quotas (LimitRanges compris), auxquelles s'ajoutent les Pod Security Standards au niveau des workloads. Négligez-en une, et un tenant censé rester isolé commence à impacter tous les autres.
- Trois modèles d'isolation existent : soft (basé sur les namespaces, le moins cher, isolation purement logique), hard (clusters virtuels comme vCluster ou Capsule) et physique (node pools ou clusters dédiés, isolation la plus forte, coût le plus élevé). La plupart des organisations combinent les trois plutôt que d'en standardiser un seul.
- La plupart des échecs viennent de la dérive, pas d'une mauvaise configuration initiale : les équipes configurent correctement quotas et RBAC une fois, puis n'y reviennent jamais alors que les workloads évoluent.
Mettez dix équipes sur un même cluster Kubernetes et, par défaut, rien n'empêche l'équipe A de lire les secrets de l'équipe B, de consommer son CPU ou de faire tomber un control plane dont l'équipe B dépend aussi. La multi-tenancy Kubernetes comble cette faille grâce à quatre couches configurables : namespaces, RBAC, network policies et resource quotas.
La multi-tenancy permet aux organisations d'arrêter de payer des dizaines de control planes inutilisés et de partager l'infrastructure entre équipes, projets ou clients (les tenants). Elle ne fonctionne que si chacune de ces couches est réellement configurée — et le reste dans la durée. Kubernetes n'est pas multi-tenant d'origine. Les namespaces tracent une frontière logique, pas une frontière de sécurité. Omettez une couche, et un tenant censé rester isolé commence à impacter tout le monde sur le cluster, qu'il s'agisse d'une frontière de sécurité ou simplement d'un workload qui dévore le CPU d'un autre.
Pourquoi partager un cluster, au juste
Trois raisons reviennent dans presque tous les cas : le coût, la charge opérationnelle et la vélocité des développeurs.
Faire tourner dix clusters, c'est dix control planes, dix jeux de node pools surprovisionnés, dix load balancers qui tournent à vide la majeure partie de la journée. Consolider en deux ou trois clusters partagés réduit directement ce surcoût. La charge opérationnelle baisse aussi : un seul cluster à patcher, un seul endroit où surveiller la santé d'etcd, un seul jeu de politiques à garder cohérent, au lieu du même travail répété sur chaque cluster que vous exploitez.
La vélocité des développeurs compte tout autant, même si on la remarque moins. Une équipe qui attend qu'une équipe plateforme provisionne un nouveau cluster attend des jours. Une équipe qui demande un namespace sur un cluster multi-tenant existant peut l'obtenir en quelques minutes, en self-service, avec quotas et network policy déjà en place. Les équipes plateforme appellent cela le namespace-as-a-service, et c'est souvent la raison première pour laquelle elles mettent en place la multi-tenancy.
Les trois modèles de multi-tenancy
Tous les tenants n'ont pas besoin du même niveau d'isolation. Le modèle que vous choisissez arbitre entre rayon d'impact, coût et complexité opérationnelle que vous acceptez d'assumer.
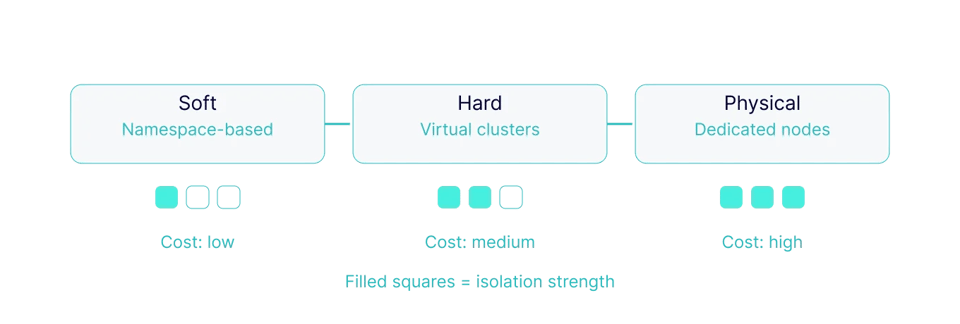
| Modèle | Mode d'isolation | Niveau d'isolation | Overhead | Idéal pour |
|---|---|---|---|---|
| Soft (basé sur les namespaces) | Namespaces + RBAC + NetworkPolicy + ResourceQuota, control plane et kernel partagés | Logique uniquement. Un exploit du kernel ou de l'API server peut encore franchir la frontière entre tenants | Coût le plus bas, exploitation la plus simple | Les équipes internes qui se font déjà confiance |
| Hard (clusters virtuels) | Chaque tenant dispose de son propre API server virtuel (vcluster, Capsule, Kiosk) au-dessus d'un pool de nœuds partagé | Forte isolation du control plane ; les workloads peuvent toujours partager un kernel si vous ne les associez pas à des runtimes sandboxés | Modéré : davantage de composants, mais toujours un seul cluster physique à gérer | Les équipes plateforme qui proposent des environnements façon cluster à de nombreux tenants internes ou externes |
| Physique (nœuds/clusters dédiés) | Taints et tolerations sur les nœuds, ou clusters entièrement séparés, par tenant | La plus forte, avec un kernel séparé et un rayon d'impact séparé | Coût le plus élevé, le plus d'infrastructure à opérer | Les workloads réglementés (HIPAA, PCI-DSS), les tenants GPU, ou quiconque ne peut pas partager un kernel pour des raisons de conformité |
La plupart des organisations ne choisissent pas un seul modèle une fois pour toutes. Elles utilisent la multi-tenancy soft pour les équipes internes de confiance, et réservent l'isolation hard ou physique à la poignée de tenants (un client externe, une équipe ML gourmande en GPU, un workload réglementé) qui en ont besoin. Traiter la multi-tenancy comme un simple interrupteur conduit à sur-dimensionner ou sous-dimensionner nombre de ces projets dès le départ.
Les couches d'isolation qui font tenir la multi-tenancy soft
La plupart des équipes commencent par la multi-tenancy soft, par défaut. Quatre couches la constituent, et il faut configurer chacune d'elles ; aucune n'est activée d'origine.
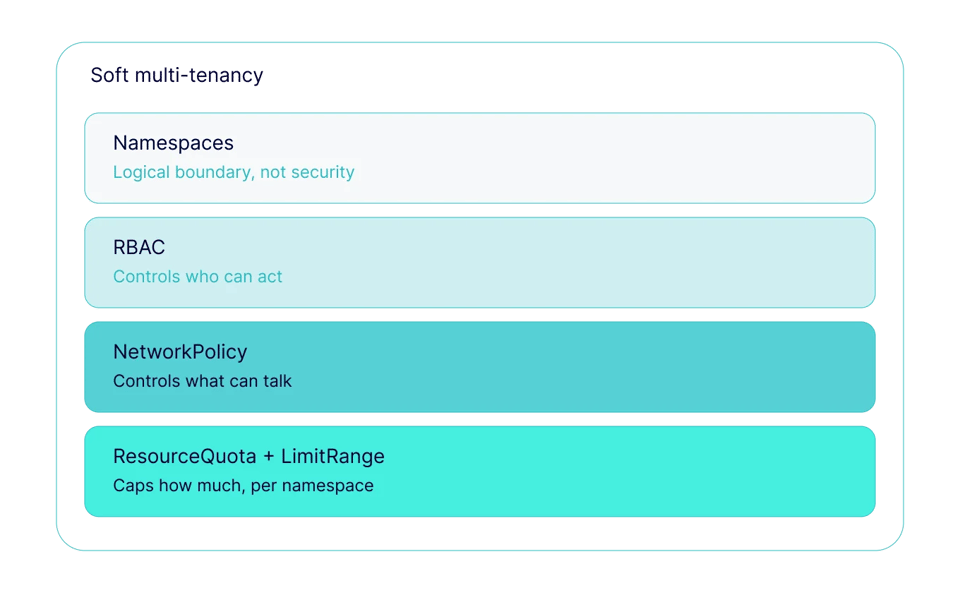
Les namespaces fournissent la frontière à laquelle tout le reste s'attache : un périmètre pour le RBAC, les quotas et les network policies. À eux seuls, ils isolent des noms, pas des comportements. Un pod du namespace A peut toujours communiquer avec un pod du namespace B, et un workload sans limites de ressources peut toujours saturer un nœud que les pods du namespace B utilisent aussi.
Le RBAC décide qui peut agir sur quoi. Partez d'un refus par défaut, accordez le strict minimum de rôles dont chaque équipe a réellement besoin, et liez les permissions à des groupes plutôt qu'à des utilisateurs individuels pour que les accès ne se dégradent pas au fil des arrivées et des départs. La prolifération du RBAC par tenant (des dizaines de Roles et RoleBindings quasi identiques qui se désynchronisent) figure parmi les principales raisons pour lesquelles les clusters multi-tenants deviennent de plus en plus difficiles à auditer.
Les NetworkPolicies empêchent les tenants de communiquer entre eux sur le réseau, ce que ni le RBAC ni les namespaces ne font seuls :
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: deny-cross-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aLa plupart des équipes commencent par une politique default-deny par namespace, puis ajoutent des règles d'autorisation explicites pour ce qui a réellement besoin de communiquer entre namespaces. Sans cela, n'importe quel pod du cluster peut atteindre n'importe quel autre pod par défaut. Les namespaces n'imposent aucune frontière réseau par eux-mêmes.
Les ResourceQuotas et LimitRanges empêchent un tenant d'affamer le reste du cluster en CPU, en mémoire ou en nombre d'objets. Un ResourceQuota plafonne ce qu'un namespace peut consommer au total ; un LimitRange fixe des valeurs par défaut et des maximums raisonnables par conteneur à l'intérieur. C'est exactement là que la multi-tenancy croise le problème du noisy neighbor : un quota ne protège le cluster que si les requests et limits qui le sous-tendent sont correctement définis, au plus près de l'usage réel. Des quotas trop laxistes n'arrêtent pas les noisy neighbors ; des quotas trop serrés poussent simplement les équipes à gonfler leurs demandes et gaspillent les économies de consolidation que la multi-tenancy promettait.
Les Pod Security Standards complètent le dispositif au niveau des workloads, en restreignant par namespace les conteneurs privilégiés, le host networking et l'accès root, afin qu'un attaquant qui compromet un pod chez un tenant ne puisse pas étendre l'attaque au nœud ou au reste du cluster.
Les points de rupture de la multi-tenancy soft en pratique
Deux problèmes reviennent plus que tous les autres.
Le premier porte un nom : le blast radius, ou rayon d'impact. La multi-tenancy isole les tenants les uns des autres, mais tout le monde partage toujours le control plane. Un namespace sans quota sur le nombre d'objets peut inonder etcd de CRD ou de watch requests et ralentir l'API server pour chaque tenant du cluster. Aucun RBAC ni aucune NetworkPolicy par tenant n'empêche cela, car la défaillance ne se produit pas de tenant à tenant. Elle se produit de tenant à control plane.
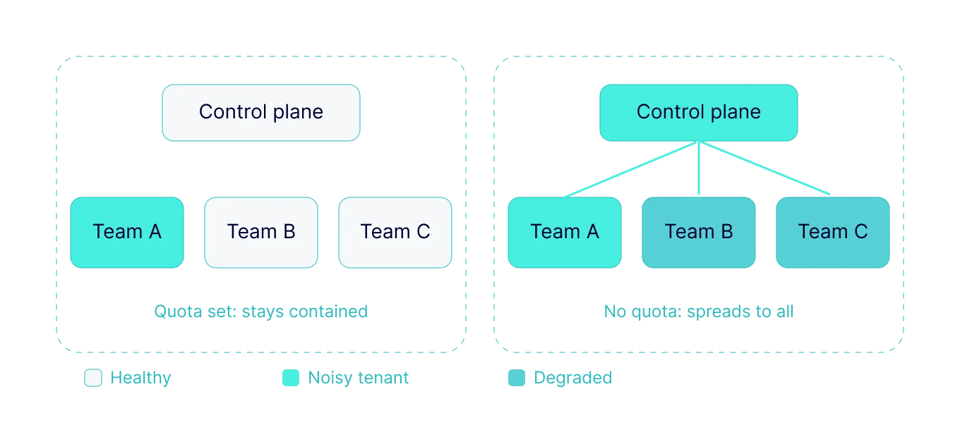
Le second problème : la dérive. Quotas, LimitRanges et RBAC sont configurés correctement une fois, au déploiement, puis plus personne n'y revient alors que les workloads évoluent. Six mois plus tard, la moitié des quotas sont obsolètes : soit trop serrés (les équipes gonflent leurs requests pour les contourner), soit trop lâches (ils n'offrent plus aucune protection réelle). L'article sur les noisy neighbors décrit le même mode de défaillance : une isolation qui tenait au premier jour cesse silencieusement de tenir, et le premier symptôme prend généralement la forme d'une éviction ou d'un OOM kill qui frappe un workload qui n'avait rien fait de mal.
Bonnes pratiques de multi-tenancy Kubernetes
- Définissez une network policy default-deny par namespace ; n'ajoutez des autorisations explicites que pour le trafic inter-namespaces réellement nécessaire
- Attribuez le RBAC à des groupes, pas à des utilisateurs individuels, et passez-le en revue à intervalle régulier au lieu de le configurer une fois puis de l'oublier
- Attachez un ResourceQuota et un LimitRange à chaque namespace de tenant, pas seulement à ceux qui ont déjà causé un problème
- Appliquez les Pod Security Standards par namespace, pas comme un ajout tardif à l'échelle du cluster
- Plafonnez le nombre d'objets (pas seulement CPU et mémoire) pour qu'aucun tenant ne puisse à lui seul mettre le control plane en péril
- Isolez tout tenant ayant des exigences de conformité, de GPU ou de performance sur des node pools dédiés (taints/tolerations) lorsque la multi-tenancy soft ne suffit pas
- Suivez l'usage réel par rapport aux ressources demandées, par namespace et par équipe ; sans cette visibilité, les équipes en sont réduites à deviner quel tenant pose problème
FAQ
Quelle est la différence entre multi-tenancy hard et soft dans Kubernetes ? La multi-tenancy soft isole les tenants de façon logique : namespaces, RBAC, network policies et quotas, tout en partageant un même control plane et un même kernel. La multi-tenancy hard donne à chaque tenant son propre API server virtuel (via des outils comme vCluster, Capsule ou Kiosk) ou des nœuds dédiés, de sorte qu'un incident au niveau du control plane ou du kernel chez un tenant ne peut pas en atteindre un autre.
Kubernetes prend-il en charge la multi-tenancy nativement ? Pas d'origine. Kubernetes fournit les primitives (namespaces, RBAC, NetworkPolicy, ResourceQuota, Pod Security Standards), mais il ne les assemble pas par défaut, et aucune d'elles ne suffit seule à garantir une isolation complète. La multi-tenancy se construit à partir de ces primitives ; ce n'est pas un mode que l'on active.
Ai-je besoin d'un cluster séparé par tenant ? Uniquement pour les tenants qui l'exigent spécifiquement : workloads réglementés, workloads gourmands en GPU avec des besoins stricts d'isolation de performance, ou clients externes pour lesquels le risque d'un kernel partagé est inacceptable. La multi-tenancy soft sur un cluster partagé convient très bien à la plupart des équipes internes ; réservez les clusters ou node pools dédiés aux exceptions plutôt que d'en faire la règle.
Garder un cluster multi-tenant fiable dans la durée
Chacune des couches décrites ci-dessus (quotas, LimitRanges, RBAC) ne vaut que tant qu'elle reste à jour. PerfectScale by DoiT maintient les requests et limits alignés sur l'usage réel à mesure que les workloads évoluent, et vous offre une visibilité par namespace et par équipe sur ce que chaque équipe consomme réellement, pour repérer la dérive des quotas et les noisy neighbors avant qu'ils ne se transforment en incident, et non après.
Envie de le voir à l'œuvre sur un vrai cluster ? Rejoignez le workshop live sur la multi-tenancy le 29 septembre, ou réservez une session technique.