
PerfectScale
Kubernetesマルチテナンシー:モデル・分離レイヤー・ベストプラクティス
Kubernetesマルチテナンシーの実際の仕組み:ソフト分離とハード分離のモデル、それを支えるレイヤー(RBAC、NetworkPolicy、ResourceQuota)、そして実運用で崩れるポイントを解説します。
このページはEnglish、Deutsch、Español、Français、Italiano、Portuguêsでもご覧いただけます。


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Kubernetesのマルチテナンシーとは、チーム・プロジェクト・顧客ごとに専用クラスタを用意するのではなく、1つの共有クラスタ上で複数のテナントを稼働させることです。そして、分離は何ひとつ自動では行われません。
- 分離を支えるのは4つの中核レイヤー、すなわちネームスペース、RBAC、ネットワークポリシー、リソースクォータ(LimitRangeを含む)に加え、ワークロードレベルを守るPod Security Standardsです。ひとつでも欠けると、分離されているはずのテナントが他のテナント全体に影響を及ぼし始めます。
- 分離モデルは3つあります。ソフト(ネームスペースベース、最も低コスト、論理分離のみ)、ハード(vClusterやCapsuleなどの仮想クラスタ)、物理(専用ノードプールまたは専用クラスタ、最も強力な分離、最も高コスト)です。多くの組織は1つに統一するのではなく、3つを組み合わせて使っています。
- 障害の多くは初期設定のミスではなくドリフトに起因します。クォータやRBACを一度正しく設定した後、ワークロードの変化に合わせて見直さないことが原因です。
1つのKubernetesクラスタに10チームを載せた場合、デフォルトでは、チームAがチームBのシークレットを読んだり、チームBのCPUを食い潰したり、チームBも依存するコントロールプレーンをダウンさせたりすることを防ぐ仕組みは何もありません。Kubernetesのマルチテナンシーは、ネームスペース、RBAC、ネットワークポリシー、リソースクォータという4つの設定可能なレイヤーでこのギャップを埋めます。
マルチテナンシーを導入すれば、何十ものアイドル状態のコントロールプレーンに費用を払い続ける必要はなくなり、チーム・プロジェクト・顧客(「テナント」)間でインフラを共有できるようになります。ただしそれは、これらのレイヤーのすべてが実際に設定され、その状態が維持されている場合に限られます。Kubernetesはデフォルトではマルチテナントではありません。ネームスペースが引くのは論理的な境界であり、セキュリティ境界ではありません。レイヤーをひとつでも省略すると、分離されているはずのテナントがクラスタ上の他の全員に影響を及ぼし始めます。それがセキュリティ境界の問題であれ、単にあるワークロードが別のワークロードのCPUを食い潰す問題であれ、です。
なぜチームはクラスタを共有するのか
ほぼすべてのケースに共通する理由は、コスト、運用負荷、開発スピードの3つです。
10個のクラスタを運用するということは、10個のコントロールプレーン、10セットの過剰プロビジョニングされたノードプール、1日の大半をアイドル状態で過ごす10個のロードバランサーを抱えるということです。2〜3個の共有クラスタに集約すれば、このオーバーヘッドを直接削減できます。運用負荷も減ります。パッチを当てるクラスタは1つ、etcdの健全性を監視する場所も1つ、一貫性を保つべきポリシーも1セットで済み、運用するすべてのクラスタで同じ作業を繰り返す必要がなくなります。
開発スピードも同じくらい重要ですが、注目されることは多くありません。プラットフォームチームによる新規クラスタのプロビジョニングを待つチームは、数日待たされます。一方、既存のマルチテナントクラスタ上でネームスペースをリクエストするチームは、クォータとネットワークポリシーが最初から付与された状態で、セルフサービスで数分以内に取得できます。プラットフォームチームはこれを「Namespace-as-a-Service」と呼び、そもそもマルチテナンシーを構築する動機そのものになることも少なくありません。
3つのマルチテナンシーモデル
すべてのテナントが同じレベルの分離を必要とするわけではありません。どのモデルを選ぶかは、影響範囲(ブラストラディウス)と、コストおよび自ら引き受ける運用の複雑さとのトレードオフです。
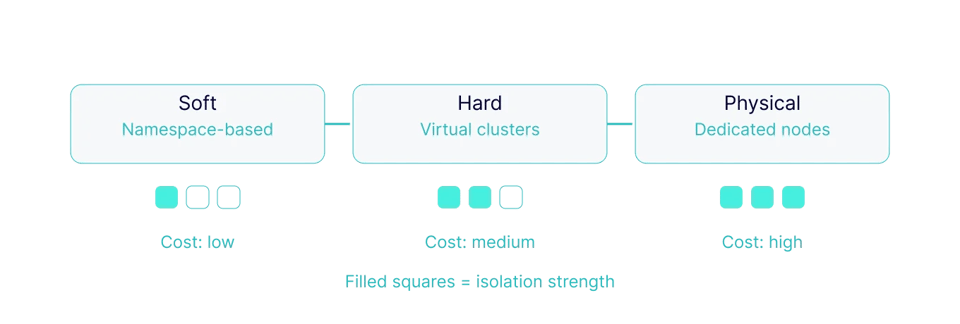
| モデル | 分離の仕組み | 分離の強度 | オーバーヘッド | 適した用途 |
|---|---|---|---|---|
| ソフト(ネームスペースベース) | ネームスペース+RBAC+NetworkPolicy+ResourceQuota。コントロールプレーンとカーネルは共有 | 論理分離のみ。カーネルやAPIサーバーの脆弱性が突かれればテナント間を越えうる | 最も低コストで運用も容易 | すでに信頼関係のある社内チーム |
| ハード(仮想クラスタ) | 各テナントが専用の仮想APIサーバー(vcluster、Capsule、Kiosk)を持ち、共有ノード群の上に重ねる | コントロールプレーンの分離は強力。ただしサンドボックス化されたランタイムと組み合わせない限り、ワークロードはカーネルを共有しうる | 中程度。構成要素は増えるが、管理する物理クラスタは1つ | 多数の社内外テナントに「クラスタに近い」環境を提供するプラットフォームチーム |
| 物理(専用ノード/クラスタ) | テナントごとにノードのtaintとtoleration、または完全に独立したクラスタ | 最も強力。カーネルも影響範囲も分離される | 最も高コストで、運用するインフラも最多 | 規制対象のワークロード(HIPAA、PCI-DSS)、GPUテナント、コンプライアンス上カーネルを共有できないケース |
多くの組織は1つのモデルを選んで終わりにはしません。信頼できる社内チームにはソフトマルチテナンシーを使い、ハードまたは物理分離は、それを必要とする一握りのテナント(外部顧客、GPUを多用するMLチーム、規制対象のワークロード)のために確保します。「マルチテナンシー」を単一のオン/オフ設定として扱うと、こうしたプロジェクトの多くが最初から過剰設計または過少設計になってしまいます。
ソフトマルチテナンシーを成立させる分離レイヤー
多くのチームはまずソフトマルチテナンシーから始めます。これは4つのレイヤーで構成され、そのすべてを自分で設定しなければなりません。デフォルトで有効になっているものは1つもありません。
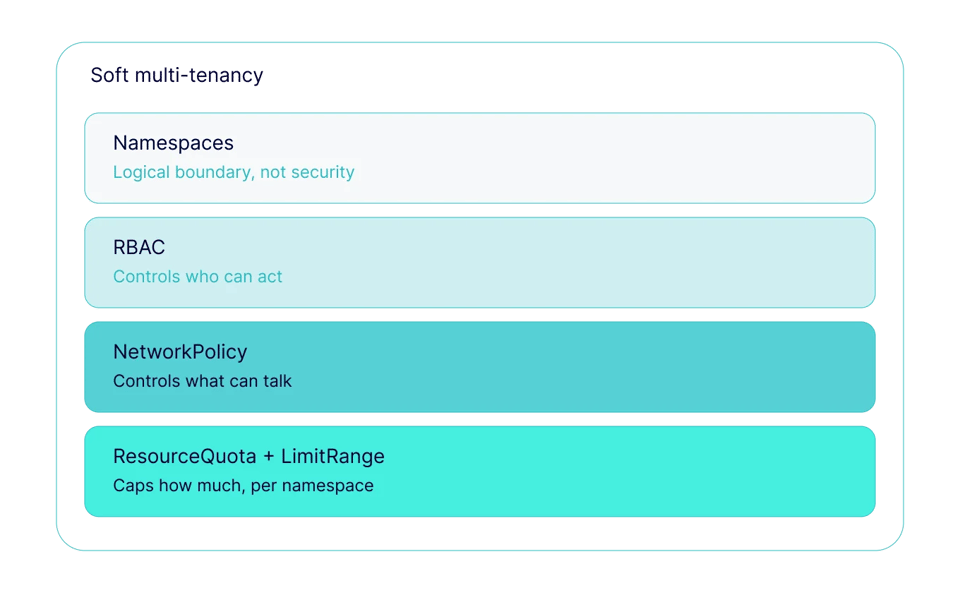
ネームスペースは、他のすべてが紐づく境界を提供します。RBAC、クォータ、ネットワークポリシーのスコープを定める場所です。ただし単体で分離できるのは名前であって、挙動ではありません。ネームスペースAのPodはネームスペースBのPodと通信できますし、リソース制限のないワークロードは、ネームスペースBのPodも使うノードを食い潰すことができます。
RBACは、誰が何に対して操作できるかを決めます。デフォルト拒否から始め、各テナントのチームが実際に必要とする最小限のロールだけを付与し、個々のユーザーではなくグループにバインドすることで、人の入れ替わりに伴ってアクセス権が形骸化するのを防ぎます。テナントRBACの無秩序な増殖(ほぼ重複した何十ものRoleとRoleBindingが同期を失っていく状態)は、マルチテナントクラスタの監査が時間とともに難しくなる最大の原因のひとつです。
NetworkPolicyは、RBACとネームスペースだけでは防げない、テナント同士のネットワーク経由の到達を遮断します。
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: deny-cross-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-a多くのチームは、ネームスペースごとのデフォルト拒否ポリシーから始め、実際にネームスペースをまたいで通信が必要なものにだけ明示的な許可ルールを追加します。これがなければ、クラスタ上のどのPodもデフォルトで他のあらゆるPodに到達できます。ネームスペース自体はネットワーク境界を強制しません。
ResourceQuotaとLimitRangeは、1つのテナントがCPU、メモリ、オブジェクト数の面でクラスタの残りを枯渇させるのを防ぎます。ResourceQuotaはネームスペースが合計で消費できる量に上限を設け、LimitRangeはその内部でコンテナ単位の妥当なデフォルト値と最大値を設定します。マルチテナンシーとノイジーネイバー問題が直接交わるのがここです。クォータがクラスタを守れるのは、チームがその背後にあるrequestsとlimitsを正しく、実際の使用量に近い値で設定している場合だけです。緩すぎるクォータはノイジーネイバーを止められず、厳しすぎるクォータはチームの過剰なリソース要求を招き、マルチテナンシーが約束したはずの集約による節約を無駄にします。
Pod Security Standardsは、ワークロードレベルでこれを補完します。ネームスペース単位で特権コンテナ、ホストネットワーク、root権限を制限し、あるテナントのPodを侵害した攻撃者がノードやクラスタの他の部分へ権限昇格できないようにします。
ソフトマルチテナンシーが実運用で崩れるポイント
特によく起きる問題が2つあります。
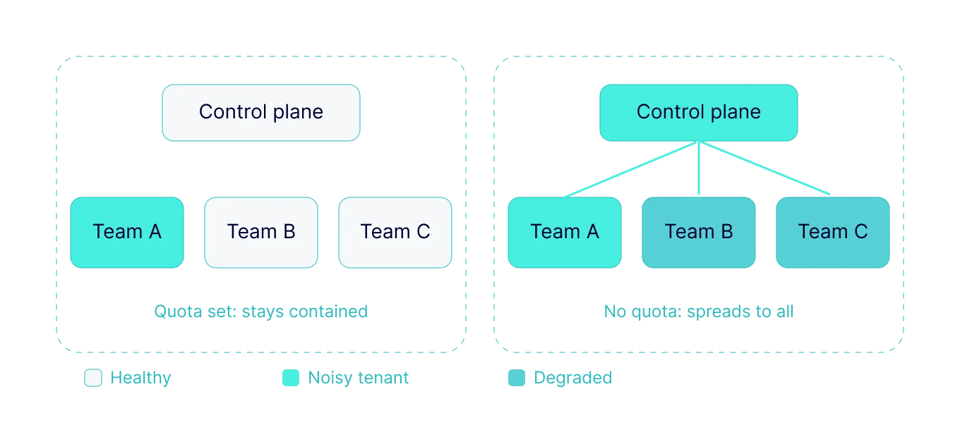
1つ目は「ブラストラディウス(影響範囲)」と呼ばれる問題です。マルチテナンシーはテナント同士を分離しますが、コントロールプレーンは依然として全員で共有しています。オブジェクト数のクォータがないネームスペースは、CRDやwatchリクエストでetcdをあふれさせ、クラスタ上のすべてのテナントに対してAPIサーバーを遅くする可能性があります。テナントごとのRBACやNetworkPolicyをどれだけ用意しても、これは防げません。この障害はテナント間ではなく、テナントからコントロールプレーンへ向かうものだからです。
2つ目の問題はドリフトです。クォータ、LimitRange、RBACは導入時に一度は正しく設定されますが、その後ワークロードが変化しても誰も見直しません。半年も経てば、クォータの半分は実態に合わなくなっています。厳しすぎて(チームがそれをすり抜けるためにリクエストを水増しする)か、緩すぎて(実質的な保護になっていない)かのどちらかです。ノイジーネイバーの記事でも同じ失敗パターンを取り上げています。初日には機能していた分離が静かに機能しなくなり、最初の兆候はたいてい、何も悪くないワークロードに降りかかるevictionやOOM killとして現れます。
Kubernetesマルチテナンシーのベストプラクティス
- ネームスペースごとにデフォルト拒否のネットワークポリシーを設定し、ネームスペースをまたぐ通信が必要なものにだけ明示的な許可を追加する
- RBACは個々のユーザーではなくグループにスコープし、一度設定して放置するのではなく定期的にレビューする
- 問題を起こしたネームスペースだけでなく、すべてのテナントのネームスペースにResourceQuotaとLimitRangeを付与する
- Pod Security Standardsをクラスタ全体への後付けとしてではなく、ネームスペース単位で強制する
- CPU/メモリだけでなくオブジェクト数にも上限を設け、単一テナントからコントロールプレーンを守る
- コンプライアンス、GPU、パフォーマンス要件を持つテナントは、ソフトマルチテナンシーで満たせない場合、専用ノードプール(taint/toleration)で分離する
- ネームスペース単位・チーム単位で、リクエスト値に対する実際の使用量を追跡する。この可視性がなければ、どのテナントが問題の原因かをチームは推測に頼ることになる
FAQ
Kubernetesにおけるハードマルチテナンシーとソフトマルチテナンシーの違いは何ですか? ソフトマルチテナンシーは、1つのコントロールプレーンとカーネルを共有しながら、ネームスペース、RBAC、ネットワークポリシー、クォータでテナントを論理的に分離します。ハードマルチテナンシーは、各テナントに専用の仮想APIサーバー(vCluster、Capsule、Kioskなどのツール経由)や専用ノードを与えるため、あるテナントで起きたコントロールプレーンやカーネルレベルの問題が他のテナントに波及しません。
Kubernetesはネイティブにマルチテナンシーをサポートしていますか? そのままでは対応していません。Kubernetesはプリミティブ(ネームスペース、RBAC、NetworkPolicy、ResourceQuota、Pod Security Standards)を提供しますが、デフォルトではそれらを連携させておらず、単体で完全な分離を実現できるものもありません。マルチテナンシーはこれらのプリミティブから構築するものであり、モードとしてオンにするものではありません。
テナントごとに別々のクラスタは必要ですか? それを明確に必要とするテナントに限られます。規制対象のワークロード、厳格なパフォーマンス分離を要するGPU中心のワークロード、カーネル共有のリスクが許容できない外部顧客などです。共有クラスタ上のソフトマルチテナンシーで大半の社内チームには十分対応できます。専用クラスタや専用ノードプールはデフォルトではなく、例外のために確保しましょう。
マルチテナントクラスタを長期的に健全に保つには
上記のすべてのレイヤー(クォータ、LimitRange、RBAC)は、最新の状態に保たれている限りにおいてのみ機能します。PerfectScale by DoiTは、ワークロードの変化に合わせてrequestsとlimitsを実際の使用量に一致させ続け、各チームが実際に何を消費しているかをネームスペース単位・チーム単位で可視化します。これにより、クォータのドリフトやノイジーネイバーを、インシデントになった後ではなく、なる前に捉えられます。
実際のクラスタで確認してみませんか?9月29日開催のマルチテナンシー・ライブワークショップに参加するか、テクニカルセッションを予約してください。