
PerfectScale
Kubernetes Multi-Tenancy: Modelle, Isolationsebenen und Best Practices
So funktioniert Kubernetes Multi-Tenancy wirklich: Soft- vs. Hard-Isolation, die Ebenen (RBAC, NetworkPolicy, ResourceQuotas), die alles zusammenhalten – und wo sie in der Praxis scheitert.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Kubernetes Multi-Tenancy bedeutet, mehrere Teams, Projekte oder Kunden auf einem gemeinsamen Cluster zu betreiben statt auf je einem dedizierten Cluster – und nichts an der Isolation passiert automatisch.
- Vier Kernebenen tragen das Ganze: Namespaces, RBAC, Network Policies und Resource Quotas (inklusive LimitRanges), plus Pod Security Standards zum Schutz auf Workload-Ebene. Fehlt eine davon, wirkt sich ein Tenant, der eigentlich isoliert bleiben sollte, auf alle anderen aus.
- Es gibt drei Isolationsmodelle: Soft (Namespace-basiert, am günstigsten, nur logische Isolation), Hard (virtuelle Cluster wie vCluster oder Capsule) und physisch (dedizierte Node Pools oder Cluster, stärkste Isolation, höchste Kosten). Die meisten Unternehmen kombinieren alle drei, statt sich auf ein einziges Modell festzulegen.
- Die meisten Ausfälle gehen auf Drift zurück, nicht auf ein schlechtes Initial-Setup: Teams konfigurieren Quotas und RBAC einmal korrekt – und fassen sie danach nie wieder an, während sich die Workloads verändern.
Setzen Sie zehn Teams auf einen Kubernetes-Cluster, und standardmäßig hindert nichts Team A daran, die Secrets von Team B zu lesen, dessen CPU zu verbrauchen oder eine Control Plane lahmzulegen, auf die auch Team B angewiesen ist. Kubernetes Multi-Tenancy schließt diese Lücke über vier konfigurierbare Ebenen: Namespaces, RBAC, Network Policies und Resource Quotas.
Mit Multi-Tenancy müssen Unternehmen nicht länger für Dutzende ungenutzte Control Planes zahlen und können Infrastruktur über Teams, Projekte oder Kunden ("Tenants") hinweg teilen. Das funktioniert aber nur, wenn jede dieser Ebenen tatsächlich konfiguriert wird – und konfiguriert bleibt. Kubernetes ist ab Werk nicht mandantenfähig. Namespaces ziehen eine logische Grenze, keine Sicherheitsgrenze. Fehlt eine Ebene, wirkt sich ein Tenant, der eigentlich isoliert bleiben sollte, auf alle anderen im Cluster aus – ob als Sicherheitsproblem oder schlicht, weil ein Workload einem anderen die CPU wegfrisst.
Warum Teams sich überhaupt einen Cluster teilen
Drei Gründe tauchen in fast jedem Fall auf: Kosten, operativer Aufwand und Entwicklungsgeschwindigkeit.
Zehn Cluster bedeuten zehn Control Planes, zehn überprovisionierte Node Pools und zehn Load Balancer, die den Großteil des Tages im Leerlauf sind. Die Konsolidierung auf zwei oder drei gemeinsame Cluster reduziert diesen Overhead unmittelbar. Auch der operative Aufwand sinkt: ein Cluster zum Patchen, ein Ort, an dem die etcd-Gesundheit überwacht wird, ein Satz konsistent zu haltender Policies – statt derselben Arbeit auf jedem einzelnen Cluster, den Sie betreiben.
Entwicklungsgeschwindigkeit ist genauso wichtig, fällt aber weniger auf. Teams, die darauf warten, dass ein Plattform-Team einen neuen Cluster provisioniert, warten Tage. Teams, die einen Namespace auf einem bestehenden Multi-Tenant-Cluster anfordern, bekommen ihn in Minuten – per Self-Service, mit bereits hinterlegten Quotas und Network Policies. Plattform-Teams nennen das "Namespace-as-a-Service", und oft ist genau das der Grund, warum sie Multi-Tenancy überhaupt aufbauen.
Die drei Multi-Tenancy-Modelle
Nicht jeder Tenant braucht dieselbe Isolation. Das gewählte Modell wägt den Blast Radius gegen die Kosten und die operative Komplexität ab, die Sie zu tragen bereit sind.
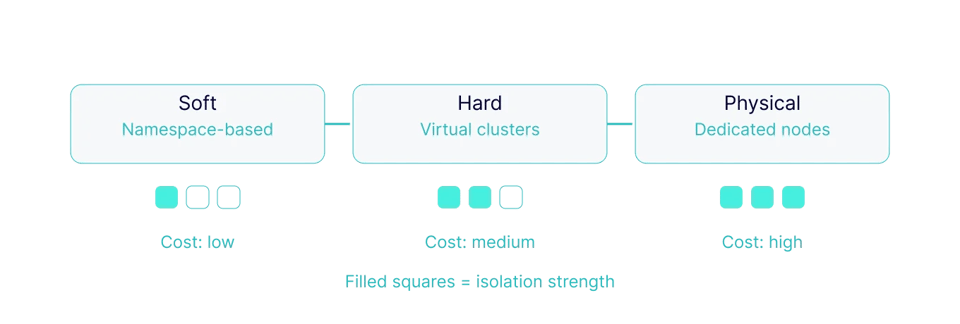
| Modell | Isolationsmechanismus | Isolationsstärke | Overhead | Am besten geeignet für |
|---|---|---|---|---|
| Soft (Namespace-basiert) | Namespaces + RBAC + NetworkPolicy + ResourceQuota, gemeinsame Control Plane und gemeinsamer Kernel | Nur logisch. Ein Kernel- oder API-Server-Exploit kann Tenant-Grenzen weiterhin überwinden | Geringste Kosten, am einfachsten zu betreiben | Interne Teams, die sich bereits vertrauen |
| Hard (virtuelle Cluster) | Jeder Tenant erhält einen eigenen virtuellen API-Server (vcluster, Capsule, Kiosk) über einem gemeinsamen Node-Set | Starke Control-Plane-Isolation; Workloads teilen sich weiterhin einen Kernel, sofern keine Sandbox-Runtimes im Einsatz sind | Moderat: mehr bewegliche Teile, aber weiterhin nur ein physischer Cluster | Plattform-Teams, die "clusterähnliche" Umgebungen für viele interne oder externe Tenants bereitstellen |
| Physisch (dedizierte Nodes/Cluster) | Node Taints und Tolerations oder komplett getrennte Cluster pro Tenant | Am stärksten, mit eigenem Kernel und eigenem Blast Radius | Höchste Kosten, am meisten Infrastruktur | Regulierte Workloads (HIPAA, PCI-DSS), GPU-Tenants oder alle, die aus Compliance-Gründen keinen Kernel teilen dürfen |
Die meisten Unternehmen legen sich nicht auf ein einziges Modell fest. Sie betreiben Soft Multi-Tenancy für vertrauenswürdige interne Teams und reservieren Hard- oder physische Isolation für die Handvoll Tenants (ein externer Kunde, ein GPU-lastiges ML-Team, ein regulierter Workload), die sie tatsächlich brauchen. Wer "Multi-Tenancy" als einfachen Ein/Aus-Schalter behandelt, über- oder unterdimensioniert viele dieser Projekte von Anfang an.
Die Isolationsebenen, die Soft Multi-Tenancy tragen
Die meisten Teams starten standardmäßig mit Soft Multi-Tenancy. Vier Ebenen bilden sie – und jede einzelne muss konfiguriert werden; keine ist ab Werk aktiv.
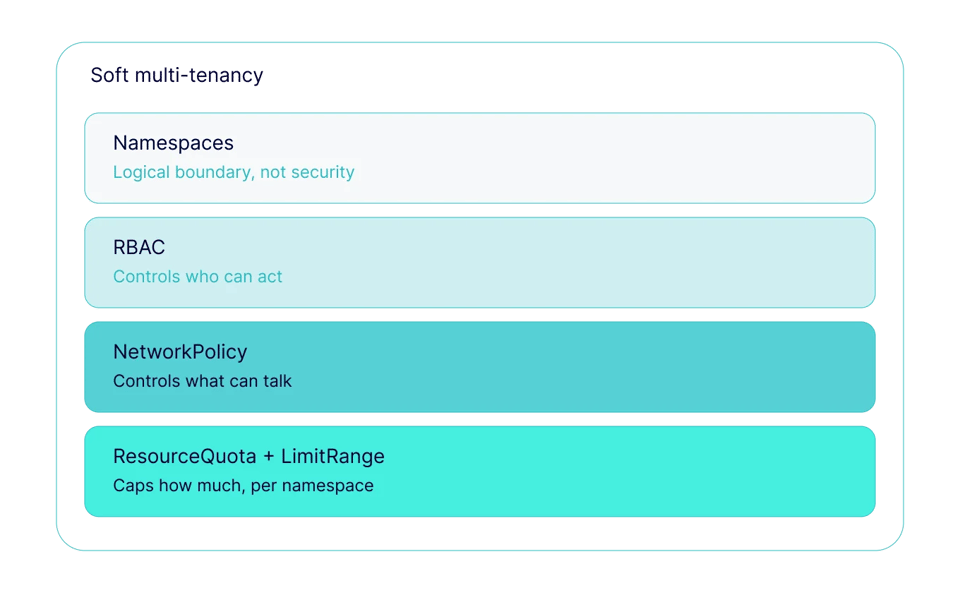
Namespaces liefern die Grenze, an der alles andere ansetzt: den Ort, an dem RBAC, Quotas und Network Policies greifen. Für sich genommen isolieren sie Namen, kein Verhalten. Ein Pod in Namespace A kann weiterhin mit einem Pod in Namespace B kommunizieren, und ein Workload ohne Ressourcenlimits kann weiterhin einen Node auslasten, den auch die Pods von Namespace B nutzen.
RBAC entscheidet, wer worauf zugreifen darf. Starten Sie mit Deny-by-Default, vergeben Sie nur die Rollen, die das Team eines Tenants tatsächlich braucht, und binden Sie Berechtigungen an Gruppen statt an einzelne Nutzer, damit Zugriffe nicht veralten, wenn Personen Teams wechseln oder verlassen. RBAC-Wildwuchs pro Tenant (Dutzende fast identischer Roles und RoleBindings, die auseinanderdriften) gehört zu den Hauptgründen, warum Multi-Tenant-Cluster mit der Zeit immer schwerer zu auditieren sind.
NetworkPolicy verhindert, dass Tenants sich gegenseitig über das Netzwerk erreichen – etwas, das RBAC und Namespaces allein nicht leisten:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: deny-cross-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aDie meisten Teams starten mit einer Default-Deny-Policy pro Namespace und ergänzen dann explizite Allow-Regeln für alles, was tatsächlich Namespace-übergreifend kommunizieren muss. Ohne sie kann standardmäßig jeder Pod im Cluster jeden anderen Pod erreichen. Namespaces erzwingen von sich aus keine Netzwerkgrenzen.
ResourceQuotas und LimitRanges verhindern, dass ein Tenant dem Rest des Clusters CPU, Arbeitsspeicher oder Objektkontingente entzieht. Eine ResourceQuota deckelt, was ein Namespace insgesamt verbrauchen darf; eine LimitRange setzt darin sinnvolle Defaults und Maxima pro Container. Multi-Tenancy und das Noisy-Neighbor-Problem treffen genau hier aufeinander: Eine Quota schützt den Cluster nur dann, wenn die dahinterliegenden Requests und Limits korrekt und nah an der realen Nutzung gesetzt sind. Zu locker gesetzte Quotas stoppen keine Noisy Neighbors; zu eng gesetzte Quotas verleiten Teams dazu, zu viel anzufordern – und verspielen genau die Konsolidierungsersparnis, die Multi-Tenancy versprochen hat.
Pod Security Standards runden das Ganze auf Workload-Ebene ab: Sie beschränken privilegierte Container, Host-Networking und Root-Zugriff pro Namespace, damit ein Angreifer, der einen Pod eines Tenants kompromittiert, nicht auf den Node oder den Rest des Clusters eskalieren kann.
Wo Soft Multi-Tenancy in der Praxis scheitert
Zwei Dinge gehen häufiger schief als alles andere.
Das erste trägt den Namen "Blast Radius": Multi-Tenancy isoliert Tenants voneinander, aber alle teilen sich weiterhin die Control Plane. Ein Namespace ohne Objektanzahl-Quota kann etcd mit CRDs oder Watch-Requests fluten und den API-Server für jeden Tenant im Cluster ausbremsen. Keine noch so gute Tenant-spezifische RBAC- oder NetworkPolicy-Konfiguration verhindert das, denn der Fehler entsteht nicht zwischen Tenants, sondern zwischen Tenant und Control Plane.
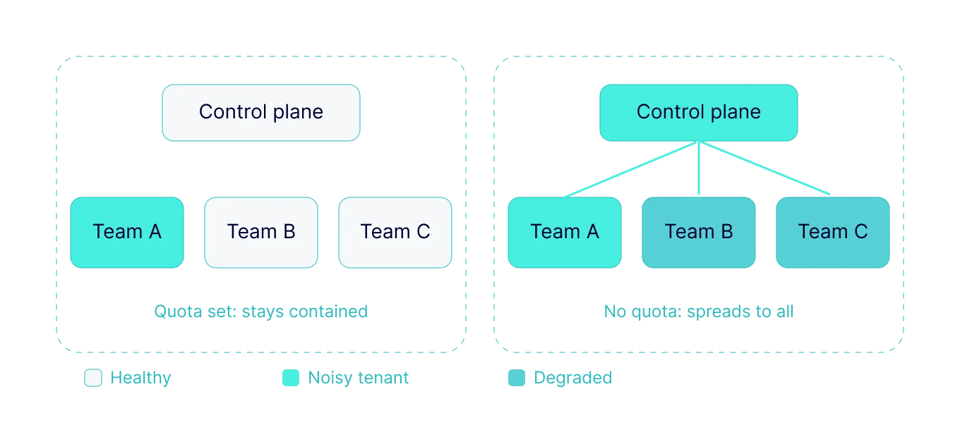
Das zweite Problem: Drift. Quotas, LimitRanges und RBAC werden beim Rollout einmal korrekt konfiguriert – und danach fasst sie niemand mehr an, während sich die Workloads verändern. Sechs Monate später ist die Hälfte der Quotas veraltet: entweder zu eng (Teams polstern ihre Requests, um daran vorbeizukommen) oder zu locker (kein echter Schutz mehr). Der Beitrag zum Noisy-Neighbor-Problem beschreibt dasselbe Fehlermuster: Isolation, die am ersten Tag hielt, hält irgendwann still und leise nicht mehr – und das erste Anzeichen ist meist eine Eviction oder ein OOM-Kill bei einem Workload, der nichts falsch gemacht hat.
Best Practices für Kubernetes Multi-Tenancy
- Setzen Sie eine Default-Deny-Network-Policy pro Namespace; ergänzen Sie explizite Allow-Regeln nur für Namespace-übergreifenden Traffic, der wirklich nötig ist
- Binden Sie RBAC an Gruppen statt an einzelne Nutzer, und überprüfen Sie es in festen Abständen, statt es einmal einzurichten und zu vergessen
- Hängen Sie an jeden Tenant-Namespace eine ResourceQuota und eine LimitRange – nicht nur an die, die bereits Probleme verursacht haben
- Erzwingen Sie Pod Security Standards pro Namespace, nicht als nachträglichen clusterweiten Zusatz
- Deckeln Sie auch Objektanzahlen (nicht nur CPU/Arbeitsspeicher), um die Control Plane vor einzelnen Tenants zu schützen
- Isolieren Sie Tenants mit Compliance-, GPU- oder Performance-Anforderungen auf dedizierten Node Pools (Taints/Tolerations), wenn Soft Multi-Tenancy dafür nicht ausreicht
- Messen Sie die tatsächliche Nutzung gegen die angeforderten Ressourcen – pro Namespace und pro Team; ohne diese Transparenz raten Teams am Ende nur, welcher Tenant Probleme verursacht
FAQ
Was ist der Unterschied zwischen Hard und Soft Multi-Tenancy in Kubernetes? Soft Multi-Tenancy isoliert Tenants logisch – über Namespaces, RBAC, Network Policies und Quotas – bei gemeinsamer Control Plane und gemeinsamem Kernel. Hard Multi-Tenancy gibt jedem Tenant einen eigenen virtuellen API-Server (über Tools wie vCluster, Capsule oder Kiosk) oder dedizierte Nodes, sodass ein Problem auf Control-Plane- oder Kernel-Ebene bei einem Tenant nicht auf einen anderen übergreifen kann.
Unterstützt Kubernetes Multi-Tenancy von Haus aus? Nicht ab Werk. Kubernetes liefert die Grundbausteine (Namespaces, RBAC, NetworkPolicy, ResourceQuota, Pod Security Standards), verdrahtet sie aber standardmäßig nicht miteinander – und keiner davon bietet allein vollständige Isolation. Multi-Tenancy bauen Sie aus diesen Grundbausteinen selbst auf; ein Modus zum Einschalten ist es nicht.
Brauche ich einen eigenen Cluster pro Tenant? Nur für Tenants, die es ausdrücklich erfordern: regulierte Workloads, GPU-lastige Workloads mit strikten Anforderungen an Performance-Isolation oder externe Kunden, bei denen ein Shared-Kernel-Risiko inakzeptabel ist. Für die meisten internen Teams reicht Soft Multi-Tenancy auf einem gemeinsamen Cluster; reservieren Sie dedizierte Cluster oder Node Pools für die Ausnahmen statt als Standard.
Einen Multi-Tenant-Cluster dauerhaft im Griff behalten
Jede der oben genannten Ebenen (Quotas, LimitRanges, RBAC) hält nur so gut, wie sie aktuell bleibt. PerfectScale by DoiT passt Requests und Limits laufend an die reale Nutzung an, während sich Workloads verändern, und zeigt Ihnen pro Namespace und pro Team, was jedes Team tatsächlich verbraucht – so erkennen Sie Quota-Drift und Noisy Neighbors, bevor daraus ein Incident wird, nicht erst danach.
Sie möchten das an einem echten Cluster sehen? Nehmen Sie am Live-Workshop zu Multi-Tenancy am 29. September teil oder buchen Sie eine technische Session.