
PerfectScale
Multi-Tenancy no Kubernetes: modelos, camadas de isolamento e boas práticas
Como o multi-tenancy no Kubernetes funciona de verdade: modelos de isolamento soft e hard, as camadas (RBAC, NetworkPolicy, ResourceQuotas) que o sustentam e onde ele falha na prática.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Multi-tenancy no Kubernetes significa rodar várias equipes, projetos ou clientes em um único cluster compartilhado, em vez de um cluster dedicado para cada um — e nada do isolamento acontece automaticamente.
- Quatro camadas principais sustentam tudo: namespaces, RBAC, network policy e resource quotas (incluindo LimitRanges), além dos Pod Security Standards protegendo o nível dos workloads. Pule uma delas e um tenant que deveria ficar isolado começa a afetar todos os outros.
- Existem três modelos de isolamento: soft (baseado em namespaces, o mais barato, isolamento apenas lógico), hard (clusters virtuais como vCluster ou Capsule) e físico (node pools ou clusters dedicados, isolamento mais forte, custo mais alto). A maioria das organizações combina os três em vez de padronizar em um só.
- A maioria das falhas vem de drift, não de uma configuração inicial ruim: as equipes configuram quotas e RBAC corretamente uma vez e nunca mais revisitam conforme os workloads mudam.
Coloque dez equipes em um único cluster Kubernetes e, por padrão, nada impede a equipe A de ler os secrets da equipe B, consumir a CPU da equipe B ou derrubar um control plane do qual a equipe B também depende. O multi-tenancy no Kubernetes fecha essa lacuna com quatro camadas configuráveis: namespaces, RBAC, network policy e resource quotas.
O multi-tenancy permite que as organizações parem de pagar por dezenas de control planes ociosos e passem a compartilhar infraestrutura entre equipes, projetos ou clientes ("tenants"). Mas isso só funciona se cada uma dessas camadas for de fato configurada — e continuar configurada. O Kubernetes não vem multi-tenant de fábrica. Namespaces traçam uma fronteira lógica, não de segurança. Pule uma camada e um tenant que deveria ficar isolado começa a afetar todos os outros no cluster, seja rompendo uma fronteira de segurança ou simplesmente com um workload consumindo a CPU de outro.
Por que as equipes compartilham um cluster, afinal
Três motivos aparecem em quase todos os casos: custo, carga operacional e velocidade dos desenvolvedores.
Rodar dez clusters significa dez control planes, dez conjuntos de node pools superprovisionados, dez load balancers ociosos a maior parte do dia. Consolidar em dois ou três clusters compartilhados corta esse overhead diretamente. Também reduz a carga operacional: um cluster para aplicar patches, um lugar para monitorar a saúde do etcd, um conjunto de políticas para manter consistente, em vez do mesmo trabalho repetido em cada cluster que você opera.
A velocidade dos desenvolvedores é igualmente importante, embora chame menos atenção. Equipes que dependem de um time de plataforma para provisionar um novo cluster esperam dias. Equipes que solicitam um namespace em um cluster multi-tenant existente conseguem um em minutos, em modelo self-service, já com quotas e network policy anexadas. Times de plataforma chamam isso de "namespace-as-a-service", e muitas vezes é justamente isso que motiva a construção do multi-tenancy.
Os três modelos de multi-tenancy
Nem todo tenant precisa do mesmo isolamento. O modelo que você escolhe equilibra raio de impacto contra custo e a complexidade operacional que você decide assumir.
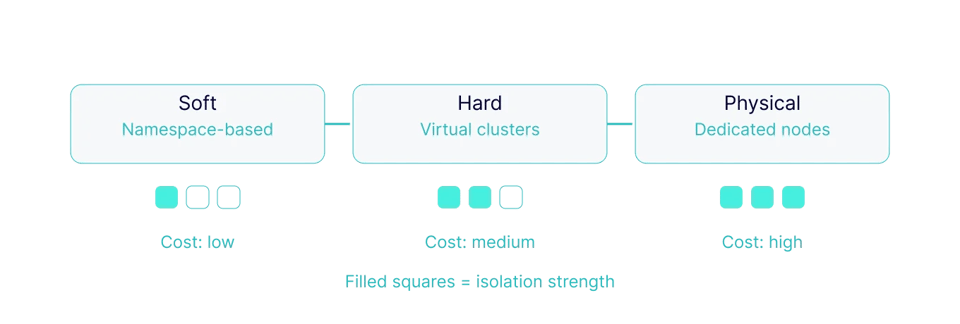
| Modelo | Como isola | Força do isolamento | Overhead | Ideal para |
|---|---|---|---|---|
| Soft (baseado em namespaces) | Namespaces + RBAC + NetworkPolicy + ResourceQuota, com control plane e kernel compartilhados | Apenas lógico. Um exploit no kernel ou no API server ainda pode cruzar a fronteira entre tenants | Menor custo, mais fácil de operar | Equipes internas que já confiam umas nas outras |
| Hard (clusters virtuais) | Cada tenant recebe seu próprio API server virtual (vcluster, Capsule, Kiosk) sobre um conjunto compartilhado de nós | Isolamento forte de control plane; os workloads ainda podem compartilhar um kernel, a menos que combinados com runtimes em sandbox | Moderado: mais partes móveis, mas ainda um único cluster físico para gerenciar | Times de plataforma que oferecem ambientes "semelhantes a clusters" para muitos tenants internos ou externos |
| Físico (nós/clusters dedicados) | Taints e tolerations de nós, ou clusters totalmente separados, por tenant | O mais forte, com kernel separado e raio de impacto separado | Maior custo, mais infraestrutura para operar | Workloads regulados (HIPAA, PCI-DSS), tenants de GPU ou quem não pode compartilhar um kernel por questões de compliance |
A maioria das organizações não escolhe um modelo e para por aí. Elas rodam soft multi-tenancy para equipes internas confiáveis e reservam o isolamento hard ou físico para o punhado de tenants (um cliente externo, um time de ML pesado em GPU, um workload regulado) que realmente precisa dele. Tratar o "multi-tenancy" como um único botão liga/desliga superdimensiona ou subdimensiona muitos desses projetos desde o início.
As camadas de isolamento que sustentam o soft multi-tenancy
A maioria das equipes começa com soft multi-tenancy por padrão. Quatro camadas o constroem, e você precisa configurar cada uma delas; nenhuma vem ativada de fábrica.
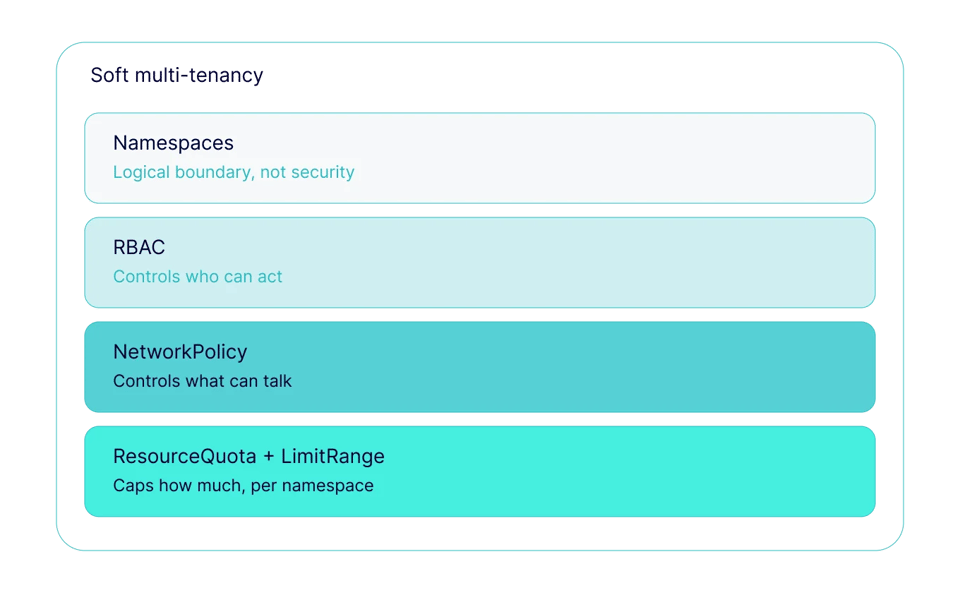
Namespaces dão a fronteira à qual todo o resto se conecta: um lugar para delimitar RBAC, quotas e network policy. Sozinhos, eles isolam nomes, não comportamento. Um pod no namespace A ainda pode falar com um pod no namespace B, e um workload sem limites de recursos ainda pode consumir um nó que os pods do namespace B também usam.
RBAC decide quem pode agir sobre o quê. Comece negando tudo por padrão, conceda apenas as roles mínimas que o time de cada tenant realmente precisa e vincule a grupos em vez de usuários individuais, para que o acesso não se degrade conforme pessoas entram e saem das equipes. O sprawl de RBAC por tenant (dezenas de Roles e RoleBindings quase duplicados saindo de sincronia) está entre os principais motivos de clusters multi-tenant ficarem cada vez mais difíceis de auditar com o tempo.
NetworkPolicy impede que tenants se alcancem pela rede, algo que RBAC e namespaces sozinhos não fazem:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: deny-cross-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aA maioria das equipes começa com uma política default-deny por namespace e depois adiciona regras de allow explícitas para o que realmente precisa se comunicar entre namespaces. Sem isso, qualquer pod do cluster pode alcançar qualquer outro pod por padrão. Namespaces não impõem fronteiras de rede por conta própria.
ResourceQuotas e LimitRanges impedem que um único tenant sufoque o resto do cluster em CPU, memória ou contagem de objetos. Uma ResourceQuota limita o que um namespace pode consumir no total; um LimitRange define padrões e máximos sensatos por contêiner dentro dele. Multi-tenancy e o problema do noisy neighbor se cruzam exatamente aqui: uma quota só protege o cluster quando as equipes definem corretamente os requests e limits por trás dela, próximos ao uso real. Quotas frouxas demais não param noisy neighbors; quotas apertadas demais só empurram as equipes a inflar requests e desperdiçar a economia de consolidação que o multi-tenancy prometia.
Pod Security Standards completam o quadro no nível dos workloads, restringindo contêineres privilegiados, host networking e acesso root por namespace, de modo que um invasor que comprometa um pod de um tenant não consiga escalar para o nó ou para o resto do cluster.
Onde o soft multi-tenancy falha na prática
Duas coisas dão errado mais do que qualquer outra.
A primeira atende pelo nome de "raio de impacto" (blast radius): o multi-tenancy isola tenants uns dos outros, mas todos continuam compartilhando o control plane. Um namespace sem quota de contagem de objetos pode inundar o etcd com CRDs ou requisições de watch e deixar o API server lento para todos os tenants do cluster. Não há RBAC ou NetworkPolicy por tenant que evite isso, porque a falha não se origina de tenant para tenant. Ela se origina de tenant para control plane.
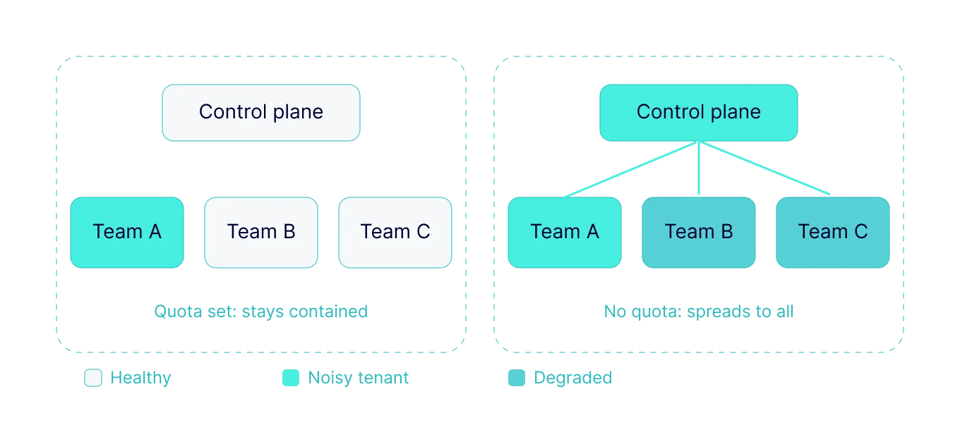
O segundo problema: drift. Quotas, LimitRanges e RBAC são configurados corretamente uma vez, no rollout, e depois ninguém mais os revisita conforme os workloads mudam. Seis meses depois, metade das quotas está obsoleta: apertadas demais (equipes inflando requests para passar por elas) ou frouxas demais (sem oferecer proteção real). O post sobre noisy neighbors cobre o mesmo modo de falha: o isolamento que funcionava no primeiro dia deixa de funcionar silenciosamente, e o primeiro sinal geralmente aparece como um eviction ou um OOM kill atingindo um workload que não fez nada de errado.
Boas práticas de multi-tenancy no Kubernetes
- Defina uma network policy default-deny por namespace; adicione allows explícitos apenas para o que precisa de tráfego entre namespaces
- Restrinja o RBAC a grupos, não a usuários individuais, e revise-o periodicamente em vez de configurar uma vez e esquecer
- Anexe uma ResourceQuota e um LimitRange a todo namespace de tenant, não só aos que já causaram problema
- Aplique Pod Security Standards por namespace, não como um remendo tardio em nível de cluster
- Limite a contagem de objetos (não só CPU/memória) para proteger o control plane de qualquer tenant individual
- Isole qualquer tenant com requisitos de compliance, GPU ou performance em node pools dedicados (taints/tolerations) quando o soft multi-tenancy não der conta
- Acompanhe o uso real em relação ao solicitado, por namespace e por equipe; sem essa visibilidade, as equipes acabam adivinhando qual tenant está causando problemas
FAQ
Qual é a diferença entre hard e soft multi-tenancy no Kubernetes? O soft multi-tenancy isola tenants logicamente: namespaces, RBAC, network policy e quotas, compartilhando um único control plane e kernel. O hard multi-tenancy dá a cada tenant seu próprio API server virtual (com ferramentas como vCluster, Capsule ou Kiosk) ou nós dedicados, de modo que um problema no control plane ou no nível do kernel em um tenant não alcance outro.
O Kubernetes suporta multi-tenancy nativamente? Não de fábrica. O Kubernetes fornece os primitivos (namespaces, RBAC, NetworkPolicy, ResourceQuota, Pod Security Standards), mas não os conecta entre si por padrão, e nenhum deles sozinho entrega isolamento completo. Você constrói o multi-tenancy a partir desses primitivos; não é um modo que se liga.
Preciso de um cluster separado por tenant? Apenas para tenants que exigem isso especificamente: workloads regulados, workloads pesados em GPU com necessidades rígidas de isolamento de performance ou clientes externos para os quais o risco de um kernel compartilhado é inaceitável. O soft multi-tenancy em um cluster compartilhado atende bem a maioria das equipes internas; reserve clusters ou node pools dedicados para as exceções, não como padrão.
Mantendo um cluster multi-tenant sob controle ao longo do tempo
Cada camada acima (quotas, LimitRanges, RBAC) só se sustenta enquanto permanece atualizada. O PerfectScale by DoiT mantém requests e limits alinhados ao uso real conforme os workloads mudam e oferece visibilidade por namespace e por equipe do que cada time realmente consome, para você detectar drift de quotas e noisy neighbors antes que virem um incidente, e não depois.
Quer ver isso em um cluster real? Participe do workshop ao vivo sobre multi-tenancy em 29 de setembro ou agende uma sessão técnica.