


¿Qué es el Exit Code 143 en Kubernetes?
El Exit Code 143 de Kubernetes indica que un contenedor fue terminado correctamente mediante una solicitud externa SIGTERM (señal 15). En la mayoría de los casos, no se trata de un error de la aplicación, sino de una señal de que Kubernetes está funcionando exactamente como se espera para apagar un workload de forma ordenada.
¿Por qué ocurre? Kubernetes envía una señal SIGTERM al proceso principal del pod (PID 1) para pedirle que termine sus tareas en curso, cierre las conexiones abiertas y salga de forma limpia. Estos son los desencadenantes operativos más comunes:
- Deployment o rolling update: Kubernetes termina los pods antiguos con SIGTERM mientras se crean los pods de reemplazo durante un despliegue.
- Eliminación manual de pods: Eliminar un pod inicia la terminación controlada y normalmente envía SIGTERM a sus contenedores.
- Escalado de pods y reducción de réplicas: Al reducir la escala de un workload, se terminan las réplicas que ya no se necesitan.
- Drenaje de nodos o desalojo de pods: El mantenimiento o un desalojo pueden terminar pods para mover los workloads a otros nodos.
- Apagado de nodos de Kubernetes: El apagado ordenado de un nodo puede enviar SIGTERM a los workloads antes de que el nodo se apague.
- Fallas en las sondas de liveness o de startup: Las sondas fallidas pueden provocar reinicios de contenedores que comienzan con una terminación controlada.
- Terminación por la aplicación o un gestor de procesos: Un gestor de procesos, un script, un sidecar o un componente de la aplicación pueden enviar SIGTERM directamente.
- Autoescalado del clúster o reemplazo de nodos: La eliminación de nodos, las actualizaciones, las reparaciones y los cambios de infraestructura pueden terminar de forma ordenada los workloads afectados.
Buenas prácticas y cómo solucionarlo:
- Implementa un manejo ordenado de SIGTERM: Asegúrate de que la aplicación capture SIGTERM, deje de aceptar trabajo nuevo, complete la limpieza necesaria y salga de forma limpia.
- Configura un terminationGracePeriodSeconds apropiado: Dale a la aplicación tiempo suficiente para completar su procedimiento de apagado antes de que Kubernetes envíe SIGKILL.
- Usa un hook preStop cuando se requiera lógica de apagado adicional: Ejecuta la baja del servicio u otras tareas de apagado necesarias antes de la terminación normal del contenedor.
- Haz que los workers en segundo plano se apaguen de forma segura: Deja de aceptar trabajos nuevos y haz que el trabajo inconcluso se pueda reintentar o reanudar para evitar procesamientos perdidos o inconsistentes.
- Monitorea el código de salida 143 en contexto: Correlaciona las terminaciones con despliegues, escalado, operaciones de nodos, fallas de sondas y errores de la aplicación, en lugar de tratar cada aparición como una falla.
Este artículo forma parte de una serie sobre resolución de problemas en Kubernetes
En este artículo:
- Cómo funciona la terminación de pods en Kubernetes
- Causas comunes del Exit Code 143 en Kubernetes
- Exit Code 143 vs. Exit Code 137 en Kubernetes
- Cómo diagnosticar el Exit Code 143 en Kubernetes
- Buenas prácticas para prevenir el Exit Code 143 en Kubernetes
Cómo funciona la terminación de pods en Kubernetes
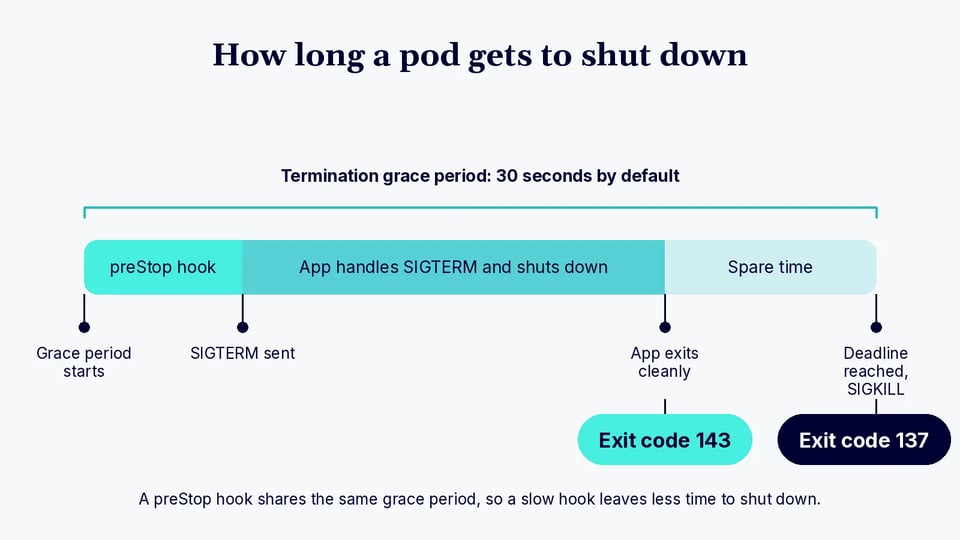
Paso 1: Kubernetes envía SIGTERM al contenedor
Cuando comienza la terminación de un pod, el kubelet le pide al runtime de contenedores que detenga los contenedores. El runtime normalmente envía SIGTERM al proceso principal de cada contenedor. SIGTERM es la señal 15 en Linux y solicita un apagado ordenado en lugar de matar el proceso de inmediato.
Las aplicaciones pueden registrar un manejador de señales para reaccionar a SIGTERM. Por ejemplo, un servidor web puede dejar de aceptar solicitudes nuevas mientras permite que terminen las que están en curso. Si la aplicación no maneja la señal de forma explícita, su comportamiento por defecto ante señales determina cómo termina.
Kubernetes también puede usar una señal de detención diferente cuando hay una configurada para el contenedor o la imagen. Sin embargo, SIGTERM es la señal estándar involucrada en la mayoría de los apagados de Kubernetes y es la razón por la que el código de salida 143 se ve con tanta frecuencia.
Paso 2: Comienza el período de gracia de terminación
Al mismo tiempo, Kubernetes inicia el período de gracia de terminación del pod. Este período se controla con terminationGracePeriodSeconds en la especificación del pod y es de 30 segundos por defecto. Define el tiempo disponible para el proceso normal de terminación antes de que Kubernetes obligue a detenerse a los contenedores restantes.
Si el contenedor tiene un hook de ciclo de vida preStop, Kubernetes lo ejecuta durante este período de terminación antes de pedirle al runtime que detenga el contenedor. El hook puede realizar tareas como notificar a otro servicio, esperar a que se drene el tráfico o activar un comportamiento de apagado específico de la aplicación.
El hook preStop normalmente no otorga tiempo extra de apagado. Su ejecución consume el mismo período de gracia, por lo que un hook de larga duración puede dejarle a la aplicación menos tiempo para procesar SIGTERM y completar su propia limpieza.
Paso 3: La aplicación realiza un apagado ordenado
Después de recibir SIGTERM, la aplicación debería comenzar su procedimiento de apagado. Un servidor podría dejar de aceptar conexiones nuevas, completar las solicitudes en curso, cerrar las conexiones a la base de datos, vaciar las escrituras en búfer y detener los workers en segundo plano.
La lógica de apagado debería completarse antes de que expire el período de gracia de terminación. Por eso, las aplicaciones con solicitudes o trabajos de larga duración pueden necesitar un valor más alto de terminationGracePeriodSeconds. El período configurado debe contemplar tanto los hooks de ciclo de vida como el peor escenario de tiempo de apagado de la aplicación.
Si el proceso termina como resultado de SIGTERM, las herramientas de monitoreo y la información de estado del contenedor pueden reportar el código de salida 143. En este contexto, el código suele indicar un apagado normal iniciado por Kubernetes y no un crash de la aplicación.
Paso 4: Kubernetes envía SIGKILL si el contenedor no sale
Si un contenedor sigue en ejecución cuando se alcanza el plazo de terminación, Kubernetes solicita un apagado forzado. El runtime de contenedores entonces envía SIGKILL, o señal 9, al proceso restante. A diferencia de SIGTERM, SIGKILL no puede ser capturada, ignorada ni manejada por la aplicación.
Esto evita que un pod quede atascado indefinidamente en estado de terminación. Sin embargo, la terminación forzada puede interrumpir solicitudes activas, dejar trabajo incompleto o impedir que los datos en búfer y el estado de la aplicación se escriban correctamente.
Un proceso eliminado con SIGKILL suele producir el código de salida 137, porque 128 + 9 = 137. Por lo tanto, un código 137 repetido durante terminaciones de pods planificadas puede indicar que el apagado ordenado de la aplicación tarda más que el período de gracia disponible.
Causas comunes del Exit Code 143 en Kubernetes
El código de salida 143 indica que el proceso del contenedor recibió SIGTERM y terminó. En Kubernetes, esto suele ocurrir porque la plataforma u otro proceso solicitó intencionalmente que el contenedor se detuviera. Los eventos del pod y el historial del workload pueden ayudar a identificar qué operación desencadenó la señal.
Deployment o rolling update
Durante una actualización progresiva de un Deployment, Kubernetes crea los pods del nuevo ReplicaSet y termina los pods del ReplicaSet anterior. Los contenedores antiguos reciben SIGTERM para poder apagarse de forma ordenada antes de ser eliminados. Por eso, ver el código de salida 143 durante un despliegue planificado suele ser esperable. Se convierte en un problema cuando el apagado interrumpe solicitudes o excede repetidamente el período de gracia configurado.
Eliminación manual de pods
Ejecutar kubectl delete pod inicia el proceso normal de terminación del pod. Kubernetes marca el pod para su eliminación y el kubelet, en algún momento, le pide al runtime de contenedores que detenga sus contenedores, normalmente usando SIGTERM. Si el proceso principal de la aplicación sale a causa de esta señal, Kubernetes puede registrar el código de salida 143. Esto es normal cuando el pod fue eliminado intencionalmente.
Escalado de pods y reducción de réplicas
Reducir la cantidad de réplicas de un Deployment, StatefulSet u otro controlador hace que Kubernetes termine los pods que ya no se necesitan. Esos pods pasan por el proceso estándar de terminación controlada. Por ejemplo, escalar un Deployment de diez réplicas a cinco requiere detener cinco pods. Sus contenedores pueden reportar el código de salida 143 después de recibir SIGTERM.
Drenaje de nodos o desalojo de pods
Drenar un nodo normalmente desaloja los pods elegibles para que los workloads puedan moverse a otro lugar. Los pods desalojados se terminan en el nodo anterior, mientras que sus controladores pueden crear pods de reemplazo en otros nodos disponibles. Los contenedores que se están terminando reciben las señales normales de apagado y pueden salir con el código 143. El mantenimiento de nodos y las operaciones de infraestructura son razones comunes para ver varias de estas terminaciones casi al mismo tiempo.
Apagado de nodos de Kubernetes
Cuando Kubernetes detecta un apagado ordenado del sistema operativo y el apagado ordenado de nodos está configurado, el kubelet puede terminar los pods antes de que el nodo se apague. Esto les da tiempo a los workloads para detenerse limpiamente en lugar de desaparecer de inmediato junto con el nodo. Los contenedores terminados durante este proceso pueden reportar el código de salida 143. Revisar los eventos del nodo y la actividad de apagado del host permite distinguir este caso de fallas a nivel de aplicación.
Fallas en las sondas de liveness o de startup
Las fallas repetidas en la sonda de liveness hacen que Kubernetes reinicie el contenedor afectado. Las fallas en la sonda de startup pueden producir el mismo resultado cuando la aplicación no logra estar saludable dentro de las verificaciones permitidas. Como parte del reinicio, el kubelet termina el contenedor, normalmente dándole la oportunidad de apagarse de forma ordenada. Si el proceso termina después de recibir SIGTERM, su estado anterior de contenedor puede mostrar el código de salida 143.
La aplicación o un gestor de procesos envía SIGTERM
SIGTERM no siempre se origina en Kubernetes. Estos elementos también pueden enviar la señal 15 al proceso principal del contenedor:
- Un script de shell
- Un supervisor
- Un gestor de procesos
- Un sidecar
- Un componente de la aplicación
En esta situación, Kubernetes solo observa la terminación resultante del proceso. Los logs de la aplicación y del gestor de procesos son importantes porque los eventos de Kubernetes pueden no identificar al emisor original de la señal.
Autoescalado del clúster o reemplazo de nodos
Un autoescalador de clúster puede eliminar nodos subutilizados cuando la capacidad ya no se necesita. Las plataformas de Kubernetes administrado también pueden reemplazar nodos durante:
- Actualizaciones
- Mantenimiento
- Reparaciones
- Cambios de infraestructura
Los workloads en los nodos que se eliminan intencionalmente suelen drenarse o terminarse de otra forma y reprogramarse cuando corresponde. Los contenedores detenidos de forma ordenada durante ese proceso pueden reportar el código de salida 143, lo que convierte al evento de infraestructura en la causa de fondo y no a un error de la aplicación.
Exit Code 143 vs. Exit Code 137 en Kubernetes
Los códigos de salida 143 y 137 indican que un contenedor fue terminado por una señal de Linux, pero representan señales diferentes. El código 143 corresponde a SIGTERM, mientras que el 137 corresponde a SIGKILL:
- El código de salida 143 se calcula como 128 + 15, donde 15 es el número de señal de SIGTERM. Esta señal le da a la aplicación la oportunidad de realizar un apagado ordenado. Aparece comúnmente durante la eliminación de pods, los rolling updates, el escalado, el drenaje de nodos y otras operaciones normales de Kubernetes.
- El código de salida 137 se calcula como 128 + 9, donde 9 es el número de señal de SIGKILL. Un proceso no puede capturar ni manejar SIGKILL, por lo que la terminación es inmediata. Kubernetes puede usarla cuando un contenedor no sale antes de que expire su período de gracia de terminación. El código 137 también puede ocurrir cuando el kernel de Linux mata un proceso por una condición de falta de memoria (out-of-memory).
La distinción es útil al diagnosticar problemas. El código 143 normalmente apunta a una solicitud de terminación intencional, mientras que el 137 indica una terminación forzada. Para el código 137, verifica si el contenedor muestra la razón OOMKilled y revisa el uso y los límites de memoria. Si no fue eliminado por OOM, determina si la aplicación excedió su período de gracia de terminación.
Cómo diagnosticar el Exit Code 143 en Kubernetes
Diagnosticar el código de salida 143 implica averiguar quién envió SIGTERM y por qué. Como Kubernetes usa esta señal con frecuencia durante la gestión normal de workloads, el código de salida por sí solo no indica una falla.
Comienza con el estado del pod y del contenedor, y luego correlaciona el momento de la terminación con logs, eventos, despliegues, actividad de escalado y operaciones de nodos. Verifica también que la aplicación responda correctamente cuando recibe SIGTERM.
Paso 1: Inspecciona el estado del pod
Comienza revisando el estado actual del pod y su información detallada:
kubectl get pod <pod-name> -n <namespace>kubectl describe pod <pod-name> -n <namespace>Busca reinicios de contenedores, condiciones del pod, eventos recientes e información de terminación. kubectl describe pod también puede revelar fallas de sondas, actividad de desalojo, cambios de programación y otros eventos relacionados con el apagado.
Si el pod está gestionado por un Deployment, StatefulSet u otro controlador, identifica también a su propietario. Esto ayuda a determinar si la terminación formó parte de la actividad normal del controlador.
Paso 2: Verifica el código de salida y la razón de terminación del contenedor
Inspecciona el estado de terminación actual y anterior del contenedor. Para un contenedor reiniciado, Kubernetes puede conservar detalles como el código de salida, la razón, la señal y las marcas de tiempo:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.status.containerStatuses[*].lastState.terminated}'Confirma que el código de salida registrado sea 143. Revisa también la razón de terminación y las marcas de tiempo startedAt y finishedAt, que pueden correlacionarse con los eventos de Kubernetes y los logs de la aplicación.
No asumas que el código de salida 143 explica por sí mismo la causa. Te dice que el proceso terminó a causa de SIGTERM, pero no qué operación de Kubernetes o proceso externo inició la terminación.
Paso 3: Revisa los logs actuales y anteriores del contenedor
Revisa los logs de la aplicación alrededor del momento de la terminación:
kubectl logs <pod-name> -n <namespace>Si el contenedor se reinició, inspecciona los logs de la instancia anterior del contenedor:
kubectl logs <pod-name> -n <namespace> --previousBusca mensajes de apagado, mensajes de señal recibida, solicitudes inconclusas, errores de conexión y excepciones de la aplicación. Una secuencia limpia —recibir SIGTERM, dejar de aceptar trabajo nuevo, cerrar recursos y salir— normalmente indica una terminación controlada.
Para pods con varios contenedores, especifica el contenedor correspondiente con -c <container-name>.
Paso 4: Inspecciona los eventos de Kubernetes
Los eventos de Kubernetes pueden dar contexto sobre lo que ocurrió inmediatamente antes de la terminación:
kubectl get events -n <namespace> \ --sort-by=.metadata.creationTimestampBusca mensajes relacionados con sondas fallidas, desalojo de pods, reinicios de contenedores, escalado, programación o problemas de nodos. Compara las marcas de tiempo de los eventos con la marca de tiempo de terminación del contenedor.
Los eventos son útiles, pero no constituyen un registro de auditoría completo. Pueden expirar y no toda causa de terminación de un pod genera un evento que explique con claridad por qué se envió SIGTERM.
Paso 5: Revisa la actividad de Deployments y despliegues
Determina si el contenedor se detuvo durante una actualización del Deployment u otro cambio en el workload:
kubectl rollout status deployment/<deployment-name> -n <namespace>kubectl rollout history deployment/<deployment-name> -n <namespace>Inspecciona también los ReplicaSets al diagnosticar un Deployment. La aparición de un nuevo ReplicaSet cerca del momento de la terminación es un fuerte indicio de que los pods antiguos estaban siendo reemplazados durante un despliegue.
Si el código de salida 143 ocurre solo cuando se despliegan nuevas versiones de la aplicación, normalmente forma parte del reemplazo normal de pods. La siguiente pregunta es si esos pods se apagaron limpiamente sin perder solicitudes ni trabajo.
Paso 6: Busca eventos de escalado, desalojo o de nodos
Verifica si cambios de réplicas, autoescalado, drenajes de nodos u operaciones de infraestructura coinciden con la terminación. Para workloads que usan un HorizontalPodAutoscaler, inspecciona su estado actual y su comportamiento reciente:
kubectl get hpa -n <namespace>kubectl describe hpa <hpa-name> -n <namespace>Inspecciona también el nodo que alojaba el pod:
kubectl describe node <node-name>Busca apagados de nodos, mantenimiento, condiciones de presión, actividad del autoescalador o eventos relacionados con desalojos. Si muchos pods sin relación entre sí terminan aproximadamente al mismo tiempo, es más probable que se trate de una operación a nivel de nodo o de clúster que de un problema específico de la aplicación.
Paso 7: Determina si la aplicación maneja SIGTERM correctamente
Por último, verifica cómo responde a SIGTERM el proceso principal de la aplicación. Normalmente debería dejar de aceptar trabajo nuevo, completar o cancelar de forma segura las operaciones activas, vaciar los datos necesarios, cerrar las conexiones externas y salir antes de que expire el período de gracia de terminación.
Revisa el período de gracia configurado en el pod:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.spec.terminationGracePeriodSeconds}'Verifica también que las señales realmente lleguen a la aplicación. Los contenedores que lanzan aplicaciones mediante scripts de shell o gestores de procesos mal configurados pueden interferir con el reenvío de señales cuando la aplicación no es el PID 1.
Si el apagado ordenado tarda sistemáticamente más que el período disponible, mejora la ruta de apagado o aumenta terminationGracePeriodSeconds cuando corresponda. Probar la aplicación directamente con SIGTERM puede confirmar que su manejador de señales se ejecuta y sale dentro del tiempo esperado.
Buenas prácticas para prevenir el Exit Code 143 en Kubernetes {#best-practices-to-prevent-kubernetes-exit-code-143}
Estas son algunas formas de prevenir el código de salida 143 al trabajar con Kubernetes.
1. Implementa un manejo ordenado de SIGTERM
Las aplicaciones deberían manejar SIGTERM de forma explícita y comenzar un apagado ordenado cuando llega la señal. Un servicio debería dejar de aceptar trabajo nuevo, terminar o cancelar de forma segura las solicitudes activas, cerrar conexiones, vaciar los datos en búfer y luego salir.
Asegúrate de que la aplicación realmente reciba la señal. Los scripts de shell envolventes y los gestores de procesos pueden impedir que las señales lleguen a la aplicación si no las reenvían correctamente. Usar exec en un script de entrypoint puede reemplazar el shell por el proceso de la aplicación:
exec /app/my-serviceEsto convierte a la aplicación en el PID 1 y permite que las señales de terminación del contenedor le lleguen directamente.
2. Configura un terminationGracePeriodSeconds apropiado
Configura terminationGracePeriodSeconds con un valor lo bastante largo para que la aplicación complete su procedimiento normal de apagado. Kubernetes usa 30 segundos por defecto, pero eso puede ser insuficiente para solicitudes de larga duración, trabajos por lotes, consumidores de mensajes o aplicaciones con tareas de limpieza considerables.
Por ejemplo:
spec: terminationGracePeriodSeconds: 60Basa el valor en los tiempos de apagado observados, en lugar de simplemente definir un timeout grande. Las aplicaciones deberían seguir terminando tan rápido como sea práctico, porque un período de gracia innecesariamente largo puede retrasar despliegues, operaciones de escalado y mantenimiento de nodos.
3. Usa un hook preStop cuando se requiera lógica de apagado adicional
Un hook preStop puede ejecutar lógica adicional antes de que el contenedor reciba su señal normal de detención. Es útil cuando el apagado requiere un comando explícito, dar de baja el servicio u otra operación fuera del manejador estándar de SIGTERM de la aplicación.
Por ejemplo:
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "/app/prepare-shutdown.sh"]Mantén el hook breve y confiable. Su tiempo de ejecución se descuenta del período de gracia de terminación del pod, por lo que un hook preStop lento reduce el tiempo disponible para que la aplicación se apague después de recibir SIGTERM.
4. Haz que los workers en segundo plano se apaguen de forma segura
Los workers en segundo plano necesitan manejo de terminación tanto como los servicios HTTP. Cuando un worker recibe SIGTERM, normalmente debería dejar de tomar trabajos nuevos y, o bien terminar su trabajo actual, o devolver el trabajo inconcluso a la cola usando el mecanismo soportado por el sistema de colas.
Evita salir de inmediato mientras un trabajo está procesado parcialmente. Según el workload, esto puede resultar en trabajo perdido, procesamiento duplicado, actualizaciones incompletas de la base de datos o un estado inconsistente de la aplicación.
Para trabajos de larga duración, asegúrate de que el período de gracia de terminación sea compatible con los tiempos de procesamiento esperados. Cuando los trabajos no puedan terminar de forma confiable dentro de ese período, diséñalos para que se puedan reintentar o reanudar.
5. Monitorea el código de salida 143 en contexto
No generes alertas por cada aparición del código de salida 143. Es esperable durante los despliegues progresivos, la eliminación manual de pods, las operaciones de reducción de escala, los drenajes de nodos y otras actividades rutinarias de Kubernetes.
En su lugar, correlaciona el código de salida 143 con las tasas de reinicio de pods, la actividad de despliegue, los eventos de Kubernetes, las operaciones de nodos, los errores de la aplicación y las solicitudes fallidas. Las terminaciones repetidas por SIGTERM sin una operación conocida del clúster merecen una investigación más profunda.
Monitorear el contexto hace que el código de salida 143 sea útil como señal de diagnóstico. Ayuda a distinguir la actividad saludable del ciclo de vida de las fallas de sondas, los workloads inestables, las terminaciones inesperadas de procesos o los cambios de infraestructura.
Preguntas frecuentes
¿El código de salida 143 de Kubernetes es un error? Normalmente no. El código de salida 143 significa que el proceso principal del contenedor recibió SIGTERM y se detuvo. Kubernetes envía esta señal durante actividades normales como rolling updates, eliminación de pods, reducción de escala y drenajes de nodos, por lo que el código por sí solo no apunta a una falla.
¿Cuál es la diferencia entre el código de salida 143 y el 137? El código de salida 143 es 128 + 15 y significa que el proceso se detuvo tras recibir SIGTERM, lo que le da a la aplicación la oportunidad de apagarse de forma ordenada. El código 137 es 128 + 9 y significa SIGKILL, que no se puede capturar. Puede ocurrir cuando un contenedor no cumple su período de gracia de terminación o es eliminado por quedarse sin memoria.
¿Cuánto espera Kubernetes antes de enviar SIGKILL? El período de gracia de terminación es de 30 segundos por defecto y se configura con terminationGracePeriodSeconds. Un hook preStop se ejecuta dentro de esa misma ventana, por lo que un hook lento le deja a la aplicación menos tiempo para manejar SIGTERM.
¿Cómo averiguo quién envió el SIGTERM? Comienza con kubectl describe pod y el último estado de terminación del contenedor, y luego compara las marcas de tiempo con los eventos de Kubernetes, el historial de despliegues, la actividad del HPA y los eventos de nodos. Si nada en el clúster coincide, revisa los logs de la aplicación y del gestor de procesos, ya que un script, un supervisor o un sidecar también pueden enviar SIGTERM.
¿Debería crear alertas por el código de salida 143? No, no por cada aparición. Crea alertas por patrones, como terminaciones repetidas por SIGTERM sin un despliegue, escalado u operación de nodo conocidos, o terminaciones que coinciden con solicitudes fallidas o tasas de reinicio en aumento.
Mantén tus workloads de Kubernetes estables en cada terminación con PerfectScale
El código de salida 143 suele ser señal de una actividad saludable del ciclo de vida, pero los despliegues frecuentes, las reducciones de escala y los cambios de nodos hacen más difícil distinguir las terminaciones rutinarias de los problemas reales de resiliencia. PerfectScale for Kubernetes de DoiT ofrece una automatización adaptada a los workloads con un enfoque que prioriza la estabilidad, manteniendo la salud de las aplicaciones en el centro de cada recomendación de optimización. Brinda a los equipos de plataforma, SRE y FinOps una vista única de la salud, el rendimiento y el costo del clúster, para que puedan detectar problemas de resiliencia y ajustar el tamaño de los workloads sin monitoreo manual ni reconfiguraciones constantes.
Capacidades clave de PerfectScale for Kubernetes:
- Detección de problemas de resiliencia: Podfit ofrece una vista granular de la salud y los costos del clúster, priorizando las áreas que requieren atención y ayudando a los equipos a identificar rápidamente recursos desaprovechados y problemas de resiliencia.
- Right-sizing con la estabilidad como prioridad: El right-sizing contextual adapta las acciones usando líneas base de rendimiento, patrones de tráfico y criticidad de negocio, de modo que la optimización nunca se logre a costa de la salud de las aplicaciones.
- Optimización autónoma de workloads: Las recomendaciones basadas en datos y los flujos de automatización ajustan el tamaño de los workloads de forma continua, eliminando el ciclo constante de reconfiguración que consume el tiempo de ingeniería.
- Insights de configuración de autoescaladores: Recomendaciones accionables ayudan a mejorar las configuraciones de HPA y KEDA, mientras que Infrafit ayuda a maximizar la efectividad de autoescaladores de nodos como Karpenter.
- Visibilidad del uso de nodos: Infrafit identifica capacidad ociosa en los nodos y recomienda los nodos adecuados para tus workloads, para que el rendimiento y la confiabilidad del clúster se mantengan al máximo nivel.
- Seguimiento de recursos a nivel de contenedor: Monitorea la CPU y la memoria a nivel de contenedor para eliminar la pérdida y definir los recursos según el uso real.
- Guardrails y políticas: Define reglas de optimización por criticidad del workload y tipo de entorno para mantener protegidos los workloads de producción.
- Visibilidad multi-cloud y multi-clúster: Obtén inteligencia basada en datos, aplicación de políticas y acciones de optimización en cualquier cantidad de clústeres y proveedores de nube, incluido el seguimiento del uso de GPU.
¿Todo listo para ejecutar workloads de Kubernetes confiables y rentables? Conoce más sobre PerfectScale for Kubernetes.